

Python多线程Threading、子线程与守护线程实例详解

本文详细解析Python中多线程编程的核心概念,涵盖线程创建、启动、Join阻塞机制及守护线程设置。通过直接调用Thread类与继承Thread类两种方式的代码实例,对比IO密集型与CPU密集型场景下的多线程效率,并深入讲解守护线程与主线程的生命周期关系及setDaemon的使用注意事项。
本文通过具体实例深入解析Python中的多线程机制,重点介绍Threading模块、子线程以及守护线程的应用。内容旨在为读者提供清晰的技术参考与实操指导。
- 可以将线程比作工厂中的工人,而进程则是工厂本身。系统分配资源时是针对整个工厂(进程),但实际执行任务的是具体的工人(线程)。
- 线程是操作系统进行独立调度和分派的基本单位。线程本身不持有系统资源,仅保留运行所必需的少量资源,但它可以与所属进程内的其他线程共享进程拥有的全部资源。
- 多线程是指在同一个程序内部,通过多个线程同时执行不同的任务,从而实现并发处理的能力。
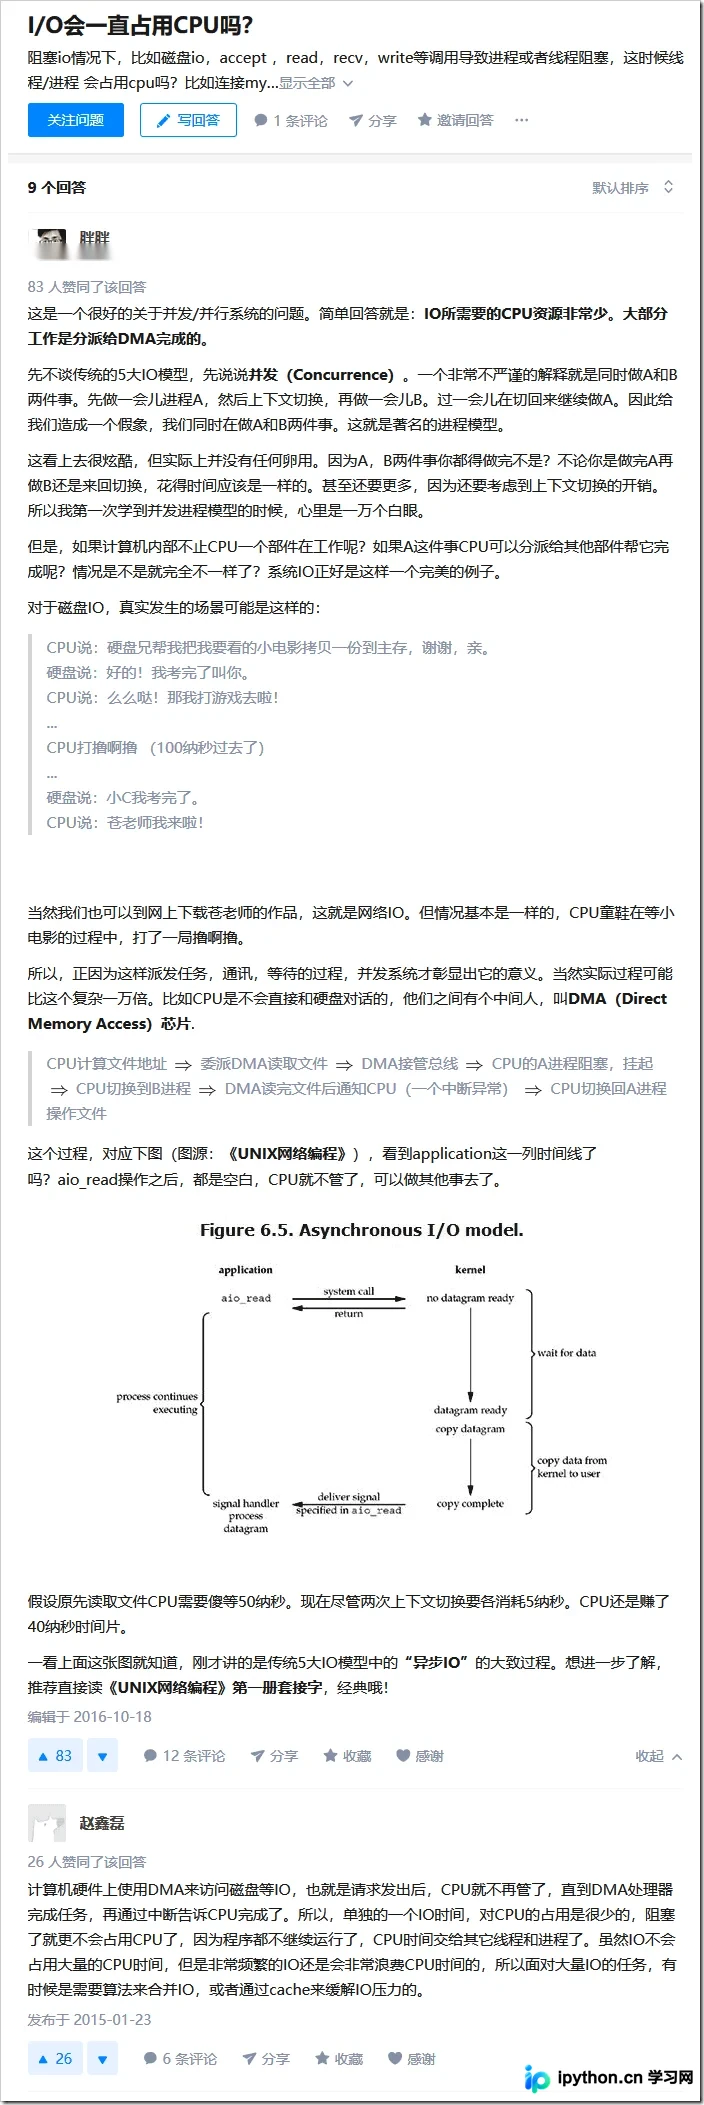
- 对于IO密集型程序,多线程具有显著优势。由于IO操作不占用CPU时间,线程可以利用等待IO的时间执行其他任务。例如,A点外卖只需等待配送并敲门,这段时间可处理其他事务。
- 对于CPU密集型程序,多线程的效率通常不高。这是因为CPU在进行计算时,线程切换需要保存和恢复之前的运行现场,这一过程消耗较大。例如,同时做几份作业,每份需十分钟且无法在十分钟内完成,那么每切换回一份作业时,都需要重新回忆之前的进度和思考过程,导致效率降低。】
补充说明:关于IO操作是否消耗CPU资源,可参考知乎相关讨论:https://www.zhihu.com/question/27734728
-
在Python中实现多线程功能,必须使用threading模块。
线程的创建与运行流程如下:
第一种方式是直接调用threading模块中的Thread类。
线程创建语法为:线程对象 = threading.Thread(target=函数名, args=(参数,))。注意,args参数期望接收一个元组,因此当只有一个参数时,必须在参数后添加逗号以确保格式正确。
线程启动通过调用线程对象的start()方法实现。执行start()后,系统会自动调用Thread类中的run()方法来执行线程逻辑。
若需让主线程等待其他子线程执行完毕,可使用线程对象的join()方法。加入join()后,主线程将被阻塞,直到被join的子线程执行结束,主线程才会继续向下执行后续代码。
import threading,time

def run(n):
 time.sleep(1)
 print("task ",n)

t1=threading.Thread(target=run,args=("t1",))
t2 = threading.Thread(target=run,args=("t2",))

start_time=time.time()#开始时间
t1.start()
t2.start()
##因为是独立线程,如果想要主线程等待其他线程运行完毕,需要使用join
t1.join()
t2.join()
spend_time=time.time()-start_time
print(spend_time)##1.0多,说明是并行的结果
补充说明:join()方法的核心作用是阻塞等待,确保主线程按顺序处理结果。
import threading,time

class MyTread(threading.Thread):
 def __init__(self,name):
  super(MyTread,self).__init__()#调用父类的__init__()
  self.name=name
 def run(self):#重写方法,按自己的要求去写
  time.sleep(1)
  print("run in task",self.name,threading.current_thread(),threading.active_count())

t1=MyTread("t1")
t2=MyTread("t2")
start_time=time.time()
t1.start()
t2.start()

t1.join()
t2.join()
time.sleep(1)###主线程等待其余线程结束
print(time.time()-start_time)
#结果是2.0多,证明是join是相当于阻塞了主线程的执行,只有当线程结束后才会向下执行
第二种创建线程的方式是继承threading模块中的Thread类。
在继承threading.Thread类的自定义类中,主要需要完成两项工作:
首先,关于初始化:若无需自定义变量初始化,可直接使用父类的__init__();若需进行自定义变量初始化,则必须先调用父类的__init__()方法,否则需要手动处理线程初始化相关的参数传递。
其次,必须重写run()方法。虽然继承了父类的run(),但如果不重写,继承Thread类的意义将大打折扣,直接调用Thread类即可,无需额外封装。
-
import threading,time

class MyTread(threading.Thread):
 def __init__(self,name):
  super(MyTread,self).__init__()#调用父类的__init__()
  self.name=name
 def run(self):#重写方法,按自己的要求去写
  time.sleep(1)
  print("run in task",self.name,threading.current_thread(),threading.active_count())

t1=MyTread("t1")
t2=MyTread("t2")
start_time=time.time()
t1.start()
t2.start()
###主线程等待其余线程结束
t1.join()
t2.join()
print(time.time()-start_time)#结果是1.0多,证明是并行的
- 由一个线程启动的线程被称为该线程的子线程。例如,线程A启动线程B,则B是A的子线程,A是B的父线程。
以下是threading模块中几个常用的函数与方法:
- threading.current_thread():
返回当前正在运行的线程对象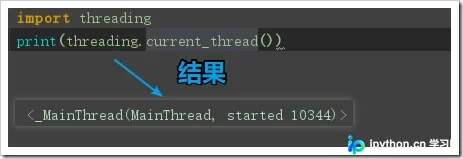
- threading.active_count():
返回当前进程中的存活的线程对象数
- 线程对象的.isAlive()方法:用于判断指定线程是否处于存活状态。
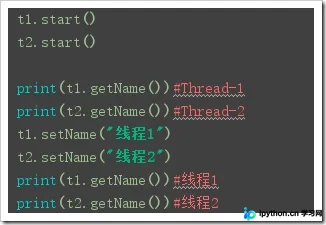
- getName():返回当前线程的名称。
- setName():用于设置线程的名称。
-
get_ident():获取当前线程的唯一标识符(ID)。
- 守护线程的作用是提供辅助支持,类似于魔法师释放禁咒时需要骑士保护。魔法师只需专注于自身任务,保护工作由守护线程负责。
- 守护线程与主线程的关系类似于备胎与女神。备胎(守护线程)需要一直在外等待(运行),但其结束不影响主进程(女神)的结束,运行时间由主线程决定。主线程无需等待守护线程,一旦主线程结束,无论守护线程的任务是否完成,它都会立即终止。
- 与join()的区别在于:join()是阻塞等待,而守护线程是并行等待,主线程结束即强制结束守护线程。
- 设置守护线程的方法为:线程对象.setDaemon(True)。注意:设置守护线程必须在调用start()之前进行,否则程序会报错。
以下代码示例展示了主线程并不会等待其守护线程执行完毕的情况:
import threading,time

class MyTread(threading.Thread):

 def __init__(self,name):
  super(MyTread,self).__init__()
  self.name=name
 def run(self):
  print("守护线程已经启动",self.name)
  time.sleep(1)
  print("run in task",self.name,threading.current_thread(),threading.active_count())

t1=MyTread("t1")
t1.setDaemon(True)
t2=MyTread("t2")
t2.setDaemon(True)
start_time=time.time()#开始时间
t1.start()
t2.start()

spend_time=time.time()-start_time
print(spend_time)##0.0多,而且三个线程都执行完毕了,说明这个是并行的等待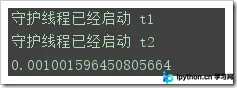
通过让主线程sleep一段时间,可以观察到如果主线程等待守护线程,这种等待是并行的。
import threading,time

class MyTread(threading.Thread):

 def __init__(self,name):
  super(MyTread,self).__init__()
  self.name=name
 def run(self):
  print("守护线程已经启动",self.name)
  time.sleep(1)
  print("run in task",self.name,threading.current_thread(),threading.active_count())

t1=MyTread("t1")
t1.setDaemon(True)
t2=MyTread("t2")
t2.setDaemon(True)
start_time=time.time()#开始时间
t1.start()
t2.start()
time.sleep(2)
spend_time=time.time()-start_time
print(spend_time)##2.0多,而且三个线程都执行完毕了,说明这个是并行的等待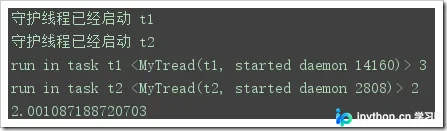
更多关于Python相关技术内容,感兴趣的读者可查阅本站专题:《Python进程与线程操作技巧总结》、《Python数据结构与算法教程》、《Python函数使用技巧总结》、《Python字符串操作技巧汇总》、《Python入门与进阶经典教程》、《Python+MySQL数据库程序设计入门教程》及《Python常见数据库操作技巧汇总》。
希望本文所述内容能对大家的Python程序设计学习有所帮助。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









