

Python怎么用PyPDF2修改PDF文件的元数据头部
详细讲解在Python中使用PyPDF2修改PDF文件元数据头部(Title、Author、Subject等)的完整操作流程、核心原理、代码示例与常见避坑指南。
在日常开发与文档自动化处理中,我们经常需要对PDF文件的元数据头部进行读取与修改,比如更新文章标题(Title)、补充作者姓名(Author)、修正主题分类(Subject)或写入关键词(Keywords)。使用Python处理此类任务时,PyPDF2是一个轻量且被广泛采用的标准库方案。本文将详细拆解PDF元数据的底层组织机制,并使用现代PyPDF2接口,完整演示从读取现有信息、构建新元数据字典到生成目标文件的全流程步骤与避坑细节。
一、PDF元数据头部的基本构成与工作原理
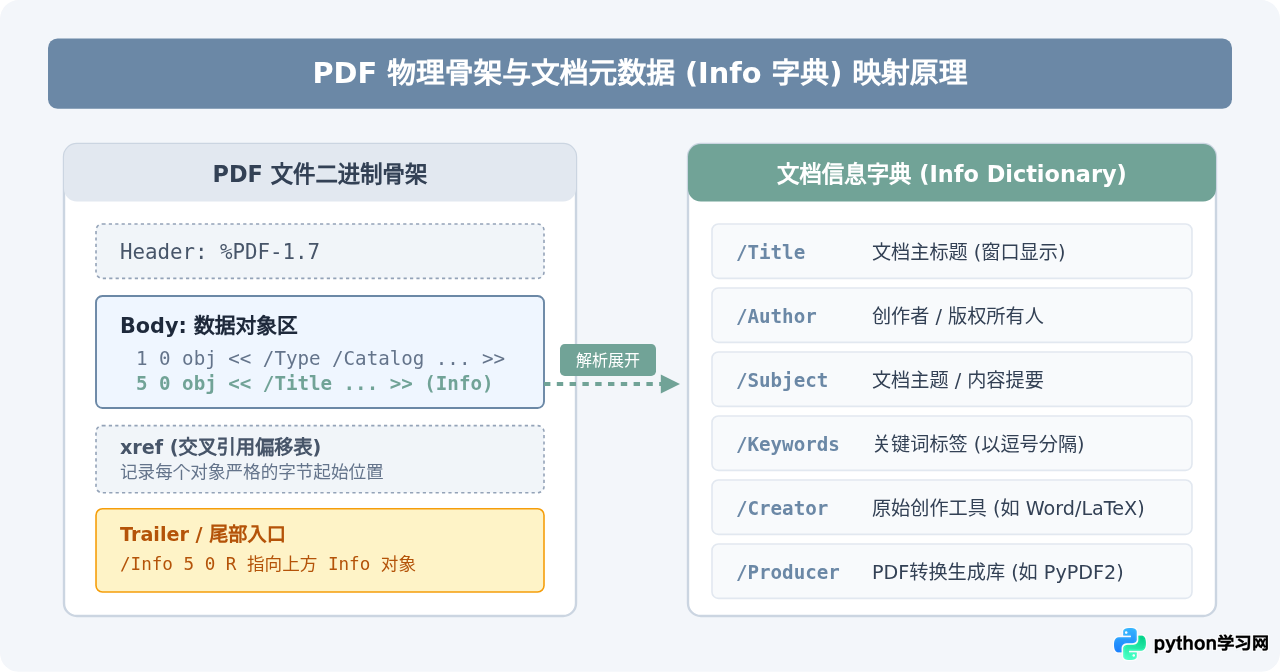
PDF文件的“元数据头部”在规范中主要体现为文档信息字典(Document Information Dictionary,简称 Info 字典)。它包含了一系列以斜杠开头的预定义键值对,用于记录文件的描述性属性与创建信息:
/Title:文档标题,PDF阅读器窗口顶部通常会优先展示该属性而非本地文件名。/Author:文档主要创作者或机构名称。/Subject:文档的主题说明或摘要概括。/Keywords:用于检索与归档的关键词列表,多个词通常用逗号或分号分隔。/Creator:生成原文档的应用程序名称(如 Word、LaTeX)。/Producer:将排版文档转换并输出为PDF的底层渲染引擎(如 Acrobat Distiller、ReportLab)。/CreationDate与/ModDate:文档创建与最后修改时间戳。
很多初学者会疑惑:为什么不能像修改纯文本那样直接用字符串替换PDF中的元数据?这是因为PDF是一种高度结构化的复合二进制文件,文件尾部包含交叉引用表(Cross-Reference Table,即 xref),其中精准记录了每个对象在文件内的物理字节偏移量。如果直接对文件进行文本替换,对象的字节长度改变会导致整个交叉引用表索引失效,最终造成PDF文件损坏无法打开。因此,正规的修改方式都是通过解析器将页面对象与元数据提取出来,在内存中完成组装后,由写入器重新生成包含完整目录与交叉引用表的新文件。
二、环境准备与现有元数据读取
在开始编写代码前,请确保系统中已经安装了 PyPDF2。你可以使用标准的 pip 命令进行安装:
pip install PyPDF2在现代版本的 PyPDF2(3.0+)中,推荐使用 PdfReader 类读取文件,使用 PdfWriter 类组装和写入文件。修改元数据的第一步通常是查看文件当前包含哪些元信息。以下是读取现有元数据的标准代码:
from PyPDF2 import PdfReader

def check_pdf_metadata(pdf_path: str):
    # 初始化读取器
    reader = PdfReader(pdf_path)

    # 获取元数据字典
    metadata = reader.metadata

    print(f"=== 文件 {pdf_path} 元数据检测 ===")
    if metadata:
        print(f"标题 (Title): {metadata.title}")
        print(f"作者 (Author): {metadata.author}")
        print(f"主题 (Subject): {metadata.subject}")
        print(f"生成程序 (Creator): {metadata.creator}")
        print(f"生成引擎 (Producer): {metadata.producer}")
        print("\n原始字典键值:")
        for key, value in metadata.items():
            print(f"  {key}: {value}")
    else:
        print("该文件不存在元数据或元数据为空。")

# 执行检测示例
check_pdf_metadata("document.pdf")标题 (Title): 2026年度技术架构白皮书
作者 (Author): 张工
主题 (Subject): 自动化部署规范
生成程序 (Creator): Microsoft Word
生成引擎 (Producer): Acrobat Distiller 11.0
原始字典键值:
/Title: 2026年度技术架构白皮书
/Author: 张工
/Subject: 自动化部署规范
/Creator: Microsoft Word
/Producer: Acrobat Distiller 11.0
三、核心操作步骤:用 PyPDF2 修改并保存元数据
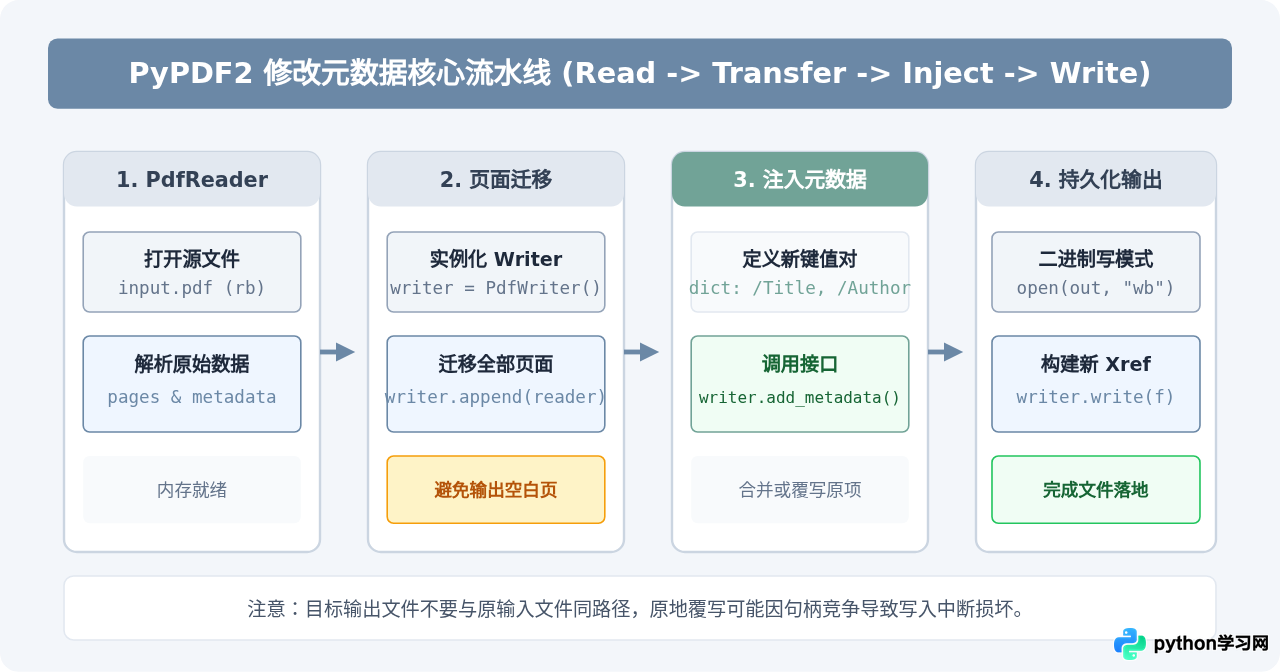
PyPDF2 并不支持直接原地修改已保存的物理文件。标准的修改逻辑包含四个关键步骤:
- 载入源文件:通过
PdfReader解析原始 PDF,获取原有的所有页面和当前元数据。 - 转存页面流:实例化
PdfWriter,并将reader.pages中的全部页面按原顺序追加到 writer 中。务必注意:如果不迁移页面,生成的目标文件将变成没有任何页面内容的空白文档。 - 注入新元数据:构建包含目标字段的 Python 字典,调用
writer.add_metadata()将其写入。字典的键建议使用以斜杠开头的标准名称(如"/Title"),PyPDF2 会自动完成规范化。 - 持久化输出:使用二进制写入模式(
"wb")打开目标文件,调用writer.write(f)将最终数据流落地。
完整修改代码示例
下面是一个经过模块化封装的完整修改脚本,支持在保留原未修改元数据的基础上,按需覆盖或新增指定的字段:
from PyPDF2 import PdfReader, PdfWriter

def update_pdf_metadata(input_path: str, output_path: str, new_meta: dict, keep_existing: bool = True):
    """
    修改指定 PDF 文件的元数据头部并输出新文件

    :param input_path: 原 PDF 文件路径
    :param output_path: 输出 PDF 文件路径
    :param new_meta: 需要修改或增加的元数据字典,如 {'/Title': '新标题'}
    :param keep_existing: 是否保留原有的其它元数据(默认为 True)
    """
    # 1. 读取原文档
    reader = PdfReader(input_path)
    writer = PdfWriter()

    # 2. 将原文件的所有页面追加到 writer 中
    # PyPDF2 3.0+ 提供了便捷的 append 方法;亦可使用 for page in reader.pages: writer.add_page(page)
    writer.append(reader)

    # 3. 处理元数据字典
    final_metadata = {}

    if keep_existing and reader.metadata:
        # 将原元数据转换为标准字典(注意:reader.metadata 中的键通常自带斜杠)
        for key, value in reader.metadata.items():
            if value is not None:
                final_metadata[str(key)] = str(value)

    # 用新传入的键值覆盖或追加
    for key, value in new_meta.items():
        # 确保键名以 '/' 开头
        standard_key = key if key.startswith('/') else f"/{key}"
        final_metadata[standard_key] = str(value)

    # 4. 写入元数据
    writer.add_metadata(final_metadata)

    # 5. 保存到目标文件
    with open(output_path, "wb") as f_out:
        writer.write(f_out)

    print(f"元数据更新成功,已保存至: {output_path}")

# 使用示例
if __name__ == "__main__":
    updates = {
        "/Title": "深入理解系统架构设计与实践",
        "/Author": "技术写作委员会",
        "/Subject": "分布式微服务与高可用体系",
        "/Keywords": "Python, PyPDF2, 架构, 分布式, 元数据",
        "/Creator": "Python 自动化运维脚本",
        "/Producer": "PyPDF2 Engine 3.0"
    }

update_pdf_metadata("input.pdf", "output.pdf", updates)四、版本演进与 API 规范要点
在网络上搜索 PyPDF2 教程时,经常会看到许多相互冲突的代码写法,这是因为 PyPDF2 经历了几次重要的版本重构。掌握这些变化有助于避免在不同环境下运行时报错:
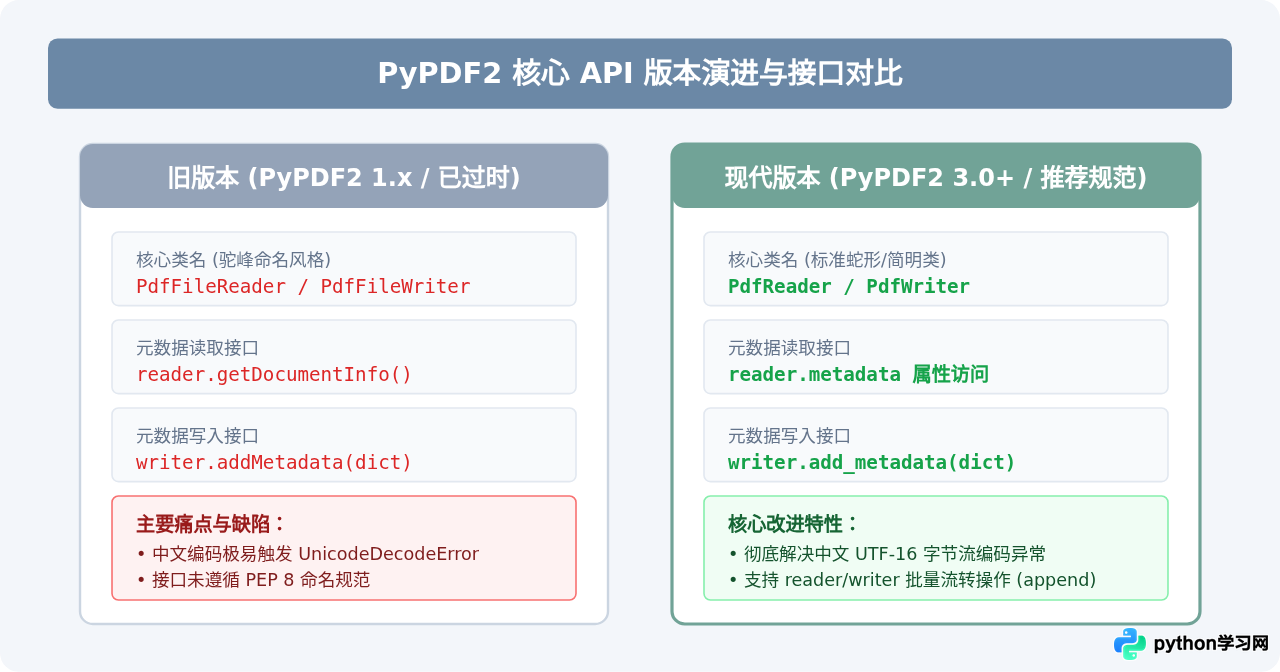
除了类名和方法命名的变动外,以下两点细节在实战中至关重要:
- 生态合并说明:官方在 PyPDF2 3.0 之后宣布将项目名称重聚归并至
pypdf(即pip install pypdf)。如果你使用的是最新的pypdf库,其类名与方法名(如PdfReader、PdfWriter、add_metadata)与 PyPDF2 3.0 完全保持一致,无需修改调用逻辑。 - 键名自动修正:在早期版本中,如果传入没有斜杠前缀的字典键(如
{"Title": "文档"}),可能会导致生成非法字典;而现代 PyPDF2 的add_metadata内部会自动补齐斜杠。但在编写通用脚本时,显式添加斜杠(如"/Title")依然是最稳健的工程实践。
五、进阶技巧:时间戳规范与中文编码细节
1. PDF 标准日期时间格式
元数据中的 /CreationDate 和 /ModDate 并非任意时间字符串,PDF 官方规范定义了严格的 ASN.1 风格时间格式:
D:YYYYMMDDHHmmSSOHH'mm'
例如:D:20261016153000+08'00' 表示北京时间(东八区)2026年10月16日15点30分00秒。如果不按此格式写入,某些严格的 PDF 校验工具或阅读器可能会将其识别为非法字段或直接忽略展示。
from datetime import datetime, timezone, timedelta

def get_pdf_timestamp(dt: datetime = None) -> str:
    """生成符合 PDF 规范的标准时间戳字符串"""
    if dt is None:
        # 默认取当前东八区时间
        tz = timezone(timedelta(hours=8))
        dt = datetime.now(tz)

    # 提取时区偏移
    offset = dt.utcoffset()
    if offset is not None:
        total_seconds = int(offset.total_seconds())
        sign = "+" if total_seconds >= 0 else "-"
        hours, remainder = divmod(abs(total_seconds), 3600)
        minutes, _ = divmod(remainder, 60)
        tz_str = f"{sign}{hours:02d}'{minutes:02d}'"
    else:
        tz_str = "Z"

    return f"D:{dt.strftime('%Y%m%d%H%M%S')}{tz_str}"

# 示例调用
formatted_time = get_pdf_timestamp()
print(f"生成的标准时间戳: {formatted_time}")
# 输出示例: D:20261016153000+08'00'
2. 中文字符与特殊符号转义
在旧版 PyPDF2 时代,元数据中如果包含中文,必须手动编码为 UTF-16BE 字节串并追加 BOM 标头(\xfe\xff),否则打开文档会变成一串问号或乱码。而在 PyPDF2 3.0 及更高版本中,底层已内置了自动识别机制:当发现字符串包含非 ASCII 字符时,库会自动将其打包为符合 PDF 规范的 UTF-16 字节串。因此,开发者直接传入 Python 的原生 str 中文字符串即可,无需手动进行编码转换。
六、常见问题排查与关键操作总结
在实际修改 PDF 元数据头部时,开发者常会遇到以下几种典型问题:
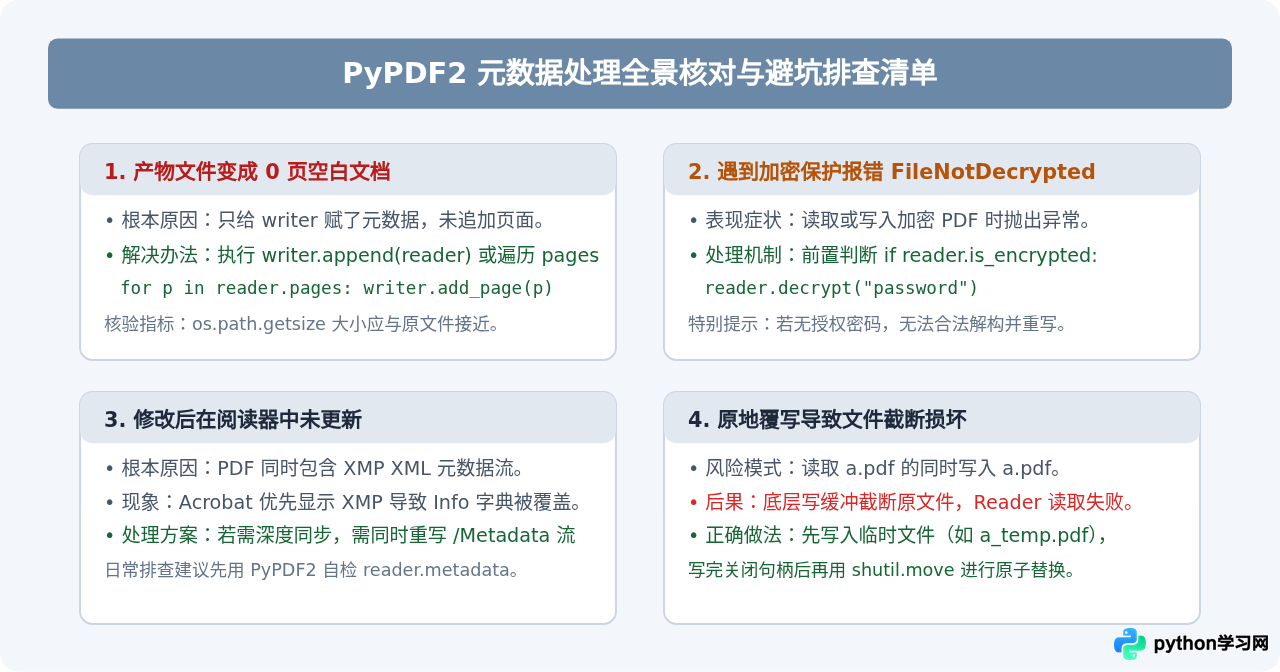
常见操作速查对照表
| 操作诉求 | 推荐现代 API (PyPDF2 3.0+) | 核心注意事项 |
|---|---|---|
| 打开并读取现有元数据 | reader = PdfReader("in.pdf") |
返回值支持以属性或字典项访问;若无元数据则返回 None。 |
| 追加页面至写入器 | writer.append(reader) |
不可遗漏,否则导出的新 PDF 不包含任何文档页面。 |
| 设置/修改文档元数据 | writer.add_metadata({"/Title": "..."}) |
键名以斜杠开头;传原生字符串即可,内部已自动处理 UTF-16 编码。 |
| 清空原有的所有元数据 | writer.add_metadata({})(不迁移旧字典) |
通过仅传入空字典或全新键值,可达到抹除历史作者与软件痕迹的效果。 |
| 导出持久化新文件 | with open("out.pdf", "wb") as f: |
必须以二进制写模式("wb")打开文件,避免在原文件上直接写。 |
综上所述,使用 Python 和 PyPDF2 修改 PDF 文件的元数据头部并不复杂,关键在于理解 PDF 的文件构造逻辑:不直接原地篡改,而是借助 PdfReader 与 PdfWriter 形成标准的数据管道,将原页面流完整迁移,并由写入器重新生成匹配的元数据字典与交叉引用表。掌握上述标准规范后,即可轻松将元数据批量修订与维护集成到各类自动化流水线中。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









