

Python前后双下划线魔术方法的作用与常见示例
深入解析Python前后双下划线魔术方法(Dunder Methods)的核心作用、触发机制与代码实践,涵盖生命周期、容器协议、运算符重载及避坑指南。
一、魔术方法的核心作用与解释器触发机制
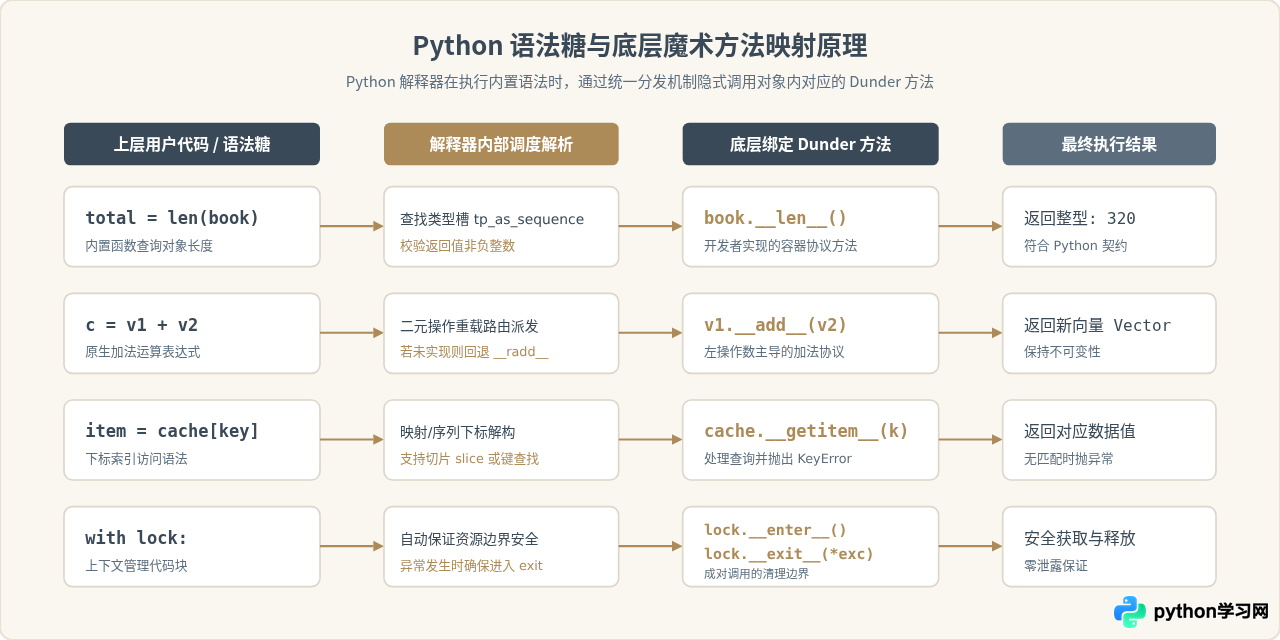
在面向对象设计中,不同编程语言实现“运算符重载”与“原生语法支持”的方式各异。Python采用了一套高度统一且透明的协议约定机制:解释器通过预定义的一系列特殊方法名,将顶层的语法糖与底层的对象操作绑定在一起。
例如,当我们执行 len(my_list) 时,Python解释器并没有直接去读取容器内部的某个长度计数器,而是转去调用 my_list.__len__();当我们写下 a + b 时,解释器会优先寻找 a.__add__(b)。这种机制让自定义对象能够像整数、列表、字典等内置数据类型一样,支持切片、迭代、比较、算术运算以及上下文管理。
二、对象生命周期:创建、初始化与销毁
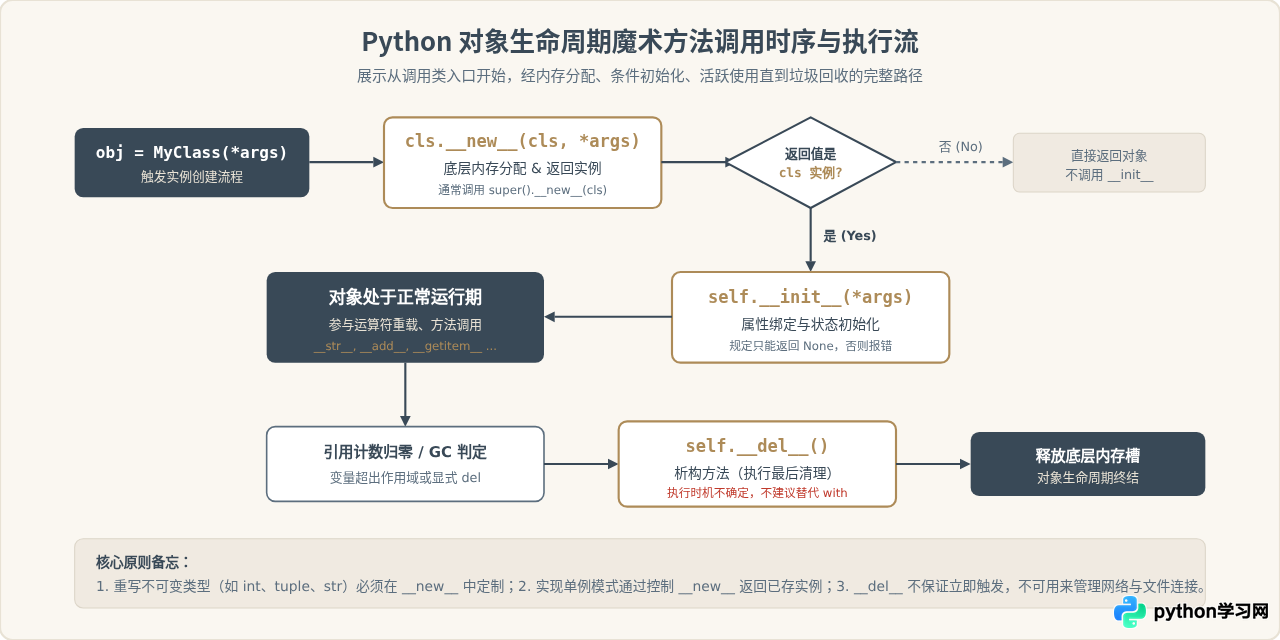
在面向对象编程中,最常接触的魔术方法是 __init__。但严格来说,__init__ 并不是对象的“构造函数”(Constructor),真正的构造工作是由 __new__ 完成的。
1. __new__ 与 __init__ 的分工与协作
__new__(cls, *args, **kwargs):负责在内存中创建并返回一个新的对象实例。它是一个静态方法(即使不加@staticmethod装饰),第一个参数是当前类cls。__init__(self, *args, **kwargs):负责对已经创建好的实例self进行属性初始化与赋值。它不能有返回值(只能返回None)。
只有当 __new__ 返回的是当前类 cls 的实例时,Python 解释器才会继续自动调用 __init__;如果 __new__ 返回了其他类型的对象或 None,则 __init__ 完全不会被触发。
下面是一个使用 __new__ 实现单例模式(Singleton)的标准示例:
class DatabaseConnection:
    _instance = None

    def __new__(cls, *args, **kwargs):
        if cls._instance is None:
            # 首次调用时分配内存并创建单例
            cls._instance = super().__new__(cls)
            cls._instance._initialized = False
        return cls._instance

    def __init__(self, db_url: str):
        # 避免每次获取实例时重复执行初始化逻辑
        if not getattr(self, "_initialized", False):
            self.db_url = db_url
            self._initialized = True
            print(f"[Init] 连接初始化成功: {self.db_url}")

# 测试验证单例特性
conn1 = DatabaseConnection("postgresql://localhost:5432/app")
conn2 = DatabaseConnection("postgresql://localhost:5432/backup")

print(f"conn1 is conn2: {conn1 is conn2}")
print(f"conn2.db_url: {conn2.db_url}")conn1 is conn2: True
conn2.db_url: postgresql://localhost:5432/app
三、对象字符串表示:__str__ 与 __repr__
在调试代码或输出日志时,如果一个类没有自定义字符串表示,默认会输出形如 <__main__.User object at 0x7f8b90> 的内存地址,这对于排查问题非常不便。Python 提供了两个互补的魔术方法来解决这个问题:
__repr__(self):面向开发者。目标是“准确、明确、无歧义”,理想情况下其返回值应该是一段合法的 Python 代码表达式(能够通过eval(repr(obj)) == obj还原对象)。在 Python 交互式环境直接回车、或者在列表中打印元素时,默认调用该方法。__str__(self):面向终端用户。目标是“易读、美观、自然”。当调用print(obj)或str(obj)时被触发。
__repr__!因为当对象未定义 __str__ 时,Python 解释器会自动把 __repr__ 作为后备替代方案;反之则不然。
class ProductItem:
    def __init__(self, item_id: int, name: str, price: float):
        self.item_id = item_id
        self.name = name
        self.price = price

    def __repr__(self) -> str:
        # 面向开发者的精确表达
        return f"ProductItem(item_id={self.item_id!r}, name={self.name!r}, price={self.price!r})"

    def __str__(self) -> str:
        # 面向用户的友好展示
        return f"商品【{self.name}】 售价: ¥{self.price:.2f}"

item = ProductItem(1001, "机械键盘", 399.0)

# 打印单一对象(触发 __str__)
print(str(item))

# 容器内部打印(触发 __repr__)
print([item])[ProductItem(item_id=1001, name='机械键盘', price=399.0)]
四、核心协议分类与常见魔术方法矩阵
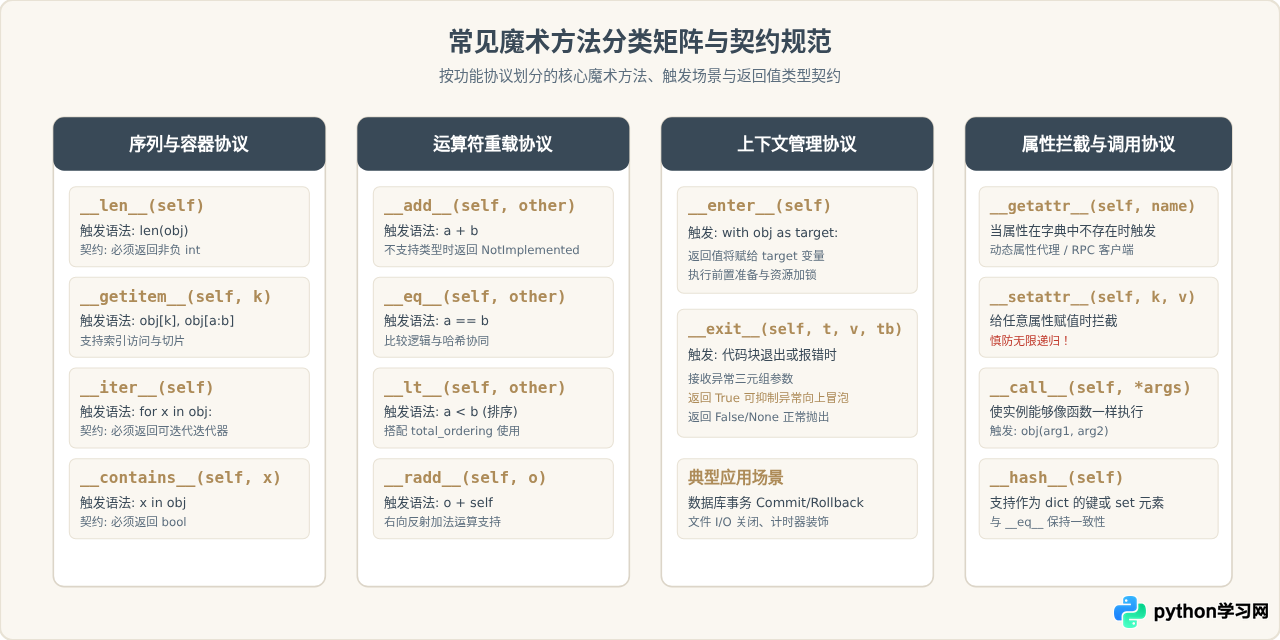
除了对象构建与字符串呈现,魔术方法最强大的地方在于能够赋予自定义类以“协议特性”。Python 遵循鸭子类型哲学(Duck Typing),只要一个类实现了某种协议规定的魔术方法,它就能直接参与到对应的语法体系中。
五、常见场景实战代码示例
1. 容器与迭代协议实战:打造可切片的任务流水线
在日常开发中,我们常常希望自定义的批处理集合能够像内置列表一样,通过 len() 获取待办数,支持 for item in pipeline 遍历,以及通过 pipeline[0:5] 截取切片。实现 __len__ 与 __getitem__ 即可无缝满足这一需求。
class TaskPipeline:
    def __init__(self, initial_tasks=None):
        self._tasks = list(initial_tasks) if initial_tasks else []

    def __len__(self) -> int:
        return len(self._tasks)

    def __getitem__(self, index):
        # 如果传入的是切片 slice 对象,返回一个新的 TaskPipeline 实例保持类型纯正
        if isinstance(index, slice):
            return TaskPipeline(self._tasks[index])
        return self._tasks[index]

    def __repr__(self) -> str:
        return f"TaskPipeline(total={len(self._tasks)}, tasks={self._tasks!r})"

# 创建流水线
pipeline = TaskPipeline(["解析JSON", "校验数据", "生成报告", "发送邮件", "备份归档"])

print(f"当前任务总数: {len(pipeline)}")
print(f"首个任务: {pipeline[0]}")

# 支持切片
subset = pipeline[1:3]
print(f"切片子集: {subset}")

# 支持直接 for 循环遍历(Python在找不到 __iter__ 时会自动回退到基于 __getitem__ 的索引扫描)
for task in pipeline:
print(f"执行阶段 -> {task}")首个任务: 解析JSON
切片子集: TaskPipeline(total=2, tasks=['校验数据', '生成报告'])
执行阶段 -> 解析JSON
执行阶段 -> 校验数据
执行阶段 -> 生成报告
执行阶段 -> 发送邮件
执行阶段 -> 备份归档
2. 运算符重载实战:二维几何向量(Vector2D)
在科学计算或图形处理中,向量相加、数乘与判等非常普遍。通过重载 __add__、__mul__ 和 __eq__,可以让代码阅读体验完全贴合数学公式:
class Vector2D:
    def __init__(self, x: float, y: float):
        self.x = float(x)
        self.y = float(y)

    def __repr__(self) -> str:
        return f"Vector2D({self.x}, {self.y})"

    def __add__(self, other):
        if not isinstance(other, Vector2D):
            return NotImplemented
        return Vector2D(self.x + other.x, self.y + other.y)

    def __mul__(self, scalar):
        # 支持标量乘法: vector * 3
        if not isinstance(scalar, (int, float)):
            return NotImplemented
        return Vector2D(self.x * scalar, self.y * scalar)

    def __rmul__(self, scalar):
        # 支持反射数乘: 3 * vector
        return self.__mul__(scalar)

    def __eq__(self, other):
        if not isinstance(other, Vector2D):
            return False
        return self.x == other.x and self.y == other.y

v1 = Vector2D(3.0, 4.0)
v2 = Vector2D(1.0, 2.0)

print(f"向量相加: {v1 + v2}")
print(f"正向标量乘: {v1 * 2}")
print(f"反向标量乘: {3 * v2}")
print(f"向量判等: {v1 == Vector2D(3.0, 4.0)}")正向标量乘: Vector2D(6.0, 8.0)
反向标量乘: Vector2D(3.0, 6.0)
向量判等: True
3. 上下文管理实战:耗时统计与异常守护
with 语句背后的 __enter__ 和 __exit__ 是编写高可靠性资源管理代码的最佳实践。无论代码块内部是否抛出异常,__exit__ 都会得到可靠执行:
import time

class PerformanceTimer:
    def __init__(self, task_name: str):
        self.task_name = task_name
        self.start_time = 0.0

    def __enter__(self):
        print(f"[{self.task_name}] 开始执行...")
        self.start_time = time.perf_counter()
        return self

    def __exit__(self, exc_type, exc_val, exc_tb):
        duration = time.perf_counter() - self.start_time
        if exc_type is not None:
            print(f"[{self.task_name}] 执行异常! 耗时: {duration:.4f}s, 错误: {exc_val}")
            # 返回 False 让异常继续向上层传播;若返回 True 则会吞掉异常
            return False
        print(f"[{self.task_name}] 顺利完成, 总耗时: {duration:.4f}s")
        return True

# 正常执行场景
with PerformanceTimer("数据批处理"):
time.sleep(0.05)[数据批处理] 顺利完成, 总耗时: 0.0503s
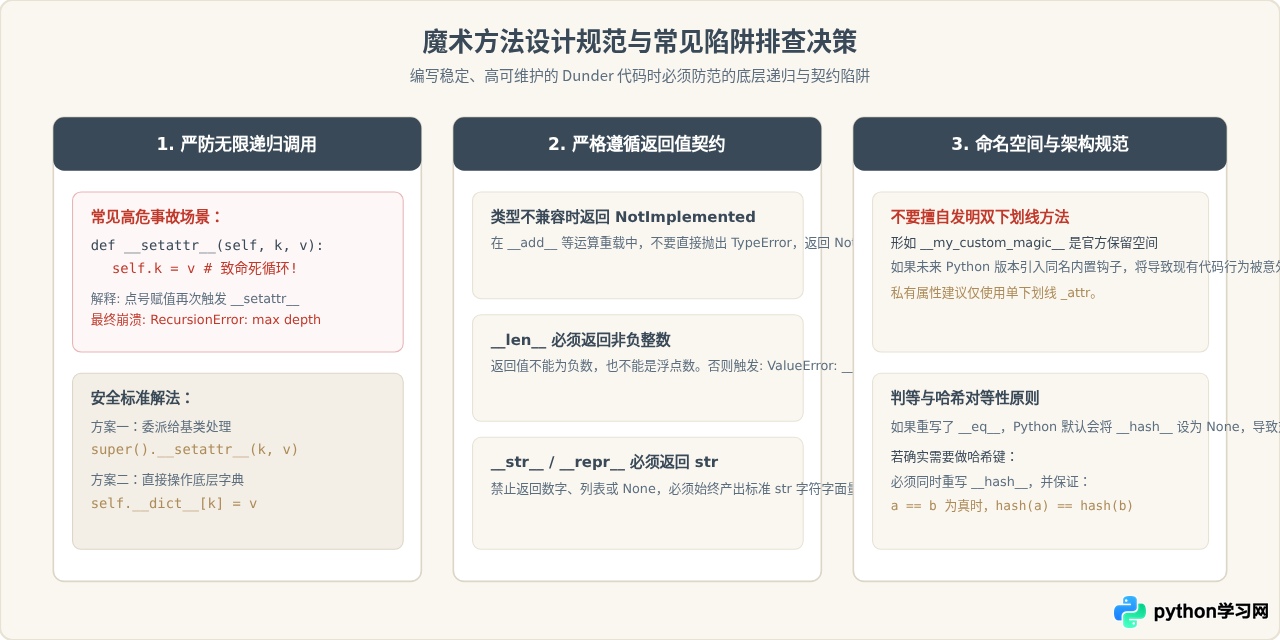
六、魔术方法的设计规范与避坑决策
魔术方法赋予了开发者拦截语言行为的底层能力,但“能力越大,陷阱越多”。在实际项目中实现魔术方法时,需严格遵循以下核心准则与边界防范:
七、总结
Python的前后双下划线魔术方法构成了这门语言优雅、表现力丰富的基础协议。在实际项目开发中:
- 对于绝大多数业务类,优先实现清晰易懂的
__repr__,能够显著提升调试效率; - 设计自定义数据结构或管理类时,按需实现序列协议(
__len__、__getitem__)或上下文协议(__enter__、__exit__),使对象自然融入原生语法; - 严格防范
__setattr__和__getattr__中的无限递归风险,坚决不擅自发明前后双下划线私有函数,维护代码的长期稳定性。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









