

Python小型项目数据库设计:基于SQLite与轻量级ORM的快速构建
针对Python小型项目与独立工具,详解基于SQLite与轻量级ORM的数据库架构设计、模型建立、事务处理及性能保障策略。
一、架构选型:原生 sqlite3 模块与轻量级 ORM 的权衡
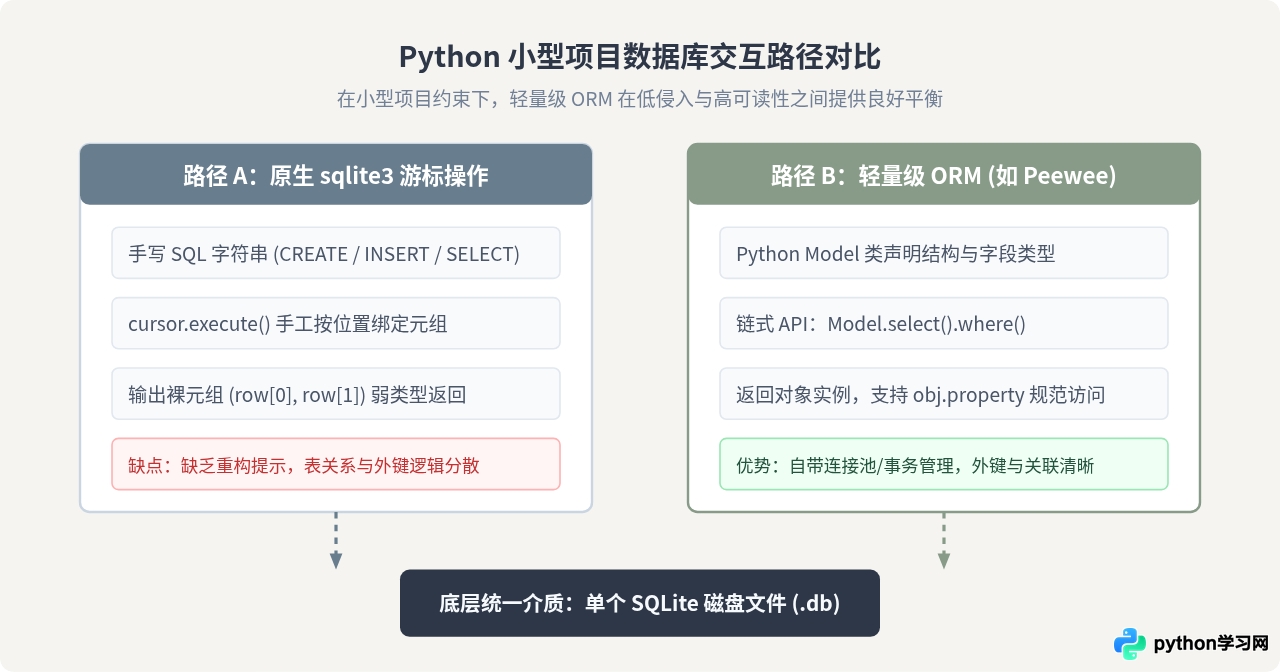
Python 内置了 sqlite3 驱动,可以直接通过 SQL 字符串和游标(Cursor)完成存取。但在实际业务迭代中,纯原生 SQL 方案与轻量级 ORM 在开发体验和维护成本上存在明确分界。
| 对比维度 | 原生 sqlite3 模块 | 轻量级 ORM(如 Peewee) |
|---|---|---|
| 开发上手方式 | 手写 DDL 与 DML 字符串,手动管理参数元组绑定 | 使用 Python 类与字段属性声明结构,面向对象操作 |
| 数据映射与读取 | 返回原生元组或需配置 Row 工厂,按索引或字典读取 | 自动转换为模型实例,直接以属性方式访问字段 |
| 重构与字段变动 | 字段重命名或调整类型需全量全局搜索替换 SQL 文本 | 类属性集中定义,IDE 代码补全与静态检查支持良好 |
| 外部依赖与体积 | 零依赖,标准库自带 | 单一极小依赖包,代码体量小,学习曲线平缓 |
对于一次性、五行以内的临时数据导出脚本,原生 sqlite3 最省事;但只要项目涉及多个实体关联、数据状态流转或长线维护,轻量级 ORM 就能在几乎不增加运行负担的前提下,消除硬编码 SQL 带来的低级拼写错误。
二、快速构建步骤:从零搭建轻量持久化层
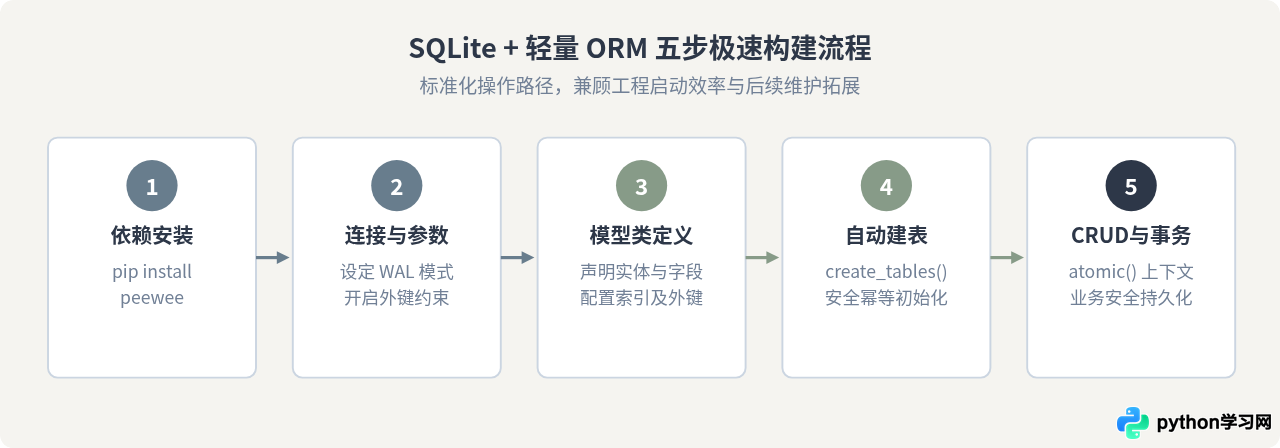
构建基于 SQLite 的持久化层,整个过程可以拆分为五个连续步骤。按照该流程推进,能确保数据库配置合理、模型映射准确且具备健壮的事务支持。
步骤 1:安装依赖
在虚拟环境中使用 pip 安装 Peewee:
pip install peewee步骤 2:初始化数据库连接与开启核心 PRAGMA
SQLite 默认采用回滚日志(Rollback Journal)且默认不开启外键约束检查。在初始化连接时,必须显式启用 foreign_keys = ON 与 journal_mode = WAL。
# database.py
from peewee import SqliteDatabase

# 初始化 SQLite 数据库实例并配置关键参数
db = SqliteDatabase(
    "app.db",
    pragmas={
        "journal_mode": "wal",       # 开启预写日志,大幅提升并发读写性能
        "foreign_keys": 1,           # 强制开启外键完整性约束
        "ignore_check_constraints": 0,
        "synchronous": 1             # NORMAL 同步模式,兼顾安全性与写入吞吐
    }
)
步骤 3:定义基础模型与业务数据表
通过继承基类集中绑定数据库连接,后续所有数据模型均继承自此基类:
# models.py
import datetime
from peewee import (
    Model, AutoField, CharField, TextField,
    DateTimeField, ForeignKeyField, IntegerField
)
from database import db

class BaseModel(Model):
    class Meta:
        database = db

class User(BaseModel):
    id = AutoField()
    username = CharField(max_length=64, unique=True, index=True)
    email = CharField(max_length=128, unique=True)
    created_at = DateTimeField(default=datetime.datetime.now)

class Post(BaseModel):
    id = AutoField()
    author = ForeignKeyField(User, backref="posts", on_delete="CASCADE")
    title = CharField(max_length=200)
    content = TextField()
    views = IntegerField(default=0)
    created_at = DateTimeField(default=datetime.datetime.now)
步骤 4:自动化建表
利用 create_tables 自动检测并创建不存在的物理表:
def init_db():
    with db:
        # safe=True 保证表已存在时不抛出异常
        db.create_tables([User, Post], safe=True)

if __name__ == "__main__":
    init_db()
    print("数据库初始化完成:app.db")
三、实体关联与模型设计:一对多与多对多的标准实现
小型项目中最常见的两种关联关系是一对多(如用户与文章)和多对多(如文章与标签)。良好的外键级联与索引规划是保证数据一致性的关键。
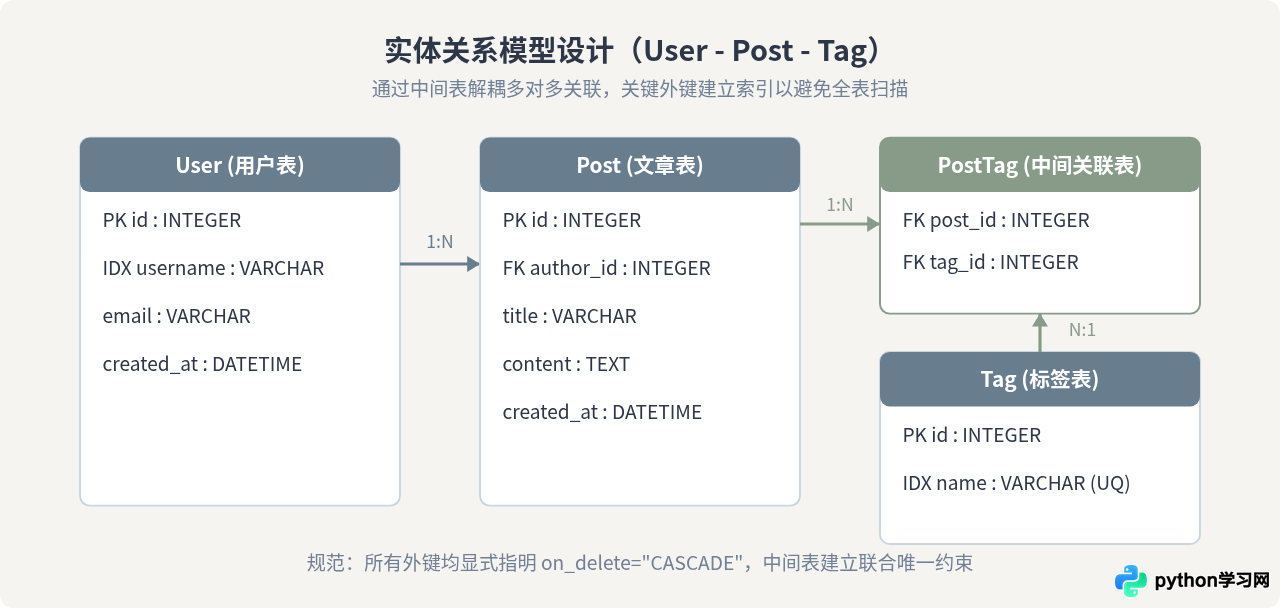
多对多模型的 Python 代码声明如下,利用联合唯一索引避免重复给文章贴相同标签:
class Tag(BaseModel):
    id = AutoField()
    name = CharField(max_length=32, unique=True, index=True)

class PostTag(BaseModel):
    post = ForeignKeyField(Post, on_delete="CASCADE")
    tag = ForeignKeyField(Tag, on_delete="CASCADE")

    class Meta:
        # post 与 tag 联合唯一,防止重复打标
        indexes = (
            (("post", "tag"), True),
        )
四、安全增删改查与事务控制
SQLite 支持事务,但在小型应用中容易因缺少批量处理或未捕获异常导致数据库死锁(sqlite3.OperationalError: database is locked)。合理使用事务上下文是保证数据安全的核心。
1. 批量插入优化
逐条调用 Model.create() 在处理数千条数据时极其缓慢,因为每条默认会触发独立的磁盘写入刷新。必须使用 insert_many() 或配合 atomic() 批量提交:
# 批量写入示例:单次事务提交 1000 条记录
user = User.get(User.username == "alice")
posts_data = [
    {"author": user, "title": f"第 {i} 篇日志", "content": "正文内容..."}
    for i in range(1000)
]

with db.atomic():
    # 每 200 条分批执行单次 INSERT 语句
    Post.insert_many(posts_data).execute()
2. 事务与原子操作
涉及账户结算、状态级联修改的多步操作,必须包裹在 with db.atomic(): 块中。如果在块内发生未捕获异常,Peewee 会自动触发 SQLite 回滚:
def transfer_post_ownership(post_id: int, new_author_id: int):
    with db.atomic() as txn:
        try:
            post = Post.get_by_id(post_id)
            target_user = User.get_by_id(new_author_id)

            post.author = target_user
            post.save()
        except Exception as e:
            # 显式回滚或自动抛出异常回滚
            txn.rollback()
            raise RuntimeError(f"所有权转移失败,已自动回滚: {e}")
with db.atomic() 事务块进行耗时的网络请求或磁盘读写,应当仅在纯数据库操作的一瞬间开启并提交事务。
五、生产可用性保障与关键检查项
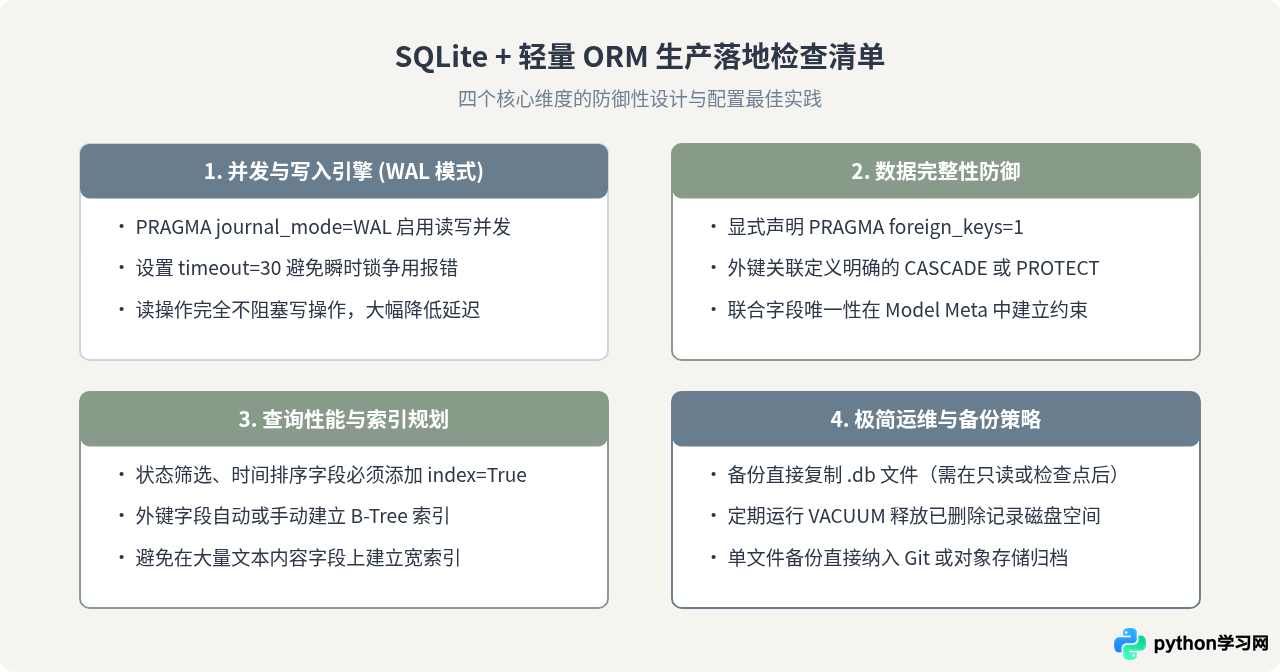
很多小型项目在部署运行一段时期后出现变慢或锁表,往往并非 SQLite 能力不足,而是缺少了几项关键的运行期配置。
六、总结
Python 小型项目的数据库设计核心在于“恰到好处的约束与极低的维护成本”。通过将存储介质收敛为单一的 SQLite 文件,利用轻量级 ORM 屏蔽手动编写 SQL 的低级语法问题与类型丢失,同时配齐 WAL 模式和外键约束,就能在几分钟内搭建出一套兼具高开发效率与长期稳定性的数据持久层架构。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









