

Python csv库怎么自定义分隔符delimiter和引号规则
详细讲解 Python 内置 csv 模块如何自定义分隔符 delimiter、引号包裹规则 quotechar、quoting 四种引用模式、转义字符 escapechar 以及方言 Dialect 注册机制,包含完整的代码示例、架构原理图解与常见错误排查。
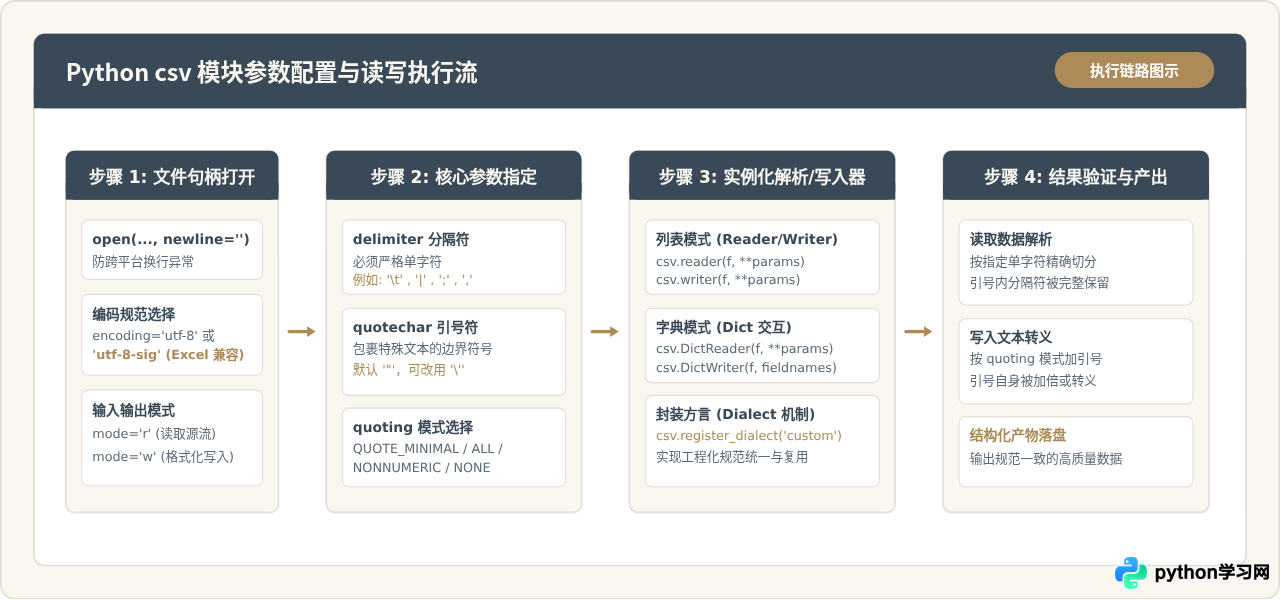
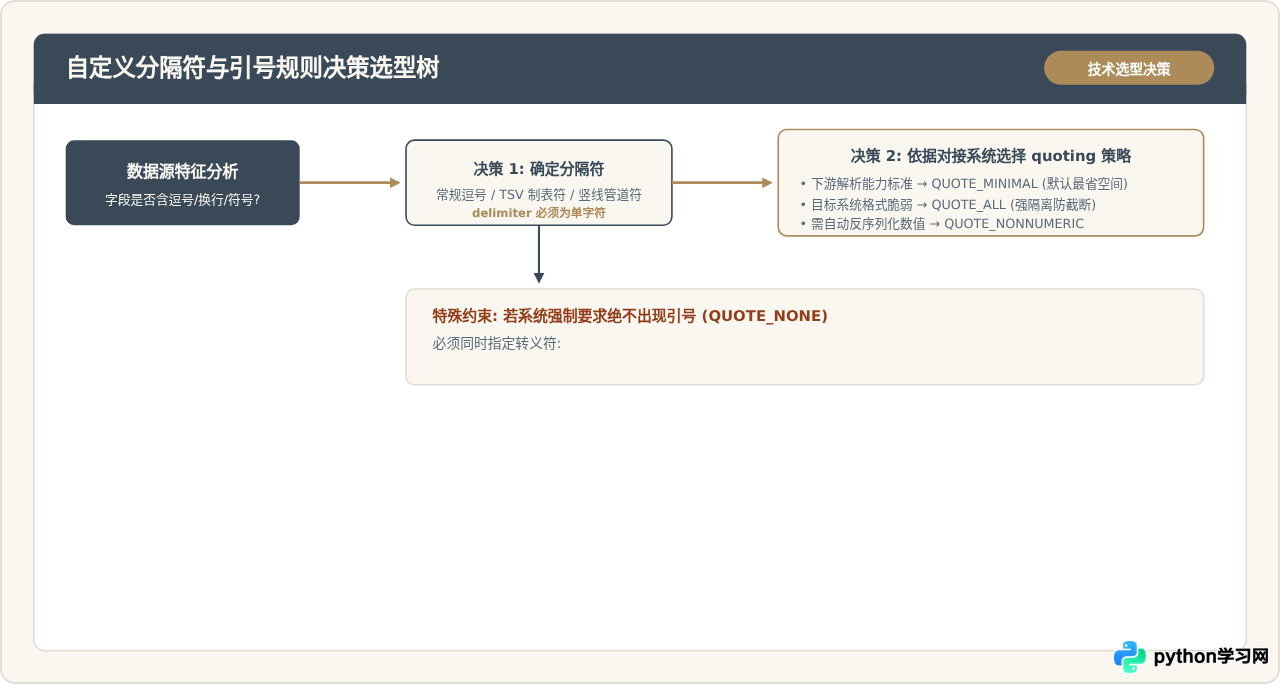
在 Python 中处理结构化文本时,标准库 csv 默认遵循 RFC 4180 规范(逗号 , 分隔、双引号 " 包裹特殊字符)。面对制表符(TSV)、竖线管道符 |、分号 ; 等异构格式,或者特定的全字段加引号、禁用转义等需求,可以通过为 csv.reader 与 csv.writer 传递 delimiter、quotechar、quoting、escapechar 参数,或直接注册复用自定义 Dialect(方言)来精准控制读写规则。
一、自定义分隔符 delimiter 的配置与使用
分隔符(Delimiter)是 CSV 文件中用于区分字段边界的关键字符。Python csv 模块的默认分隔符为英文逗号 ','。但在许多实际业务中,由于字段内容本身可能经常包含逗号(例如英文句子、带千分位的货币格式、地理坐标等),系统导出的文本文件往往会改用制表符 '\t'(即 TSV)、竖线 '|' 或分号 ';'。
无论是数据读取还是生成,只需向 csv.reader()、csv.writer()、csv.DictReader() 或 csv.DictWriter() 显式传入 delimiter 关键字参数即可完成定制。
1. 写入非标分隔符文本文件
下面的代码演示如何使用竖线 '|' 作为字段分隔符生成数据文件。注意在调用 open() 时始终指定 newline='',这是标准库官方推荐的标准实践,可防止在 Windows 等跨平台系统上自动多写额外的空行。
import csv

records = [
    ["商品编号", "商品名称", "规格型号", "单价"],
    ["SKU-1001", "机械键盘, 87键", "茶轴|有线", 299.0],
    ["SKU-1002", "无线鼠标", "静音|黑", 89.5]
]

# 自定义分隔符为竖线 '|'
with open("products.psv", mode="w", encoding="utf-8", newline="") as f:
    writer = csv.writer(f, delimiter="|")
    writer.writerows(records)
2. 读取自定义分隔符文件
读取上述生成的竖线分隔文件时,必须向 csv.reader 提供完全一致的 delimiter="|"。若不指定,解析器仍按默认逗号解析,导致整行文本被误识别为单个字段:
import csv

with open("products.psv", mode="r", encoding="utf-8", newline="") as f:
    reader = csv.reader(f, delimiter="|")
    for row in reader:
        print(row)

# 控制台输出:
# ['商品编号', '商品名称', '规格型号', '单价']
# ['SKU-1001', '机械键盘, 87键', '茶轴|有线', '299.0']
# ['SKU-1002', '无线鼠标', '静音|黑', '89.5']delimiter 参数必须是严格的单字符(1-character string)。如果传入包含两个或更多字符的字符串(例如 delimiter="::" 或 delimiter="||"),Python 解释器会立即抛出 TypeError: "delimiter" must be a 1-character string 异常。对于多字符分隔符,需要改用字符串的 split() 或正则表达式 re.split() 处理。
二、深入引号规则:quotechar、quoting 与转义控制
当数据字段内部本身含有分隔符(如含有逗号的文本)、换行符或引号字符时,CSV 生成器必须有一套明确的规则来标记字段边界,否则读取方将无法区分哪些字符是数据、哪些字符是结构标记。这就是引号规则(Quoting Rules)的核心使命。
1. 引号字符 quotechar 与转义逻辑 doublequote
quotechar 指定用来包裹特殊字段的字符,默认为双引号 '"'。如果目标系统要求使用单引号包裹,可配置 quotechar="'"。
当字段内容中已经包含了 quotechar 本身时,如何防止过早闭合?Python 提供了 doublequote 与 escapechar 两个协同参数:
doublequote=True(默认值):遇到引号本身时,采用双写机制转义。例如He said "Hi"写入后变为"He said ""Hi"""。doublequote=False:禁用双写转义。此时必须提供escapechar(如escapechar='\\'),内容将转义为"He said \"Hi\""。
2. 四种 quoting 常量的行为与对比
Python 在 csv 模块内定义了四个常量,用于控制何时对字段施加引号包裹:
| 常量名称 | 数值 | 写入行为 (Writer) | 读取行为 (Reader) | 推荐使用场景 |
|---|---|---|---|---|
csv.QUOTE_MINIMAL |
0 | 仅当字段中包含 delimiter、quotechar 或行终止符时才添加引号(默认行为)。 |
按常规规则去除引号并还原数据。 | 常规业务、最节省存储体积的标准 CSV。 |
csv.QUOTE_ALL |
1 | 对所有字段无条件添加引号,无论是文本还是数值。 | 按常规规则去除包裹的引号。 | 下游对接系统解析脆弱,需强制限定全文本。 |
csv.QUOTE_NONNUMERIC |
2 | 仅对非数值字段(字符串)添加引号,整数和浮点数不加引号。 | 自动将所有未加引号的字段转为 float 类型。 | 明确区分数值与字符串类型的数据交换管道。 |
csv.QUOTE_NONE |
3 | 无论字段包含什么,绝不添加任何引号。 | 将引号作为普通文本字符原样读取。 | 严格要求无引号格式。若遇分隔符必须配 escapechar。 |
3. 代码示例:不同 quoting 模式下的输出差异
import csv
import sys

data = [
    ["ID", "Name", "Score", "Remark"],
    [101, "Alice, W.", 95.5, "Passed"],
    [102, "Bob", 88.0, "Contains|Pipe"]
]

print("--- 1. QUOTE_MINIMAL (默认模式) ---")
writer = csv.writer(sys.stdout, delimiter="|", quoting=csv.QUOTE_MINIMAL)
writer.writerows(data)

print("\n--- 2. QUOTE_ALL (全字段包裹) ---")
writer = csv.writer(sys.stdout, delimiter="|", quoting=csv.QUOTE_ALL)
writer.writerows(data)

print("\n--- 3. QUOTE_NONNUMERIC (非数值包裹) ---")
writer = csv.writer(sys.stdout, delimiter="|", quoting=csv.QUOTE_NONNUMERIC)
writer.writerows(data)

print("\n--- 4. QUOTE_NONE (无引号,依赖 escapechar 转义) ---")
writer = csv.writer(sys.stdout, delimiter="|", quoting=csv.QUOTE_NONE, escapechar="\\")
writer.writerows(data)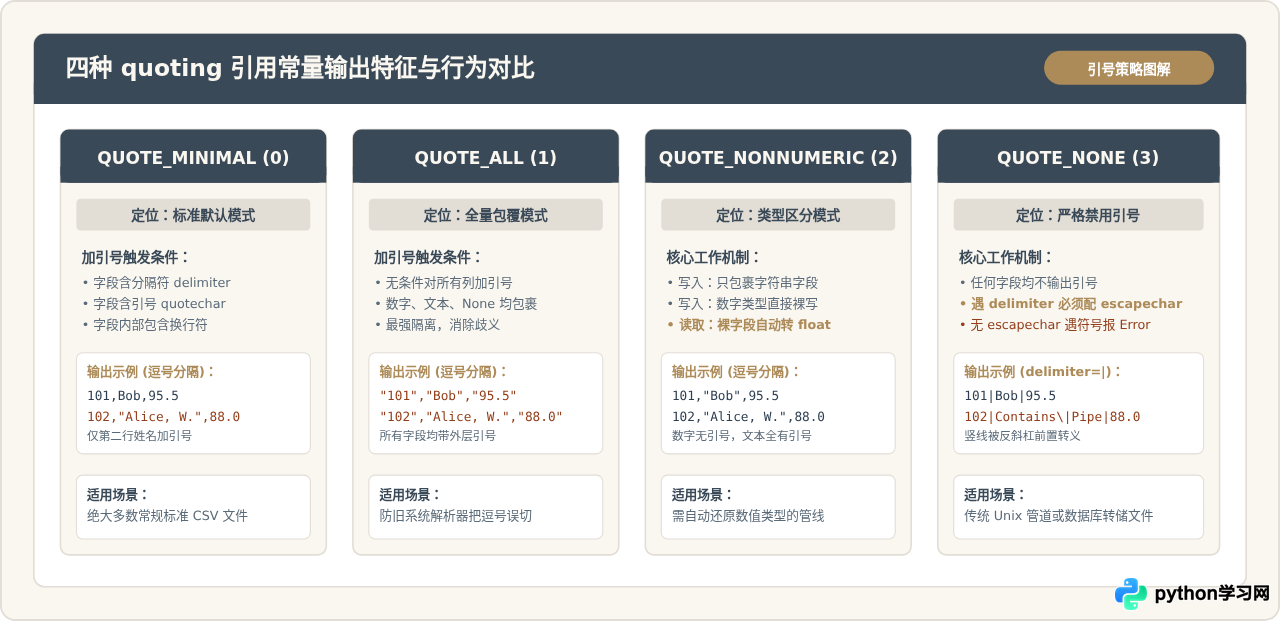
三、底层解析机制:状态机模型与转义判定
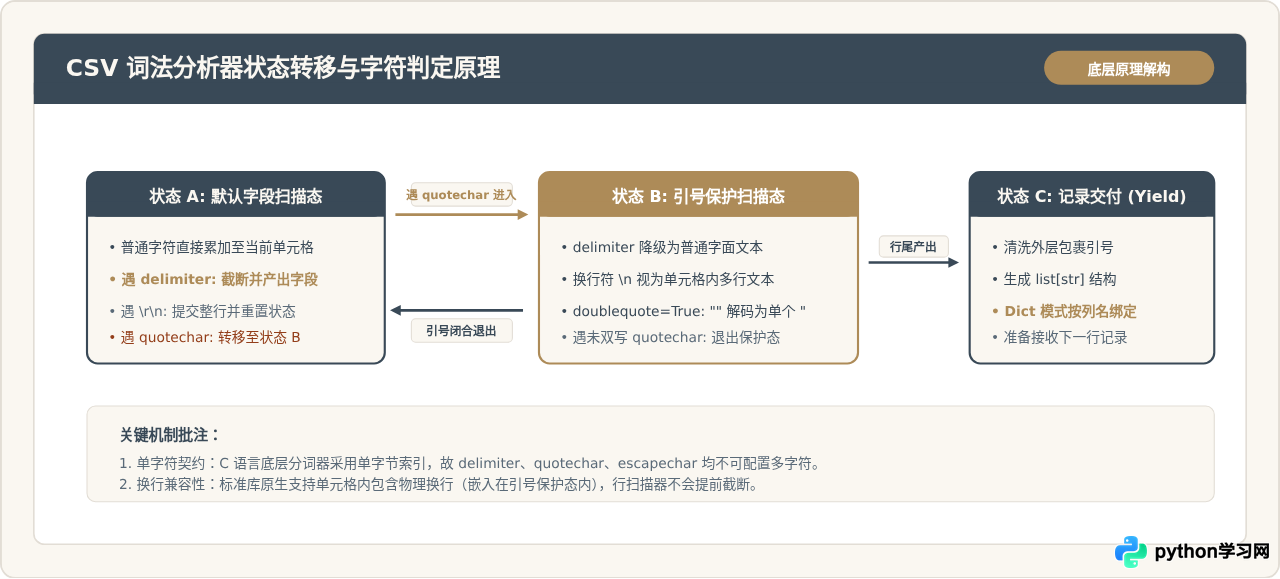
了解 Python csv 解析器的内部原理,有助于在排查解析异常或格式混乱时迅速定位原因。Python 底层的 CSV 核心是用 C 语言编写的有限状态自动机(FSM)。
当解析器从流中逐字符读取时,它主要在两个基础状态之间转移:未引用状态(Unquoted Field)与引用状态(Quoted Field)。
- 未引用状态下:只要遇到
delimiter,当前收集的字符即作为一个完整字段发射(Emit),并清空缓冲区;只要遇到\r或\n,整行记录结束;一旦遇到quotechar,状态立即切换为“引用状态”。 - 引用状态下:任何
delimiter、制表符甚至换行符都会被视为普通字符并追加至缓冲区。直到再次遇到quotechar时,解析器根据doublequote决定是转义还是结束引用状态。
四、使用自定义 Dialect(方言)实现规则复用
在大型项目或流水线任务中,如果每一处调用 csv.reader 或 csv.writer 都重复书写长串的关键字参数(如 delimiter="|", quoting=csv.QUOTE_ALL, quotechar="'" 等),不仅冗长,而且一旦格式调整极易出现配置不一致。
Python 提供了 Dialect(方言)机制,将分隔符、引号、换行符等完整规则打包成一个独立的命名配置。
1. 注册与使用方言
import csv

# 1. 注册名为 'custom_pipe' 的自定义方言
csv.register_dialect(
    "custom_pipe",
    delimiter="|",
    quoting=csv.QUOTE_MINIMAL,
    quotechar='"',
    doublequote=True,
    lineterminator="\r\n",
    skipinitialspace=True  # 忽略分隔符后紧跟的空格
)

rows = [
    ["ID", "Department", "Note"],
    ["D-01", "研发部", "核心技术组"],
    ["D-02", "市场部, 华东区", "重点客户"]
]

# 2. 写入时直接引用方言名称
with open("org.psv", mode="w", encoding="utf-8", newline="") as f:
    writer = csv.writer(f, dialect="custom_pipe")
    writer.writerows(rows)

# 3. 读取时直接指定同一方言
with open("org.psv", mode="r", encoding="utf-8", newline="") as f:
    reader = csv.reader(f, dialect="custom_pipe")
    for row in reader:
        print(row)
2. 通过类继承定义方言
除了调用 register_dialect() 传参外,还可以直接继承 csv.Dialect 基类并声明属性,这种方式在面向对象架构中更为清晰:
import csv

class LogFileDialect(csv.Dialect):
    delimiter = "\t"          # 制表符分隔
    quotechar = "'"           # 单引号包裹
    doublequote = False       # 禁用双写转义
    escapechar = "\\"         # 使用反斜杠转义
    quoting = csv.QUOTE_ALL   # 所有字段强制包裹
    lineterminator = "\n"     # 换行符设定

# 注册类方言
csv.register_dialect("log_format", LogFileDialect)
五、常见问题排查与避坑指南
-
TypeError: "delimiter" must be a 1-character string
原因:试图将
delimiter="###"或delimiter="\s+"传给 csv 库。解决方案:确保 delimiter 为严格的单字符,如'\t'或'|'。 -
csv.Error: need to escape, but no escapechar set
原因:设置了
quoting=csv.QUOTE_NONE,但当写入字段包含delimiter字符时,既不准加引号又没有提供escapechar,导致无法处理歧义。解决方案:在QUOTE_NONE模式下显式指定escapechar='\\'。 -
Excel 打开 CSV 出现中文乱码或首列带 \ufeff
原因:Windows 上的 Excel 默认依赖带有 UTF-8 BOM 头来识别 Unicode。如果纯 UTF-8 导出,Excel 可能使用本地编码(如 GBK)打开造成乱码。解决方案:在写入文件时使用
encoding="utf-8-sig"。 -
ValueError: could not convert string to float
原因:读取时使用了
quoting=csv.QUOTE_NONNUMERIC,此模式会强行把所有未用引号包裹的字段尝试转为float。若某文本字段原文件并未带引号,转换便会失败。解决方案:仅在数据源格式规范且确定未加引号内容纯为数值时使用。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









