

Python在线编译器代码运行超时怎么办?优化策略与限制解析
针对Python在线编译器常见的代码运行超时报错,系统解析沙箱资源限制机制,提供从死循环排查、算法复杂度优化到I/O加速的具体解决方案。
在网页端在线编译器编写 Python 代码时,遇到“Execution Timed Out”或“Time Limit Exceeded”提示,通常由两大根源引发:一是平台后端沙箱设定的硬性时间与计算资源配额已达上限;二是代码逻辑存在死循环、过高的渐近复杂度(如 O(n²) 甚至指数级运算)或未处理的阻塞式输入。本文将全面解析线上编译器的运行限制机制,提供一套清晰的排查修复流程及针对性的代码优化方案。
一、认识在线编译器的运行限制机制
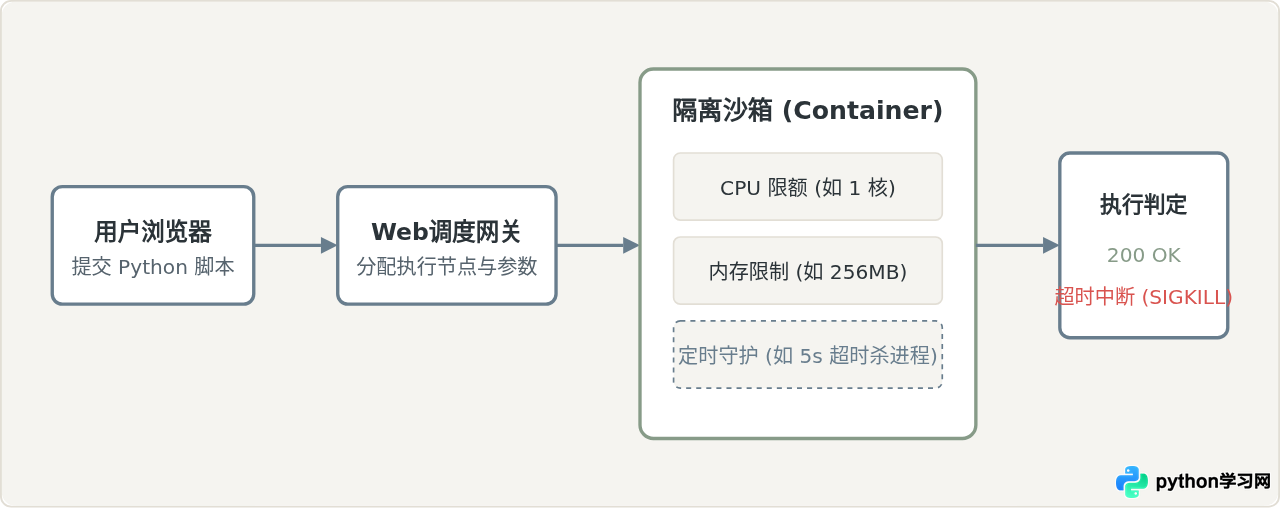
为了防止恶意挖矿、拒绝服务攻击(DoS)以及无止境占用多租户服务器资源,各类在线运行环境(如各类在线刷题判题系统、云端交互式 Notebook 以及简易在线解释器)都会在容器层面施加严格的边界保护。
这些限制并非单纯针对 Python 这门语言,而是由底层操作系统机制共同决定的:
- 单次执行时限(Wall Time 与 CPU Time):绝大多数网页工具对单次执行的时间硬限制设定在 3秒 至 15秒 之间。若包含网络通信延迟或排队,可能稍有不同,但计算核实际占用的时间通常极短。
- 内存使用上限:通常限制在 128MB 到 512MB 之间。一旦内存超标,进程常被直接终止(OOM Killer),在部分系统上这也会间接表现为任务无响应继而报出超时。
- 交互式 I/O 阻塞:线上环境通常没有真实的终端交互。如果代码中写了
input()却未提前在平台的“标准输入(Stdin)”面板填入数据,解释器将无限期挂起等待流输入,最终触发平台的强制熔断。
二、四步排查法:从低级错误到性能瓶颈
当遇到超时错误时,不要盲目重写整段业务,建议按照影响面由浅入深进行排查。
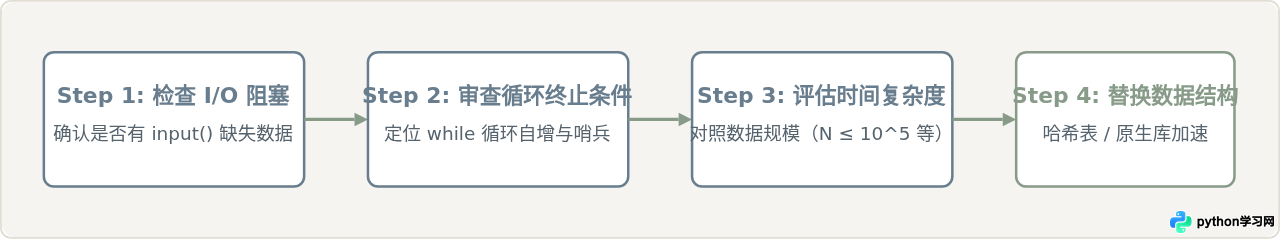
1. 确认是否发生输入阻塞
最隐蔽的超时往往不是因为计算慢,而是因为程序在等输入。比如以下代码:
# 错误示范:在无 Stdin 配置时直接等待
name = input("请输入你的名字:")
print(f"你好, {name}")
若编译器界面的“自定义输入/Stdin”未启用或未预留文本行,沙箱进程将一直保持读状态,直至触发超时熔断。排查方法:先临时注释掉所有 input() 语句,或在调试阶段为输入变量赋予硬编码默认值。
2. 检查循环中的变量递增与递归出口
死循环会瞬间打满分配的单个虚拟 CPU 核心。重点检查 while 循环条件是否能在边界值时正常闭合,以及递归函数是否有漏写的 base case(递归基)。
三、核心优化策略:降低复杂度与提升运行效率
在确认无死循环和 I/O 挂起后,超时几乎都源于算法的时间复杂度超出了在线环境的承载上限。常规 Python 解释器(CPython)在 1 秒内大约能执行 10^7 次 基础操作。根据输入数据规模(N),可以大致框定可行算法的上限:
| 输入规模(N) | 最大可承受时间复杂度 | 典型算法/结构 |
|---|---|---|
| N ≤ 20 | O(2^N) 或 O(N!) | 回溯、深度优先搜索穷举、状态压缩 |
| N ≤ 1,000 | O(N²) | 双重遍历、常见动态规划二维网格 |
| N ≤ 100,000 (10^5) | O(N log N) 或 O(N) | 归并/快速排序、二分查找、单调栈、滑动窗口 |
| N ≥ 1,000,000 (10^6) | O(N) 或 O(log N) | 线性扫描、前缀和、数学计算、常数级哈希查找 |
策略一:将列表线性查找(O(N))转换为哈希查找(O(1))
在 Python 中,使用 in 关键字查找某个元素是否存在时,list 每次都需要从前到后遍历,而 set 或 dict 是基于哈希表实现的,查找平均耗时为常数时间。
# 优化前:双重嵌套循环中使用了列表查找,总体复杂度为 O(M * N)
data_list = [i for i in range(100000)]
query_list = [99999, 88888, 77777]

for q in query_list:
    if q in data_list:  # 每次扫描耗费 O(N)
        pass

# 优化后:转为 set 集合,总体复杂度降为 O(M + N)
data_set = set(data_list)  # 一次性预处理 O(N)
for q in query_list:
    if q in data_set:   # 单次查询仅需 O(1)
        pass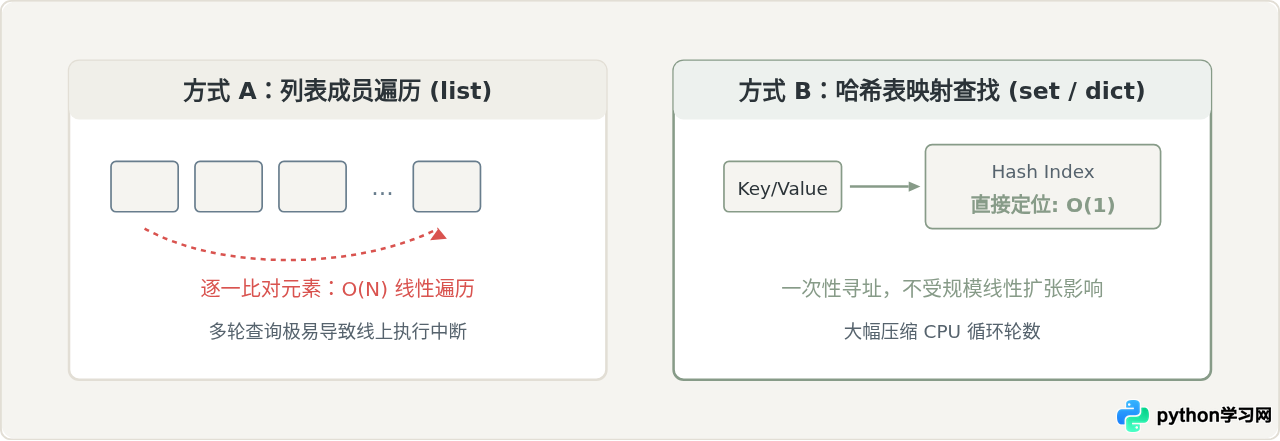
策略二:避免在循环体内频繁进行字符串拼接
Python 中的字符串属于不可变对象(Immutable)。使用 + 拼接字符串时,解释器每次都会开辟新的内存空间并拷贝原有内容。在长循环内连续使用 s += char 会退化成 O(N²) 的复杂度。应当使用数组收集后统一调用 str.join()。
# 优化前:频繁申请内存造成运行拖慢
res = ""
for i in range(100000):
    res += str(i)

# 优化后:先收集为列表,一次性拼接(O(N) 复杂度)
buffer = [str(i) for i in range(100000)]
res = "".join(buffer)
策略三:使用内置模块或标准库的 C 语言实现
Python 原生循环在解释执行时的额外开销相对较高,而 Python 内置的高阶函数和标准库大多由底层 C 语言实现,效率明显优于手动书写的循环代码:
- 优先使用
collections.deque替代list执行队头弹出操作(pop(0)是 O(N) 耗时,而deque.popleft()仅为 O(1))。 - 在计数场景下优先使用
collections.Counter,而非手动用循环更新字典。 - 在数学累加、极值求取时,直接使用
sum()、min()、max()。
print() 进行分步调试。在循环内频繁调用 print() 会产生巨大的 I/O 缓冲刷写开销,哪怕算法本身正确,也很容易因此被判定超时。提交前务必清理非必要的输出代码。
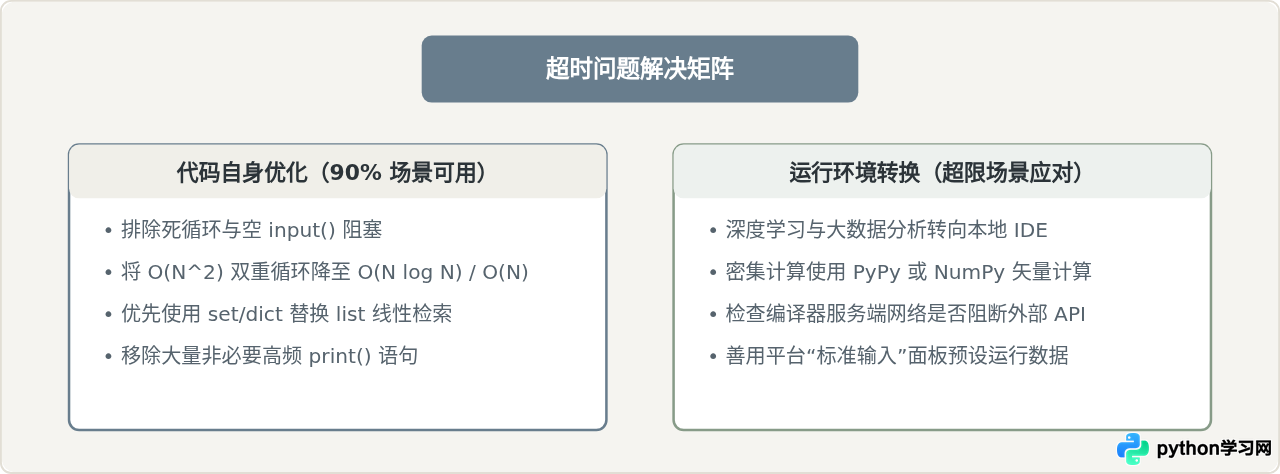
四、应对策略全景总结
面对在线编译器的各类运行限制,我们应建立“明确边界、分层处理”的全局视野:
五、总结
在线编译器报出代码超时,本质上是云端资源的严格配额与代码计算复杂度或挂起状态之间产生的冲突。当遇到该报错时,先花几十秒确认是否存在交互阻塞(如无输入参数的 input())与失控死循环;随后根据题目或数据规模,倒推合理的时间复杂度指标,用哈希表、高效内置函数代替粗暴的线性扫描与字符串累加。如果属于需要长久运行的数据处理或模型训练任务,应当及时迁移至配备完整算力的本地开发环境。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









