

Python标准库csv模块读取数据教程(无需安装第三方库)
本教程详细讲解如何使用Python内置标准库csv模块读取CSV文件数据,全面涵盖csv.reader与csv.DictReader用法、参数配置、编码处理及避坑指南。
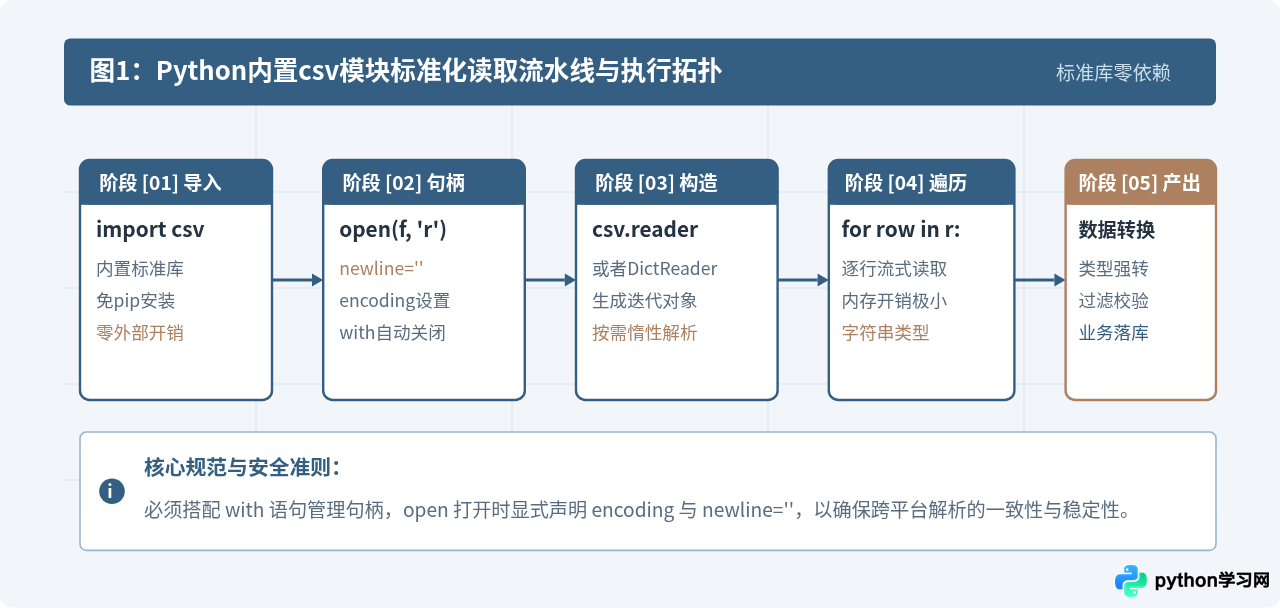
在Python开发中,处理以逗号分隔的结构化表格文件(CSV)是极其常见的数据读取需求。许多初学者首先想到的往往是安装Pandas等重型第三方库,但在轻量级脚本、自动化运维、容器化部署或严苛的离线生产环境中,额外安装第三方包不仅增加依赖体积,还可能引入兼容性开销。Python语言本身内置了功能完善、执行高效的 csv 标准库,无需执行任何 pip install 即可直接导入使用。本文将全面介绍如何使用内置 csv 模块稳定、规范地读取各类CSV数据文件,理清核心参数与常见陷阱,帮助你在不依赖任何外部工具的前提下,写出健壮可靠的数据读取程序。
一、快速上手:使用 csv.reader 按行读取
csv.reader 是标准库中最基础的读取接口。它接收一个已经打开的可迭代文件对象,逐行读取内容并按指定规则切分成字符串列表(List[str])。
1. 最简读取示例
假设当前目录下存在一个名为 users.csv 的数据文件,内容如下:
name,age,department,city
张三,28,技术研发部,北京
李四,34,产品运营部,上海
王五,25,市场策划部,深圳
使用 csv.reader 进行读取的标准代码如下:
import csv

# 推荐使用 with 语句管理文件资源
with open('users.csv', mode='r', encoding='utf-8', newline='') as file:
    reader = csv.reader(file)
    for row in reader:
        print(row)
运行上述代码后,每一行数据都会被解析为一个原生的 Python 列表(示例输出):
['name', 'age', 'department', 'city']
['张三', '28', '技术研发部', '北京']
['李四', '34', '产品运营部', '上海']
['王五', '25', '市场策划部', '深圳']
2. 跳过表头行(Header)
在实际业务中,首行通常是字段名而非具体数据。由于 csv.reader 返回的是一个迭代器对象,我们可以直接调用 Python 内置的 next() 函数将首行读出并丢弃(或保存为表头变量),后续的 for 循环将直接从第二行数据开始遍历:
import csv

with open('users.csv', mode='r', encoding='utf-8', newline='') as file:
    reader = csv.reader(file)
    header = next(reader)  # 读取并暂存首行表头
    print(f"检测到字段表头: {header}")

    for row in reader:
        # 通过下标索引获取具体字段值
        name = row[0]
        age = int(row[1])  # 显式转换为数值类型
        city = row[3]
        print(f"姓名: {name}, 年龄: {age}, 所在城市: {city}")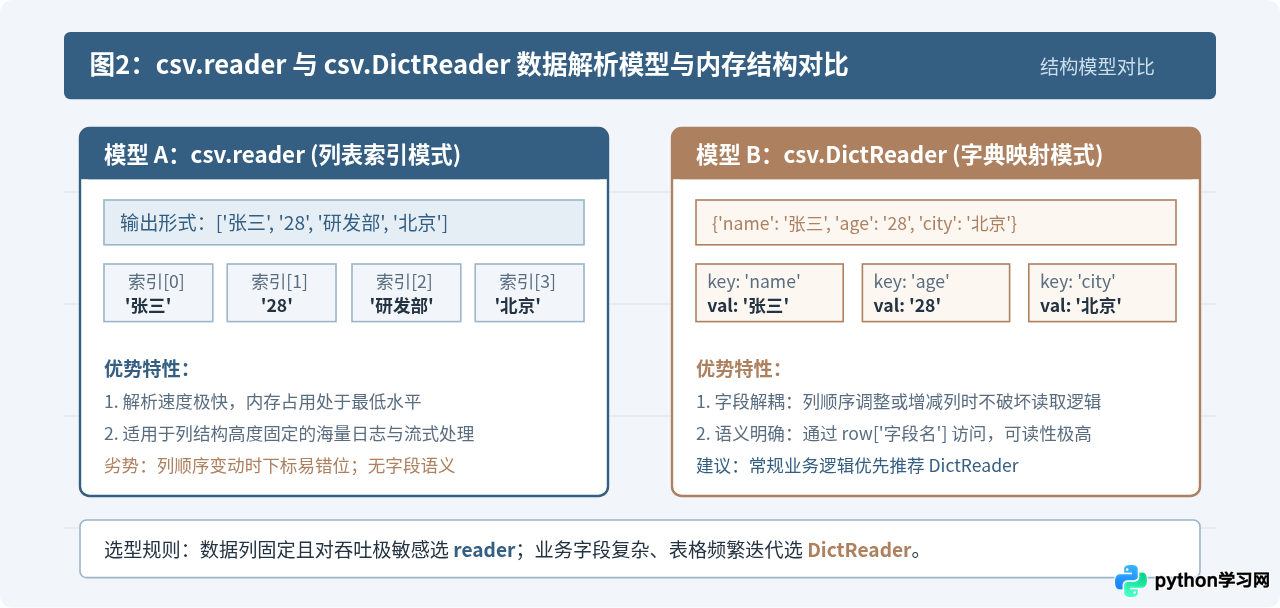
二、语义化读取:使用 csv.DictReader 映射为字典
虽然 csv.reader 运行速度极快,但在实际业务开发中,数据文件的列顺序可能会随着业务迭代而增减或调换。如果依赖 row[0]、row[3] 这样的硬编码下标,一旦表格格式微调,整个程序就会出现取值错位甚至静默逻辑错误。为此,标准库提供了 csv.DictReader 类。
1. 基本用法
csv.DictReader 会自动将文件的第一行解析为字典的键(Keys),随后的每一行数据都会被解析为一个有序字典,访问字段时直接通过表头名称索引:
import csv

with open('users.csv', mode='r', encoding='utf-8', newline='') as file:
    dict_reader = csv.DictReader(file)

    # 打印自动识别到的字段名列表
    print(f"解析到的列名: {dict_reader.fieldnames}")

    for row in dict_reader:
        # 直接通过列名提取,语义清晰且不依赖列顺序
        name = row['name']
        age = int(row['age'])
        dept = row['department']
        city = row['city']
        print(f"员工: {name} | 部门: {dept} | 城市: {city} | 年龄: {age}")
2. 自定义表头(处理无表头文件)
如果源 CSV 文件本身没有表头行,首行就是具体数据,直接使用 DictReader 会导致第一行数据被错误地当作字典键。此时可以通过传入 fieldnames 参数显式指定字段名:
import csv

# 假设 raw_logs.csv 第一行直接是数据:2026-10-16,ERROR,DatabaseTimeout,Node-03
custom_headers = ['log_date', 'level', 'message', 'node_id']

with open('raw_logs.csv', mode='r', encoding='utf-8', newline='') as file:
    reader = csv.DictReader(file, fieldnames=custom_headers)
    for row in reader:
print(f"[{row['log_date']}] {row['level']} 在 {row['node_id']}: {row['message']}")当某一行的字段数量少于 fieldnames 时,缺失字段在字典中的默认值为 None(可通过 restval 参数自定义填充值);当某一行字段数量多于 fieldnames 时,多出来的字段会被存放在一个以 restkey 指定的键名下的列表中。
三、进阶控制:处理非常规分隔符与复杂格式
虽然 CSV 名字中带有“Comma(逗号)”,但在工业实践中,制表符分隔(TSV)、分号分隔(在欧洲某些地区或特定财务软件中很常见)或包含复杂双引号转义的文件屡见不鲜。csv 模块通过可配置的方言(Dialect)和参数提供了强大的适应能力。
1. 自定义分隔符(delimiter)
如果读取的是以制表符 \t 分隔的 TSV 文件,或者以分号 ; 分隔的数据,只需指定 delimiter 参数:
import csv

# 读取制表符分隔的文件
with open('data.tsv', mode='r', encoding='utf-8', newline='') as file:
    reader = csv.reader(file, delimiter='\t')
    for row in reader:
        print(row)

# 读取分号分隔的文件
with open('finance.csv', mode='r', encoding='utf-8', newline='') as file:
    reader = csv.DictReader(file, delimiter=';')
    for row in reader:
        print(row)
2. 忽略分隔符后的空白字符(skipinitialspace)
某些软件导出的 CSV 在分隔符后附带多余的空格,如 "张三", 28, "研发部"。默认情况下,28 前面的空格会被当作数据的一部分读入为 ' 28'。将 skipinitialspace=True 传入后,紧随分隔符后的空格将被自动忽略:
import csv

with open('data.csv', mode='r', encoding='utf-8', newline='') as file:
    # 忽略逗号后的空格
    reader = csv.reader(file, skipinitialspace=True)
    for row in reader:
        print(row)
3. 引号规则与类型自动转换(quoting)
默认情况下,无论 CSV 中的内容是否带有引号,csv.reader 读取出的字段一律是字符串类型 str。如果希望非引号包裹的数值自动解析为浮点数(float),可以设置 quoting=csv.QUOTE_NONNUMERIC:
import csv

# 假设内容为: "Apple",12.5,100
with open('inventory.csv', mode='r', encoding='utf-8', newline='') as file:
    reader = csv.reader(file, quoting=csv.QUOTE_NONNUMERIC)
    for row in reader:
        # row[0] 为 str ('Apple')
        # row[1] 自动解析为 float (12.5)
        # row[2] 自动解析为 float (100.0)
        print(row, [type(x) for x in row])
四、避坑指南:必须掌握的注意事项
| 常见问题 / 异常 | 根本原因 | 标准解决方案 |
|---|---|---|
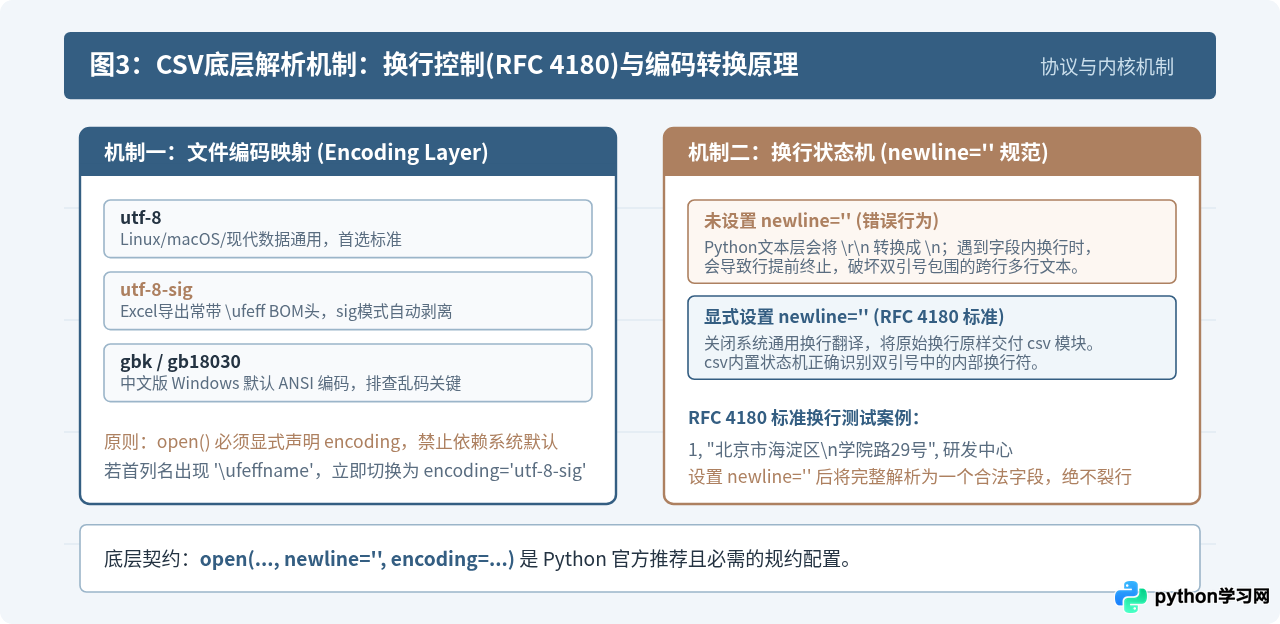
| 漏写 newline='' | 跨平台时换行符解析错乱,当单元格内部存在换行文本时导致整行数据被错误切断 | 调用 open() 时始终指定 newline='' |
| 首个字段名包含 \ufeff | Windows 或 Excel 导出文件带有 UTF-8 BOM 签名头 | 指定 encoding='utf-8-sig' 自动剥离 BOM |
| 数值计算抛出 TypeError | csv 模块默认所有字段均为纯文本 str |
根据字段业务含义显式执行 int() 或 float() 转换 |
| 二次遍历迭代器为空 | csv.reader 是单向惰性迭代器,遍历完毕后指针停在文件末尾 |
使用 file.seek(0) 重置指针,或提前用 list(reader) 缓存 |
五、端到端综合实战:健壮的读取与数据清洗
结合前面所学的所有要点,下面给出一个包含编码自动兼容、异常数据捕获以及类型强转的工业级读取模板:
import csv

def load_sales_data(filepath):
    """
    健壮读取销售数据CSV文件
    包含容错处理、类型转换与格式校验
    """
    valid_records = []

    # 使用 utf-8-sig 兼容带或不带 BOM 的 UTF-8 文件,newline='' 保证换行一致
    try:
        with open(filepath, mode='r', encoding='utf-8-sig', newline='') as file:
            reader = csv.DictReader(file)

            for line_no, row in enumerate(reader, start=2):  # 表头为第1行,数据从第2行算起
                try:
                    record = {
                        'product_id': row['product_id'].strip(),
                        'price': float(row['price'].strip()),
                        'quantity': int(row['quantity'].strip()),
                        'category': row.get('category', 'Uncategorized').strip()
                    }
                    record['total_amount'] = round(record['price'] * record['quantity'], 2)
                    valid_records.append(record)
                except (ValueError, KeyError) as err:
                    print(f"[警告] 第 {line_no} 行解析失败,跳过该记录: {row},错误: {err}")
                    continue

    except UnicodeDecodeError:
        # 若遭遇系统级ANSI编码,尝试回退到 gbk
        print("[提示] 检测到非UTF-8编码,正在切换为 GBK 编码重试...")
        with open(filepath, mode='r', encoding='gbk', newline='') as file:
            reader = csv.DictReader(file)
            for line_no, row in enumerate(reader, start=2):
                record = {
                    'product_id': row['product_id'].strip(),
                    'price': float(row['price'].strip()),
                    'quantity': int(row['quantity'].strip()),
                    'category': row.get('category', 'Uncategorized').strip()
                }
                record['total_amount'] = round(record['price'] * record['quantity'], 2)
                valid_records.append(record)

    return valid_records

# 示例调用与校验
if __name__ == '__main__':
    data = load_sales_data('sales.csv')
    print(f"成功载入 {len(data)} 条有效记录")
    for item in data[:3]:
        print(item)
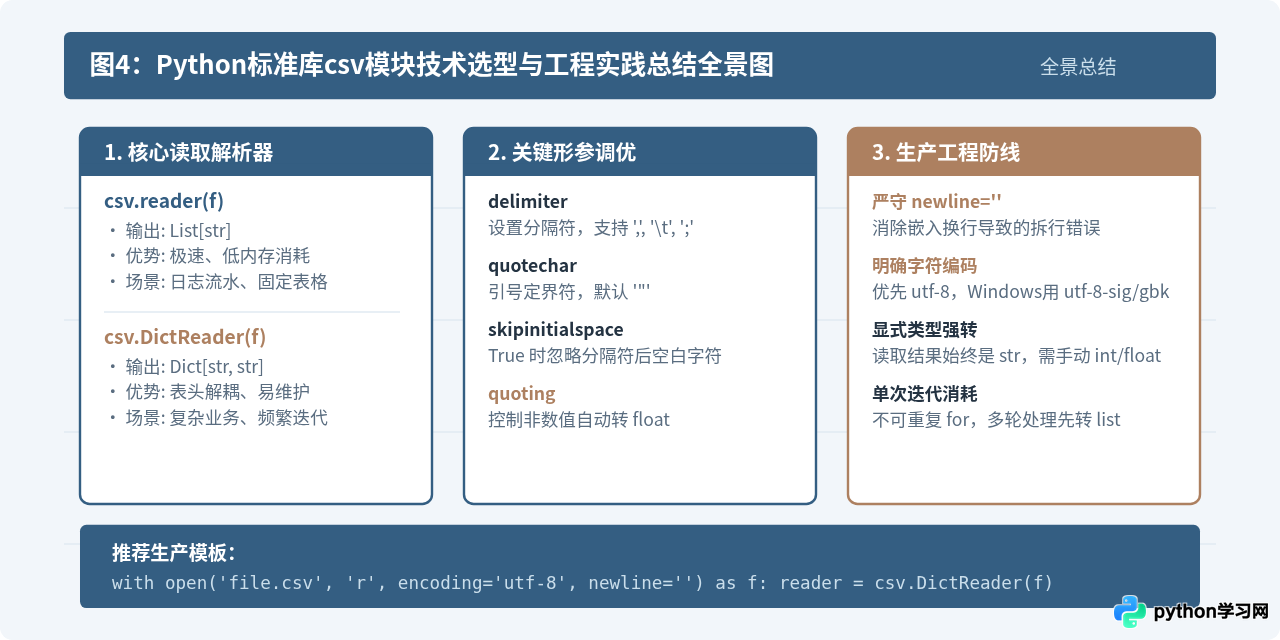
通过使用 Python 内置的标准库 csv 模块,开发者不仅完全摆脱了对重量级第三方库的依赖,使脚本运行更加敏捷轻便,而且能够通过底层的 reader 与 DictReader 精细把控数据流、编码以及边界异常,是每一位 Python 开发者必须掌握的基础内功。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









