

Python读取文本并生成词云:数据清洗与去停用词全流程
详细讲解使用Python读取文本并生成词云的完整流程,涵盖文本编码处理、正则数据清洗、jieba精准分词、停用词表构建过滤与WordCloud中文词云渲染配置。
一、全流程步骤拆解与准备工作
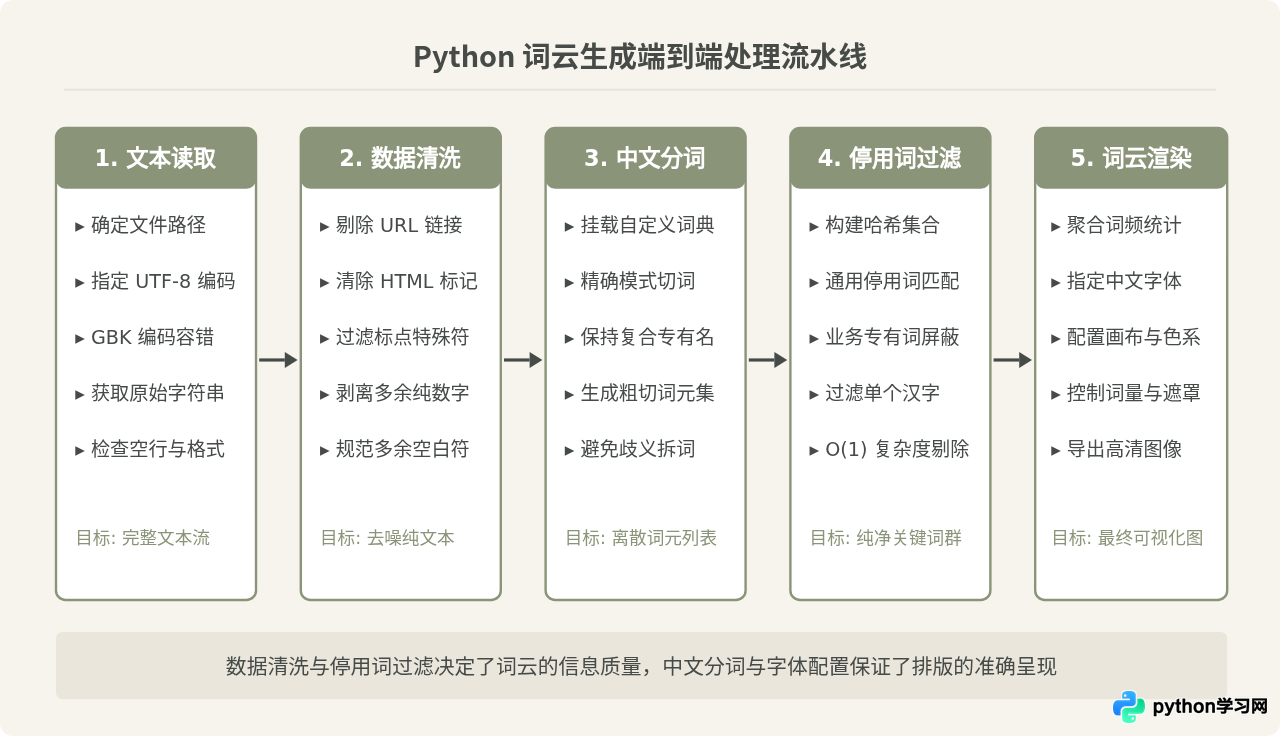
很多初学者在制作词云时,习惯直接把抓取到的网页文本或文档整段丢给 wordcloud 库。这样生成的结果通常充斥着“的”、“了”、“在”、“是”等无意义虚词,或者夹杂大量网页标签、标点符号和单字,导致真正反映主题的核心关键词被淹没。因此,正规的文本词云处理必须包含“读取-清洗-切词-过滤-渲染”五个连贯环节。
在开始编码前,需要确保安装了所需的 Python 第三方库。运行以下命令安装:
pip install jieba wordcloud matplotlib其中,jieba 负责中文分词;wordcloud 负责词云布局与图像生成算法;matplotlib 用于显示或辅助导出高质量图表。
二、文本读取与字符编码避坑
文本读取是所有处理的源头。但在实际操作中,读者最常遇到的第一个绊脚石就是 UnicodeDecodeError。这通常是因为操作系统默认编码与待读取文件的实际编码不匹配造成的。
Windows 系统的默认编码通常是 GBK 或 CP936,而从现代网络、API 或编辑器中导出的文本大多采用 UTF-8。在调用 Python 内置的 open() 函数时,若未显式指定 encoding 参数,程序就会使用系统默认编码尝试解析,从而引发解码崩溃。
def load_text(file_path: str) -> str:
    """安全读取外部文本文件并返回纯文本字符串"""
    try:
        with open(file_path, "r", encoding="utf-8") as f:
            return f.read()
    except UnicodeDecodeError:
        # 兼容处理旧版 Windows 下可能保存为 GBK/GB18030 的文本文件
        with open(file_path, "r", encoding="gb18030", errors="ignore") as f:
            return f.read()
    except FileNotFoundError:
        raise FileNotFoundError(f"未找到目标文件: {file_path}")
在上述实现中,优先采用通用的 utf-8 尝试读取;若捕获到编码异常,则优雅退化为兼容性更广的 gb18030,并配合 errors="ignore" 忽略极少数无法识别的损坏字节。这种做法能保障读取环节平稳运行,避免因几个非标字节直接中断整个分析流水线。
三、数据清洗的关键:从脏文本到纯净词元
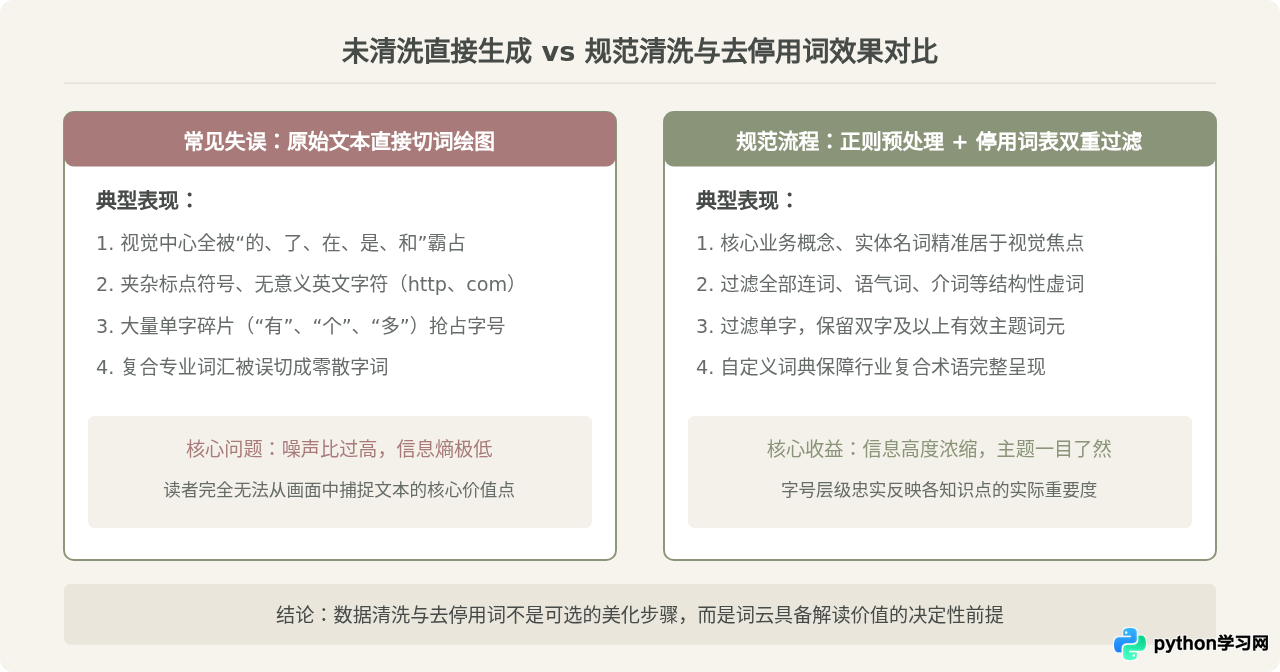
获取到原始文本后,千万不要直接调用分词。许多人误以为“分词器会自动忽略无用符号”,这是一个普遍认知误区。分词器的职责是按照词典和统计模型切断词语,它并不会主动替你判定标点、特殊符号、换行符或超链接是否具备分析价值。
未经清洗的文本中通常夹杂着网址(如 http://...)、HTML 实体标签(如 )、多余的标点符号、纯数字以及特殊控制字符。这些噪音会直接混入词元流,不仅浪费计算资源,还会在词云中占据显眼位置。
实现数据预清洗,最直接有效的方式是结合 Python 的 re(正则表达式)模块。通过正则模式,可以一站式剥离链接、标签及非中文/英文/数字的特殊符号:
import re

def clean_raw_text(text: str) -> str:
    """使用正则表达式清洗原始杂乱文本"""
    # 1. 剔除 URL 链接
    text = re.sub(r"https?://\S+|www\.\S+", "", text)
    # 2. 剔除 HTML 实体或标签
    text = re.sub(r"<.*?>|&[a-zA-Z]+;", "", text)
    # 3. 仅保留汉字、英文字母及空格,其余符号替换为空格
    # 如需保留数字,可改为 [^\u4e00-\u9fa5a-zA-Z0-9]
    text = re.sub(r"[^\u4e00-\u9fa5a-zA-Z]", " ", text)
    # 4. 压缩连续的空白字符为单个空格
    text = re.sub(r"\s+", " ", text).strip()
    return text
四、中文分词与停用词过滤机制
英文文本天然以空格作为单词分隔符,而中文书写是连续不断的字串。要统计中文词频并生成词云,必须通过分词引擎把连续字流精确切分为独立词元。
1. jieba 分词模式选择与自定义词典
jieba 提供了三种常用分词模式:
- 精确模式(jieba.lcut(text)):试图将句子最精确地切开,适合文本分析与词云绘制,词语无重复重叠。
- 全模式(jieba.lcut(text, cut_all=True)):把句子中所有可以成词的词语都扫描出来,速度快但冗余度极高,会导致词频虚高,不适合直接做词云。
- 搜索引擎模式(jieba.lcut_for_search(text)):在精确模式的基础上对长词进一步切分,适合搜索索引,同样不推荐作为词云首选。
如果文本涉及特定行业或专业术语(例如“数据清洗”、“停用词”、“知识图谱”),默认词典可能会把它们切碎成“数据 / 清洗”、“停用 / 词”。为了防止专业术语被肢解,可以在切词前动态添加专有词或载入词典:
import jieba

# 动态添加专有名词,保证其不被拆分
jieba.add_word("数据清洗")
jieba.add_word("停用词")
jieba.add_word("词云图")
2. 停用词表构建与高效过滤
所谓停用词(Stop Words),是指在语言组织中频繁出现、负责语法连接但在表达具体内容上贡献极低的词汇。常见的停用词包括介词、连词、叹词、代词等(如“以及”、“由于”、“然而”、“我们”、“他们”)。此外,分析特定业务文本时,“根据”、“指出”、“表示”、“文章”等通用套话也应归入业务自定义停用词。
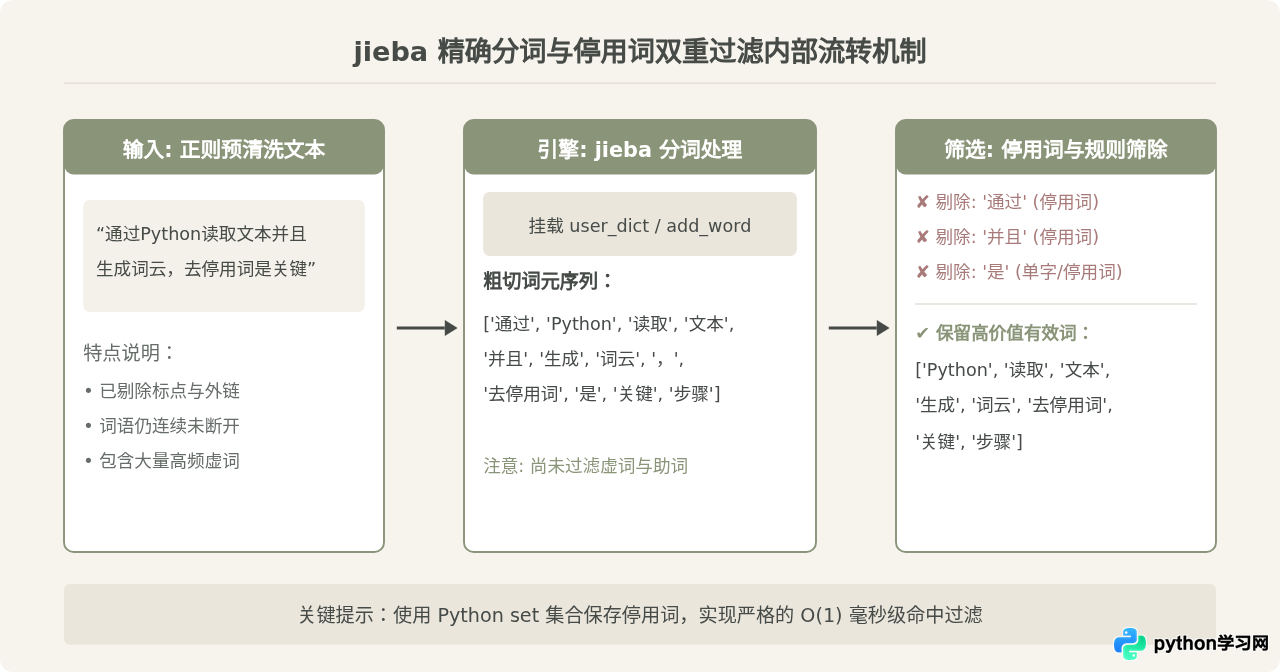
为了达到最佳过滤性能,停用词必须加载至 Python 的 set(集合)数据结构中。如果在 list(列表)中执行 word in stop_words_list,时间复杂度为 \(O(N)\);当文本词元量达到数万或几十万时,查询会变得极其缓慢。而 set 基于哈希表实现,检索复杂度为 \(O(1)\),可实现瞬间过滤。
def load_stopwords(stopwords_path: str = None) -> set:
    """加载停用词集合,支持传入自定义停用词文件路径"""
    # 基础内置停用词表(涵盖常见虚词、副词、标点)
    default_stopwords = {
        "的", "了", "和", "是", "就", "都", "而", "及", "与", "着",
        "或", "一个", "没有", "我们", "你们", "他们", "其", "在", "对",
        "有", "等", "被", "从", "中", "上", "下", "说", "到", "为",
        "也", "把", "让", "给", "但", "去", "又", "得", "这", "那",
        "此", "这些", "那些", "因", "因此", "所以", "如果", "进行"
    }

    if stopwords_path:
        try:
            with open(stopwords_path, "r", encoding="utf-8") as f:
                file_words = {line.strip() for line in f if line.strip()}
                default_stopwords.update(file_words)
        except Exception as e:
            print(f"提示:读取自定义停用词文件失败,使用默认停用词集合 ({e})")

    return default_stopwords

def segment_and_filter(text: str, stopwords: set) -> list:
    """执行 jieba 精确分词,并过滤停用词与单字碎片"""
    words = jieba.lcut(text, cut_all=False)

    clean_words = []
    for w in words:
        w = w.strip()
        # 过滤条件:非空、长度大于1(过滤单个汉字)、且不在停用词表中
        if len(w) > 1 and w not in stopwords:
            clean_words.append(w)

return clean_words汉语中绝大多数具备明确具体语义的名词、动词或专业术语都是双字或多字词组。单个字(如“做”、“看”、“好”、“大”、“新”)往往随语境多变,缺乏独立指示意义。若保留单字,它们的高频出现会抢占大量视觉空间,导致“词”云沦为“字”云。因此,除非进行古汉语或特定韵文分析,现代中文词云中过滤单字是通用且有效的降噪策略。
五、词频统计与词云图生成配置
完成分词与去停用词后,清洗流程已圆满结束。接下来是利用 wordcloud.WordCloud 将纯净的词元列表转化为视觉图像。
1. 中文字体路径配置(彻底解决方块乱码)
这是 Python 绘制中文词云时读者遭遇率第二高的典型故障:生成的词云图上没有任何文字,全是一排排矩形方框(“豆腐块”)。
出现方框的根本原因是:WordCloud 底层默认使用的是无中文字符集的英文字体(DroidSansMono)。在遇到中文字符时,字体库找不到对应的字形轮廓(Glyph),只能降级渲染为缺失字符方块。解决办法非常直接——通过 font_path 参数显式指定系统中的中文字体文件绝对路径:
| 操作系统 | 常用系统自带中文字体路径 | 字体名称 |
|---|---|---|
| Windows | C:/Windows/Fonts/msyh.ttc 或 simhei.ttf |
微软雅黑 / 黑体 |
| macOS | /System/Library/Fonts/PingFang.ttc 或 /System/Library/Fonts/STHeiti Light.ttc |
苹方 / 华文黑体 |
| Linux / Ubuntu | /usr/share/fonts/truetype/wqy/wqy-microhei.ttc |
文泉驿微米黑 |
2. 词云核心参数详解与渲染代码
WordCloud 类提供了丰富的参数来调控画布质量与词汇分布:
from collections import Counter
from wordcloud import WordCloud
import matplotlib.pyplot as plt

def generate_wordcloud(word_list: list, output_image_path: str, font_path: str):
    """根据清洗后的词元列表生成高清词云图并保存"""
    # 统计词频(WordCloud 接收以空格拼接的字符串或词频字典均可)
    word_counts = Counter(word_list)

    # 实例化 WordCloud 配置对象
    wc = WordCloud(
        font_path=font_path,          # 必须指定中文字体路径,防止方块乱码
        width=1200,                   # 输出图像宽度(像素)
        height=800,                   # 输出图像高度(像素)
        background_color="white",     # 画布背景颜色(如 white, #F7F4ED 等)
        max_words=150,                # 词云呈现的最大词汇数量,避免过密
        max_font_size=160,            # 最大字体大小
        min_font_size=14,             # 最小字体大小
        random_state=42,              # 固定随机种子,确保每次运行排版一致
        colormap="viridis",           # 配色方案,如 viridis, plasma, bone 等
        collocations=False            # 禁用双词搭配统计,防止词汇意外重复
    )

    # 基于词频字典拟合词云布局
    wc.generate_from_frequencies(word_counts)

    # 保存高清结果图像至磁盘
    wc.to_file(output_image_path)
    print(f"词云图已成功导出至: {output_image_path}")
六、关键步骤排坑与全流程自检清单
为了让读者在实际操作中快速定位问题,我们将全流程中的关键配置要点、易错原因及对应的自检措施总结归纳如下:
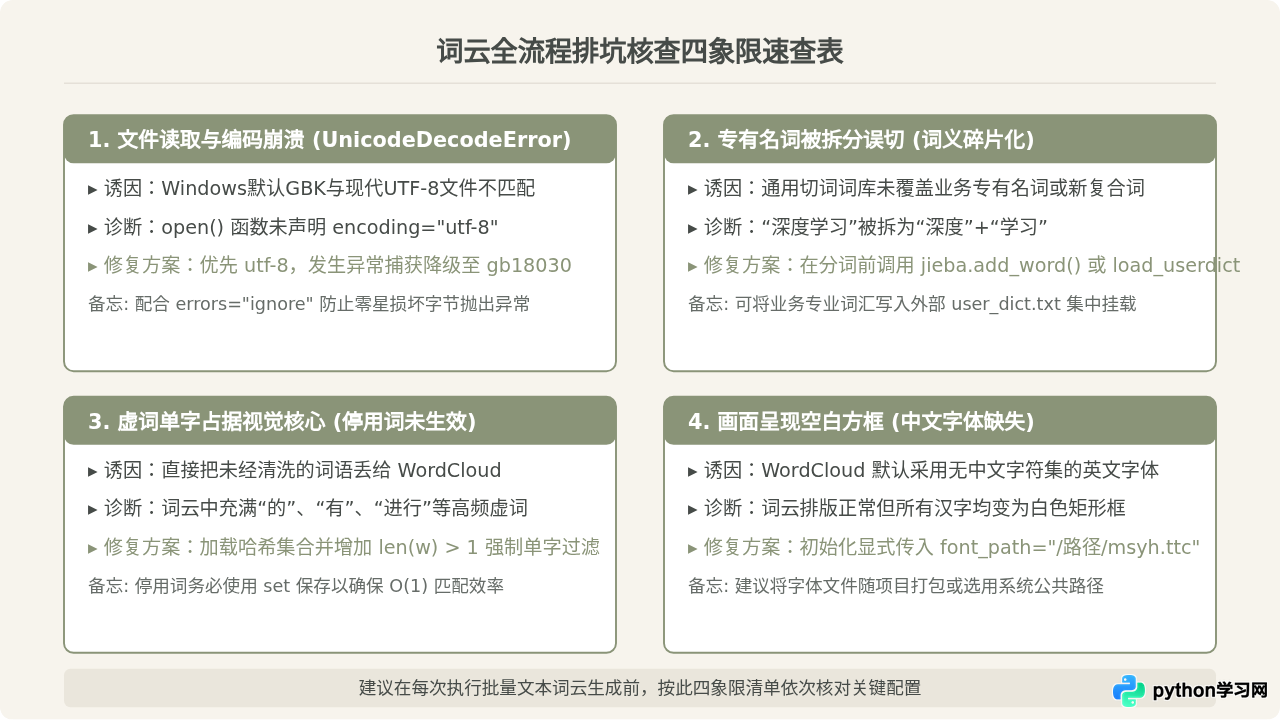
七、完整可运行端到端代码
将上述所有模块组合起来,即可得到一份开箱即用、具备高度鲁棒性的完整 Python 脚本。读者只需将脚本保存并在本地准备一个测试文本即可直接运行:
import re
from collections import Counter
import jieba
from wordcloud import WordCloud

def load_text(file_path: str) -> str:
    """第一步:安全读取文本文件"""
    try:
        with open(file_path, "r", encoding="utf-8") as f:
            return f.read()
    except UnicodeDecodeError:
        with open(file_path, "r", encoding="gb18030", errors="ignore") as f:
            return f.read()

def clean_text(raw_text: str) -> str:
    """第二步:正则表达式清洗杂质"""
    text = re.sub(r"https?://\S+|www\.\S+", "", raw_text)
    text = re.sub(r"<.*?>|&[a-zA-Z]+;", "", text)
    text = re.sub(r"[^\u4e00-\u9fa5a-zA-Z]", " ", text)
    text = re.sub(r"\s+", " ", text).strip()
    return text

def segment_and_filter(cleaned_text: str, custom_stopwords: set = None) -> list:
    """第三步与第四步:中文分词与去停用词"""
    # 基础内置停用词
    stopwords = {
        "的", "了", "和", "是", "就", "都", "而", "及", "与", "着",
        "或", "一个", "没有", "我们", "你们", "他们", "其", "在", "对",
        "有", "等", "被", "从", "中", "上", "下", "说", "到", "为",
        "也", "把", "让", "给", "但", "去", "又", "得", "这", "那",
        "此", "这些", "那些", "因", "因此", "所以", "如果", "进行"
    }
    if custom_stopwords:
        stopwords.update(custom_stopwords)

    # 动态添加业务保护词汇,防止被误切
    jieba.add_word("数据清洗")
    jieba.add_word("去停用词")
    jieba.add_word("词云图")

    # 精确切词
    tokens = jieba.lcut(cleaned_text, cut_all=False)

    # 过滤单字与停用词
    filtered_words = [
        w.strip() for w in tokens
        if len(w.strip()) > 1 and w.strip() not in stopwords
    ]
    return filtered_words

def render_wordcloud(words: list, output_path: str, font_path: str):
    """第五步:词频汇总与词云渲染保存"""
    word_counts = Counter(words)
    if not word_counts:
        print("警告:清洗过滤后无有效词汇,无法生成词云。")
        return

    wc = WordCloud(
        font_path=font_path,
        width=1200,
        height=800,
        background_color="white",
        max_words=120,
        max_font_size=150,
        random_state=42,
        colormap="viridis",
        collocations=False
    )
    wc.generate_from_frequencies(word_counts)
    wc.to_file(output_path)
    print(f"处理完成!词云已成功保存至: {output_path}")

# ================= 业务调用示例 =================
if __name__ == "__main__":
    # 配置路径
    INPUT_TXT = "sample_data.txt"
    OUTPUT_PNG = "clean_wordcloud.png"

    # 根据读者自己的操作系统选择对应字体路径
    # Windows 示例: "C:/Windows/Fonts/msyh.ttc"
    # macOS 示例: "/System/Library/Fonts/PingFang.ttc"
    # Linux 示例: "/usr/share/fonts/truetype/wqy/wqy-microhei.ttc"
    SYSTEM_FONT = "/System/Library/Fonts/PingFang.ttc"

    # 执行全流程
    print("1. 正在读取文件...")
    raw_content = load_text(INPUT_TXT)

    print("2. 正在进行正则数据清洗...")
    pure_content = clean_text(raw_content)

    print("3. 正在进行中文分词与停用词过滤...")
    clean_word_tokens = segment_and_filter(pure_content)

    print("4. 正在生成并保存词云...")
    render_wordcloud(clean_word_tokens, OUTPUT_PNG, SYSTEM_FONT)
遵循上述标准流程,无论是处理爬虫采集的几百页网页数据,还是对上千条用户评论进行主题提取,都能高效剔除冗余干扰,精准提炼出最具信息密度的核心关键词云图。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









