

Python序列常用操作汇总:索引、切片、拼接与重复
系统梳理Python字符串、列表、元组等序列类型的核心操作,详解正反向双向索引机制、切片参数推导与容错规则、序列拼接及重复运算,并深入剖析嵌套可变对象重复时的内存引用陷阱。
在 Python 编程中,文本字符串(str)、有序列表(list)、不可变元组(tuple)以及二进制序列(bytes)都属于序列(Sequence)数据结构。序列的共同特征在于:容器中的元素具备严格的前后排列次序,且每个元素均对应唯一的位置编号。无论是处理传感器上报的时间序列,还是解析一段网络报文,掌握序列的基础运算协议都是编写健壮 Python 代码的前提。本文将围绕索引、切片、拼接与重复四大核心操作展开,剖析其语法规范、底层运行机制以及工程实践中的易错边界。
一、序列索引操作(正向寻址与反向定位)
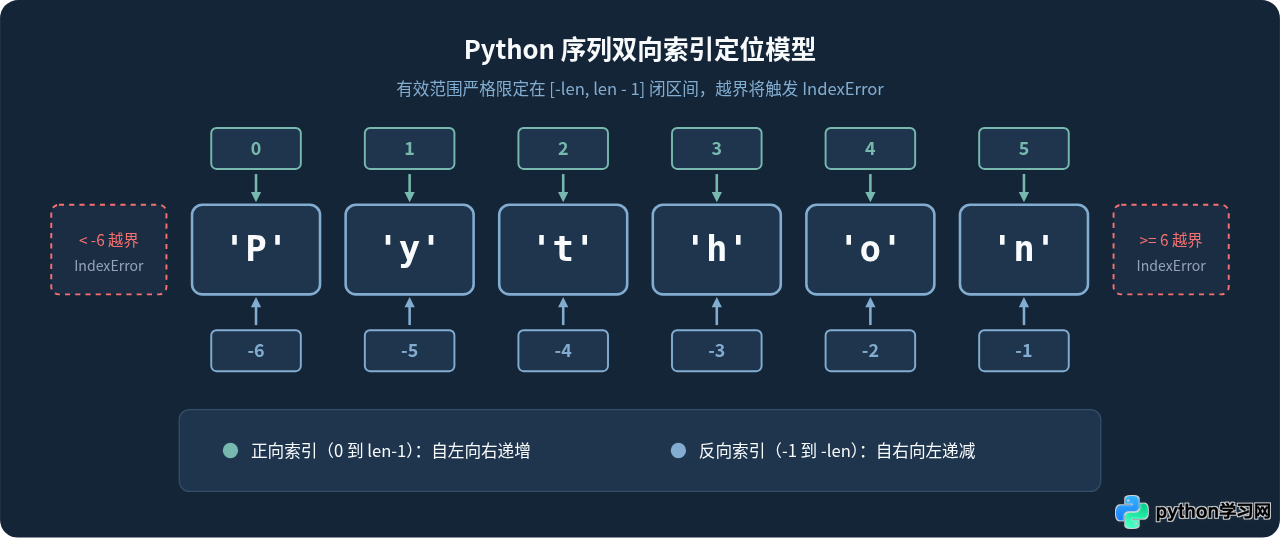
索引(Indexing)用于通过元素在序列中的特定位置获取单个元素。Python 的序列支持双向索引机制:
- 正向索引:编号从序列头部的
0开始递增,最后一个元素的有效索引值为len(s) - 1。 - 反向索引:编号从序列末尾的
-1开始递减,头部第一个元素的负向索引值为-len(s)。
双向索引的实现避免了开发者在获取末尾元素时手动编写 s[len(s) - 1] 这样繁琐的代码,直接使用 s[-1] 即可获得末位对象。
# 索引基础访问示例
text = "Python"
print("正向首位:", text[0])    # 示例输出: P
print("正向第4位:", text[3])   # 示例输出: h
print("反向末位:", text[-1])   # 示例输出: n
print("反向首位:", text[-6])   # 示例输出: P

# 列表与元组同样适用
numbers = [10, 20, 30, 40, 50]
print("倒数第二个元素:", numbers[-2]) # 示例输出: 40当传入的索引值超出合法区间 [-len(s), len(s) - 1] 时,解释器会立即抛出 IndexError(如 IndexError: string index out of range)。在不确定序列长度的动态场景下,访问前需先校验长度,或通过异常捕获防御越界错误。
二、序列切片操作(区间截取与步长控制)
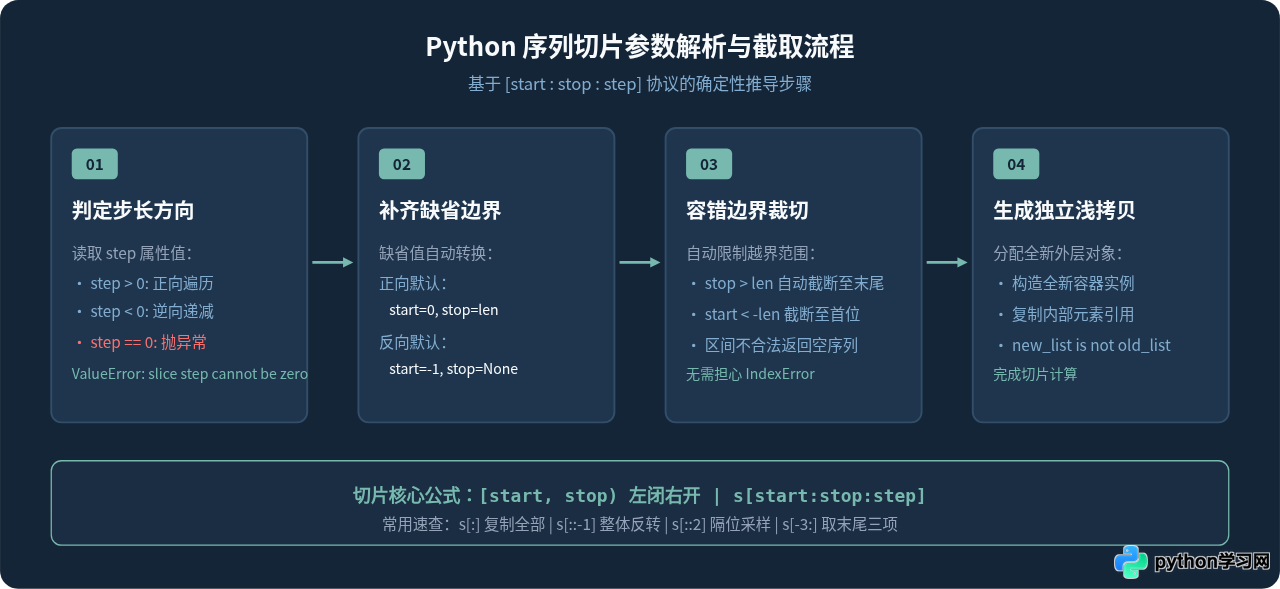
如果说索引是为了提取单个元素,那么切片(Slicing)则是为了获取子序列。切片语法的通用结构如下:
sequence[start:stop:step]切片计算包含三个核心要素:
- 左闭右开区间:切片截取包含
start对应位置的元素,但不包含stop对应位置的元素,即数学上的[start, stop)区间。 - 步长控制(step):决定取值的步进幅度与遍历方向。当
step > 0时,索引由左向右递增;当step < 0时,索引由右向左逆序递减。默认步长为1。 - 缺省值推导规则:
- 当
step > 0时:start省略默认为0;stop省略默认为序列总长度len(s)。 - 当
step < 0时:start省略默认为末尾-1;stop省略默认为头部之前(一直截取到首元素)。
- 当
# 切片常用操作示例
data = [0, 1, 2, 3, 4, 5, 6, 7, 8, 9]

# 1. 基础区间截取 [2, 6)
print("截取2到5:", data[2:6])        # 示例输出: [2, 3, 4, 5]

# 2. 省略边界
print("前4个元素:", data[:4])         # 示例输出: [0, 1, 2, 3]
print("从第7个起:", data[7:])         # 示例输出: [7, 8, 9]

# 3. 指定步长
print("偶数位元素:", data[::2])       # 示例输出: [0, 2, 4, 6, 8]

# 4. 逆序反转(关键技巧)
print("逆序反转:", data[::-1]) # 示例输出: [9, 8, 7, 6, 5, 4, 3, 2, 1, 0]与索引操作严苛的边界检查不同,切片具备极强的容错性。当 start 或 stop 超过序列边界时,Python 不会抛出异常,而是优雅地将索引截断至合法的两端边界。例如 data[5:100] 会安全截取至列表末尾,而 data[20:30] 则返回同类型的空序列 []。
三、序列拼接与重复(+ 与 * 运算机制)
序列的拼接(Concatenation)与重复(Repetition)是日常重组数据的高频手段,两者分别使用加号 + 与乘号 * 操作符。
1. 拼接操作符(+)
使用 + 操作符可以将两个同类型的序列合并为一个新的序列对象。需要严格保证参与相加的两端类型一致:
# 同类型序列拼接
str_result = "Py" + "thon"           # 得到 "Python"
list_result = [1, 2] + [3, 4]        # 得到 [1, 2, 3, 4]
tuple_result = (10,) + (20, 30)      # 得到 (10, 20, 30)

# 错误示例:不同类型无法直接相加
# invalid = [1, 2] + (3, 4)          # 抛出 TypeError: can only concatenate list to list
关于 += 复合赋值的底层差异:对于不可变序列(字符串、元组),s += other 会创建全新对象并重新绑定变量名;而对于可变序列(列表),list += other 实际底层触发的是 list.extend() 方法,是在原内存地址上进行的原地修改(In-place Mutation)。
2. 重复操作符(*)
使用 * 操作符可以将序列内容重复指定整数次 k。如果 k <= 0,则返回同类型的空序列。
# 基础类型重复
border = "=" * 10                    # 得到 "=========="
zeros = [0] * 5 # 得到 [0, 0, 0, 0, 0]当序列中包含可变对象(例如子列表)时,使用 * 操作符并不会深拷贝内部的子对象,而仅仅是将其内存引用指针重复了多次!
我们来看下面的真实对比示例:
# ❌ 错误写法:3个子列表指向同一块内存
matrix_bad = [[0] * 3] * 3
matrix_bad[0][0] = 99
print(matrix_bad)
# 示例输出: [[99, 0, 0], [99, 0, 0], [99, 0, 0]]
# 问题:改动第一行,导致所有行被同时修改!

# ✅ 正确写法:使用列表推导式创建独立对象
matrix_good = [[0] * 3 for _ in range(3)]
matrix_good[0][0] = 99
print(matrix_good)
# 示例输出: [[99, 0, 0], [0, 0, 0], [0, 0, 0]]
# 结果:每一行具备完全独立的堆内存地址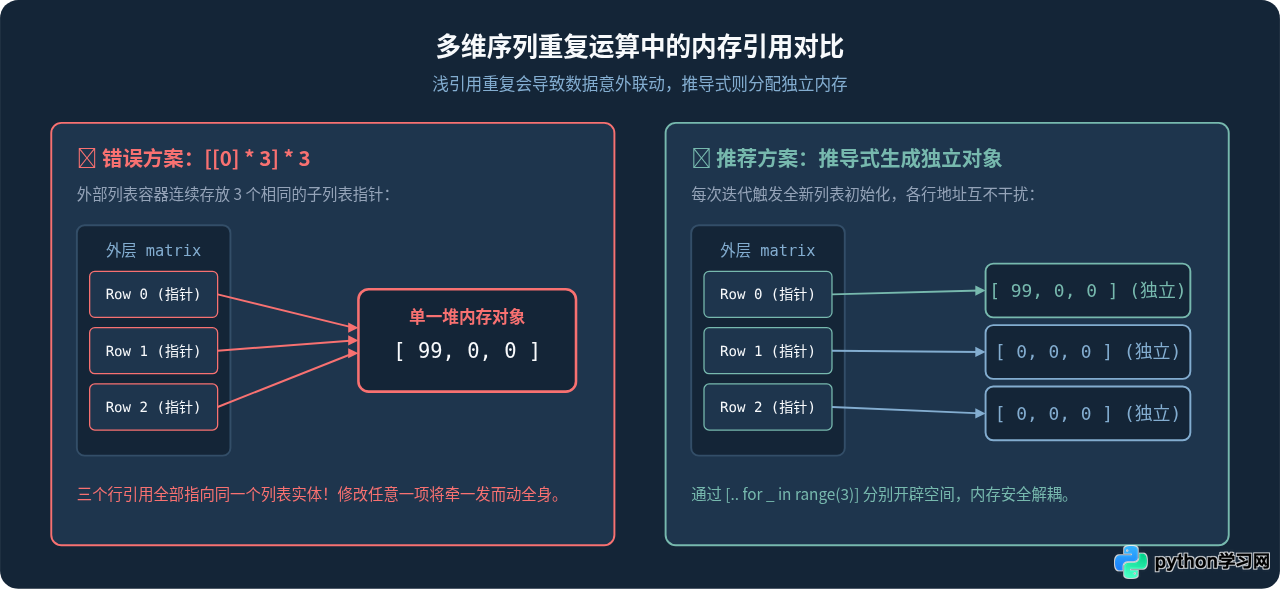
四、操作特性汇总与工程实践总结
为了在实际开发中更加从容地选择操作方式,下表总结了 Python 序列四大基础操作的核心指标与行为差异:
| 操作类型 | 典型语法 | 时间复杂度 | 越界处理机制 | 返回值 / 对象类型 | 核心注意事项 |
|---|---|---|---|---|---|
| 索引 (Indexing) | s[i] |
O(1) | 触发 IndexError |
单一元素对象 | 严格遵守 [-len, len-1] 边界 |
| 切片 (Slicing) | s[start:stop:step] |
O(k),k为切片长度 | 自动容错截断,不报错 | 原序列同类型的全新浅拷贝 | step < 0 时注意首末反转与空区间 |
| 拼接 (Concatenation) | s1 + s2 |
O(len(s1) + len(s2)) | 不适用(类型不符报 TypeError) |
全新合并序列 | 频繁拼接大字符串时优先使用 str.join() |
| 重复 (Repetition) | s * n |
O(n * len(s)) | n <= 0 时返回空序列 |
全新重复序列 | 警惕嵌套可变子对象(如二维列表)浅引用陷阱 |
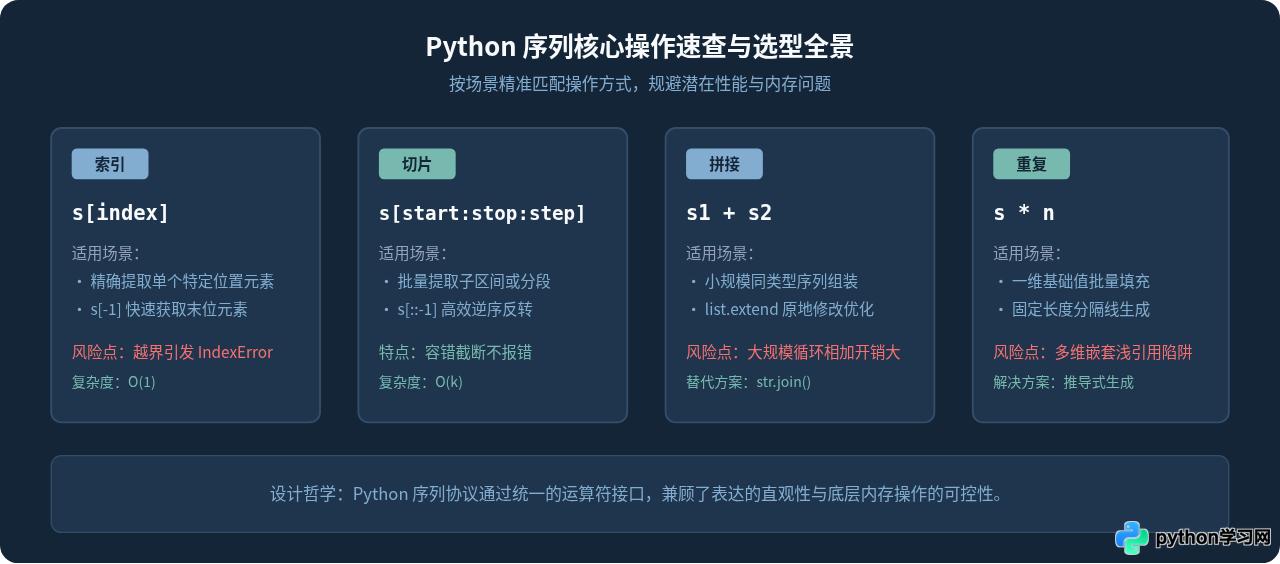
总的来说,索引、切片、拼接与重复构成了 Python 处理有序集合的基石。在日常工程落地中,请牢记两点核心原则:一是对于索引访问始终保持对 IndexError 的敬畏,必要时可利用切片的容错特性或长度判断进行规避;二是涉及包含嵌套容器的多维数据结构时,坚决避免使用 * 进行多层初始化,转而使用列表推导式保障内存引用的绝对隔离。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









