

解决Python \t输出不对齐的问题及替代方案
深入分析Python使用制表符\t进行表格或多列文本输出时对齐错位的根本原因,并提供基于f-string、unicodedata宽字符计算以及tabulate第三方库的完整替代方案与实操代码。
\t 打印规则表格时,经常会出现某一列突然向右偏移、整体排版错乱的情况。出现这种现象的核心原因在于制表符并不是“插入固定数量的空格”,而是将光标移动到“下一个固定步长(通常是8或4)的倍数位置”;一旦前置字符串长度超过或跨过了一个制表位,或者字符串包含全角中文字符,对其就会彻底失效。本文将先解析错位机制,随后给出从原生格式化到专业表格库的完整替代方案。
一、现象重现与制表符(\t)的对齐原理
编写轻量脚本时,开发者经常顺手写出类似下面的代码,期望用 \t 作为列分隔符生成规整的多列报表:
headers = ["编号", "姓名", "岗位", "薪资"]
rows = [
    ["001", "Bob", "Dev", "12000"],
    ["002", "Alexander", "DevOps", "16000"],
    ["003", "Tom", "QA", "9500"]
]

print("\t".join(headers))
for row in rows:
    print("\t".join(row))
实际控制台输出往往如下所示:
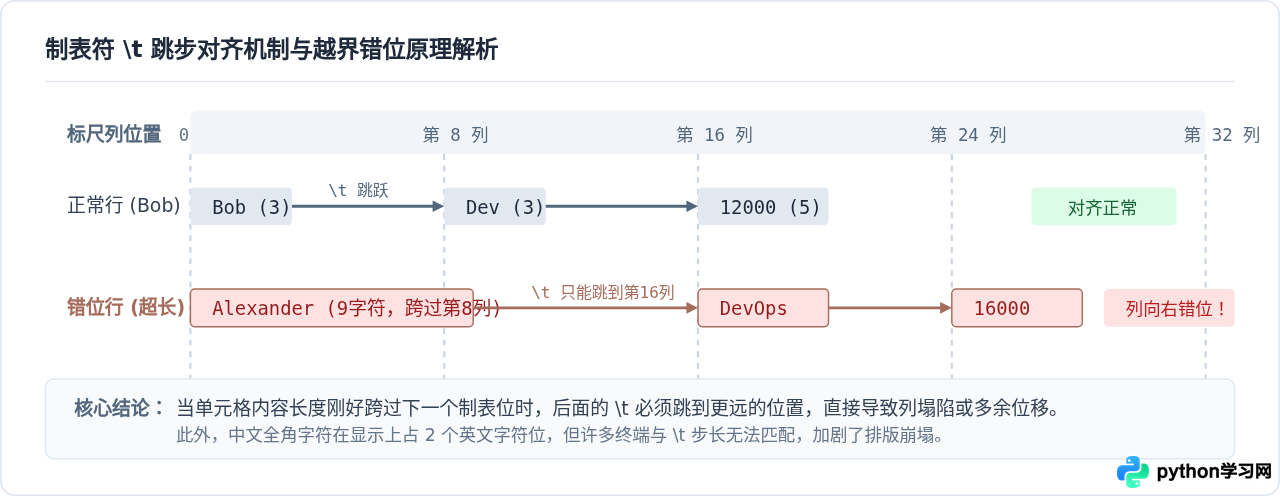
可以看到,第二行在 Alexander 之后的内容整体向右跳了一格,导致整列完全对不齐。这是因为终端环境内部设定了固定的制表位(Tab Stop),步长一般为 8 个字符。制表符并不是在当前文本后追加固定数量的空格,而是命令光标“前进到当前行下一个制表位所在列”。
二、排查与替代方案实施路径
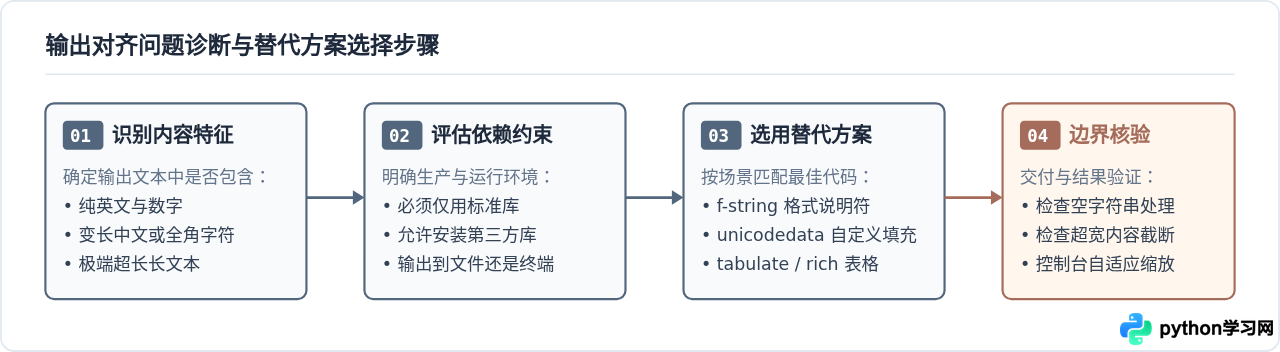
要彻底解决输出不对齐的问题,不能靠在字符串后面碰运气拼接 \t * 2 这种易碎的权宜之计,而应按照标准诊断逻辑选择稳健的实现手段。
三、替代方案一:原生 f-string 与 format 格式化(纯英文与数字场景)
如果输出内容主要是英文字符、数字或固定符号,Python 内置的 f-string(或 str.format())是最轻量、零外部依赖的替代方式。
格式说明符语法为:{值:对齐方向 宽度}:
<表示左对齐(文本默认行为)。>表示右对齐(数值推荐行为)。^表示居中对齐。
# 示例:通过 f-string 严格指定列宽
headers = ["ID", "Name", "Role", "Salary"]
data = [
    ["001", "Bob", "Dev", "12000"],
    ["002", "Alexander", "DevOps", "16000"],
    ["003", "Tom", "QA", "9500"]
]

# 分别指定 6, 14, 10, 8 个字符宽度
row_template = "{:<6}{:<14}{:<10}{:>8}"

print(row_template.format(*headers))
print("-" * 38)
for row in data:
    print(row_template.format(*row))
即使 Alexander 长度为 9,只要我们给 Name 列预留了充足的字符宽度(如 14),它就不会把下一列挤偏,整齐划一。
四、替代方案二:解决中英文混排对齐(unicodedata 动态宽度计算)
许多开发者使用 f"{name:<10}" 后会惊讶地发现:一旦填入中文汉字,表格依然对不齐!
其根源在于:在 Python 中,len("中国") 返回的是字符个数 2,因此 f"{'中国':<10}" 会在后面补上 8 个英文半角空格。但在大多数等宽终端字体中,一个汉字占据 2 个半角字符的显示宽度。2 个汉字(视觉占4位)+ 8个空格 = 视觉占 12 位,而非预期的 10 位,进而造成后续列向右偏移。
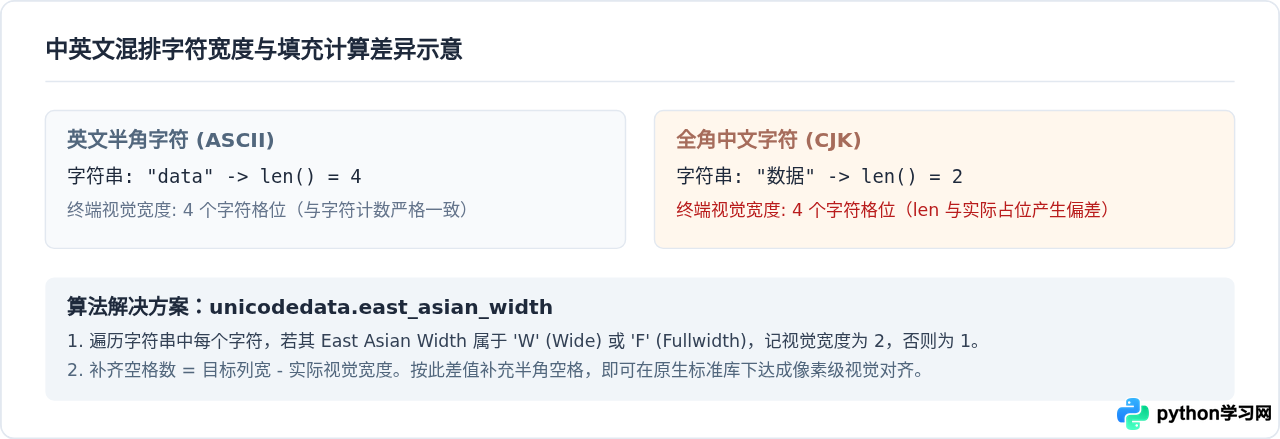
利用标准库 unicodedata,可以封装一个轻量的自适应中英文对齐函数:
import unicodedata

def get_display_width(text: str) -> int:
    """计算字符串在终端中的实际显示宽度(全角字符计为2,半角计为1)"""
    width = 0
    for char in text:
        # W: Wide (如中日韩汉字), F: Fullwidth (全角字符)
        if unicodedata.east_asian_width(char) in ('W', 'F'):
            width += 2
        else:
            width += 1
    return width

def pad_text(text: str, target_width: int, align: str = 'left') -> str:
    """按终端显示宽度对齐字符串,不足部分用空格补齐"""
    current_width = get_display_width(text)
    pad_len = max(0, target_width - current_width)

    if align == 'right':
        return ' ' * pad_len + text
    elif align == 'center':
        left_pad = pad_len // 2
        right_pad = pad_len - left_pad
        return ' ' * left_pad + text + ' ' * right_pad
    else:  # left
        return text + ' ' * pad_len

# 实际测试中英文混排表格输出
headers = ["工号", "员工姓名", "所属部门", "基本工资"]
table = [
    ["01", "李明", "技术研发部", "15000"],
    ["02", "Alexander", "运维部", "16500"],
    ["03", "诸葛孔明", "架构设计", "28000"],
]

widths = [8, 14, 16, 10]

# 打印表头
header_line = "".join(pad_text(h, w) for h, w in zip(headers, widths))
print(header_line)
print("-" * sum(widths))

# 打印数据行
for row in table:
    line = "".join(pad_text(item, w) for item, w in zip(row, widths))
    print(line)
运行效果(即使名字有中文双字、四字或长英文,都能在控制台中对齐):
五、替代方案三:成熟第三方表格库(生产环境首选)
当需要生成具备表格线、分页、表头自适应或 Markdown/HTML 导出的复杂报表时,编写自制补齐函数维护成本较高,推荐使用成熟的开源三方库。
1. tabulate:轻量且多格式支持
tabulate 极为简单,仅需调用一个函数即可自动计算列宽并生成漂亮的外框:
# 安装: pip install tabulate
from tabulate import tabulate

data = [
    ["001", "Bob", "Dev", 12000],
    ["002", "Alexander", "DevOps", 16000],
    ["003", "Tom", "QA", 9500]
]
headers = ["ID", "Name", "Role", "Salary"]

print(tabulate(data, headers=headers, tablefmt="grid"))2. rich.table:现代高颜值控制台终端排版
rich 支持色彩高亮、边框样式自定义、自动根据终端尺寸截断或换行,非常适合 CLI 命令行工具开发:
# 安装: pip install rich
from rich.console import Console
from rich.table import Table

console = Console()
table = Table(title="员工信息表")

table.add_column("ID", justify="center", style="cyan")
table.add_column("姓名", justify="left", style="white")
table.add_column("岗位", justify="left", style="green")
table.add_column("薪资", justify="right", style="magenta")

table.add_row("001", "Bob", "Dev", "12,000")
table.add_row("002", "Alexander", "DevOps", "16,000")
console.print(table)
六、方案选型与对比总结
选择对齐方案时,不需要一律引入重量级第三方库,也不要退回使用脆弱的 \t。根据具体的场景权衡轻重即可:
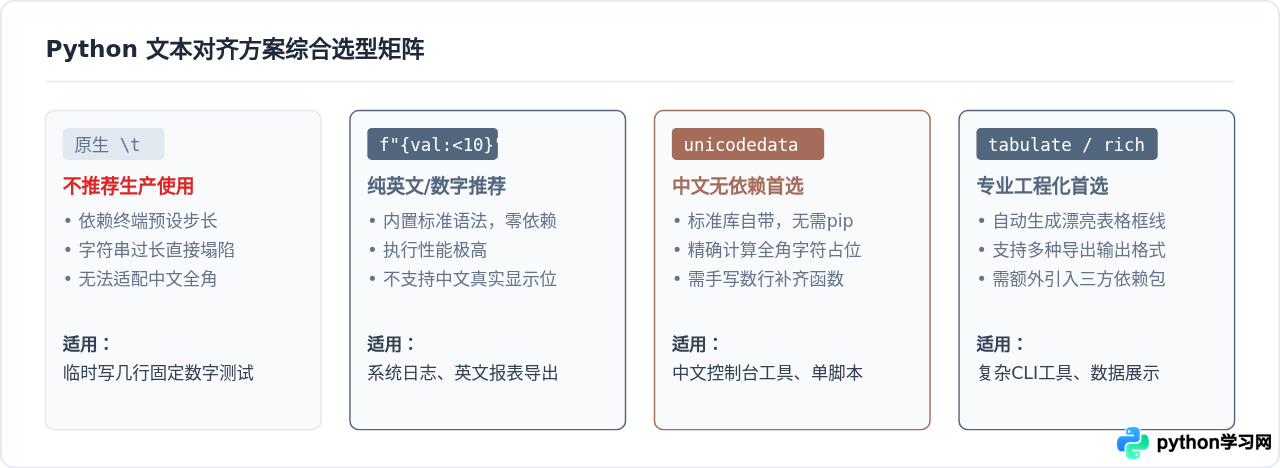
csv.writer(f, delimiter='\t')。在数据存储和交换领域,制表符是规范的“字段分隔符”;但在视觉排版与控制台显示领域,应坚决使用定宽格式化或表格排版库替代 \t。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









