

自学Python坚持不下去怎么办?提升学习效率的实用技巧
针对自学Python容易半途而废的问题,本文提供一套从认知重构、最小必要语法掌握、微型项目驱动到标准化调试排错的完整提效方案,帮助初学者建立持续的正向反馈闭环。
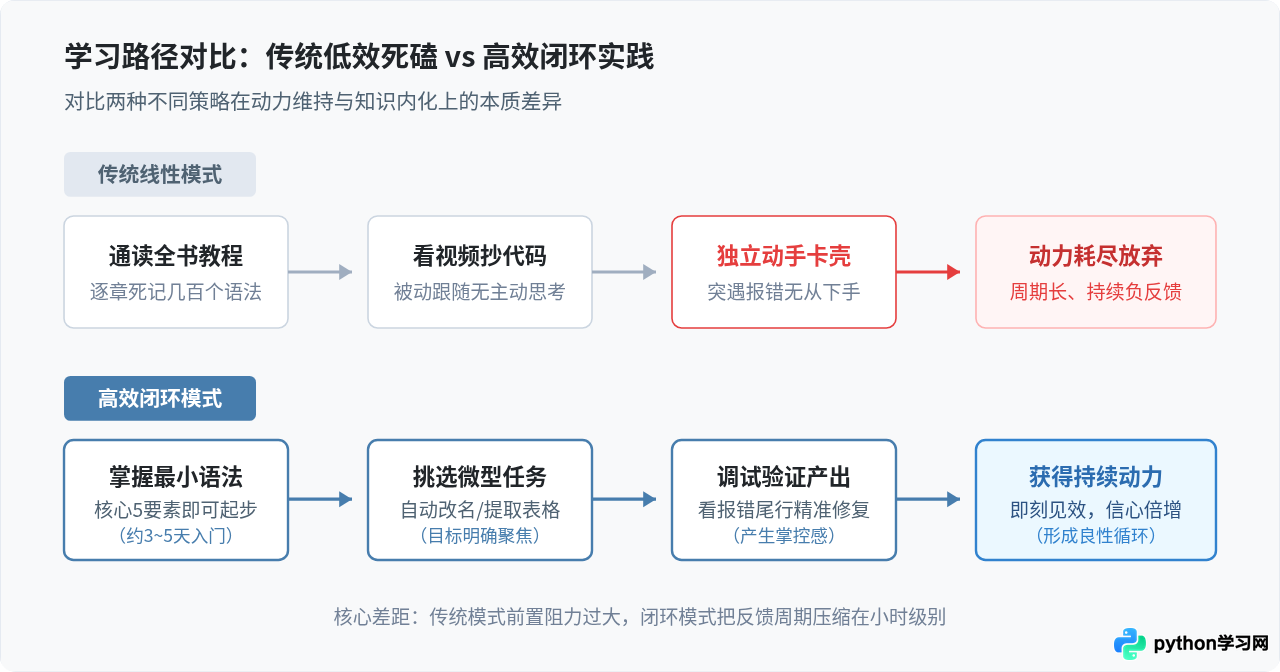
多数自学 Python 最终放弃的人,往往并不是缺乏逻辑思维或数学底子,而是在学习初期陷入了“囤积语法教程、被动抄写示例、一独立写代码就频繁报错、长期看不到实际成果”的负反馈循环。要扭转这种局面,根本办法是重构学习路径:摒弃“必须通读大部头教材”的执念,提炼出能立即解决问题的“最小必要语法”,用小时级的微型实用项目驱动练习,并掌握标准化的报错排查流程,在持续获得正面产出中建立自学的飞轮。
一、诊断挫败来源:为何传统的死磕方式极易放弃
审视大多数初学者的自学经历,往往从购买一本厚达六七百页的语法书或收藏上百集视频合集开始。这种做法看似规划完整,实则埋下了三大动力陷阱:
- 语法囤积陷阱:试图在写出第一行有用程序前,把条件判断、循环、面向对象、异常处理、装饰器甚至多线程全背一遍。战线拉得太长,前面学完后面忘记,陷入持续的自我怀疑。
- 被动跟随的虚假充实:看着视频教学把代码一字不差敲进编辑器,运行通过时误以为自己完全掌握。然而一旦关闭视频自己新建一个空白文件,连第一行该从哪里写起都没有头绪。
- 目标颗粒度过大:很多初学者一上手就立志做“自动化高频交易系统”或“全网爬虫分布式集群”,由于涉及知识面过于庞杂,稍遇网络反爬、异步协程等难点便陷入停滞,最终弃坑。
二、精简前置输入:掌握“最小必要语法”即可开工
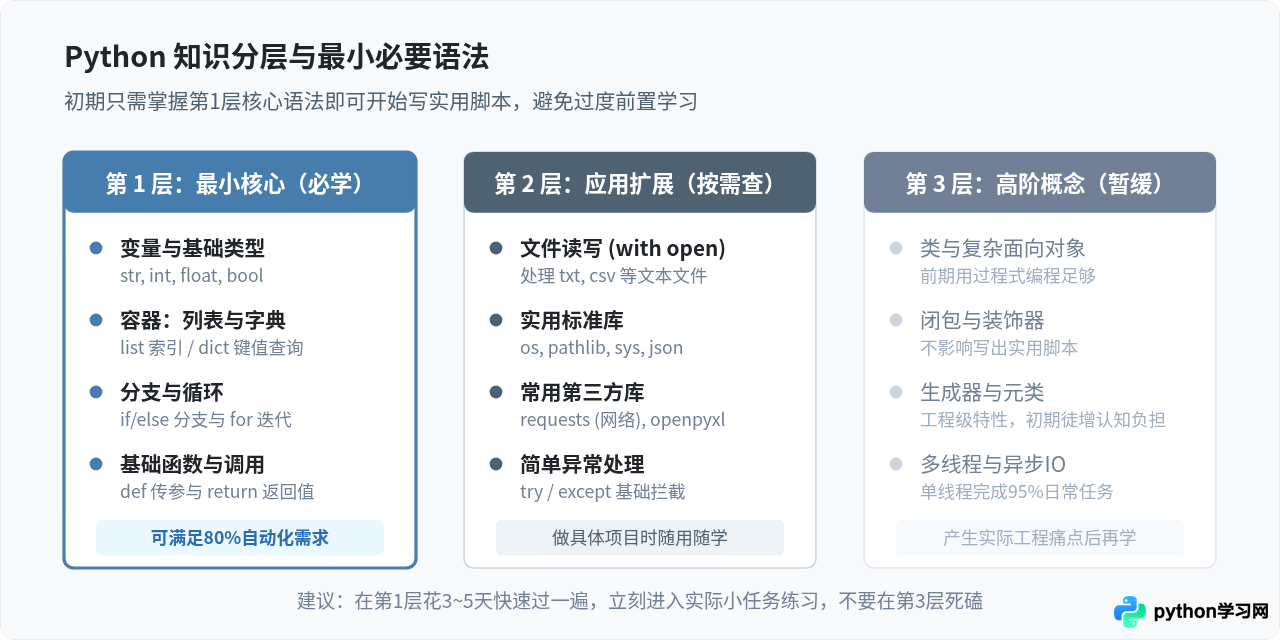
编程语言的语法库非常庞大,但在实际日常脚本开发中,前 20% 的基础语法就足以支撑 80% 的工作场景。把教材当作“按需查阅的技术字典”,而不是“必须从头背到尾的教科书”。在开启具体项目之前,只需集中 3 到 5 天时间掌握以下五项核心构件:
- 变量与基础数据类型:字符串(str)、整数(int)、浮点数(float)与布尔值(bool)。理解变量是存放数据的“标签盒子”。
- 基础数据容器:列表(list)用于按顺序存放多个元素;字典(dict)用于键值对(Key-Value)的高效映射。
- 分支判断:
if、elif、else条件分支,用于根据数据状态做出不同执行逻辑。 - 循环迭代:
for循环用于遍历列表、字典或字符串;while循环用于满足特定条件时重复操作。 - 函数封装:用
def声明一个函数,明确接收哪些入参,并通过return返回结果,实现代码的复用。
至于面向对象的类继承、元类、闭包装饰器、多进程并发等概念,在初学者阶段一律暂缓。它们是工程级架构特性,强行提前学习只会徒增认知负担。
三、微型项目驱动法:把被动学习转化为实际产出
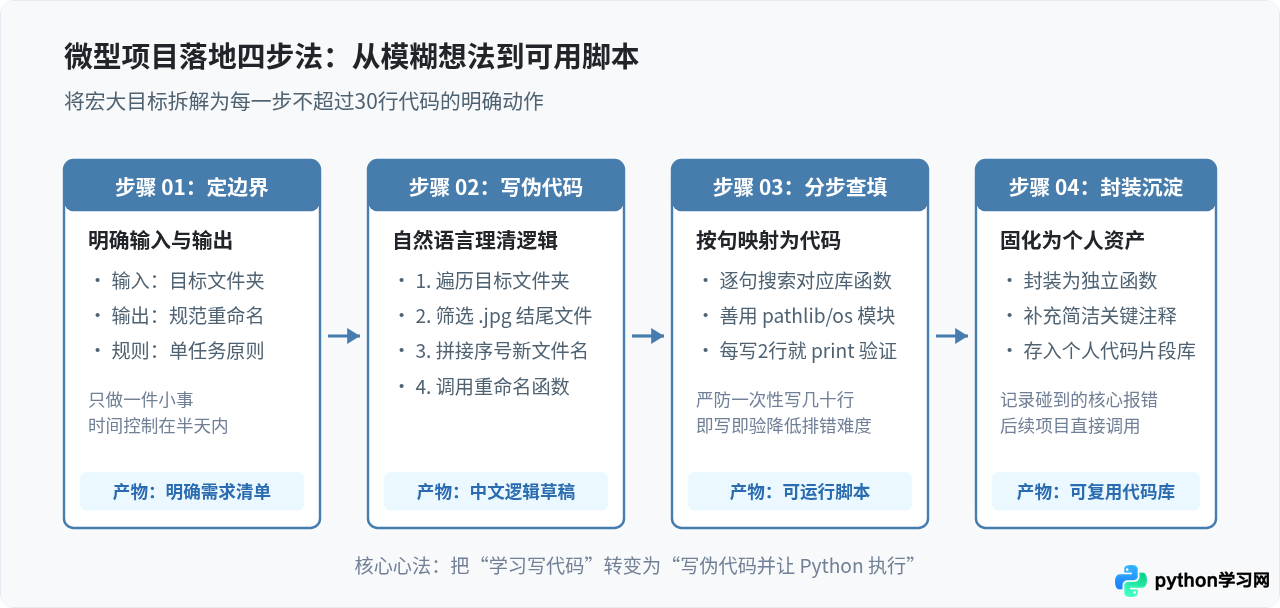
坚持自学的核心动力源于“代码真的帮我解决了具体麻烦”。不要把“学会某个知识点”当成目标,而要把“实现一个半小时内能跑通的小工具”作为冲刺终点。以下是适合新手的典型微型项目场景:
- 文件夹自动整理:遍历下载目录,把
.jpg和.png移动到“图片”目录,.pdf移动到“文档”目录。 - 批量文件重命名:将某个课程目录下的所有杂乱视频文件名统一按“第01讲”、“第02讲”格式重新编号。
- 数据提取转换:从几十份格式相同的 CSV 表格中,提取销售额列并计算总和,直接打印出汇总数据。
实战示例:编写批量重命名脚本
以“批量给指定文件夹内的图片增加前缀与序号”为例,以下是完整、可运行的代码示例。它仅仅串联了基础的 pathlib 模块、enumerate 遍历以及 rename 方法,全长不到 20 行:
from pathlib import Path

def batch_rename_images(target_dir: str, prefix: str = "photo"):
    folder = Path(target_dir)
    if not folder.exists():
        print(f"提示:目标路径 {target_dir} 不存在,已终止。")
        return

    # 筛选所有 .jpg 与 .png 图片
    valid_extensions = {".jpg", ".jpeg", ".png"}
    files = [f for f in folder.iterdir() if f.is_file() and f.suffix.lower() in valid_extensions]

    # 打印中间状态以确保筛选正确
    print(f"已发现 {len(files)} 个待重命名图片文件。")

    for index, file_path in enumerate(files, start=1):
        # 构造新文件名,例如:photo_001.jpg
        new_name = f"{prefix}_{index:03d}{file_path.suffix.lower()}"
        new_path = file_path.with_name(new_name)

        # 执行重命名
        file_path.rename(new_path)
        print(f"已处理: {file_path.name} -> {new_name}")

if __name__ == "__main__":
    # 使用时替换为本地实际测试路径
    batch_rename_images("./test_folder", prefix="vacation")
初学者切忌一次性把整个脚本敲完才按运行键。正确习惯是:写出 folder.iterdir() 后,立即使用 print(file_path) 查看输出;确认文件路径无误后,再写字符串拼接并打印 new_name;最后一步才调用 rename。小步快跑,每一步都能亲眼看到状态变化,调试压力会骤减 90%。
四、标准化排错:化解卡壳造成的放弃冲动
自学路上最磨损耐心的时刻,莫过于终端弹出长达十几行的红字报错(Traceback)。初学者往往被大段英文吓退,甚至不知道该看哪里。实际上,Python 的报错信息极其规范,排查仅需四步:
- 直奔最后一行:异常的最精确描述永远在输出的最底部。例如
IndexError: list index out of range(列表索引超出范围)或KeyError: 'age'(字典中找不到指定键)。 - 向上寻找自己的源码行号:倒数第 2 至第 4 行中,寻找带有自己所写文件名(如
test.py)及行号(如line 14)的记录,忽略进入标准库底层的堆栈。 - 使用 print 检查上下文变量:在报错代码行的上一行,插入
print("DEBUG:", repr(变量名)),确认传入的数据是否为None、空列表,或者实际类型与预期不符。 - 脱敏搜索技术社区:若无法自行理解,将最后一行的错误名称与简述复制到搜索引擎(去掉个人特定的变量名或本地磁盘路径)。99% 的入门级错误在技术社区中已有成熟答案。
五、构建动力维持系统:让学习进入正循环
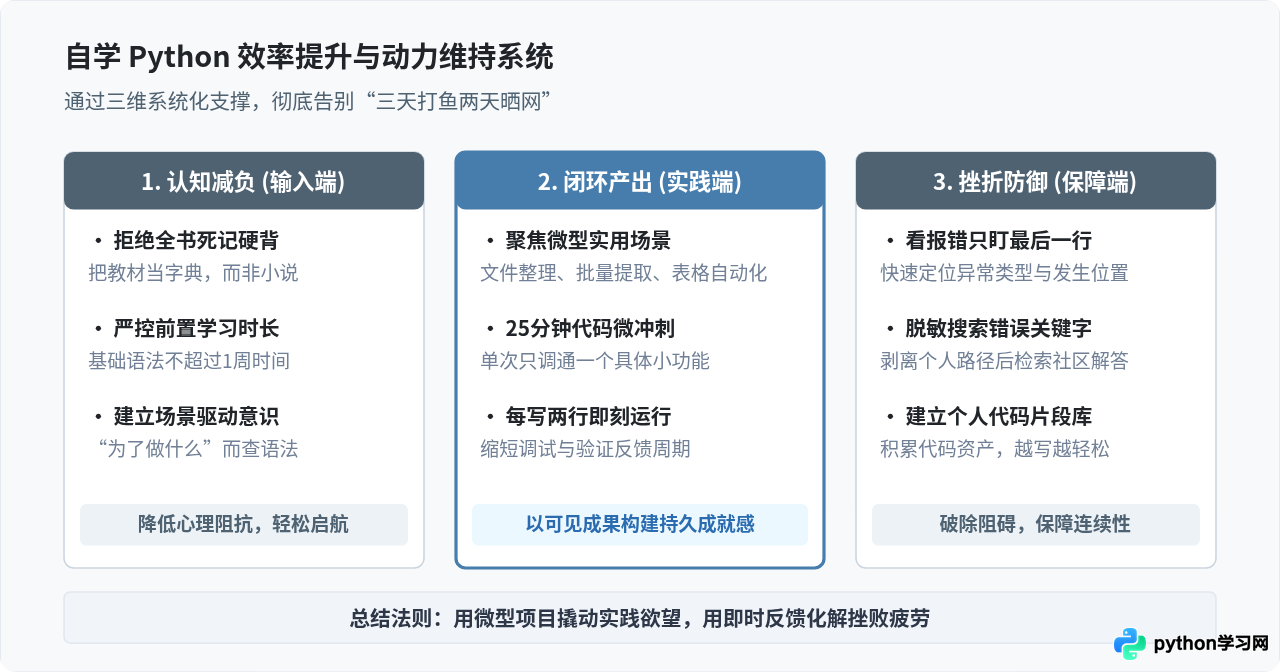
编程能力不是看书看出来的,而是通过键盘击打出来的肌肉记忆。为了让自学过程不再“三天打鱼两天晒网”,建议建立以下三套配套习惯:
- 25分钟聚焦工作块:每次坐下只专注解决一个具体的小疑问(例如“如何读取 CSV 表格中的第一行”),时间一到立刻休息。小目标易启动,不会产生心理拖延。
- 维护个人的 Snippets 代码片段库:每调通一段解决具体问题的代码(如读写 JSON、发送 GET 请求、解析日期),就存入自己的代码笔记本,写上中文用途说明。随着库存越来越丰富,后续开发会像搭积木一样顺畅。
- 以解决现实问题为导向:哪怕只是写一个能帮自己自动计算发票报销金额的脚本,其带来的成就感与记忆深度,也远胜于在 LeetCode 机械刷十道脱离业务的算法题。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









