

Python机器学习实战:使用scikit-learn进行数据预测的步骤详解
本文系统拆解使用 Python 和 scikit-learn 完成机器学习数据预测的标准步骤,涵盖数据划分、特征预处理流水线构建、模型拟合、评估指标验证及新数据预测推断,并深入辨析避免数据泄露的工程实践规范。
一、数据预测的标准工程链路
scikit-learn(简称 sklearn)采用高度统一的面向对象设计。无论处理何种预测任务,核心步骤均遵循“样本划分 → 预处理流水线 → 模型拟合(fit) → 预测推断(predict)”的标准闭环。理清这个流程能帮助开发者避免常见的方法混淆与验证偏差。
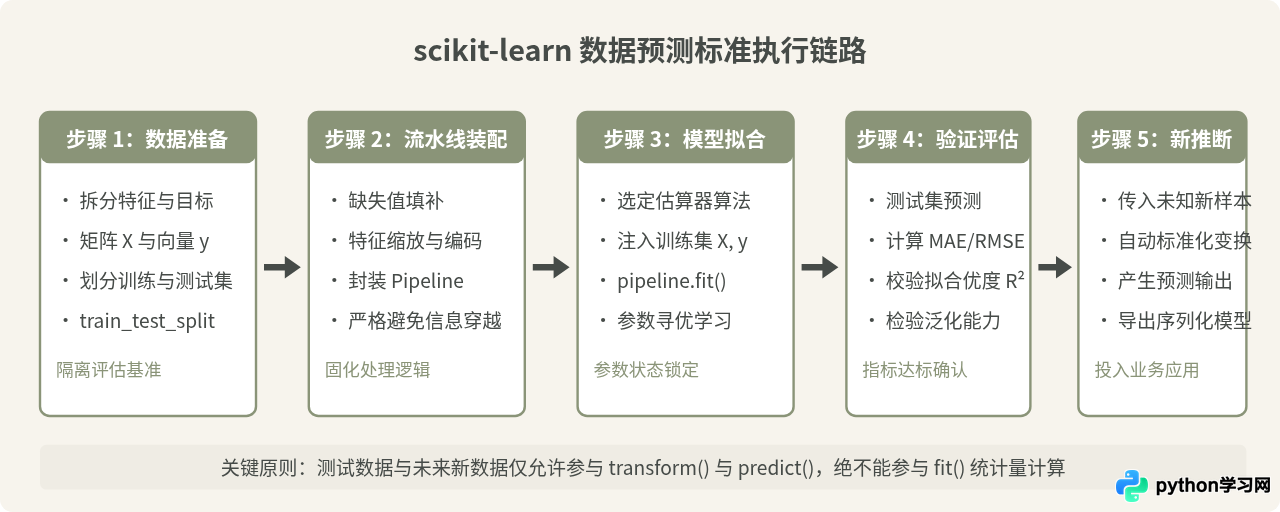
图 1:使用 scikit-learn 完成端到端预测的标准工序与各阶段目标
二、环境准备与样本集隔离
在开始编写代码前,需确认安装了 scikit-learn、numpy 与 pandas。执行环境可通过终端命令完成安装:
pip install scikit-learn pandas numpy进行预测建模时,首要动作是将特征矩阵(通常记为 X)与目标值向量(通常记为 y)显式分离,并立即划分测试集。测试集的作用是模拟未来未知的真实数据。若在划分前对全量数据做统计计算,将直接破坏验证的可靠性。
通过 train_test_split 函数,可以确定性地切分数据集。设置 random_state 参数能确保结果完全可复现:
import numpy as np
import pandas as pd
from sklearn.model_selection import train_test_split

# 构造模拟数据集:根据房屋面积、房间数、房龄预测价格
np.random.seed(42)
n_samples = 300

area = np.random.uniform(50, 180, n_samples)
rooms = np.random.randint(1, 6, n_samples)
age = np.random.uniform(1, 30, n_samples)

# 真实生成机制 + 随机高斯噪声
price = area * 4.2 + rooms * 15.0 - age * 1.5 + 50 + np.random.normal(0, 15, n_samples)

df = pd.DataFrame({
    'area': area,
    'rooms': rooms,
    'age': age,
    'price': price
})

# 1. 拆分特征与目标
X = df[['area', 'rooms', 'age']]
y = df['price']

# 2. 划分训练集(80%)与测试集(20%)
X_train, X_test, y_train, y_test = train_test_split(
    X, y, test_size=0.2, random_state=42
)
三、核心误区辨析:预处理中的“数据泄露”
初学者容易产生一种看似合理的做法:“在切分训练集和测试集之前,先对整个数据集进行标准化(StandardScaler)或缺失值填充”。
这种做法初看很有道理:利用全部 300 个样本计算特征的均值和标准差,样本量更多,计算出来的均值显然“更准确、更稳定”,而且写代码只需一次调用,省去了两处管理转换器的麻烦。然而,这个做法在统计与机器学习工程上是错误的。
错误原因在于“数据泄露”(Data Leakage):标准化过程中的均值 $\mu$ 和方差 $\sigma$ 是模型的先验统计参数。如果在划分前基于全体数据计算,测试集的统计分布信息就提前渗透到了模型训练阶段。这会导致测试集上的评估得分虚高,掩盖模型在真实未知数据上的过拟合风险。一旦部署到线上,真实生产数据无法提前参与历史均值的计算,预测误差便会大幅上升。
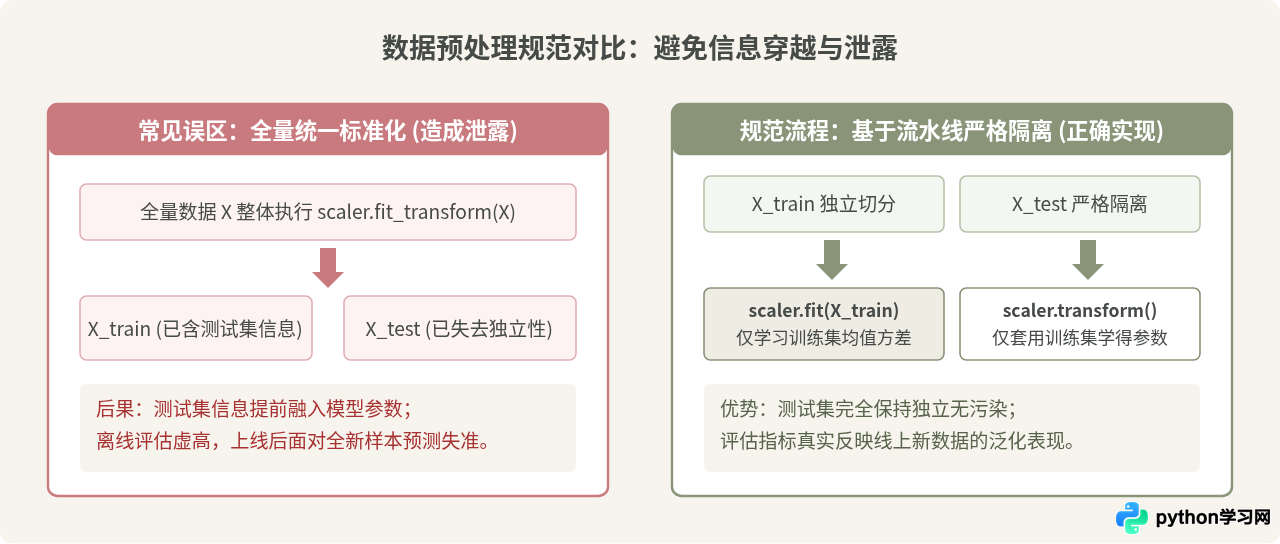
图 2:数据泄露机制与严格隔离预处理的执行差异
四、使用 Pipeline 构建与拟合模型
为了从代码结构上彻底防止数据泄露,最佳实践是使用 sklearn.pipeline.Pipeline。Pipeline 可以将多个转换器(Transformers)与最终的估算器(Estimator)串联成一个整体。
对 Pipeline 执行 fit() 时,它会自动对前面的预处理阶段执行 fit_transform(),而在后续步骤或测试集上自动调用 transform(),无需手动切换。
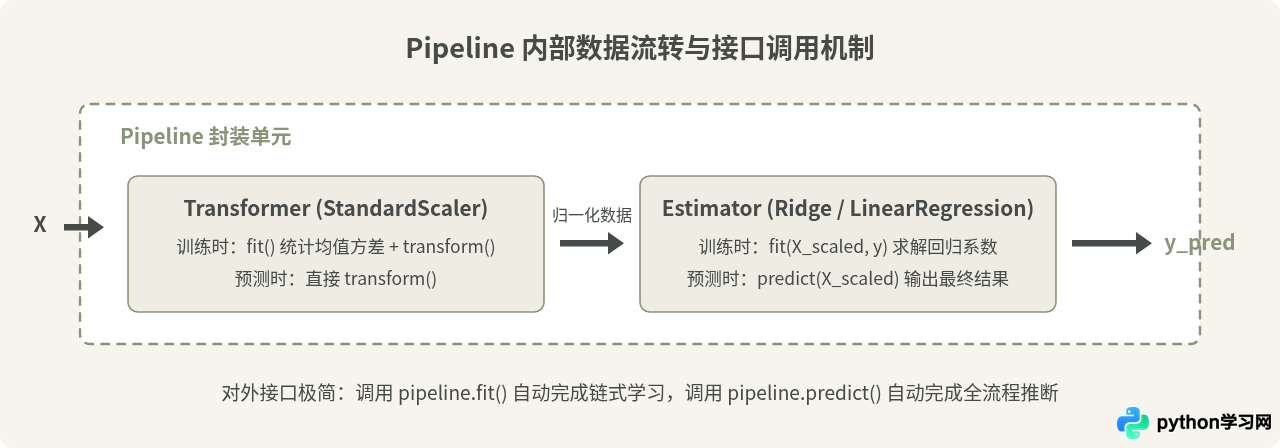
图 3:scikit-learn 中 Pipeline 容器对于预处理与预测模型的统一调度
下面是建立 Pipeline 并使用岭回归(Ridge)算法完成拟合的代码示例:
from sklearn.pipeline import Pipeline
from sklearn.preprocessing import StandardScaler
from sklearn.linear_model import Ridge

# 创建管道:步骤一为特征标准化,步骤二为正则化线性回归
model_pipeline = Pipeline([
    ('scaler', StandardScaler()),
    ('regressor', Ridge(alpha=1.0))
])

# 针对训练集执行拟合
# 内部自动执行:scaler.fit_transform(X_train) -> regressor.fit(X_train_scaled, y_train)
model_pipeline.fit(X_train, y_train)
五、模型评估:度量预测准确性
模型在训练集上完成参数优化后,必须使用此前完全隔离的 X_test 和 y_test 验证泛化能力。回归预测任务中,常用的量化指标包括:
- 平均绝对误差 (MAE):预测值与真实值差值绝对值的平均数,反映平均误差幅度,单位与目标变量完全一致。
- 均方根误差 (RMSE):误差平方的均值开根号,对异常大误差更为敏感。
- 决定系数 ($R^2$):度量模型对目标方差的解释比例,1 表示完美预测,0 表示等同于仅使用均值基准,小于 0 表示预测质量极差。
评估代码实现如下:
from sklearn.metrics import mean_absolute_error, root_mean_squared_error, r2_score

# 在测试集上进行预测推断
# Pipeline 会自动对 X_test 调用之前训练好的 scaler.transform(),再送入回归器预测
y_pred_test = model_pipeline.predict(X_test)

# 计算各项指标
mae = mean_absolute_error(y_test, y_pred_test)
rmse = root_mean_squared_error(y_test, y_pred_test)
r2 = r2_score(y_test, y_pred_test)

print(f"测试集 MAE:  {mae:.2f}")
print(f"测试集 RMSE: {rmse:.2f}")
print(f"测试集 R²: {r2:.4f}")测试集 MAE: 11.85
测试集 RMSE: 14.62
测试集 R²: 0.9856
注:上述数值为本示例运行生成的参考结果,实际运行数值因数据随机波动存在微小差异。$R^2$ 超过 0.98 表明模型成功捕获了特征与价格之间的主要线性关系。
六、执行新数据预测与模型固化
模型评估达标后,即可将其应用于生产环境处理未来产生的未知样本。输入新样本时,其特征名称、列顺序及数据类型必须与训练阶段的 X 保持完全一致。
预测新样本的完整操作如下:
# 构造一条未知的新房屋数据:面积 115 平米,3 个房间,房龄 5 年
new_house = pd.DataFrame([{
    'area': 115.0,
    'rooms': 3,
    'age': 5.0
}])

# 直接通过 Pipeline 进行预测
predicted_price = model_pipeline.predict(new_house)
print(f"新房屋预测价格为: {predicted_price[0]:.2f} 万元")新房屋预测价格为: 569.18 万元
在实际应用中,通常不需要每次预测都重新训练模型。可以使用 joblib 库将训练好的 Pipeline 完整对象序列化持久化到磁盘上,后续服务直接加载即可投入预测:
import joblib

# 保存模型管道至磁盘
joblib.dump(model_pipeline, 'house_price_model.joblib')

# 在生产预测脚本中恢复模型
loaded_model = joblib.load('house_price_model.joblib')

# 使用加载的模型执行预测
batch_houses = pd.DataFrame([
    {'area': 80.0, 'rooms': 2, 'age': 12.0},
    {'area': 140.0, 'rooms': 4, 'age': 2.0}
])
batch_predictions = loaded_model.predict(batch_houses)
print("批量预测结果:", np.round(batch_predictions, 2))
七、实战复盘与开发检查清单
为了保证预测模型在真实业务中稳定可靠,开发者可以参考下述检查清单,核对每个环节的实现细节:
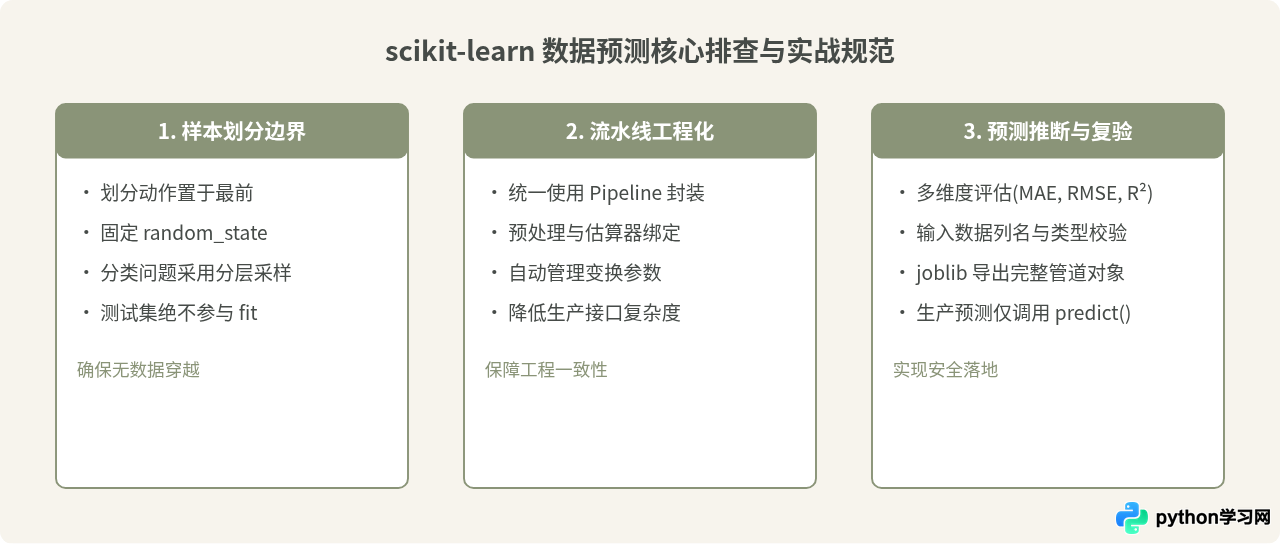
图 4:使用 scikit-learn 进行预测任务的开发排查与避坑清单
掌握了数据隔离逻辑、流水线组装规范以及推断部署步骤后,开发者即可将该框架平滑拓展至随机森林、梯度提升树或分类预测等更多复杂的 scikit-learn 机器学习应用场景中。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









