

在线运行Python代码提示超时或报错怎么办
针对在线运行Python代码时常见的超时和报错提示,详细分析沙盒机制、死循环、等待输入、缺少依赖等根源,并提供条理清晰的排查步骤与修复方案。
在各类在线Python编译器、刷题平台或云端实验环境中,代码无法正常返回结果通常分为两类情形:“超时”大多由于代码陷入死循环、存在无法响应的键盘输入等待,或算法时间复杂度过高;而“报错”则源于语法符号失误、调用了沙盒未安装的第三方库,或是运行时触发了异常边界。本文将梳理这两种状态的本质原因,并提供按部就班的排查路径与修复方案。
一、快速分流:明确“超时”与“报错”的排查分工
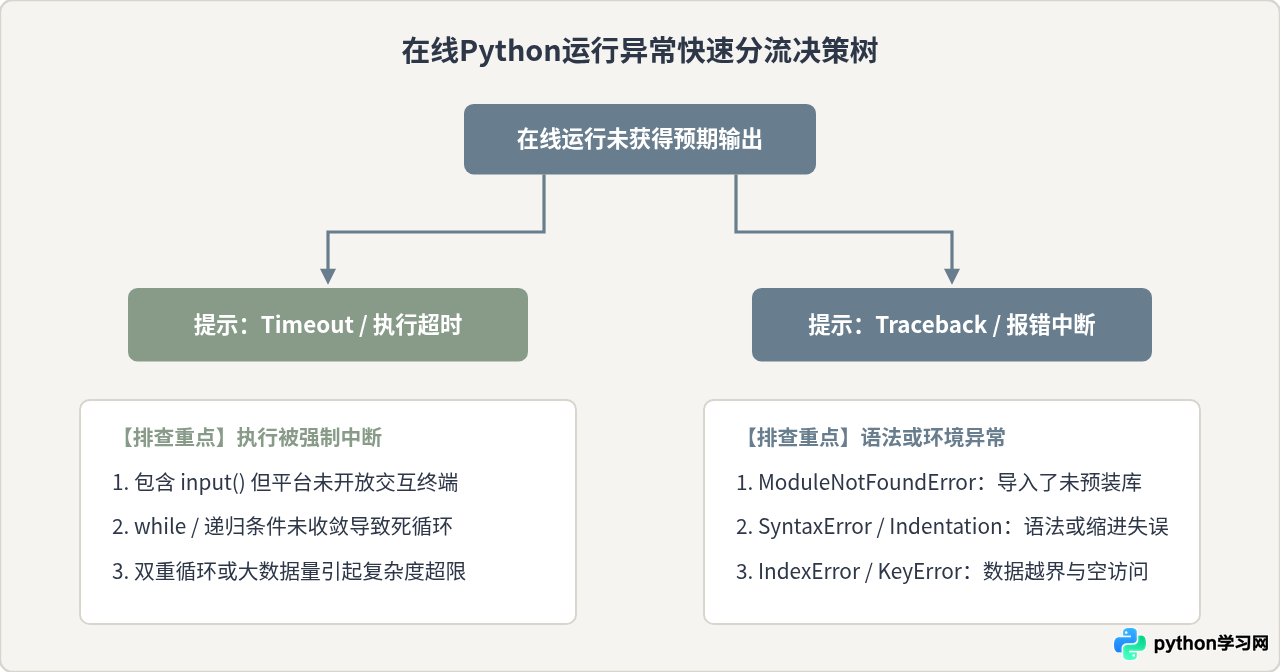
当在线工具提示执行失败时,首先需要看清系统返回的提示文字。平台给出的反馈信息决定了排查的方向,切忌在没有看清状态前盲目修改代码逻辑:
- 超时提示(Timeout / Time Limit Exceeded / CPU Limit Reached):说明解释器启动了,但没有在系统限定的时间阈值内运行完毕并退出。代码本身可能完全合法,但由于执行卡在某个循环、递归或等待指令中,被平台的安全保护机制强制杀死。
- 报错提示(Error / Exception / Traceback):说明解释器在解析阶段发现语法问题,或在执行到某一具体语句时抛出了异常并中断,通常伴随明确的文件名、行号与错误类别。
二、出现“运行超时”的排查与解决办法
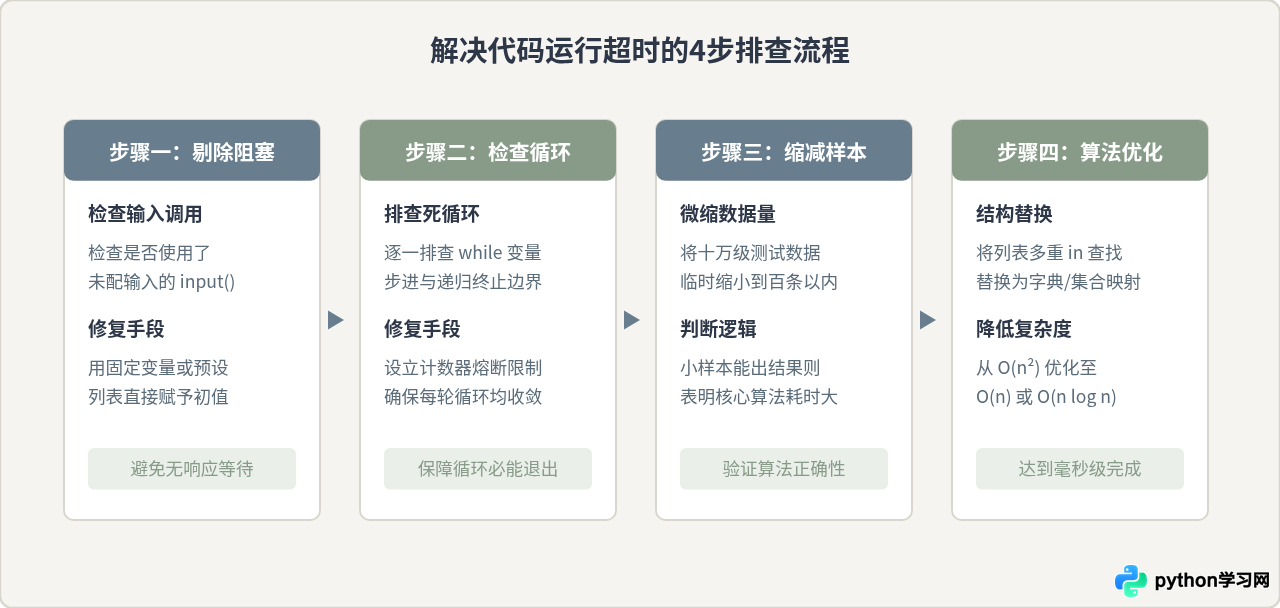
在线环境不同于个人计算机,为了保证服务器多租户的稳定与安全,平台为每次代码执行分配的CPU运行时间通常仅有3秒到15秒。超过该时间,守护进程便会主动切断连接并报出超时错误。
1. 移除交互式 input() 等待
许多刚接触在线工具的初学者习惯在代码中使用 input() 接收控制台输入。大部分简洁型在线运行工具属于一次性批处理模式,没有提供真实的交互式标准输入流。程序运行到 input() 处时会无限期等待键盘信号,直到服务端达到超时时限强制结束。
解决办法:在在线测试中,不要直接调用 input()。改用硬编码的数据变量来替代输入,或者使用预设列表模拟输入流:
# 易超时的写法(在线无交互终端时卡死):
# user_val = input("请输入测试数字:")

# 适合在线运行的写法:
user_val = "100"  # 直接给定测试参数
numbers = [12, 45, 68, 93]
print(f"测试输入值为: {user_val},处理结果: {int(user_val) * 2}")
2. 排查死循环与递归出口
如果循环的更新变量缺失或判断条件永远为真,代码就会陷入死循环。由于在线环境无法像本地终端那样按下 Ctrl + C 实时打断,只能等待平台判定超时。
# 错误示例:缺少步长递增导致死循环
i = 0
total = 0
while i < 10:
    total += i
    # 漏写 i += 1,导致 i 永远为 0,在线运行直接超时

# 正确示例:确保计数器更新并设立安全边界
i = 0
total = 0
while i < 10:
    total += i
    i += 1
print("累加结果:", total)RecursionError,而是直接因为堆栈消耗殆尽导致超时。
3. 控制测试样本规模与算法复杂度
如果算法包含多层嵌套循环(如 $O(n^2)$ 甚至更高级别),当数据样本达到数十万级别时,运算所需时间将大幅超出在线沙盒的时限。
解决办法:在验证代码逻辑时,优先使用 10 到 100 条的小规模数据进行验证,确认逻辑无误后再考虑扩大数据量;同时尽量采用字典哈希查找或内置集合,减少不必要的嵌套循环检索。
三、出现具体报错(Error)时的精准修复指南
当平台输出了红色的 Traceback (most recent call last) 信息时,表明程序抛出了具体异常。排查的第一原则是直接阅读最后一行报错类型与行号提示。
1. 依赖库缺失:ModuleNotFoundError
ModuleNotFoundError: No module named 'requests' 或 'pandas' 是在线运行环境最常见的报错之一。
- 原因:绝大多数轻量级在线编译器仅自带 Python 基础标准库(如
math,json,random,re,sys等),并未在服务器容器中安装重量级科学计算或网络爬虫第三方库。 - 修复方案:
- 如果平台具备终端命令行或支持魔法指令,尝试在首行写入
!pip install 库名安装依赖。 - 若属于轻量测试网站,改用标准库替代。例如需要发送网络请求时,使用内置的
urllib.request替代requests;做轻量表格计算时,使用内置的二维列表与csv模块替代pandas。
- 如果平台具备终端命令行或支持魔法指令,尝试在首行写入
2. 语法与缩进失误:SyntaxError 与 IndentationError
在线网页编辑器往往受限于浏览器字体与输入法特性,容易出现看不见的代码格式问题:
- 全半角符号混用:中文输入法下的括号
()、冒号:、引号“”与英文字符外观相近,会导致SyntaxError: invalid character。请全部切换为英文半角输入。 - 制表符(Tab)与空格(Space)混用:从外部网站复制代码粘贴到在线网页时,原有缩进格式常被转换,从而触发
IndentationError: unexpected indent。可在在线编辑器中按Shift + Tab清除缩进后重新统一按4个空格对齐。
3. 运行时异常:IndexError 与 KeyError
这类错误是由于代码对空数据或边界值的容错性不足导致的:
# 易引发 IndexError 的写法:
items = []
# print(items[0])  # 直接抛出 IndexError: list index out of range

# 安全防御写法:
if items:
    print(items[0])
else:
    print("列表为空,跳过索引访问")

# 易引发 KeyError 的字典访问:
user_info = {"name": "Alice"}
# age = user_info["age"]  # 抛出 KeyError: 'age'

# 安全写法:使用 get() 并附带默认值
age = user_info.get("age", 18)
print("年龄:", age)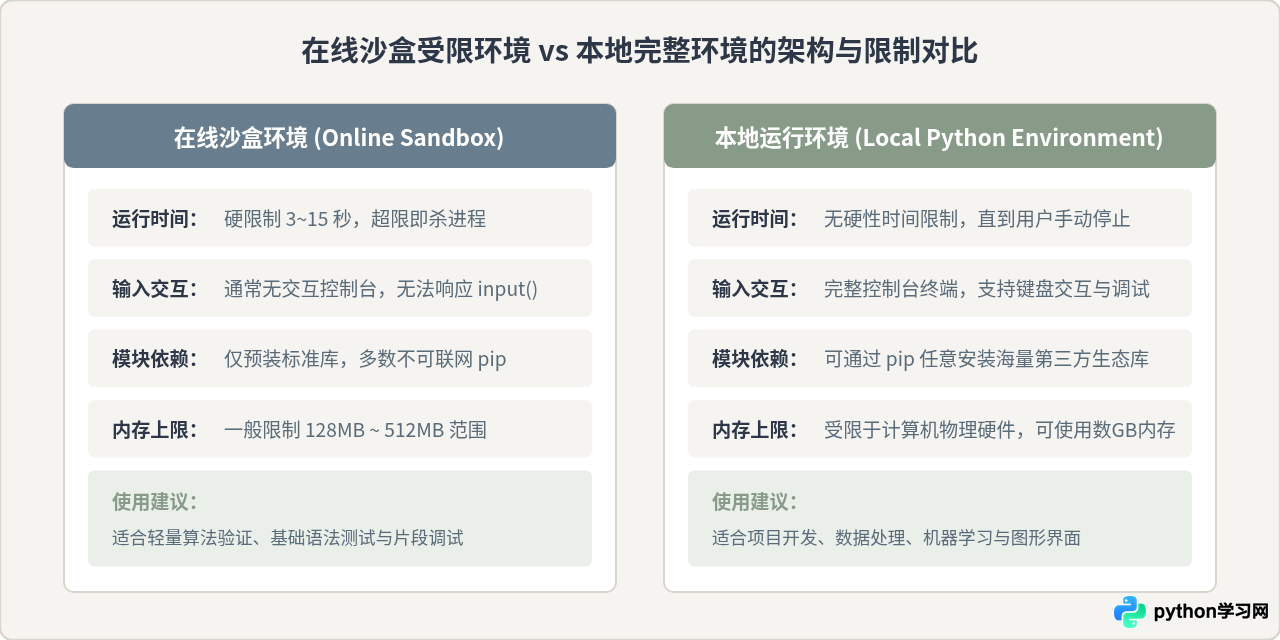
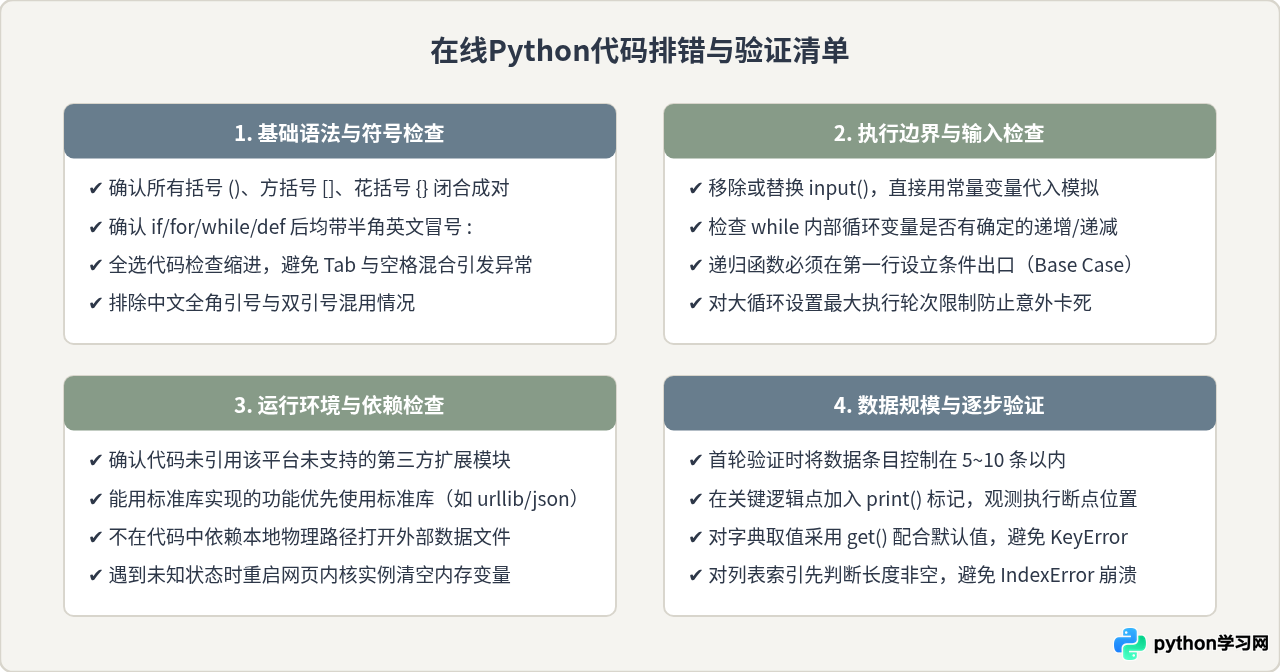
四、避坑清单:在在线环境中稳定运行的排错习惯
为了在在线沙盒中快速获得结果,养成以下调试习惯能有效减少超时与异常报错:
- 善用分段 print() 输出定位点:在线环境无法像本地 IDE 那样随时打断点单步调试。在关键分支(如循环入口、数据清洗前后、函数调用前后)打印简单字符串(如
print("[DEBUG] 进入主循环"))。如果前端输出了该标记却未出结果,说明卡在紧随其后的代码段中。 - 刷新页面或重启内核实例:某些在线 Notebook(如 Jupyter 类型的网页端)会保留上一次执行中的全局变量或占用内存。如果代码逻辑毫无问题但依然超时或报错未定义变量,点击工具栏中的“Restart Kernel”或重置沙箱,清除旧有状态后再试。
- 避免使用本地特有资源路径:在线服务器没有你的本地磁盘路径。代码中若包含
open("D:\\data.txt")或绝对路径,必然触发FileNotFoundError。在在线工具中读取数据时,优先使用字符串直接赋值或使用网页自带的文件上传面板。
五、总结
在线运行Python代码提示超时或报错,本质上是因为在线沙盒环境受到计算时间、无交互控制台和精简依赖这三重边界的约束。面对超时提示,重点关注 input() 阻塞、循环终止条件以及算法数据规模;面对报错提示,则根据 Traceback 识别出语法字符、第三方库依赖或数组越界问题。理清这两条不同的排查路径,就能在在线编程环境中快速定位问题,让代码顺畅运行。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









