

Python基础阶段常见编码误区与规范写法总结
总结Python初学者在基础阶段最容易踩中的编码误区,剖析背后的运行机制,并提供符合PEP 8与Pythonic设计哲学的规范写法与重构实践。
一、可变对象作为函数默认参数
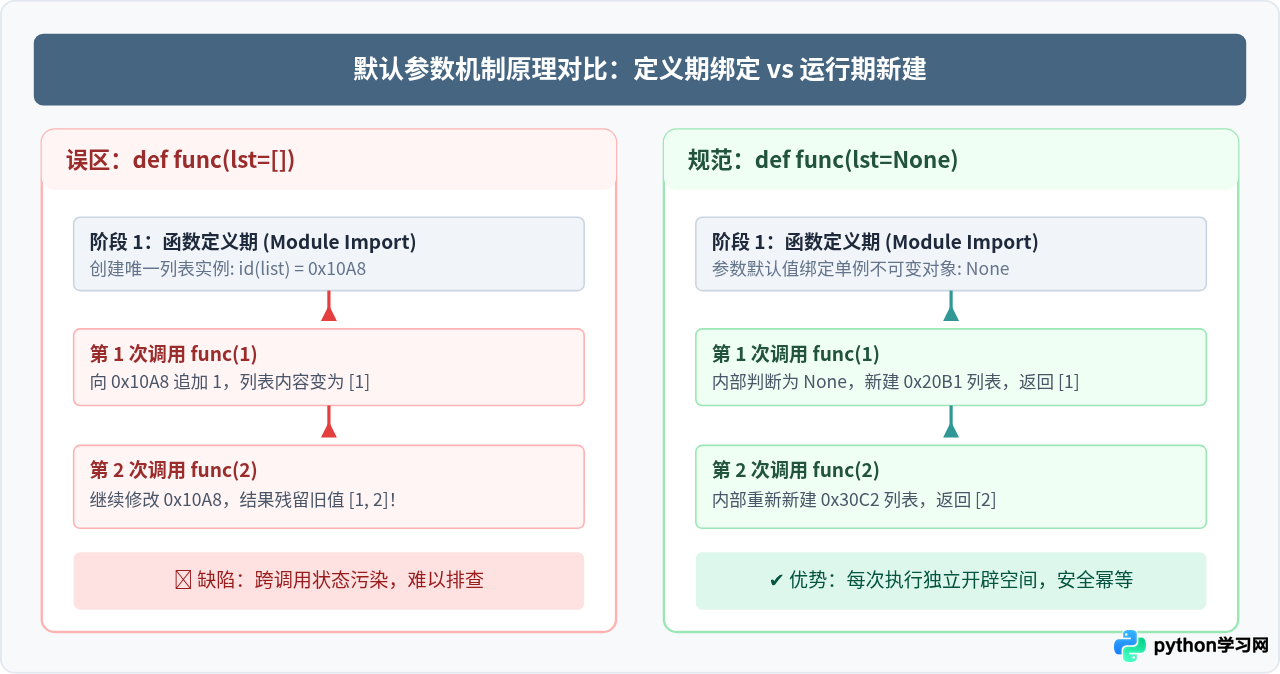
在编写函数时,为一个可选列表或字典设置空容器作为默认值是新手的常见做法。然而,Python 中的函数默认参数只在模块加载并执行 def 语句时求值一次,而不是每次函数调用时重新创建。这意味着该默认对象会在所有未传入实参的函数调用之间被共享。
def append_item(val, container=[]):
    container.append(val)
    return container

# 连续调用将导致状态意外累加
print(append_item(1))  # [1]
print(append_item(2))  # [1, 2],而非预期的 [2]
container 绑定在函数对象的 __defaults__ 元组中,每次就地修改都会污染后续调用。
def append_item(val, container=None):
    if container is None:
        container = []
    container.append(val)
    return container

print(append_item(1))  # [1]
print(append_item(2)) # [2] 保持调用隔离None 作为占位符,在函数作用域内部显式创建新实例,确保每次调用的独立性。
二、遍历容器过程中直接增删元素
在 for item in my_list: 遍历时直接调用 my_list.remove() 或 del 是初学者极易出现逻辑漏洞的场景。Python 的列表迭代器依靠内部偏移指针推进,当原列表长度动态变化时,后续元素的索引会前移,导致迭代器跳过相邻元素。
nums = [1, 2, 2, 3, 4]
for n in nums:
    if n == 2:
        nums.remove(n)

# 实际输出: [1, 2, 3, 4],第二个 2 漏删!
print(nums)nums = [1, 2, 2, 3, 4]
# 方法 A:列表推导式直接构建过滤后新列表(推荐)
filtered_nums = [n for n in nums if n != 2]
# 方法 B:如果必须原地修改,遍历切片浅拷贝
for n in nums[:]:
if n == 2:
nums.remove(n)nums[:] 保证了迭代对象与修改对象分离。
三、过度宽泛的异常捕获
编写稳健代码离不开异常控制,但不少初学者为了省事直接使用裸 except: 或 except Exception:,这种做法会掩盖语法错误、变量名拼写错误,甚至是系统中断信号(如 KeyboardInterrupt),给调试带来巨大障碍。
try:
    data = fetch_record()
    parsed = int(data["val"])
except:
    # 遮盖了所有的 KeyError、ValueError 甚至拼写错误
passimport logging
try:
data = fetch_record()
parsed = int(data["val"])
except (KeyError, ValueError) as err:
logging.warning("数据解析失败: %s", err)
parsed = 0四、初学者代码审查与规范重构四步流程
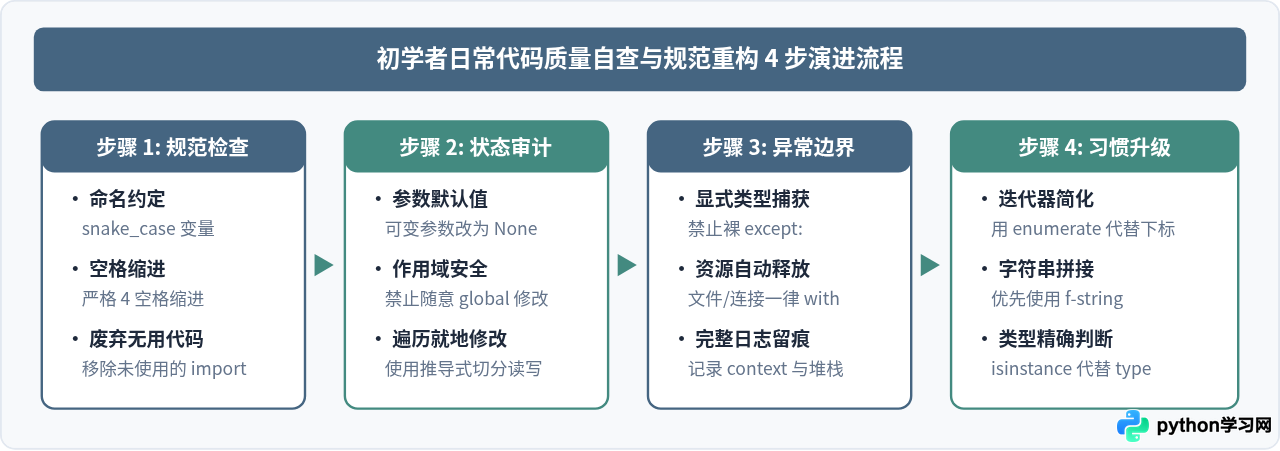
养成严谨的代码编写习惯需要一套系统化的自查思路。从最基础的语法规范检查,到运行时的内存状态、异常边界与现代 Pythonic 惯用写法的迁移,遵循清晰的重构阶段可以迅速提升代码的健壮度。
五、混淆同一性(is)与相等性(==)
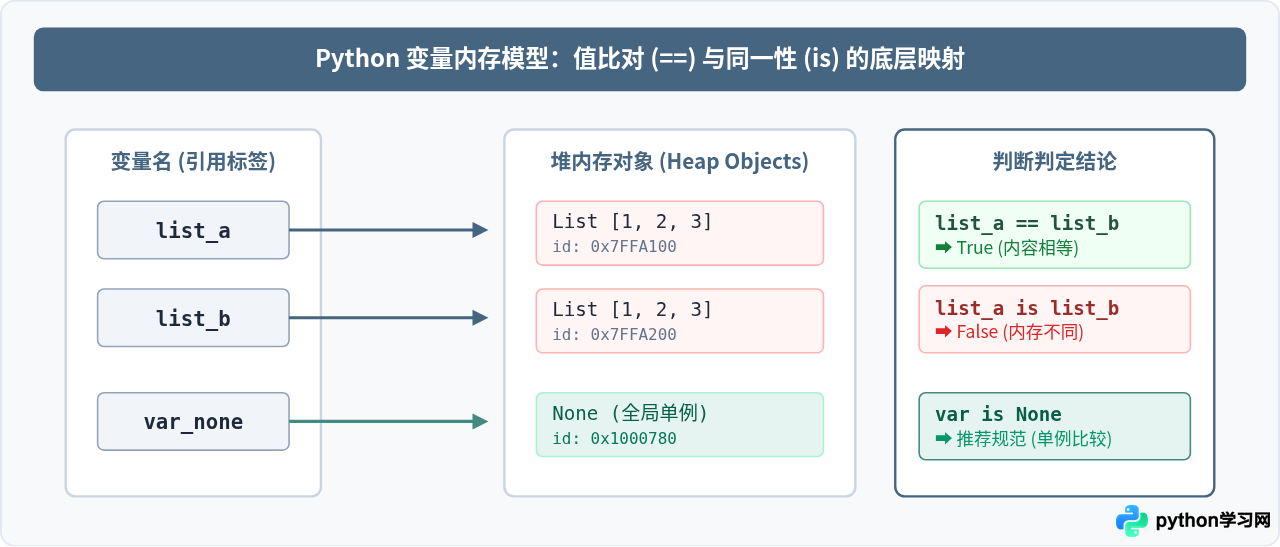
初学者常常混用 is 与 ==。== 比较的是两个对象的值是否相等(调用底层 __eq__ 魔术方法),而 is 比较的是两者的内存地址是否相同(即 id(a) == id(b))。Python 为了性能优化在内部对小整数(-5 到 256)和部分短字符串实施了驻留机制,这容易让初学者产生“两者没有差别”的错觉。
a = 1000
b = 1000
print(a is b)  # 在交互环境可能为 False!

text1 = "hello world!"
text2 = "hello world!"
if text1 is text2:  # 依赖未定义的驻留行为
do_something()# 数值、字符串、容器等内容比对一律使用 ==
if a == b:
process_values()
# None、True、False 等单例对象规范使用 is
if val is None:
init_default()is None 是 Python 官方极其强调的规范;普通数据比对则始终依靠 ==。
六、资源管理中手动关闭与忽视上下文管理器
文件读写、网络套接字或数据库连接需要保证资源无论在正常执行还是异常中断时都能被及时释放。依赖手动 f.close() 极易因为中途抛出异常或逻辑提前 return 而造成文件句柄泄漏。
f = open("data.txt", "r", encoding="utf-8")
content = f.read()
process_data(content)  # 若此处抛出异常,close() 永远无法执行
f.close()close(),并在高并发或长时间运行进程中造成句柄耗尽崩溃。
with open("data.txt", "r", encoding="utf-8") as f:
    content = f.read()
    process_data(content)
# 离开代码块时,内部 __exit__ 必定自动关闭句柄七、其他高频初级编码误区速览
for i in range(len(items)): items[i] 的 C 风格遍历,优先使用 for idx, item in enumerate(items):。2. 类型校验:判断变量类型应使用
isinstance(val, int) 而不是 type(val) == int,前者能够正确支持面向对象中的派生子类继承判断。3. 字典键取值:取可能不存在的字典键时,使用
d.get("key", default) 代替容易触发 KeyError 的直接下标索引。
八、Python 基础阶段规范编码避坑全景
将上述误区归纳整合,形成一张完整的知识体系速查图,有助于初学者在编写每一行代码时建立肌肉记忆。
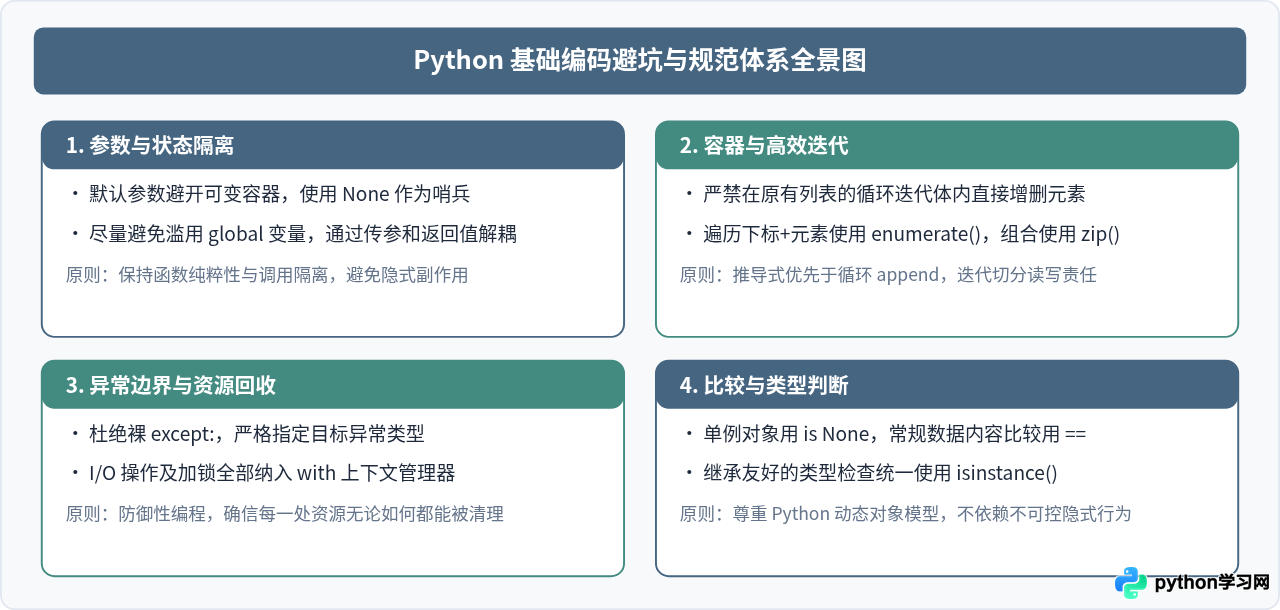
编写高质量 Python 代码的核心不在于记忆晦涩的冷门语法,而在于深刻理解对象模型与作用域的生命周期。从规避可变默认参数、规范异常捕获到合理使用上下文管理器,建立起对机制的敬畏,才能在后续走向大型项目与并发系统开发时从容不迫。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









