

Python与R语言在处理大规模数据时的性能与工程化部署对比
深入对比Python与R语言在面对数十GB至TB级大规模数据时的内存计算性能、流式处理能力、分布式架构与微服务生产部署差异,提供务实的工程选型依据。
在面对单机内存无法轻松容纳的数十吉字节(GB)乃至太字节(TB)级别的大规模数据时,选择 Python 还是 R 语言,本质上是在选择两套迥异的计算架构哲学与工程演进路径。Python 凭借多核向量化计算库(如 Polars、DuckDB)、深度的底层 C/Rust 绑定以及对分布式引擎(如 PySpark、Ray)的原生兼容,构筑了高弹性、微服务化的工程流水线;而 R 语言则通过高度优化的底层单机内存计算引擎(如 data.table)、统一的 Apache Arrow 接口与直接面向统计学家的敏捷设计,在单机高密度分析与紧凑型数据管道中展现出极高的算力转化比。本文将从单机执行模型、流式分块操作、分布式扩展边界以及生产环境微服务化四个维度展开实测机制对比,为大数据场景下的架构选型提供确切依据。
一、单机内存模型与运算核心机制对比
大规模数据处理的首要瓶颈是内存利用率与 CPU 缓存局部性。经典 Python pandas 由于对象类型开销过大、基于 NumPy 的单线程设计以及缺乏深拷贝优化,在数据集接近物理内存 30% 时便极易触发内存溢出(OOM)。现代 Python 方案已经全面转向以 Arrow 内存格式为底层的 Polars 与嵌入式分析引擎 DuckDB,利用 Rust 编写的并发执行计划和零拷贝切片,将单机吞吐推向硬件极限。
R 语言早期基于 base 体系的向量化在应对数十 GB 数据时同样受困于多次垃圾回收(GC)开销与数据复制机制。然而,R 语言社区的 data.table 扩展包利用自研的高性能 C 语言内核与多线程基数排序(Radix Sort),实现了在单机内存中就地修改(In-Place Modification)而不产生冗余副本,并对常见的分组聚合操作实现了直接对齐 CPU 缓存行的内存访问模式。
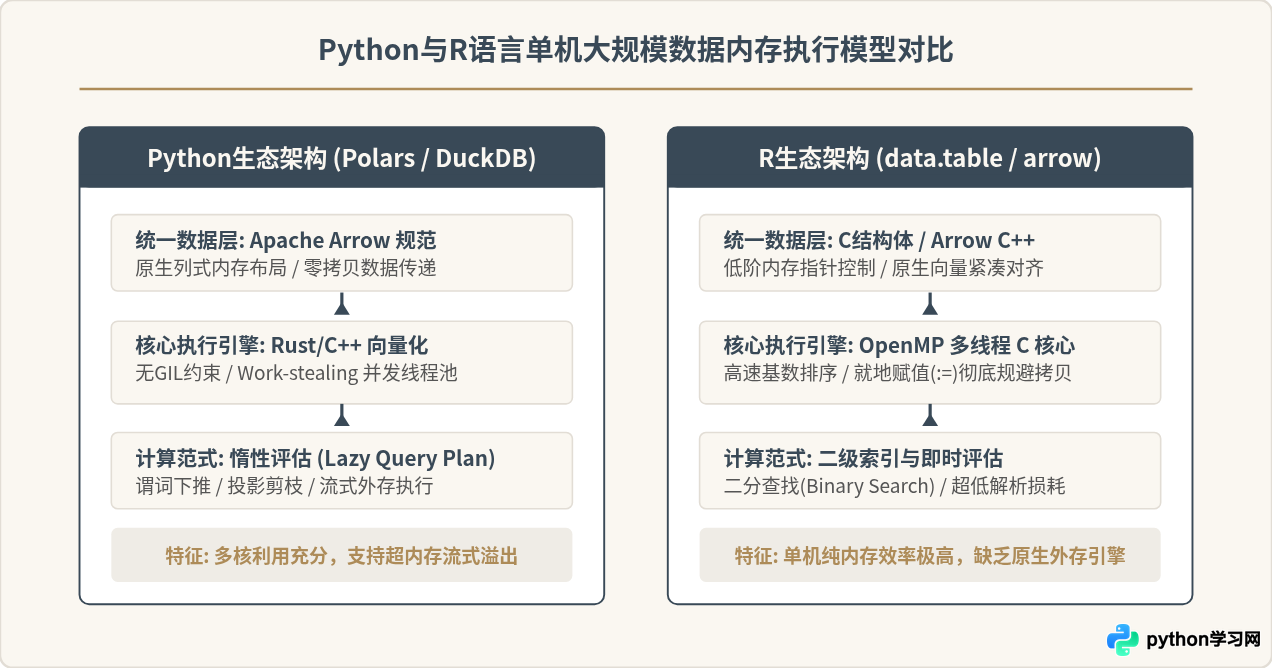
为了直观观察二者在大规模数据聚合场景下的语法设计与执行特征,以下分别给出处理 20GB 级别交易记录(按用户 ID 聚合求和与求均值)的标准工程实现:
# Python 实现: 使用 Polars 惰性流式计算 (支持数据量超出物理RAM)
import polars as pl

# scan_parquet 仅读取元数据构建执行图,并不加载完整数据到内存
query = (
    pl.scan_parquet("/data/transactions/*.parquet")
    .filter(pl.col("status") == "SUCCESS")
    .group_by("user_id")
    .agg([
        pl.col("amount").sum().alias("total_spent"),
        pl.col("amount").mean().alias("avg_spent"),
        pl.len().alias("tx_count")
    ])
    .filter(pl.col("total_spent") > 1000.0)
)

# collect(streaming=True) 触发流式分页执行,将内存峰值控制在恒定区间
result = query.collect(streaming=True)
result.write_parquet("/data/output/user_summary.parquet")
# R 语言实现: 使用 data.table 配合 OpenMP 多线程高速聚合
library(data.table)
setDTthreads(threads = 8) # 明确分配计算线程
# 快速读取并就地转换为 data.table
dt <- fread("/data/transactions/all_records.csv", select = c("user_id", "status", "amount"))
# 基于 C 级键值索引与就地内存更新进行高效聚合计算
summary_dt <- dt[status == "SUCCESS",
.(total_spent = sum(amount),
avg_spent = mean(amount),
tx_count = .N),
by = .(user_id)][total_spent > 1000.0]
fwrite(summary_dt, "/data/output/user_summary.csv")data.table 在纯内存场景下速度极其惊人,但其执行前提是完整数据或当前批次能够装载进物理内存;若原始数据量超出物理 RAM,必须借助 arrow::open_dataset() 或 duckdb 接口做分片缓冲,否则单机进程会直接由于内存分配失败崩溃。而 Python 的 Polars 和 DuckDB 内置了 Out-of-Core(外存流式溢出)机制,能够平滑降级使用硬盘交换空间完成任务。
二、大规模数据流式处理与管道操作步骤
当处理规整至 50GB 以上的日志或传感器原始流时,不能采用一次性读取全量的批处理方式。一个规范的工程流水线必须遵循明确的阶段划分:元数据扫描、投影下推、分块流式加载、向量化计算与输出持久化。下文展示在大规模生产数据中建立流式管道的具体执行步骤。
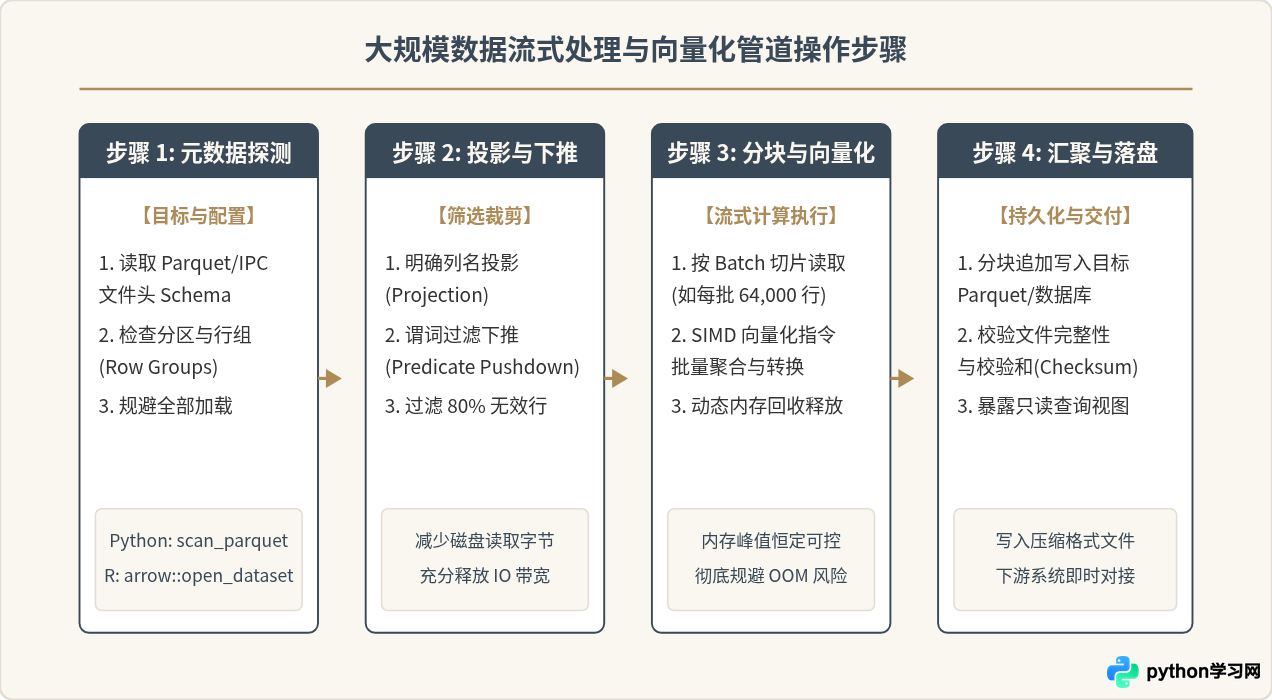
在执行上述步骤时,具体工程选型的技术细节表现为:
- 行过滤下推效率:当底层存储格式为 Snappy 或 ZSTD 压缩的 Parquet 文件时,Python(DuckDB/Polars)与 R(
arrow包)均能直接通过 Parquet 文件尾部的统计数据(Min/Max/Null Count)跳过不匹配的 Row Groups,避免无谓的磁盘读取。 - 分块内存回收:R 语言在处理超大数据循环分块时,需要显式调用
rm(chunk); gc()辅助垃圾回收器归还空闲内存,否则单线程堆内存的碎片化容易导致物理内存占用居高不下;Python 中基于 Rust 或 C++ 引擎(如 Polars C bindings)分配的内存位于 Python 解释器堆外(Off-Heap),生命周期随上下文退出立即自动归还操作系统。
三、分布式集群扩展与计算框架生态
当数据规模跨越数百 GB 达到数 TB 时,无论怎样优化单机内存或采用外存算法,单台物理机的算力与网络带宽均会成为绝对瓶颈。此时,语言在分布式生态中的集成度决定了工程上限。
Python 在分布式计算领域占据统治级地位。其核心优势在于:
- Ray 统一调度框架:Ray 能够无缝将 Python 函数、类和数据对象转化为分布式 Actor 与 Task,在集群节点间通过 Plasma 共享内存实现零拷贝对象传输,是当前大规模分布式特征工程与大模型数据预处理的首选底层。
- 成熟的 PySpark 生态:通过 Arrow 优化的 Vectorized UDF,PySpark 极大降低了 JVM 与 Python 进程间的数据序列化开销,使得海量批处理计算与清洗能够直接融入企业级 Hadoop/S3 数据湖体系。
相比之下,R 语言的分布式生态相对较为局限。虽然存在 sparklyr、SparkR 以及基于套接字通信的 future/parallel 库,但在实际工程落地中常遭遇以下限制:
- 序列化瓶颈:R 语言复杂的闭包与 S4 对象结构在多节点间进行序列化分发时耗时显著,且缺少像 Plasma 这样的全局共享内存总线支持。
- 调试难度与日志追踪:当分布式节点上的 R 进程因内存过载或 C 核心段错误崩溃时,调用栈往往深陷于外部 Java/C++ 封装层,定位分布式 Worker 异常极其繁琐。
四、生产环境微服务化与容器化部署对比
将大规模数据处理模型或数据管道沉淀为生产级 API 服务时,系统对高并发吞吐、低延迟响应、冷启动时间以及可维护性有着严苛要求。Python 与 R 在工程部署架构上的差异最为直观。
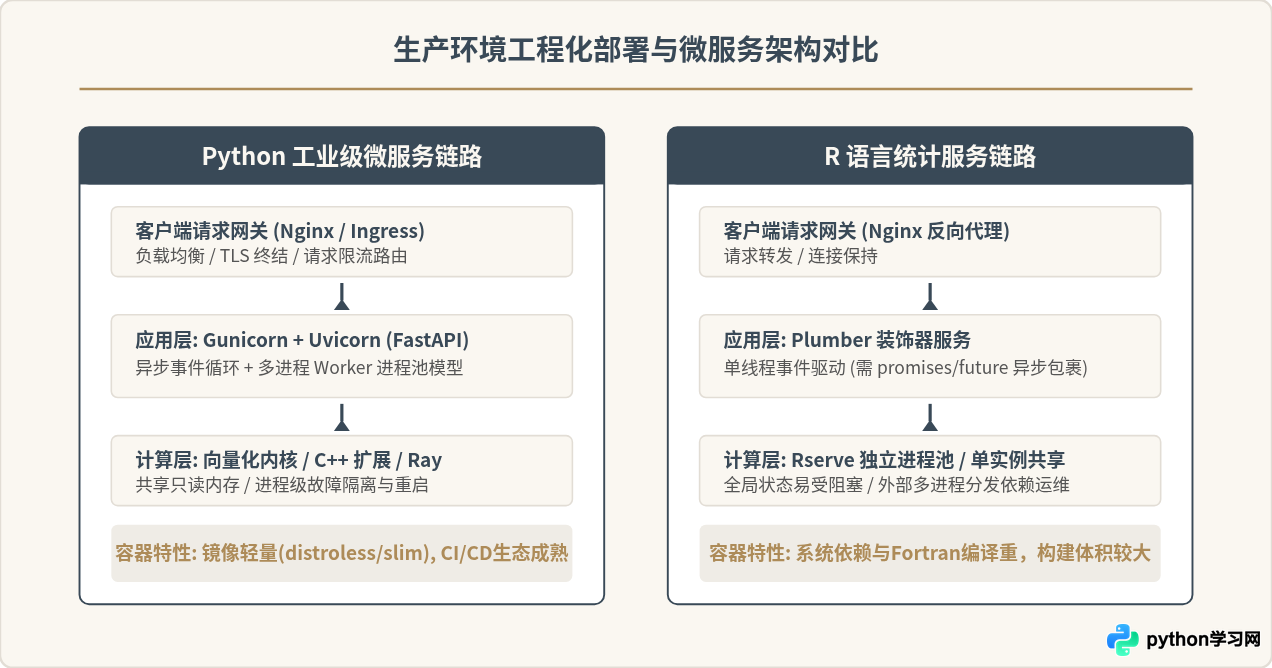
在工程化实践中,两种技术栈的具体指标差异如下:
| 工程考量维度 | Python 典型方案 (FastAPI / Gunicorn) | R 语言典型方案 (Plumber / Rserve) |
|---|---|---|
| 并发模型 | ASGI 异步非阻塞 + 多进程 Prefork 进程池,轻松支撑万级连接 | 默认单线程阻塞,长耗时统计需显式配合 promises 与后台集群 |
| Docker 镜像构建 | 轻量基础镜像(如 python:3.11-slim 约 150MB),预编译二进制轮子丰富 | 基础镜像含编译工具链通常超过 800MB,CRAN 源码包编译耗时较长 |
| 微服务可观测性 | 原生支持 OpenTelemetry、Prometheus 导出器与结构化 JSON 日志 | 生态插件较少,指标采集通常需要编写自定义日志钩子或反向代理打点 |
| 冷启动与伸缩性 | Pod 秒级水平扩缩容(HPA),内存控制精细 | 包加载及环境恢复相对缓慢,弹性伸缩响应时间较长 |
五、工程架构选型决策矩阵与总结
面对具体的大数据业务工程,技术选型不应当停留在语言喜好的争论上,而应严格以数据物理规模、数据流转形态、基础设施约束以及团队协作链路为基准进行科学决策。
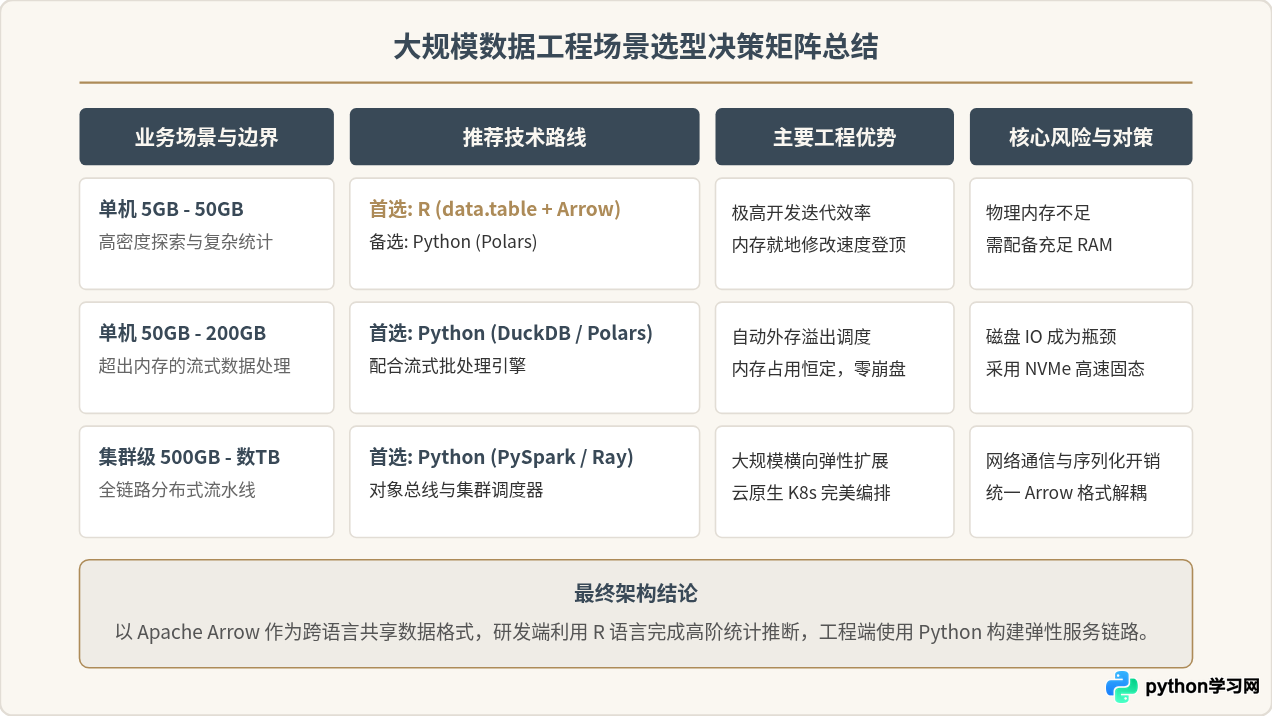
综上所述,Python 与 R 在现代大规模数据体系中不再是非此即彼的对立关系:
- 在工程全生命周期中,如果系统目标是接入生产集群、支撑高并发微服务调用、参与端到端自动化 CI/CD,Python 展现出无可替代的工程完备性。
- 在核心统计与探索分析阶段,只要数据能在物理 RAM 内分片容纳,R 语言的
data.table依然能够凭借极致的单机运行效率和精简的代码语义为团队赢得宝贵的研发时间。 - 最佳的现代工程实践,正越来越多地依赖底层统一的 Apache Arrow IPC / Feather / Parquet 格式:由研发团队使用 R 完成数据深度剖析与模型原型设计,再通过统一的 Parquet 或 Arrow 内存映射传递给 Python FastAPI / Ray 基础设施实现自动化编排与生产部署。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









