

Python判断字符串是否包含子串:in运算符与find方法详解
详细解析Python中判断字符串是否包含子串的两种主流方式:in运算符与find()方法。从工作原理、返回值差异、执行效率到高频避坑指南,帮助开发者做出正确且规范的技术选型。
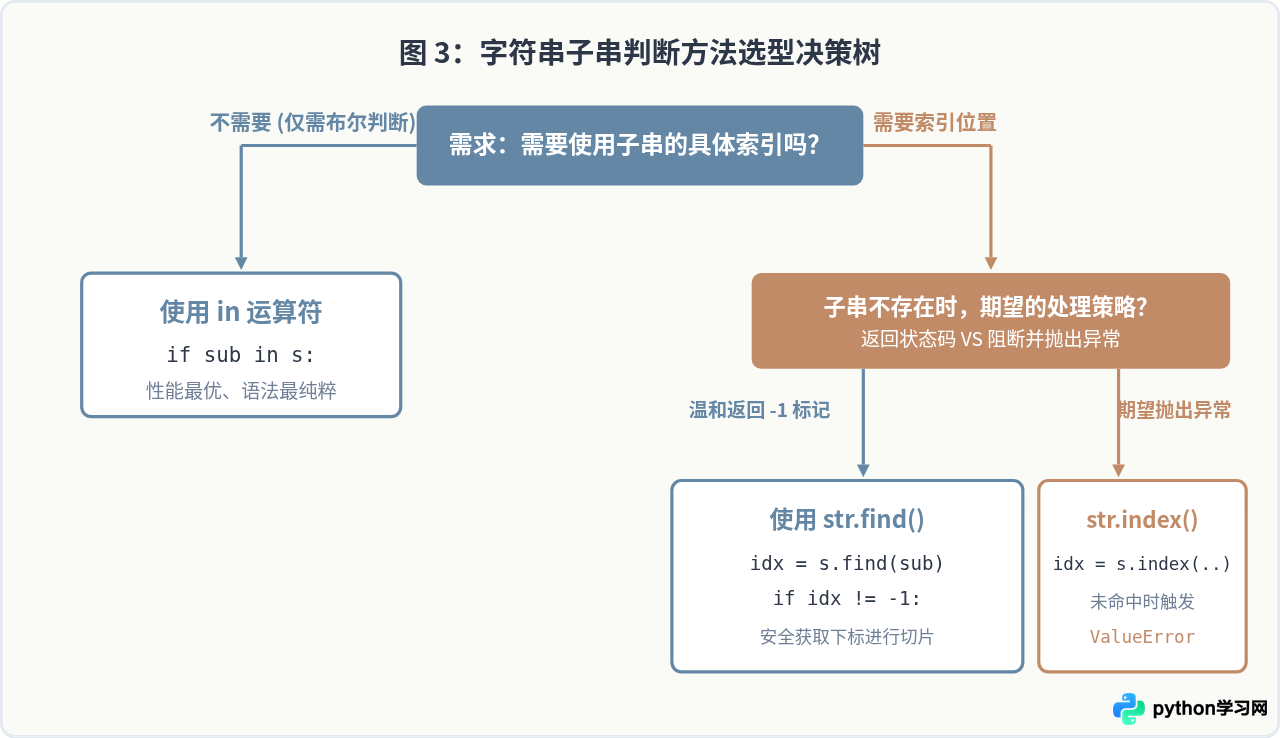
在 Python 中判断一个字符串是否包含某个子串,最直接且推荐的做法是使用成员运算符 in;如果除了判断存在性之外,还需要获取子串在目标字符串中的起始索引位置,则应使用字符串内置的 str.find() 方法。本文将从语义设计、返回值差异、运行原理与常见陷阱四个维度深入剖析这两种方式,帮助读者在不同开发场景下做出清晰、规范的选择。
一、核心结论与选型依据
面对“判断子串是否存在”的需求,Python 社区有非常统一的最佳实践准则:
- 纯粹判断存在性(True/False):一律使用
in(或not in)运算符。代码意图最直观,执行性能最高。 - 需要获取子串出现的位置索引:使用
str.find()方法,并严格判断返回值是否!= -1。 - 必须避免的逻辑反模式:不要为了布尔判断而写出
if s.find(sub) != -1:,更不能简写为if s.find(sub):,后者在子串位于首位时会导致严重的逻辑 Bug。
二、in 与 not in 运算符:最直接的布尔判定
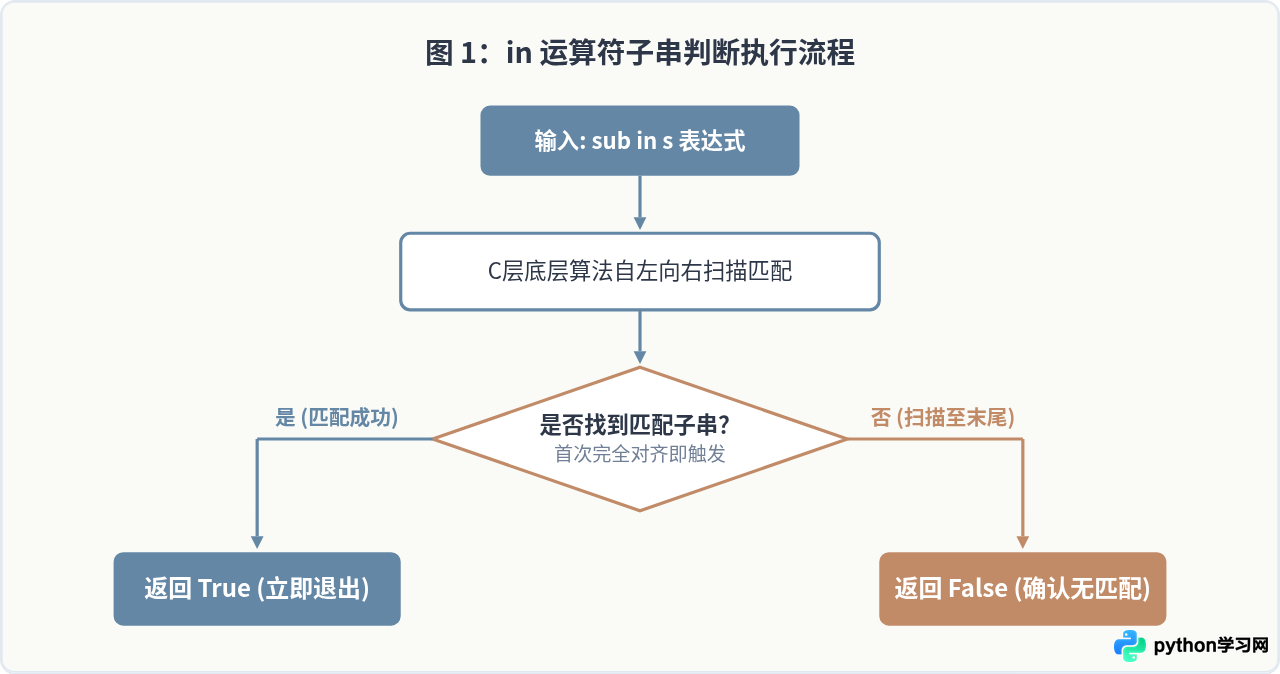
in 是 Python 语言层面的成员运算符,专门用于检测某个元素是否属于一个序列。当操作对象为字符串时,sub in s 会自左向右扫描目标字符串 s,一旦匹配到子串 sub 即返回 True,若扫描完毕仍未找到则返回 False。
1. 基本使用示例
# 基础判断示例
text = "Python 数据分析与 Web 全栈开发"

# 判断子串是否存在
if "Python" in text:
    print("匹配成功:找到了 Python")
else:
    print("匹配失败:未找到目标子串")

# 判断子串是否不存在
if "Java" not in text:
    print("验证通过:文本中不包含 Java")
示例输出:
匹配成功:找到了 Python
验证通过:文本中不包含 Java
2. in 运算符的执行机制与优势
在底层实现中,Python 的字符串匹配采用了高度优化的混合搜索算法(基于 Boyer-Moore 与 Horspool 思想的快速匹配算法)。当使用 in 运算符时,解释器直接在 C 语言层完成内存扫描,具有以下明显优势:
- 语义自然:代码形如英语自然语句,可读性极佳,符合“Pythonic”风格。
- 开销极小:返回值直接是布尔值,省去了计算位置索引并打包返回额外数值的流程。
- 短路终止:一旦找到第一个完整匹配的字符序列,搜索立即停止,避免无谓的后续计算。
三、str.find() 方法:需要下标位置时的标准方案
str.find() 是 Python 字符串对象的内置方法。其核心使命是定位:查找子串在目标字符串中第一次出现的起始下标索引。
1. 方法签名与参数说明
该方法的完整调用格式如下:
str.find(sub[, start[, end]])sub:必选参数,指定要查找的目标子串。start:可选参数,检索的起始切片下标,默认为0。end:可选参数,检索的结束切片下标,默认为字符串长度(不包含end处的字符)。
2. 返回值定义与示例
str.find() 的返回值规则如下:
- 如果找到子串,返回该子串首次出现位置的非负整数索引(范围为
0到len(s) - 1)。 - 如果未找到子串,统一返回
-1,不会引发异常。
content = "FastAPI and Flask are web frameworks"

# 查找处于中间的子串
idx_flask = content.find("Flask")
print(f"Flask 的起始位置: {idx_flask}")

# 查找处于起始位置的子串
idx_fastapi = content.find("FastAPI")
print(f"FastAPI 的起始位置: {idx_fastapi}")

# 查找不存在的子串
idx_django = content.find("Django")
print(f"Django 的起始位置: {idx_django}")
示例输出:
Flask 的起始位置: 12
FastAPI 的起始位置: 0
Django 的起始位置: -1
3. 核心避坑:为什么严禁写 if str.find(sub):
Python 中的整数
0 在布尔上下文中被视为 False,而所有非零整数(包括负数 -1)均被视为 True。如果错误地直接把 find() 的返回值作为条件表达式,会引发毁灭性的逻辑颠倒:
- 当子串位于字符串最开头时(下标为
0),bool(0)为False,程序误判为“未找到”! - 当子串完全不存在时(返回
-1),bool(-1)为True,程序反而误判为“找到了”!
# 错误示范:严禁这样写!
title = "Python指南"
if title.find("Python"): # 此时返回 0,bool(0) 为 False!
    print("找到了 Python")
else:
    print("未找到 Python(严重逻辑错误触发)")

# 正确写法:必须显式与 -1 进行对比
if title.find("Python") != -1:
    print("正确识别:找到了 Python")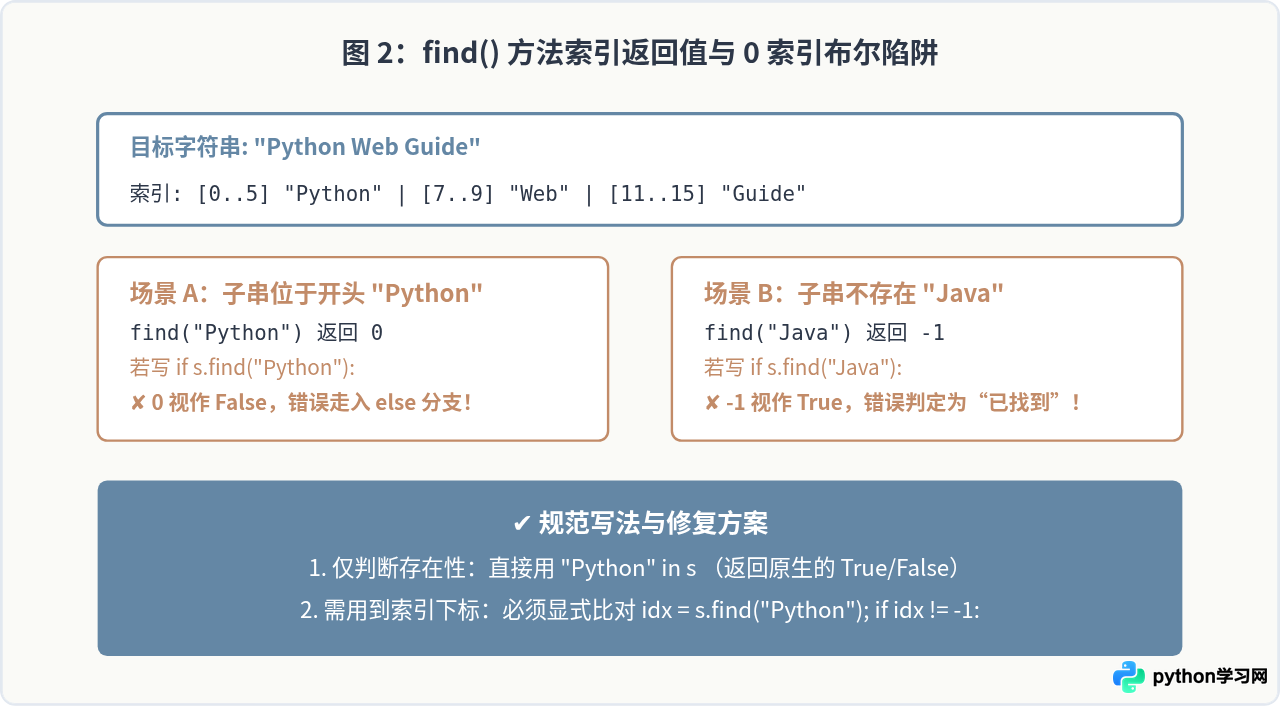
四、全面对比与技术选型(in、find 与 index)
在实际编码中,除 in 和 find() 外,Python 还提供了行为高度相似的 str.index() 方法。三者的差异主要集中在返回值形式和对未命中情况的处理上:
| 比对维度 | in 运算符 | str.find() 方法 | str.index() 方法 |
|---|---|---|---|
| 核心目的 | 检测子串是否存在 | 获取子串首次出现的下标位置 | 获取子串下标(严格模式) |
| 匹配成功返回值 | True |
起始非负整数索引(>= 0) |
起始非负整数索引(>= 0) |
| 匹配失败处理 | 返回 False |
返回 -1 |
抛出 ValueError 异常 |
| 调用形式 | sub in s |
s.find(sub) |
s.index(sub) |
| 适用场景 | 绝大多数常规存在性分支判定 | 需要索引且子串可能不存在的场景 | 确信子串存在,或配合 try/except 处理异常 |
五、进阶场景与工程实战细节
1. 忽略大小写的子串判断
无论是 in 还是 find(),默认都是严格区分大小写的。如果业务场景需要进行大小写无关的判定,标准解法是调用 casefold() 或 lower() 对字符串与子串同时进行标准化预处理:
raw_text = "Welcome to PYTHON Community"
search_term = "python"

# 推荐使用 str.casefold() 处理多语言全小写化
if search_term.casefold() in raw_text.casefold():
print("匹配成功:忽略大小写后存在该子串")提示:casefold() 相比 lower() 更加激进和彻底,对德语小写字母“ß”等特殊 Unicode 字符转换更准确,是现代化 Python 程序中大小写无关判定的推荐首选。
2. 同时判断多个子串:配合 any() 与 all()
在敏感词过滤或多关键词匹配时,往往需要检测“是否包含其中任意一个”或“是否同时包含全部关键词”。利用生成器表达式与 in 运算符组合,代码既紧凑又具备短路特性:
log_message = "ERROR: Failed to connect to database host at 192.168.1.10"
keywords = ["CRITICAL", "ERROR", "FATAL"]

# 判断是否包含列表中的任意一个关键词(短路求值,遇到第一个命中即返回)
has_any_error = any(keyword in log_message for keyword in keywords)
print(f"包含严重错误标签: {has_any_error}")

# 判断是否同时满足所有关键词
required_terms = ["connect", "database"]
has_all_terms = all(term in log_message for term in required_terms)
print(f"包含所有必填要素: {has_all_terms}")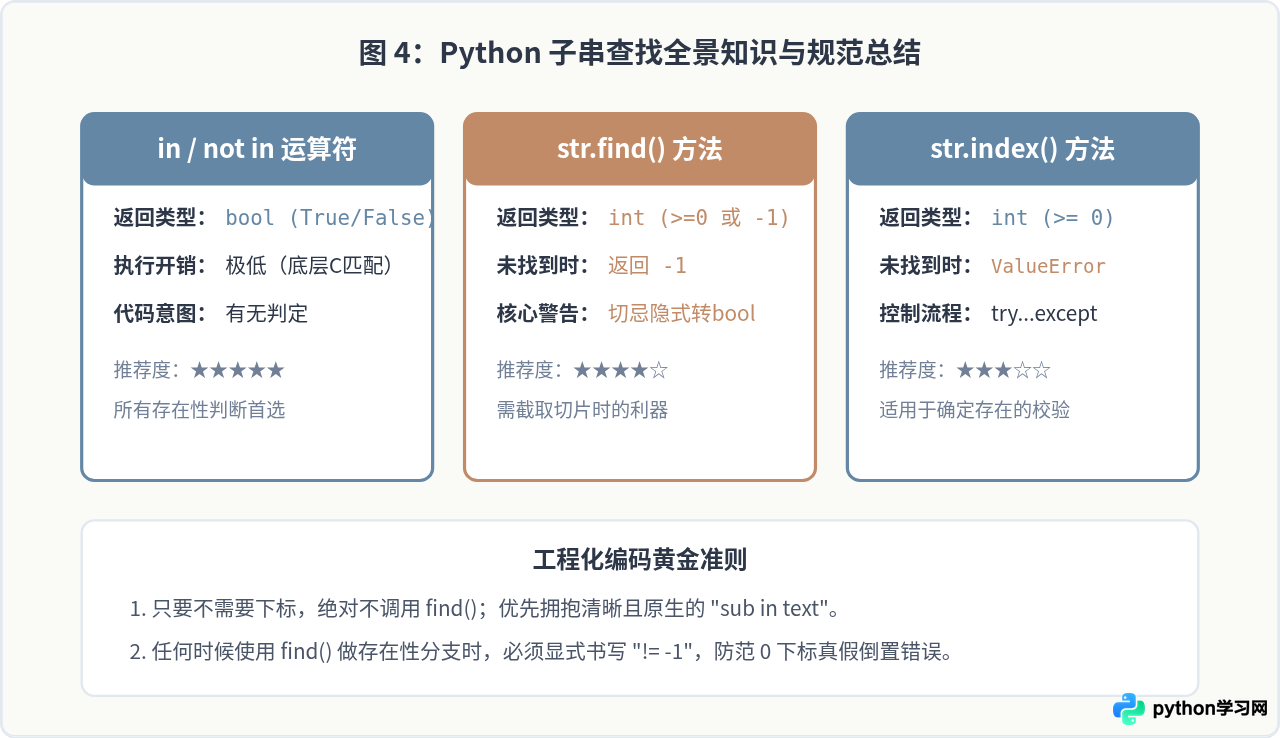
六、总结回顾
在 Python 字符串处理中,in 运算符与 find() 方法有着明确的分工:
in 运算符用于询问“在不在”,返回值是地道的布尔值(True/False),代码直观、优雅且运行高效;而 find() 方法用于询问“在哪里”,返回子串首次出现的起始整数索引,当子串不存在时以 -1 标识。在实际开发中,务必恪守职责分离原则,不在布尔判定场景滥用 find(),杜绝直接将 find() 结果放入 if 条件中隐式求值的潜在 Bug,从而保障代码的健壮性与可读性。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









