

python必背源代码列表增删改查基础操作代码
深入解析Python列表(list)的核心增删改查(CRUD)基础操作源代码。涵盖索引切片查找、append/extend/insert追加插入、原地更新重排、pop/remove/del安全删除,结合底层内存指针结构与时间复杂度图示,提供完整可运行代码与避坑指南。
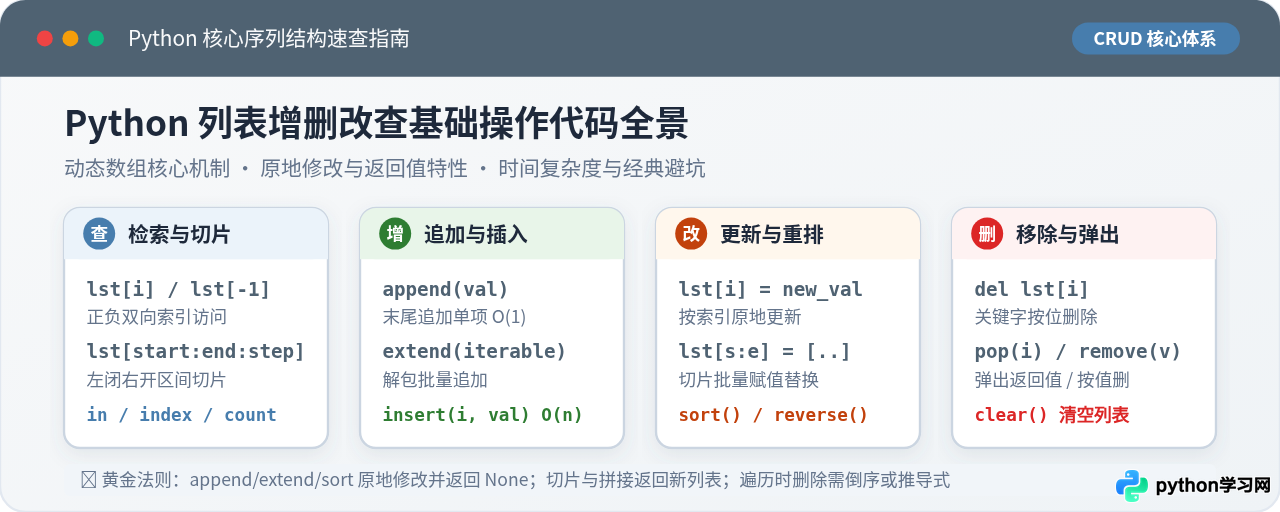
1 查(Retrieve / Access):精准索引与切片提取
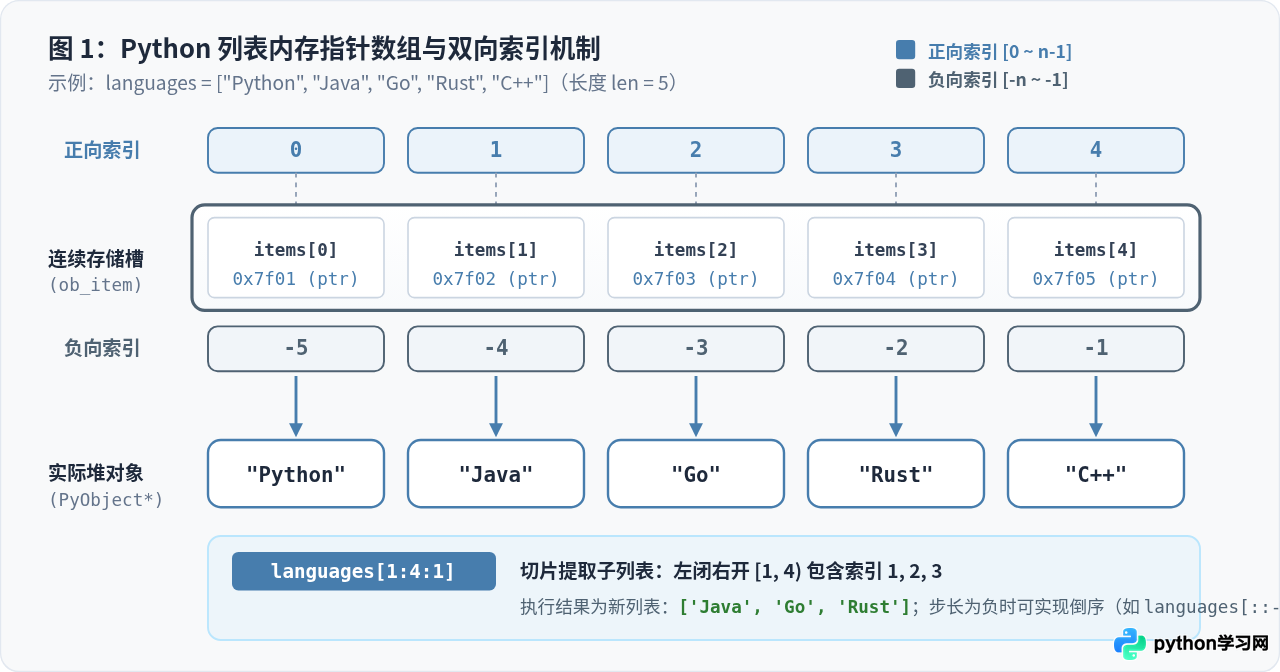
“查”是使用列表的第一步。Python 列表支持正向与负向双向索引访问,并在底层通过连续指针数组(ob_item)实现。由于内存地址连续,通过索引访问任意元素的时间复杂度恒为 O(1)。
1.1 索引访问与越界控制
正向索引从 0 开始(从左向右递增至 len-1);负向索引从 -1 开始(代表末尾最后一个元素,向左递减至 -len)。如果访问超出有效索引范围,Python 将主动抛出 IndexError 异常。
# 1. 基础双向索引访问
languages = ["Python", "Java", "Go", "Rust", "C++"]

first_item = languages[0]      # 示例输出: 'Python' (首元素)
last_item = languages[-1]      # 示例输出: 'C++' (末尾元素)
second_last = languages[-2]    # 示例输出: 'Rust' (倒数第二项)

# 2. 安全防范越界检查
target_idx = 5
if 0 <= target_idx < len(languages):
    val = languages[target_idx]
else:
    val = None  # 避免触发 IndexError: list index out of range
1.2 切片提取(Slicing)
切片语法为 list[start:end:step],其核心特征为“左闭右开”(包含 start 索引,不包含 end 索引)。切片操作不会修改原列表,而是以浅拷贝的形式构造并返回一个全新的列表。与索引单项访问不同,切片中的索引超出范围时不会报错,而是自动截断到边界。
nums = [10, 20, 30, 40, 50, 60, 70]

# [start:end] 提取子区间(左闭右开)
sub_1 = nums[1:4]      # 示例输出: [20, 30, 40]

# 省略 start(从头开始)或省略 end(截取至末尾)
head_3 = nums[:3]      # 示例输出: [10, 20, 30]
tail_3 = nums[-3:]     # 示例输出: [50, 60, 70]

# step 步长提取
evens = nums[::2]      # 示例输出: [10, 30, 50, 70] (隔一个取一个)
reverse_list = nums[::-1] # 示例输出: [70, 60, 50, 40, 30, 20, 10] (全列表逆序拷贝)
1.3 存在性判定与统计
使用 in 关键字可直接判断某元素是否存在于列表中;使用 .index(value) 查找某元素首次出现的索引位置;使用 .count(value) 统计元素出现的总次数。这三个操作均依赖底层线性扫描,时间复杂度为 O(n)。
fruits = ["apple", "banana", "orange", "apple", "peach"]

# 成员资格判断 (返回 True / False)
has_apple = "apple" in fruits   # 示例输出: True

# 获取首个匹配项索引(防范 ValueError)
if "orange" in fruits:
    pos = fruits.index("orange") # 示例输出: 2

# 统计频次
apple_count = fruits.count("apple") # 示例输出: 2
2 增(Create / Insert):单项追加与位置插入
向列表中新增元素主要依赖 .append()、.extend() 与 .insert() 三种方法。这三种方法全部为原地修改(in-place),其函数返回值均为 None。初学者常犯将 res = lst.append(x) 赋值给新变量的错误,导致 res 成为 None。
2.1 单项追加与解包扩展的区别
list.append(x):将元素x作为一个完整独立的对象追加到列表末尾。平均时间复杂度为O(1)。list.extend(iterable):迭代传入的序列(如另一个列表、元组、字符串),将其中的每个元素逐一追加到末尾。等价于+=操作。时间复杂度为O(k)(k为待追加序列长度)。
# 1. append 追加单一元素
nums = [1, 2, 3]
nums.append(4)
print(nums)  # 示例输出: [1, 2, 3, 4]

# 注意:若 append 传入一个子列表,它会作为嵌套子项存入
nums.append([5, 6])
print(nums)  # 示例输出: [1, 2, 3, 4, [5, 6]]

# 2. extend 解包追加
colors = ["red", "green"]
colors.extend(["blue", "yellow"])
print(colors)  # 示例输出: ['red', 'green', 'blue', 'yellow']

# 3. += 运算符(内部调用 extend 原地扩展)
colors += ["purple"]
print(colors)  # 示例输出: ['red', 'green', 'blue', 'yellow', 'purple']
2.2 指定位置插入:insert()
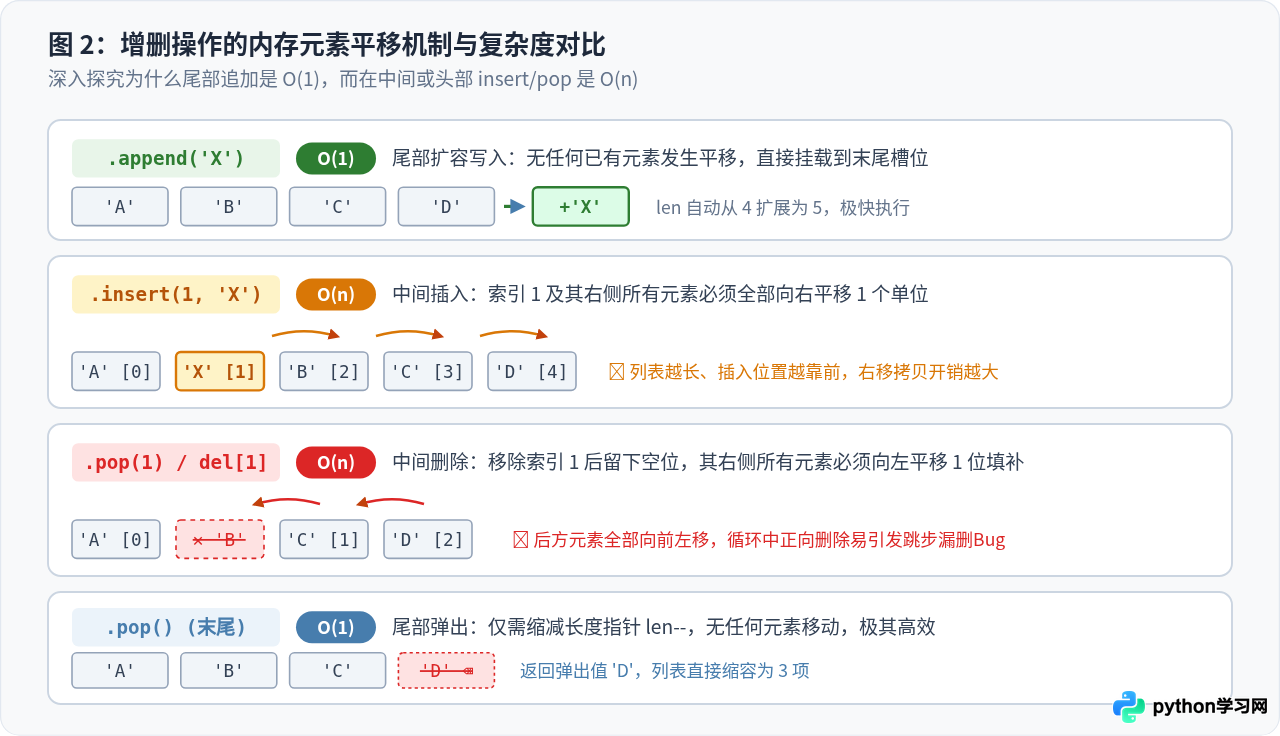
语法为 list.insert(index, element)。它将元素插入到指定索引 index 的位置上。根据图 2 所示的内存模型,插入点之后的所有元素都必须向右移动一个槽位以腾出空间。因此,insert(0, x)(头部插入)的时间复杂度为 O(n),在大型列表或高频头部写入场景下应优先选用 collections.deque。
letters = ["A", "C", "D"]

# 在索引 1 处插入 "B"
letters.insert(1, "B")
print(letters)  # 示例输出: ['A', 'B', 'C', 'D']

# 越界索引自动转化为末尾追加或头部插入
letters.insert(100, "Z")  # 超过当前长度,自动落在末尾
letters.insert(-100, "FIRST") # 负向严重越界,自动插入到最开头
3 改(Update / Modify):单项重置与原地重排
修改操作涵盖按索引单项覆盖、通过切片批量替换,以及对列表内部元素顺序的原地重排(排序与翻转)。
3.1 单项赋值与切片批量替换
通过 list[i] = new_value 可直接在常数时间 O(1) 内覆盖对应位置的元素。若使用切片赋值 list[start:end] = iterable,不仅可以替换区间内的值,还能改变列表长度(替换区间的长度与赋值序列长度无需相等)。
scores = [85, 92, 78, 60, 99]

# 1. 单项索引替换
scores[3] = 68  # 将索引 3 处的 60 修改为 68
print(scores)   # 示例输出: [85, 92, 78, 68, 99]

# 2. 切片区间替换(替换 [1:3] 即 92 和 78)
scores[1:3] = [95, 88, 82]  # 用 3 个新数替换原有的 2 个数
print(scores)   # 示例输出: [85, 95, 88, 82, 68, 99]
3.2 原地排序与反转
列表自带的 .sort() 和 .reverse() 方法均为原地修改,同样返回 None。如果希望保留原列表并生成一个排序后的新列表,必须使用内置函数 sorted(list)。
data = [42, 12, 88, 5, 23]

# 1. 原地升序排序
data.sort()
print(data)  # 示例输出: [5, 12, 23, 42, 88]

# 2. 原地降序排序与自定义 key
data.sort(reverse=True)
print(data)  # 示例输出: [88, 42, 23, 12, 5]

# 3. 原地前后逆序倒转
data.reverse()
print(data)  # 示例输出: [5, 12, 23, 42, 88]

# 4. 对比:内置 sorted() 返回新对象
original = [3, 1, 2]
sorted_copy = sorted(original)
print(original)     # 示例输出: [3, 1, 2] (原对象保持不变)
print(sorted_copy)  # 示例输出: [1, 2, 3] (新对象)
4 删(Delete / Remove):四种清除途径与避坑指南
Python 提供了四种删除列表元素的原语,分别应对“按索引删除并返回”、“按索引/切片物理删除”、“按值匹配删除”以及“清空全表”四种需求场景。
4.1 四大删除方法功能对比
list.pop([index]):按索引移除元素,并返回被移除的元素值。默认弹出末尾项(index=-1,时间O(1));若弹出中间项,时间为O(n)。del list[index]或del list[start:end]:Python 语言级关键字,按索引或切片原地销毁元素,无返回值。list.remove(value):从左至右查找并删除第一个与value相等的项。若值不存在,直接触发ValueError,不返回任何值。list.clear():清空列表中的所有元素,将其变成空列表[],原对象引用地址不变。
items = ["apple", "banana", "cherry", "date", "banana"]

# 1. pop() 按索引弹出并获取值
last_val = items.pop()       # 弹出末尾 'banana',items 剩下 4 项
second_val = items.pop(1)    # 弹出索引 1 的 'banana'
print(f"弹出了: {last_val}, {second_val}")
print(items)  # 示例输出: ['apple', 'cherry', 'date']

# 2. remove() 按值删除首个匹配项
items.remove("cherry")  # 移除 'cherry'
print(items)  # 示例输出: ['apple', 'date']

# 3. del 按索引或切片删除
del items[0]  # 删除索引 0 的 'apple'
print(items)  # 示例输出: ['date']

# 4. clear() 全量清空
items.clear()
print(items)  # 示例输出: [] (变为空列表)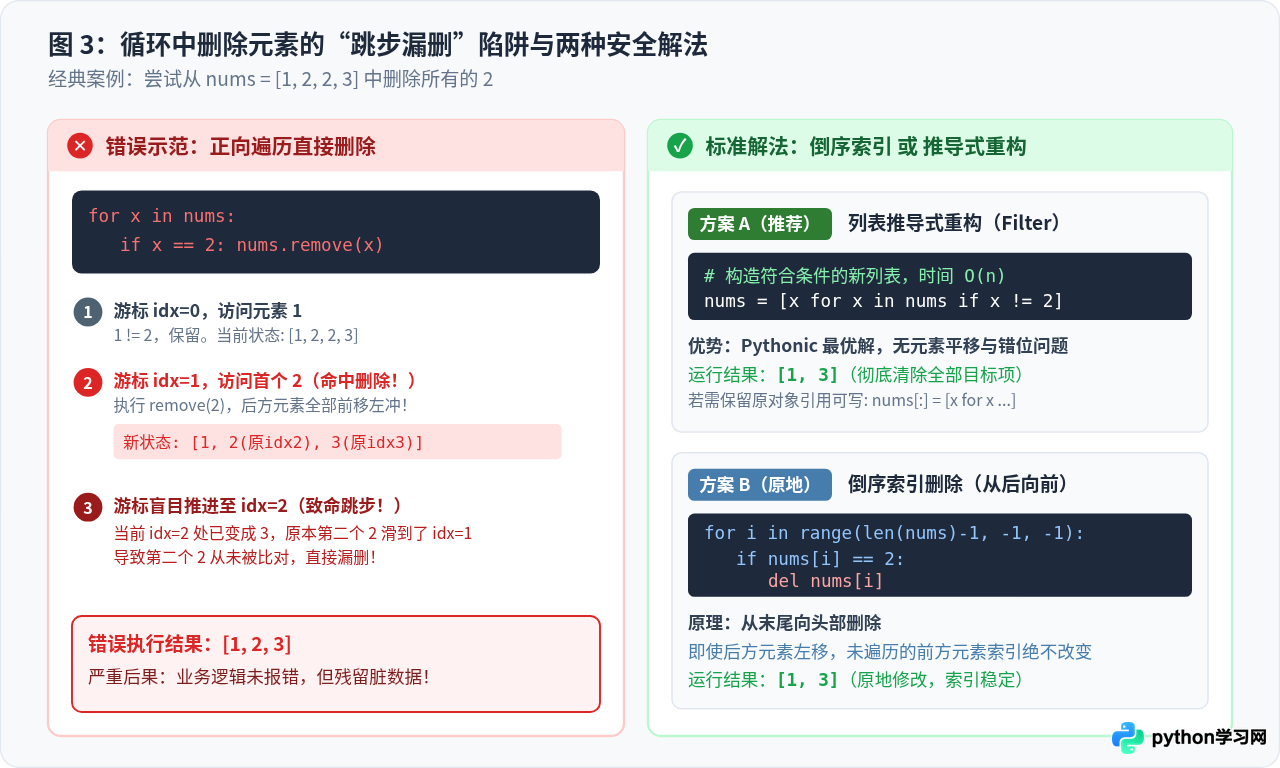
绝不要在正向
for item in list: 循环中使用 list.remove() 或 del!如图 3 所示,正向删除会导致后续元素立刻向左平移,而 Python 的内部迭代指针依然机械地递增 1,从而直接跳过被平移上来的相邻元素。安全做法是使用列表推导式重构,或采用倒序索引遍历。
# 目标:从列表中清除所有偶数
numbers = [1, 2, 2, 4, 5, 6, 7]

# 【安全方案 1:推导式过滤】(最推荐,代码简洁,效率高)
filtered_nums = [x for x in numbers if x % 2 != 0]
print(filtered_nums)  # 示例输出: [1, 5, 7]

# 若需要保持原列表对象引用(原地生效):
numbers[:] = [x for x in numbers if x % 2 != 0]

# 【安全方案 2:倒序索引遍历】(必须原地删除时的经典方案)
raw_data = [1, 2, 2, 4, 5, 6, 7]
for i in range(len(raw_data) - 1, -1, -1):
    if raw_data[i] % 2 == 0:
        del raw_data[i]  # 倒序删除,左移仅发生在已访问区域之后,前方未遍历索引不受影响
print(raw_data)  # 示例输出: [1, 5, 7]
5 核心特性总结与必背代码速查
为了在日常编码与技术面试中能够秒级选出最合理的列表 API,以下矩阵总结了所有增删改查操作的核心差异、返回值机制、时间复杂度及易踩雷区:
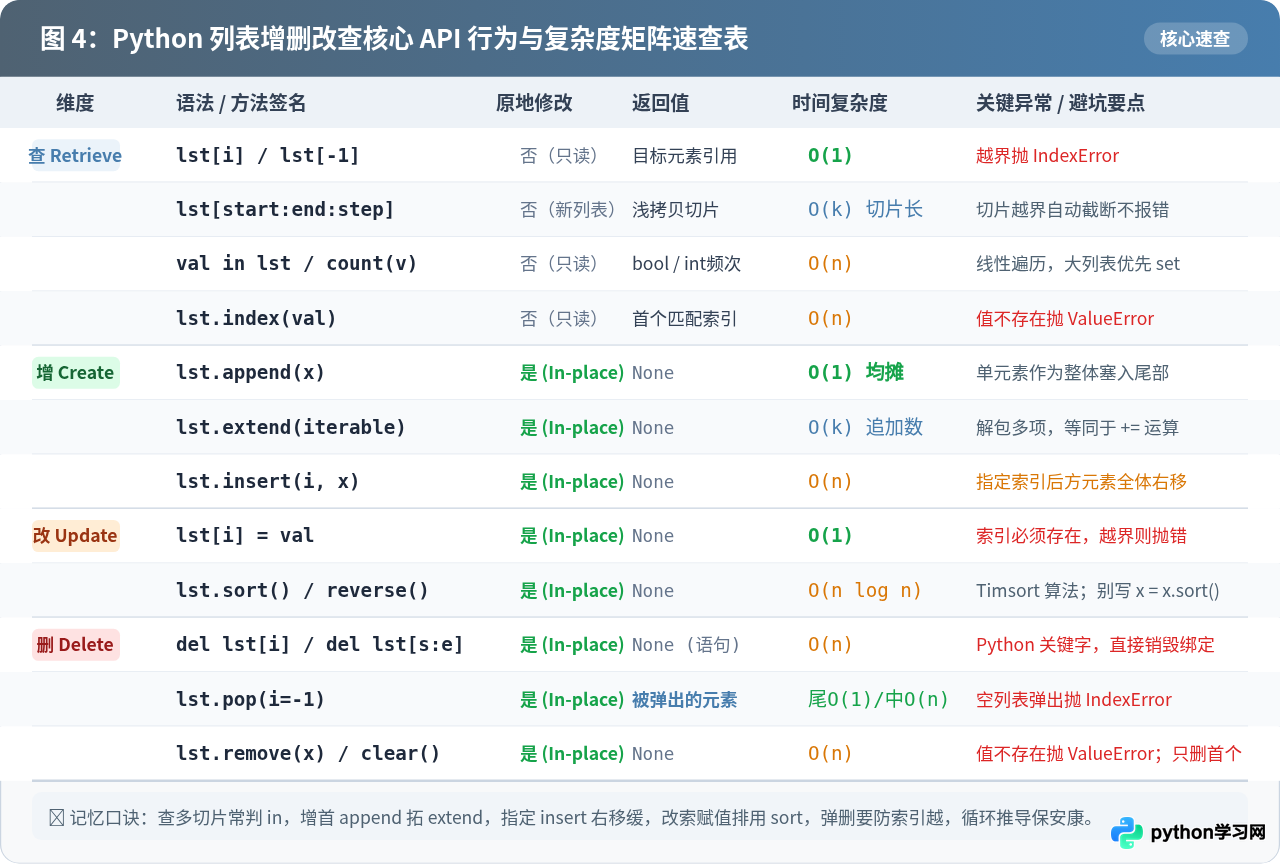
- 区分“原地修改”与“生成新列表”:
append、extend、insert、sort、reverse全部原地修改并返回None,千万不要写出lst = lst.append(...);切片lst[:]与拼接+则会生成新列表。 - 注意浅拷贝陷阱:
sub = lst[:]或lst.copy()仅复制第一层对象引用。如果列表中包含可变嵌套对象(如子列表或字典),修改子对象依旧会连锁影响原列表。深拷贝须使用copy.deepcopy()。 - 性能敏感场景合理选型:列表尾部操作(
append/pop())均为O(1),但头部操作(insert(0, x)/pop(0))需要搬移整个连续内存段,时间复杂度为O(n)。若有高频双端出入队需求,请使用collections.deque。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









