

Cursor Pro的隐私模式怎么使用?代码数据安全指南
详细讲解Cursor Pro隐私模式(Privacy Mode)的配置开启步骤、底层零数据留存(ZDR)原理、.cursorignore敏感代码过滤与企业安全纵深防护实践,全方位保护商业代码不被落盘与模型训练。
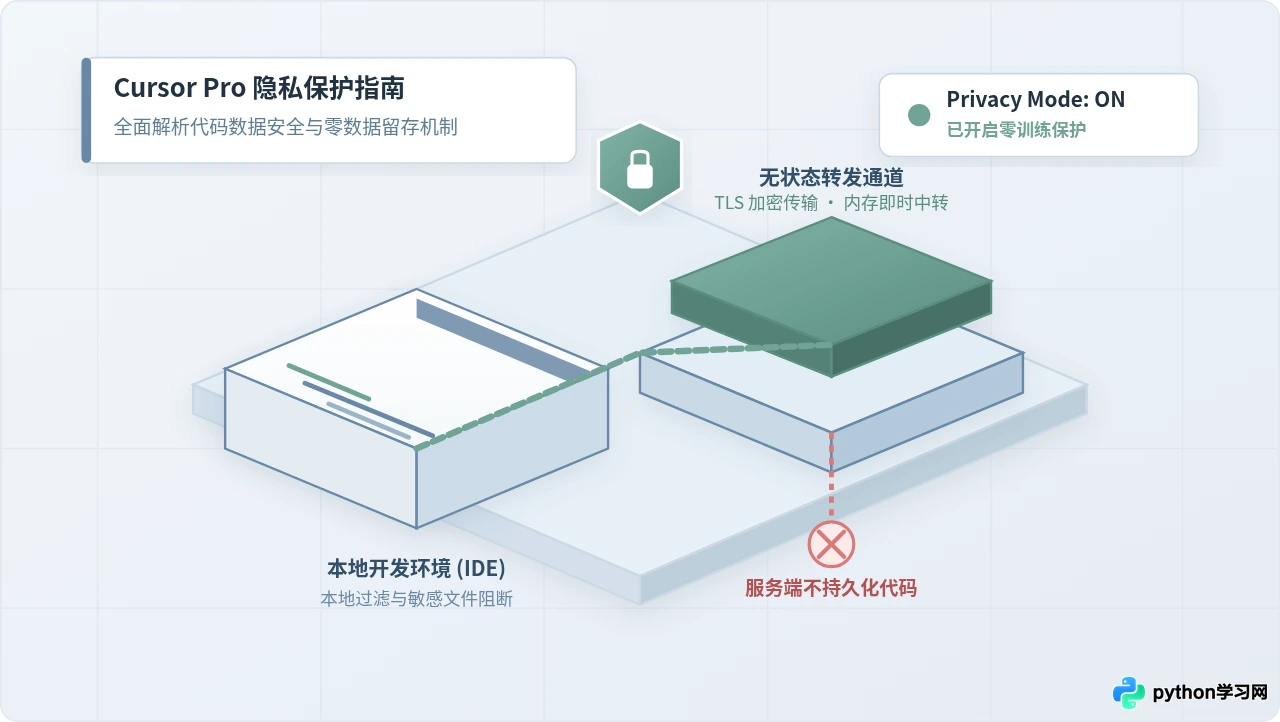
开启 Cursor Pro 隐私模式只需进入 Cursor Settings -> General -> Privacy Mode 并将选项切换至 Enabled 即可。开启后,Cursor 官方及底层大模型供应商均承诺不会在服务端持久化存储读者的代码与提问,也绝不会将其用于模型训练。本文将从具体操作步骤、数据传输原理、本地敏感文件隔离(.cursorignore)以及企业级合规方案四个方面,系统梳理如何在享受 AI 辅助编码的同时保障商业源码资产安全。
一、开启 Cursor Pro 隐私模式的具体操作步骤
Cursor 将隐私控制项内嵌在客户端核心设置中,用户在开通 Cursor Pro 后,配置会与当前账户自动绑定并实时生效,无需重启编辑器。
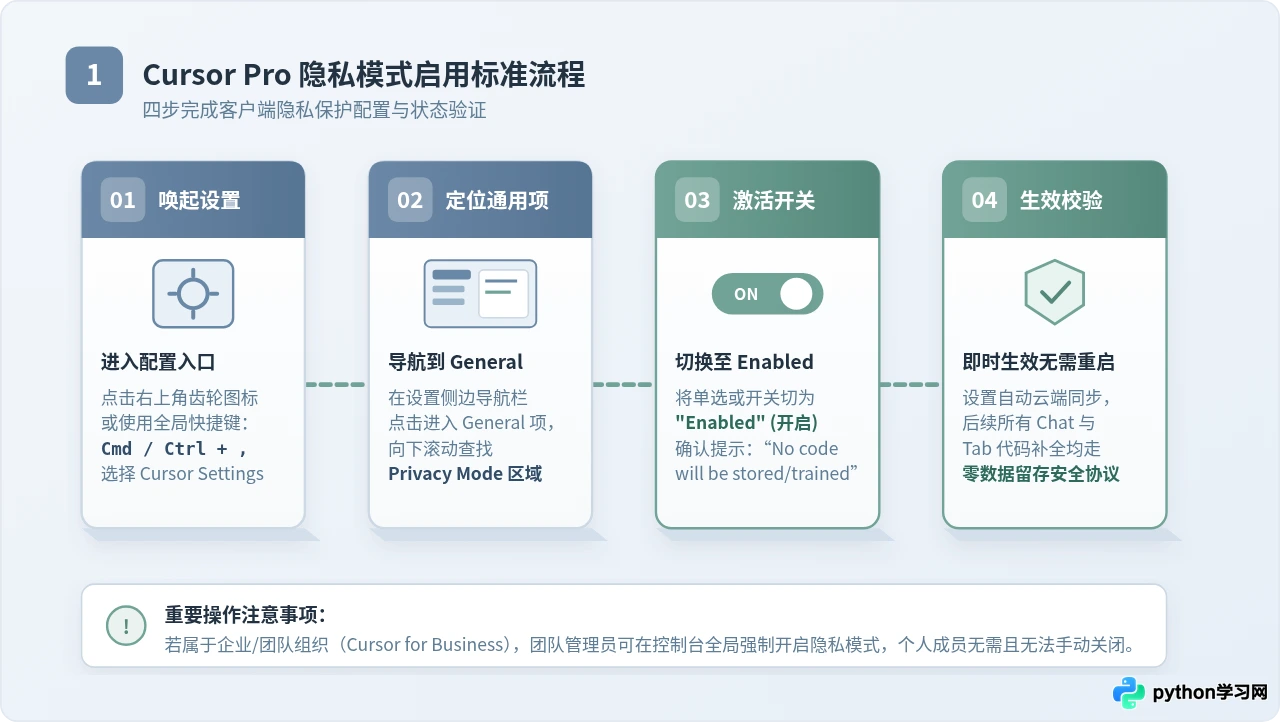
在编辑器主界面右上角,点击齿轮形状的 Settings 图标;或者使用操作系统对应的快捷键唤起偏好设置菜单:
- macOS 快捷键:
Cmd + ,或Cmd + Shift + J - Windows / Linux 快捷键:
Ctrl + ,或Ctrl + Shift + J
在弹出的菜单中,选择 Cursor Settings 进入专用设置页。
在 Cursor Settings 的左侧导航栏中,点击 General 标签页。向下滚动界面,找到标有 Privacy Mode 的专属控制区。
在 Privacy Mode 选项旁,将单选开关切换为 Enabled。切换完成后,界面会展示明确的隐私保证文案:“No code will ever be stored by us or our model providers for training.”(我们及模型供应商均不会存储任何代码用于模型训练)。
该设置会自动同步至云端账户配置文件。切换后可以发起一次简单的 Chat 对话或触发代码行内补全(Cursor Tab),所有请求都将立即通过加密的零数据留存代理通道流转。
二、隐私模式的数据流转与底层安全原理
不少开发者关心:既然开启了隐私模式,为什么代码依然能够发送到远端并生成精确的补全建议?理解这背后的数据链路设计,有助于建立清晰的安全预期。
1. 零数据留存(Zero Data Retention, ZDR)机制
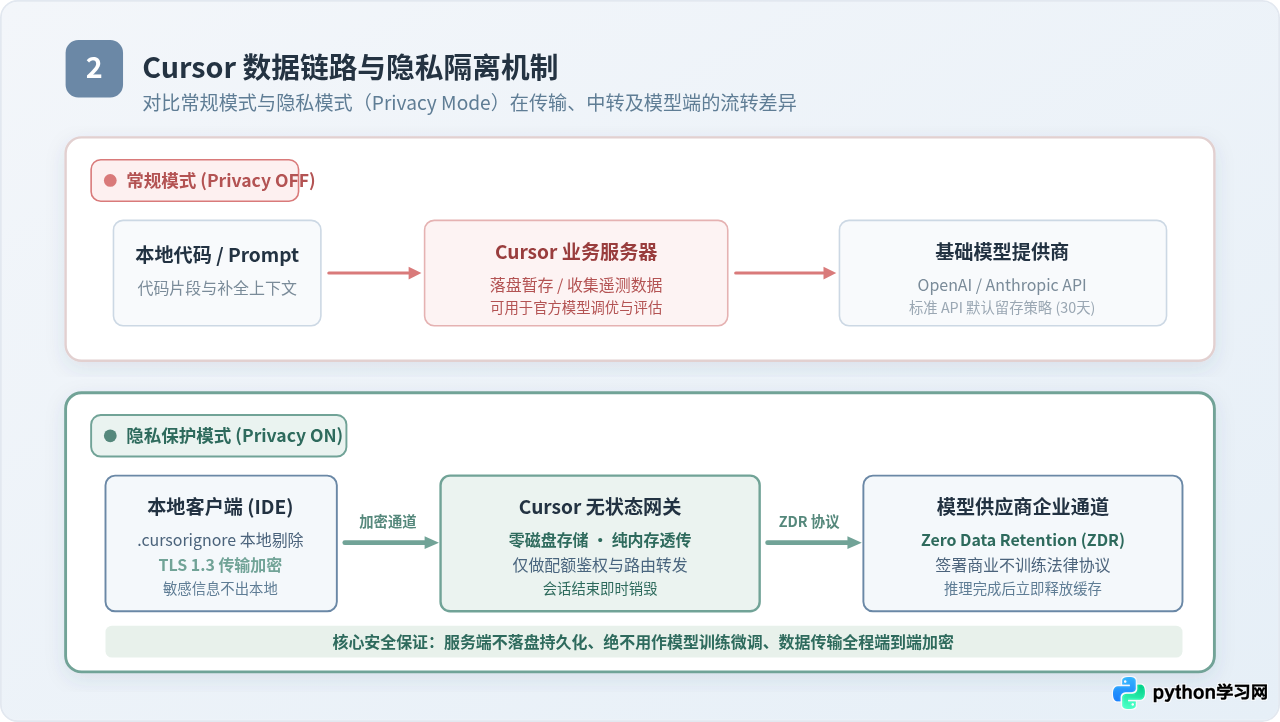
在常规模式(Privacy Mode 关闭)下,Cursor 可能会在服务端保留匿名的提示词和代码片段日志,用于产品错误诊断及官方专用辅助模型的微调优化。而在开启 Privacy Mode 后,数据流转遵循如下严格规范:
- 无状态中转网关:Cursor 服务器仅充当 TLS 1.3 加密的无状态路由代理(Stateless Proxy),只在内存中解析请求头用于配额计量和权限鉴权,不对请求正文(代码、Prompt、上下文文件)做任何磁盘落盘持久化存储。
- 商业级不训练承诺:Cursor 与底层模型供应商(如 OpenAI、Anthropic、Google Cloud)签署了企业级商用数据保护协议(Business Associate Agreements / ZDR)。模型供应商明确承诺:接收到的上下文在推理计算完成后立即从缓存释放,严禁被用于公开大模型的后续训练或微调迭代。
- 会话即刻销毁:一旦当前推理流式传输结束,网关侧的内存临时会话对象立即被回收清理。
2. 常规模式与隐私模式关键指标对比
| 对比维度 | 常规模式 (Privacy OFF) | 隐私模式 (Privacy ON) |
|---|---|---|
| 代码持久化存储 | 可能落盘保留 作为优化日志 | 严禁落盘 仅内存即时转发 |
| 用于模型训练 | 允许 用于 Cursor 内部算法微调 | 完全杜绝 官方与供应商均不训练 |
| 传输加密级别 | TLS 1.2 / 1.3 | TLS 1.3 全链路端到端加密 |
| 模型供应商留存 | 遵循供应商标准 API 留存期(最高30天) | 受商业级 ZDR 零数据保留条款约束 |
| AI 补全与聊天功能 | 正常可用 | 功能完全一致,无任何体验衰减 |
三、进阶防御:使用 .cursorignore 阻断敏感文件
很多开发者容易陷入一个误区:“开启了隐私模式,就意味着任何敏感文件都能放心地交给 AI”。实际上,零数据留存解决的是代码不被官方持久化和不被训练的问题,而不能阻止含有数据库明文密码、私钥证书或用户真实生产数据的片段在会话中被发送给大模型。
为了从客户端源头杜绝高危资产泄露,必须配合使用 .cursorignore 文件。
1. 代码库上下文索引(Embeddings)的工作逻辑
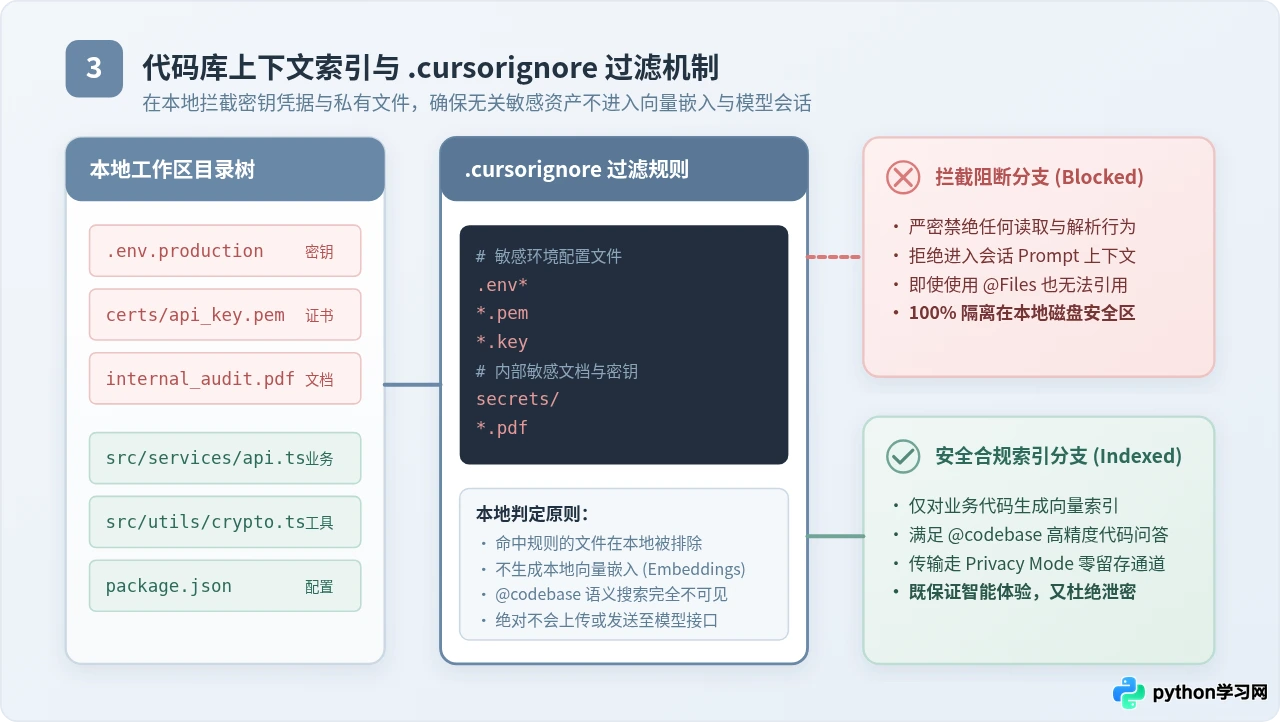
Cursor 提供了极其强大的 @codebase 语义代码搜索功能。该功能会在本地或远端对工作区文件构建代码向量嵌入(Embeddings)。如果在项目根目录没有声明排除规则,包含敏感密钥的文件可能会被分块索引,进而在 AI 检索相关上下文时被作为 Prompt 的一部分附加发送出去。
2. 创建并配置 .cursorignore 规则模板
在项目的根目录下创建一个名为 .cursorignore 的文件。其语法规则与 .gitignore 完全相同。被列入的文件将直接在本地被 Cursor 忽略:不进行本地或远端向量索引、不可被 @Files 语义引用、绝不发送给大模型。
# ==========================================
# Cursor 敏感文件排除配置 (.cursorignore)
# ==========================================

# 1. 核心环境变量与私钥配置(高危)
.env
.env.*
!.env.example
*.pem
*.key
*.p12
*.pfx
id_rsa
id_rsa.pub

# 2. 云厂商凭证与数据库连接配置
credentials.json
service-account*.json
database.yml
secrets/
config/master.key

# 3. 生产/测试真实数据脱敏文件
*.dump
*.sql
*.sqlite
*.sqlite3
test-data/real-dump/

# 4. 企业核心私有算法与特权代码模块(按需隔离)
src/core/proprietary_algo/
internal_compliance/
certs/

# 5. 大型二进制产物与依赖包(减少冗余开销)
node_modules/
vendor/
dist/
build/
*.bin
*.exe.cursorignore 提交到项目的 Git 版本管理中,以便团队所有开发者拉取项目后能够统一继承相同的安全排除策略,从源头上形成防泄密机制。
四、企业与高合规场景下的两项增强策略
对于涉及金融、军工、医疗或外包保密协议的特殊工程,单靠客户端开关可能仍不足以通过企业信息安全(InfoSec)团队的严格合规审计。针对这类高要求场景,Cursor 还提供了两项进阶管控手段。
1. 接入企业专属 API Key(BYOK 模式)
Cursor 允许用户绕过官方统一聚合通道,在设置中直接填入企业自有的模型 API 密钥(如 Azure OpenAI、Anthropic Claude 或 Google Gemini API Key)。
操作路径:Cursor Settings -> Models -> OpenAI API Key / Anthropic API Key。
安全收益:所有推理请求直接从本地向企业已签约的模型端点发起。企业拥有完整的数据控制权、网络白名单配置以及独立的账单与日志审计权限,完全不受第三方聚合中转的影响。
2. 禁用云端代码库索引(Local-Only Indexing)
如果不希望代码库特征上传至云端进行快速向量构建,可以在 Cursor Settings -> Features -> Codebase Indexing 中选择只使用本地索引或完全关闭该特性。此时 AI 对全局代码的理解将退回到基于编辑器打开窗口与主动引用的范围,进一步降低了数据暴露面。
五、代码数据安全纵深防御体系总结
保障 AI 辅助开发过程中的数据安全,绝非单一配置所能达成,而是由客户端、传输层、算力层和组织管理层共同构成的多层纵深防御体系。
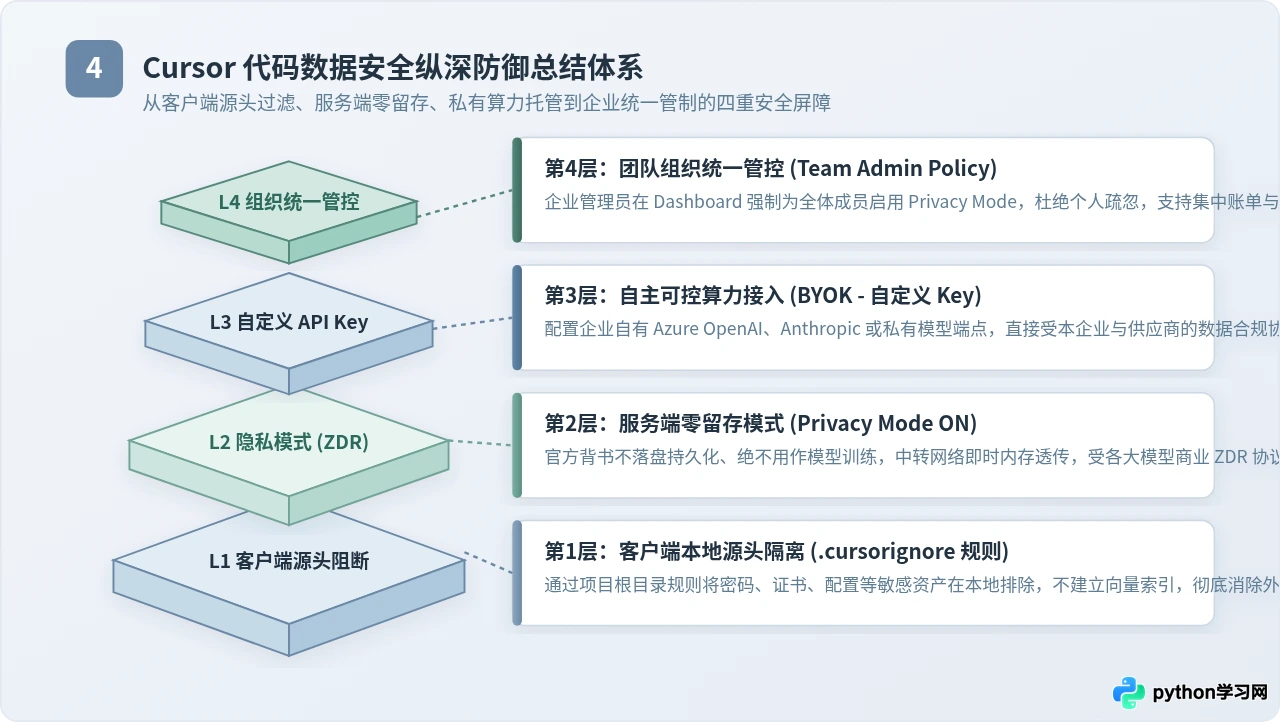
- L1 客户端源头隔离(.cursorignore): 守好第一道大门,确保密钥凭据、环境私钥和核心特权资产从一开始就被剔除在向量化和语义检索之外。
- L2 服务端零数据留存(Privacy Mode Enabled): 官方白纸黑字承诺不落盘存储代码、不将代码纳入模型训练语料,通过无状态网关保障即时流转。
- L3 自主可控算力端点(BYOK 自定义 Key): 在极高合规场景下,直连企业自主签约的云供应商企业端点(如 Azure OpenAI 专区),享有专属企业合规隔离。
- L4 组织统一集中管控(Team Admin Policy): 团队管理员通过统一后台强制执行合规基线,杜绝个人开发者因配置疏漏带来的数据外溢隐患。
六、常见疑问与安全排查 FAQ
.cursorignore 进行双重防护。免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









