

Python处理特殊字符大写转换:德语ß与土耳其语i的注意事项
深入解析Python中处理德语字母ß和土耳其语i大写转换时的核心陷阱、长度膨胀、不可逆回退以及协议标识破坏问题,提供可靠的工程实现方案与最佳实践准则。
str.upper()。但当业务涉及多语言文本或跨国数据交互时,德语字母 ß 会导致字符串长度膨胀且无法通过 lower() 逆向还原;而土耳其语中独立存在的两对点/无点 i 与 ı,不仅会被 Python 静态无视上下文的映射规则抹除语言含义,更可能因局部错误的转换逻辑破坏底层 HTTP 协议头、SQL 关键字或数据库字段。本文将具体剖析两者的底层机制、真实陷阱,并提供安全隔离的代码实践。
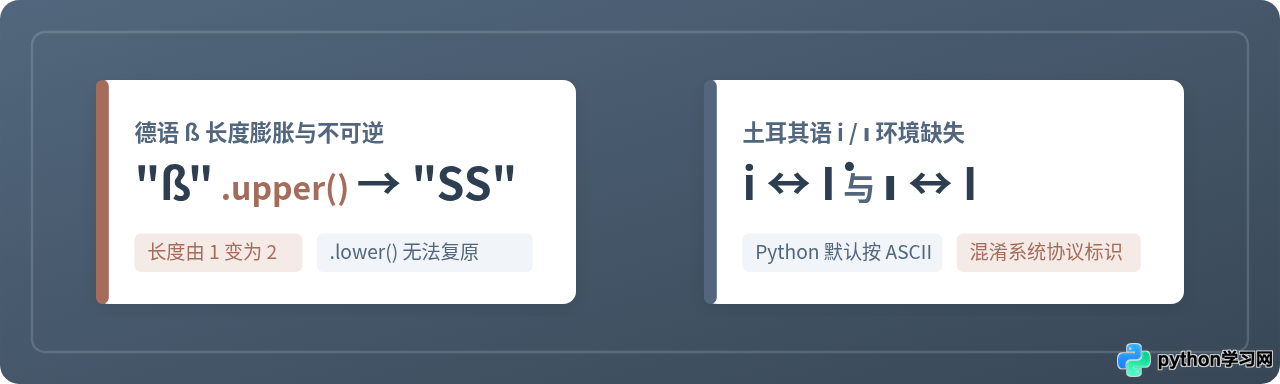
一、为什么简单的 upper() 在多语言文本中会失效?
Python 3 的字符串在内存中以 Unicode 字符序列(PyUnicodeObject)存储。Python 标准库中的 str.upper() 和 str.lower() 遵循的是 Unicode 官方标准的“默认大小写映射表(Default Case Operations)”。这一实现机制具有两个关键特征:
- 完全脱离运行时系统 Locale:无论当前操作系统或 Python 进程的区域设置为
zh_CN、en_US还是tr_TR,"i".upper()永远只会产出标准 ASCII 字符"I",不会依据当前语言环境动态变化。 - 支持 1 对多(One-to-Many)展开,但缺少上下文反向映射:单个 Unicode 字符的大写形式可能由多个字符组成。
对于纯英文字符串,大小写转换是直观的 1 对 1 可逆映射;但只要进入德语和土耳其语的语境,这种“一对一且双向可逆”的经验假设就会彻底失效。
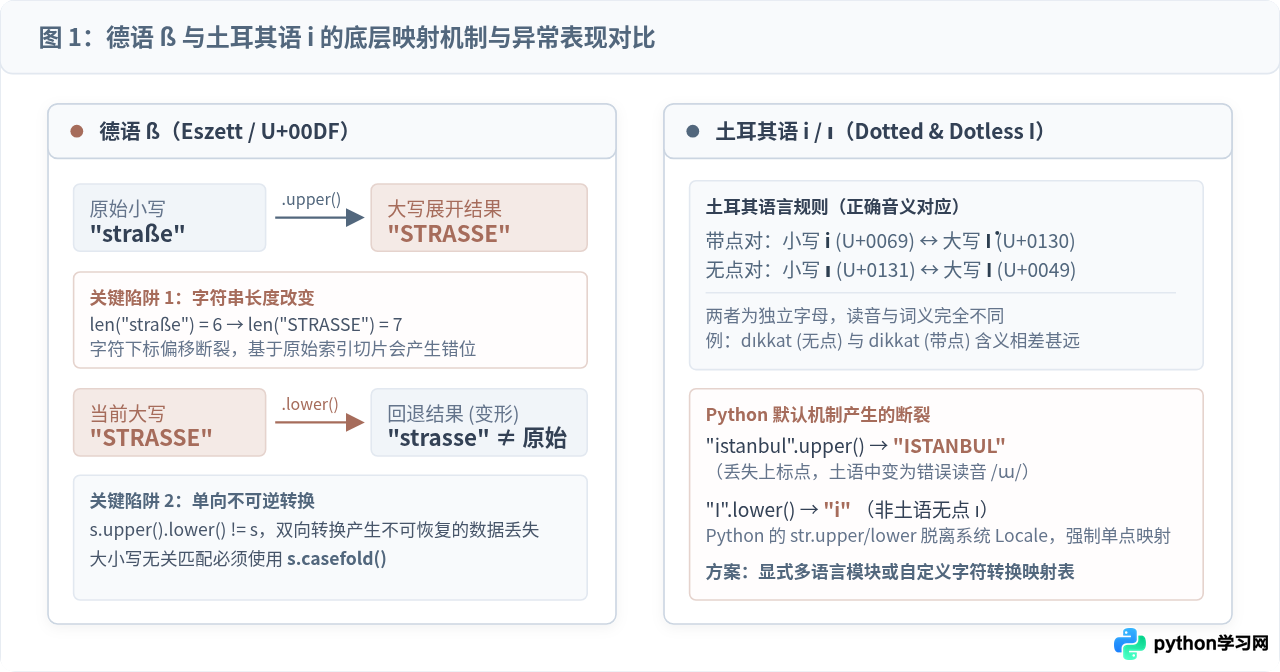
二、德语字母 ß(Eszett)的大写细节:长度膨胀与不可逆回退
德语中的小写字母 ß(Unicode 编码 U+00DF,德语称为 Eszett 或 scharfes S)代表清齿龈擦音 /s/。在德语传统正字法中,ß 仅存在小写形式,当需要全大写书写时,官方规范一律使用两个连写的大写字母 SS 代替。
1. 长度突变(Length Expansion)引发的索引错位
当对包含 ß 的字符串调用 .upper() 时,Python 严格遵循 Unicode 映射将其展开为两个字符 SS。这意味着字符串的长度在转换后发生了变化:
# 示例代码:验证德语 ß 大写转换后的长度变化
text_de = "straße"
text_upper = text_de.upper()

print("原始文本:", text_de, "| 字符数:", len(text_de))
print("大写文本:", text_upper, "| 字符数:", len(text_upper))大写文本: STRASSE | 字符数: 7
很多工程逻辑假设“大小写转换不改变字符位置”。例如在富文本高亮、搜索结果标记、语法分词(Tokenization)或数据库列截断逻辑中,如果使用在原始字符串上计算得到的下标去切片大写转换后的字符串,在 ß 之后的每一个字符都会发生 1 个偏移量(Offset)的移位,从而导致高亮错位或文本截断异常。
2. 双向转换不可逆:无法回退原始数据
另一个隐蔽风险是不可逆性。在德语中,Masse(质量、大众)和 Maße(尺寸、规格)是两个词义完全不同的词汇。如果程序将 Maße 转换为大写再转回小写:
# 示例代码:大写后再转小写的不可逆变形
word = "Maße"
upper_word = word.upper()  # 结果为 'MASSE'
lower_word = upper_word.lower()  # 结果为 'masse'

print("原词:", word)
print("往返后:", lower_word)
print("两者是否相等:", word == lower_word)往返后: masse
两者是否相等: False
原词中的 ß 在经过大写化后再小写化,被永久篡改成了 ss。这种往返操作破坏了数据的幂等性与准确性。
ẞ,编码 U+1E9E,LATIN CAPITAL LETTER SHARP S)纳入官方正字法,主要用于护照、法律公文和全大写排版中区分 MASSE 与 MAẞE。然而,Unicode 规范仍将 U+00DF 的默认大小写映射定义为 SS。因此在 Python 中,"ß".upper() 依旧输出 "SS",若业务明确要求使用新版单字符大写 ẞ,必须通过显式字符替换处理。
三、土耳其语 i 与 ı:被忽视的语言环境与协议灾难
在拉丁字母体系中,大多数语言都把 i 和 I 视为同一个字母的大小写形态。但在土耳其语(以及阿塞拜疆语)正字法中,存在两组地位平等的独立元音字母:
- 带点字母对(Dotted):小写
i(U+0069)↔ 大写İ(U+0130,上带点) - 无点字母对(Dotless):小写
ı(U+0131,无点)↔ 大写I(U+0049,普通 ASCII 大写 I)
带点的 i / İ 发前元音 /i/(类似“衣”),而无点的 ı / I 发后元音 /ɯ/(类似“饿”)。如果把带点与无点混淆,在土耳其语中就会造成单词词义完全改变,甚至构成侮辱性词汇。
1. Python 默认转换在土耳其语中的表现
因为 Python 默认采用与语言无关的 Unicode 映射,在处理土耳其语文本时会产生不符合土耳其语语法的映射:
# 示例代码:Python 默认 upper/lower 忽略土耳其语规则
city = "istanbul"
print("Python 默认大写:", city.upper())
# 土耳其语期望:İSTANBUL,实际得到:ISTANBUL(发音完全错误)

letter_I = "I"
print("Python 默认小写:", letter_I.lower())
# 土耳其语期望:ı,实际得到:iPython 默认小写: i
2. 致命的“土耳其语 I 问题”(The Turkish-I Problem)
有些开发者为了解决土耳其文本的大写问题,尝试去修改运行环境的全局 locale,或者编写了未经隔离的全局转换钩子。在有此机制的环境(如早期某些 Java/C 库在土耳其操作系统下默认生效)中,曾引发无数严重的系统崩溃——这就是计算机领域著名的 Turkish-I Bug。
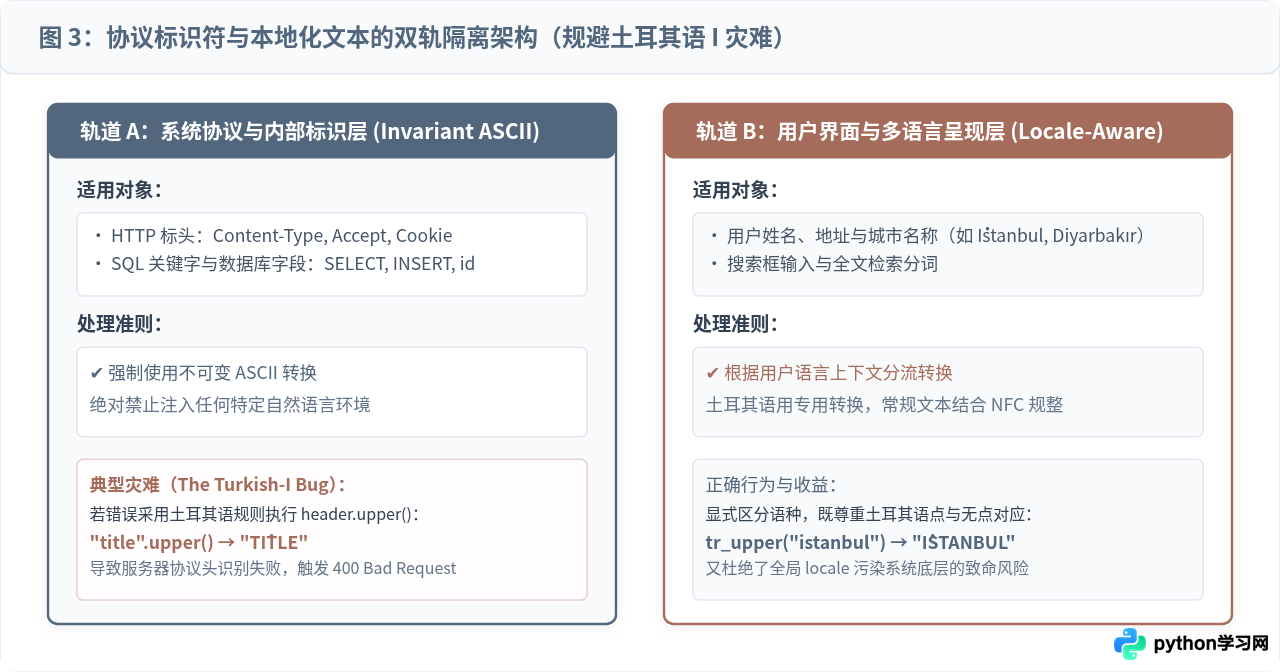
计算机底层的绝大多数协议、语法和数据标准,均建立在 ASCII 字符集之上。如果一个应用错误地把土耳其语大小写规则应用于底层协议数据,例如:
- HTTP 协议解析:将头部
"content-type".upper()转换为"CONTENT-TYPE",其中的I变成了带点的İ,导致主流 Web 容器无法识别该请求头。 - SQL 解析器:将查询语句
"select id from users"大写转换为"SELECT İD FROM USERS",数据库报错无法找到名为İD的字段。 - 文件路径与扩展名:将
"file.png".upper()中的i转为İ,在区分大小写的文件系统中导致 404 错误。
四、工程实战:可靠的处理方案与代码实现
面对上述特殊字符的大写转换与匹配需求,工程实现应当区分三类场景:大小写不敏感匹配、土耳其文本展示转换,以及德语特定大写展示。
1. 大小写无关比对:必须使用 casefold()
如果你的目的是在不区分大小写的情况下比较两个字符串是否一致(例如搜索、匹配、查重),绝对不要使用 a.upper() == b.upper() 或 a.lower() == b.lower()。
Python 提供了专用于大小写折叠的 str.casefold() 方法。它不仅执行小写转换,还会将特殊 Unicode 字符(如 ß 展开为 ss)规范化为可匹配的标准形态:
# 示例代码:casefold 与 upper/lower 在德语比对中的正确姿势
s1 = "Straße"
s2 = "STRASSE"

# 错误做法:使用 lower()
print("lower 比较结果:", s1.lower() == s2.lower())

# 错误做法:使用 upper() (虽然在德语ß刚好偶然相等,但在其他语种极易漏判)
print("upper 比较结果:", s1.upper() == s2.upper())

# 官方推荐正解:使用 casefold()
print("casefold 比较结果:", s1.casefold() == s2.casefold())
print("s1 casefold 结果:", repr(s1.casefold()))
print("s2 casefold 结果:", repr(s2.casefold()))upper 比较结果: True
casefold 比较结果: True
s1 casefold 结果: 'strasse'
s2 casefold 结果: 'strasse'
2. 土耳其语文本的安全转换实现
在不破坏系统全局环境的前提下,如果需要向土耳其用户展示正确的大写或小写文本,推荐使用基于 str.translate 的安全转换纯函数,或者在大型国际化系统中使用专业的 PyICU 库。
# 示例代码:轻量级、无全局污染的土耳其语大小写转换实现
TURKISH_UPPER_MAP = str.maketrans({
    'i': 'İ',  # 小写带点 i -> 大写带点 İ
    'ı': 'I',  # 小写无点 ı -> 大写无点 I
})

TURKISH_LOWER_MAP = str.maketrans({
    'İ': 'i',  # 大写带点 İ -> 小写带点 i
    'I': 'ı',  # 大写无点 I -> 小写无点 ı
})

def turkish_upper(text: str) -> str:
    """针对土耳其语的大写转换函数:仅转换特异性字母,其余保持 Unicode 标准转换"""
    # 先处理 i 和 ı 的特殊映射,其余字符再进行常规 upper
    return text.translate(TURKISH_UPPER_MAP).upper()

def turkish_lower(text: str) -> str:
    """针对土耳其语的小写转换函数"""
    return text.translate(TURKISH_LOWER_MAP).lower()

# 测试运行
sample_text = "istanbul ve diyarbakır"
print("土耳其大写结果:", turkish_upper(sample_text))

sample_upper = "İSTANBUL VE DİYARBAKIR"
print("土耳其小写还原:", turkish_lower(sample_upper))土耳其小写还原: istanbul ve diyarbakır
如果生产环境已引入 PyICU,推荐使用 ICU 官方提供的 Locale 转换接口:
# 示例代码:使用 PyICU 实现符合 Unicode CLDR 标准的转换(需安装 pyicu)
# import icu
# def icu_turkish_upper(text: str) -> str:
#     loc = icu.Locale("tr_TR")
#     return str(icu.UnicodeString(text).toUpper(loc))
#
# print(icu_turkish_upper("istanbul"))  # 输出: İSTANBUL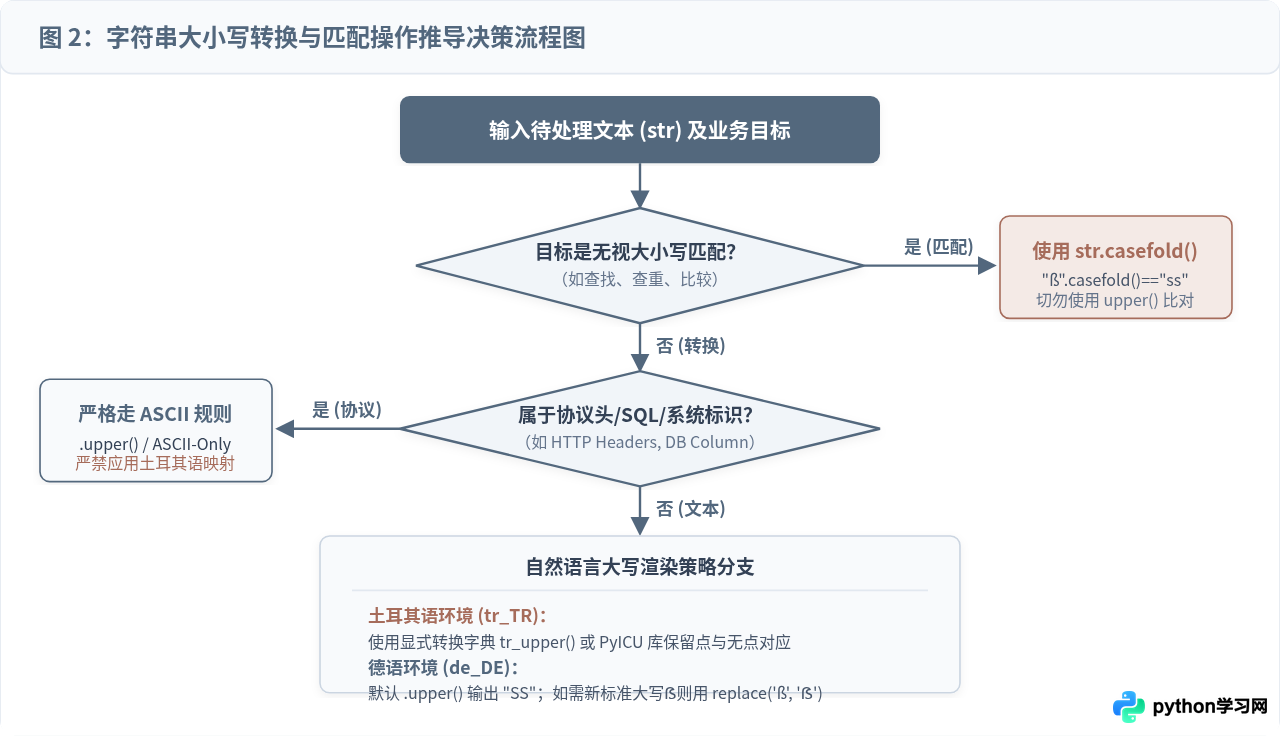
五、开发边界规范:两层分流与架构防护
为了杜绝在大型项目中发生“为了兼顾多语言显示而破坏内部逻辑”的事故,团队应在架构层面遵循“双轨隔离(Dual-Track Isolation)”准则:
| 对比维度 | 轨道 A:内部协议与标识符(Invariant ASCII) | 轨道 B:用户多语言呈现文本(Locale-Aware) |
|---|---|---|
| 涉及对象 | HTTP 请求头、URL 路由、SQL 字段、JSON 键、环境变量、文件后缀 | 用户昵称、街道地址、城市名称、文章正文、搜索框输入 |
| 转换原则 | 严格走 ASCII 规则(.upper() / .lower()),绝对禁止语种定制 |
根据用户语言标签(如 Accept-Language: tr)进行分流处理 |
| 匹配方式 | 标准字符串匹配或基础 lower 比较 | 强制使用 str.casefold(),必要时结合 Unicode NFC 规整 |
| 核心红线 | 绝不允许在系统层全局设置 setlocale(LC_ALL, 'tr_TR') |
绝不在多语言文本转换后基于转换前下标做切片截断 |
六、核心要点总结
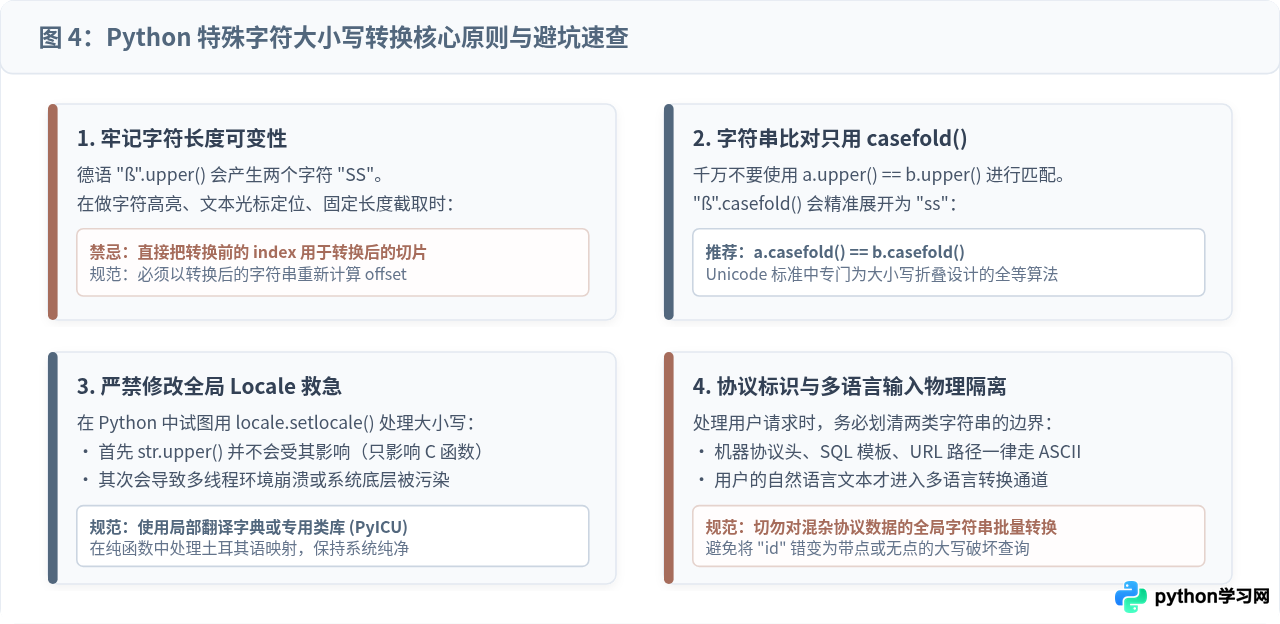
处理包含德语 ß 与土耳其语 i 的大小写转换时,请牢记以下四条黄金准则:
- 比较不用 upper/lower,一律使用 casefold:
a.casefold() == b.casefold()是 Python 中进行无视大小写字符串比对的唯一可靠方式。 - 动态计算切片位置,警惕长度膨胀:德语
ß转大写变为两个SS,任何涉及字符光标、高亮或定长截取的逻辑,必须以转换后的字符串重新测量长度与偏移量。 - 绝不对协议层数据注入自然语言规则:系统协议、数据库字段与机器标识符必须留在不可变的 ASCII 域,防止土耳其语
i转为带点大写İ引发协议失效。 - 本地化转换采用纯函数局部映射:土耳其语的带点/无点转换应在业务表现层通过独立纯函数(
translate或PyICU)按需调用,严禁通过修改全局环境试图“一劳永逸”。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









