

Python大型项目为何要用包组织代码?单模块与多模块对比
深入解析Python大型项目为何必须使用包组织代码。从单模块的代码膨胀痛点、命名冲突与合并地狱,到包架构的命名空间隔离、依赖解耦与接口控制,全方位对比单模块与多模块包的工程优劣,并提供平滑演进重构步骤与选型决策。
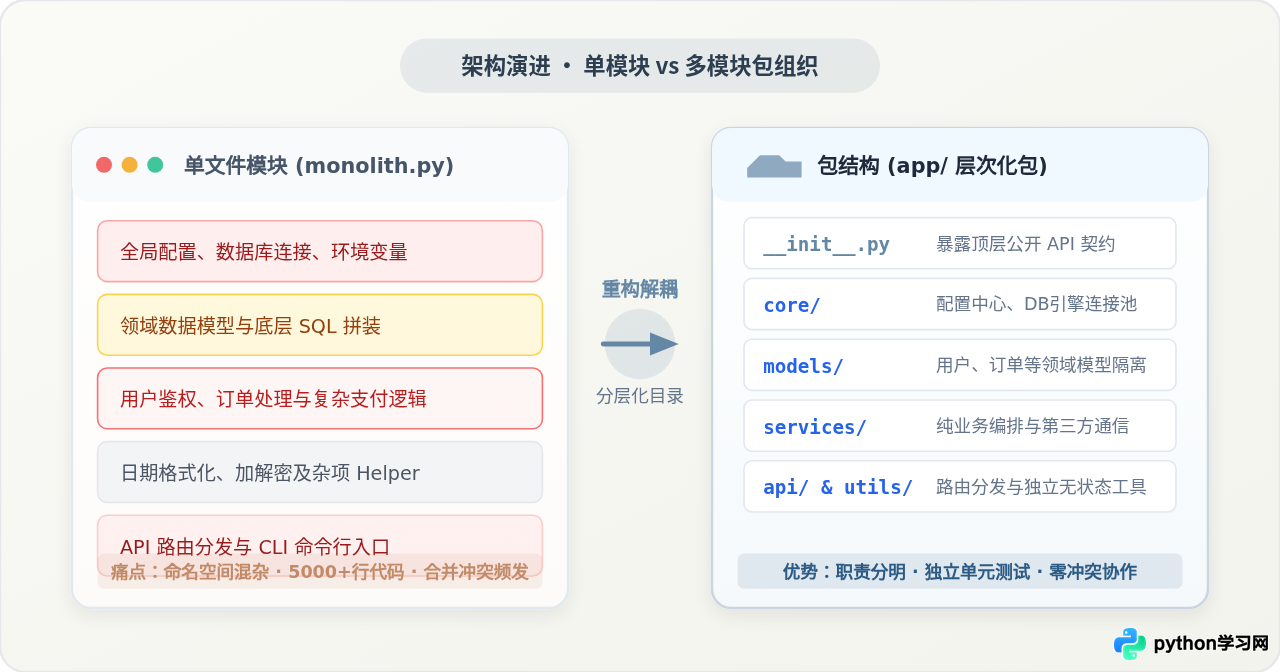
.py 文件)适合百行以内的小脚本或验证型原型,但当业务规模扩大、团队协作人数增加、长期维护与自动化测试成为硬性指标时,项目必须升级为由包(Package)和子模块(Module)构成的层次化目录架构。单模块向多模块包演进的核心目标,并不是形式上的“拆分文件”,而是通过命名空间隔离、职责边界正交化、接口可见性控制和依赖单向流转,将线性膨胀的认知负荷与代码冲突压制在局部可控范围。
一、单模块与包的底层技术定义
在深入探讨架构优劣之前,必须先厘清 Python 语言层面对“模块(Module)”与“包(Package)”的底层约定:
- 单文件模块(Module):任何一个以
.py结尾的 Python 文本文件就是一个独立模块。模块拥有独立的代码执行上下文,在被导入时,Python 会为其分配一个全局命名空间(即该文件内的globals()字典),并在sys.modules缓存中注册一个键名。 - 包(Package):包是一种特殊的模块,在文件系统层面表现为一个包含
__init__.py文件的目录(Python 3.3+ 也支持隐式命名空间包)。包不仅自身是一个模块对象,更是其他子模块和子包的容器,支持通过点号表示法(Dot Notation,如mypkg.submodule)构建树形层次空间。
理解这个区别至关重要:单模块是平面的一维结构,而包是立体的树状层级结构。正是这种空间维度的跃迁,决定了两者在支撑不同规模工程时表现出的本质差异。
二、单模块在大型项目中的四大结构性失控
当开发者试图将整个大型项目的逻辑堆叠在一个单文件(如 app.py 或 server.py)中时,随着代码突破数千行,系统必然遭遇以下四大结构性失控:
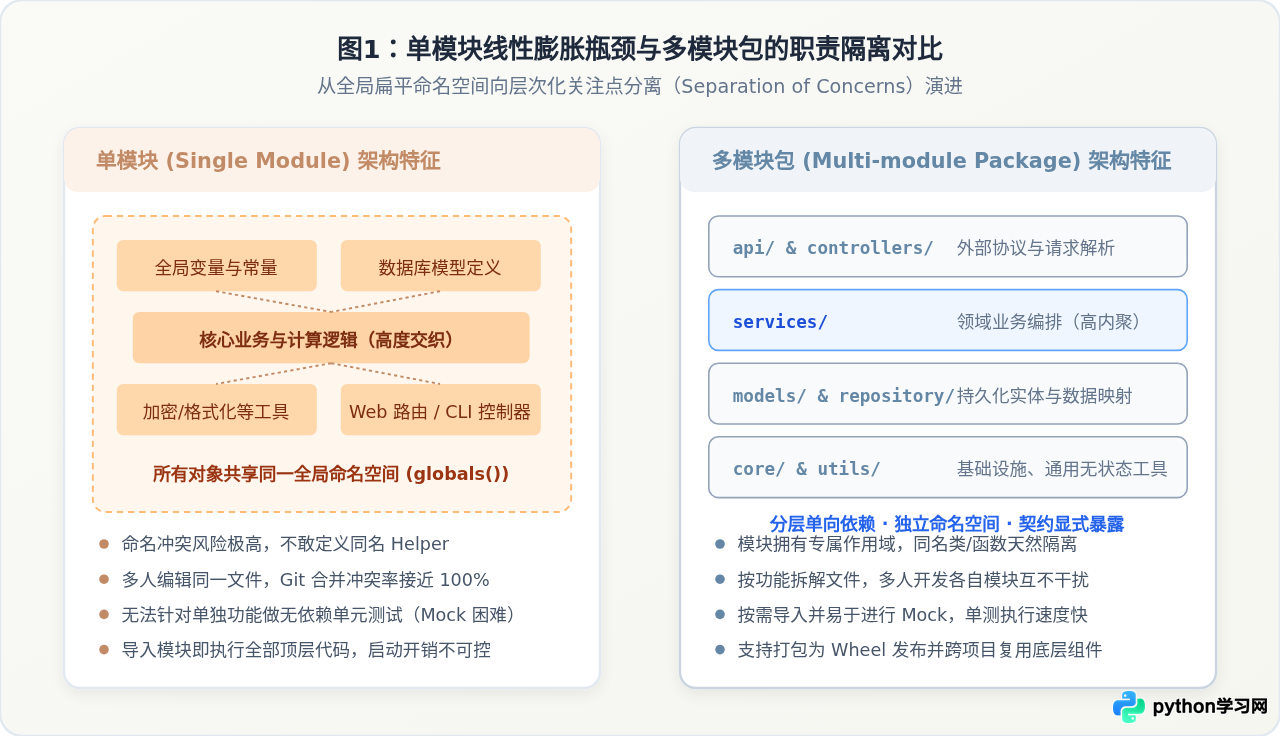
1. 命名空间坍塌与全局污染
在单模块中,所有顶层定义的变量、类、常量和辅助函数都挤在同一个 globals() 作用域中。随着业务演进,同名标识符的冲突概率急剧增加。例如,处理订单需要一个名为 validate() 的校验函数,处理用户注册也需要一个 validate(),在单模块中,开发者不得不通过生硬的人工前缀来规避冲突(如 order_validate()、user_validate())。这种做法极易发生意外覆盖,一旦某个局部逻辑不慎重新赋值了全局符号,整条业务线都将面临隐蔽的运行时崩溃。
2. 认知负荷过载与巨石黑洞
一个包含数千行代码的单文件,其内部函数间的调用关系往往演化为错综复杂的“网状依赖”。新加入团队的工程师想要修改一个数据格式化逻辑,必须通篇搜索该函数是否在文件后半部的某处被意外调用,心理负荷极大。大型单文件抹杀了架构的物理层次,使得代码无法从宏观视觉上反映出业务领域划分。
3. 团队协作并发瓶颈与 Git 合并地狱
软件工程的组织效率取决于团队成员能否并行工作。如果十名工程师同时在同一个 main.py 中新增功能、修复 Bug 和重构方法,Git 版本控制系统几乎无法自动合并更改。每一位开发者拉取主干时都会遇到密密麻麻的代码冲突(Merge Conflict),解决冲突的时间甚至会反超实际编码时间,严重拖慢交付节奏。
4. 测试隔离受阻与依赖倒置缺失
单文件代码中,高层业务逻辑(如结账扣款)往往与底层实现(如数据库直连游标、三方支付 SDK 客户端初始化)紧密交织在一起。编写单元测试时,无法只加载某个纯净函数进行快速验证;只要 import main,就会连带触发数据库连接、读取环境变量或初始化全局连接池,导致 Mock(模拟打桩)极其困难,CI/CD 流水线运行极其缓慢。
三、包组织代码的核心工程机制
将代码拆分为规范的包结构,并非只是“把大文件切碎”,而是借助 Python 语言特性建立严谨的软件架构约束。包组织为大型项目带来了四项关键工程能力:
1. 树形命名空间与点号寻址
包为每一个功能领域开辟了独立的命名空间。order/validator.py 与 user/validator.py 各自维护一个纯粹的 validate() 函数,两者调用时通过 order.validator.validate() 与 user.validator.validate() 清晰区分,从根源上杜绝了标识符覆盖与全局污染。
2. 关注点分离(SoC)与正交化架构
通过包的目录分层,可以建立自顶向下的单向依赖架构:
- 表现层(API / Controllers):仅负责接收请求、解析输入并下发任务。
- 领域层(Services / Domain):纯粹的业务规则实现,不涉及任何 HTTP 或 SQL 细节。
- 持久层(Models / Repositories):负责与数据库映射,隔离底层 SQL 变化。
- 公共层(Core / Utils):无业务状态的通用基础工具。
当下层模块发生改动时,上层调用方只要契约不变就无需改动,实现了系统内部的高内聚、低耦合。
3. 显式公开接口控制:__all__ 与封装契约
在包的 __init__.py 中,开发者可以使用 __all__ 列表精确界定对外开放的公共 API,隐藏内部实现细节:
# myapp/services/__init__.py
from .order import OrderProcessor
from .payment import PaymentGateway

# 显式声明仅向包外部暴露的核心类
__all__ = ["OrderProcessor", "PaymentGateway"]
外部模块只需书写 from myapp.services import OrderProcessor,而无需关心该类具体存放在哪一个私有内部子模块中。当未来重构内部模块文件名时,调用方的代码无需发生任何改变。
4. 循环依赖(Circular Import)的系统化治理
在单模块中,由于所有逻辑混杂,很多隐式双向依赖被全局变量掩盖。一旦拆分文件,若缺乏清晰的层级设计,极易出现 A 导入 B、B 又导入 A 的死锁(ImportError: cannot import name ... from partially initialized module)。而在标准包设计中,通过引入公共中介层、依赖倒置(Dependency Inversion)或使用局部延迟导入,能够迫使架构师梳理清晰的单向无环依赖图(DAG),从而大幅提升系统的健壮度。
四、Python 导入机制与命名空间解析原理
为了编写出稳定、无歧义的包结构,必须透彻理解 Python 解释器在执行 import 时的寻址与装载流程。
import mypkg.services.order 时,Python 并不是直接读取文件,而是通过一系列钩子(Hooks)在 sys.path 中搜寻对应的加载器,并在 sys.modules 中建立模块字典树。
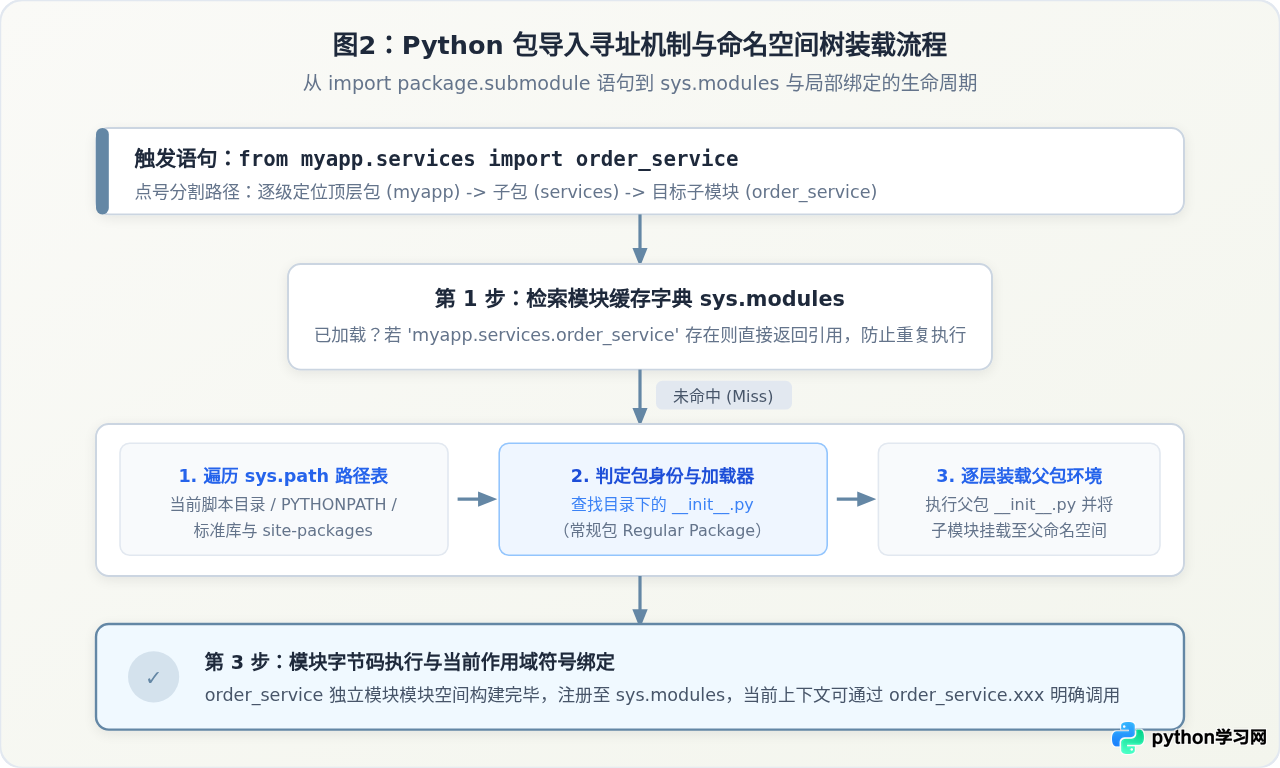
整个导入过程遵循严格的三步判定:
- 检查
sys.modules缓存:若目标模块名称已在字典中,直接返回该模块对象的内存引用。这是 Python 防止重复执行模块顶层代码、保证单例状态的核心机制。 sys.path路径查找与加载器匹配:若缓存未命中,解释器依次检索sys.path列表中的各个目录(依次包括:脚本入口所在目录、PYTHONPATH环境变量配置路径、标准库目录以及第三方包site-packages)。找到匹配的目录后,检查是否存在__init__.py。- 创建模块对象并填充命名空间:顺序执行该模块或对应
__init__.py中的顶层语句,将生成的局部变量填充到模块的__dict__中,最后存入sys.modules,并绑定到当前上下文的作用域变量中。
绝对导入与显式相对导入规范
在大型包组织中,导入语句的书写规范直接决定了项目的可维护性:
- 推荐规范:绝对导入(Absolute Import):以项目根包为起点,路径清晰明确。
from myapp.services.order import calculate_total
优点:不论当前文件被移动到包内哪个子目录,只要根包在sys.path中,导入语句始终有效且语义直观。 - 局部辅助:显式相对导入(Explicit Relative Import):使用前置点号表示当前或上级包。
from .helpers import sanitize_string
from ..core.config import get_settings
注意边界:相对导入必须在包的执行上下文中运行(模块必须具备有效的__package__属性),直接通过python myapp/services/order.py运行会触发ImportError: attempted relative import with no known parent package。
五、实战演练:从单模块平滑演进为包架构
以下通过一个具体的工程场景,演示如何将一个混合了配置、数据模型、业务计算与 API 路由的单文件平滑重构成标准的多模块包。
1. 重构前:膨胀的单模块 monolithic_order.py
# monolithic_order.py (全部混在一起,达数千行)
import os

# 全局配置
DB_HOST = os.getenv("DB_HOST", "localhost")
APP_SECRET = "super-secret-key"

# 数据库操作
def get_db_connection():
    return f"Connected to {DB_HOST}"

# 实体定义与验证
class Order:
    def __init__(self, order_id, amount):
        self.order_id = order_id
        self.amount = amount

# 业务逻辑
def process_order_payment(order: Order, token: str):
    conn = get_db_connection()
    # 支付计算逻辑...
    return f"Order {order.order_id} paid {order.amount}"

# 工具函数
def format_currency(val):
    return f"¥{val:.2f}"

# 路由分发
def handle_http_request(request_data):
    order = Order(request_data["id"], request_data["amount"])
    return process_order_payment(order, request_data["token"])
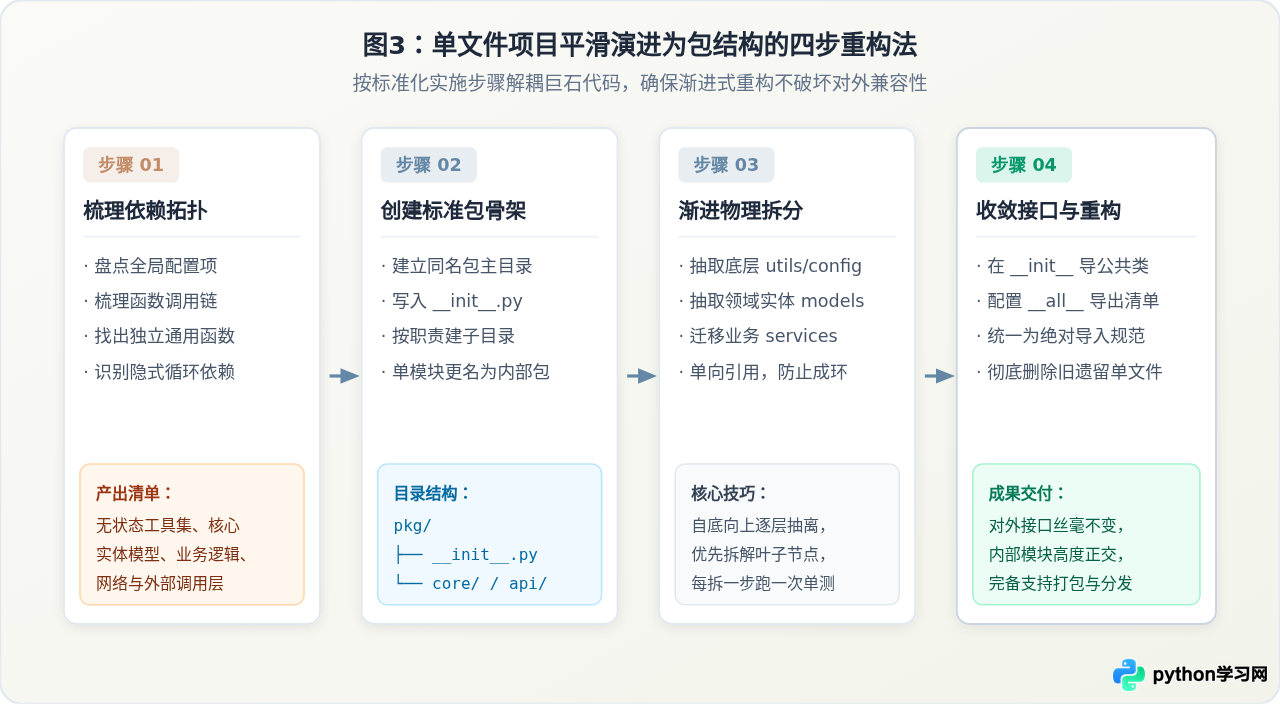
2. 四步演进实施指南
第一步:梳理依赖拓扑与边界划分
盘点全局变量与函数关系,划定职责板块:无状态工具(Utils)、基础设施与配置(Core)、数据对象(Models)、业务流程(Services)与外部接口(API)。
第二步:建立标准包骨架目录
在项目根目录下创建 order_system/ 包目录,并在子目录中安放 __init__.py:
order_system/
├── __init__.py
├── core/
│   ├── __init__.py
│   ├── config.py
│   └── database.py
├── models/
│   ├── __init__.py
│   └── order.py
├── services/
│   ├── __init__.py
│   └── payment.py
├── utils/
│   ├── __init__.py
│   └── formatters.py
└── api/
    ├── __init__.py
    └── routes.py
第三步:自底向上抽取子模块
先抽取最底层的无依赖模块(如 utils/formatters.py 与 core/config.py),再抽取 models/order.py,最后抽取上层 services/payment.py:
# order_system/services/payment.py
from order_system.core.database import get_db_connection
from order_system.models.order import Order

class PaymentService:
    def __init__(self):
        self.conn = get_db_connection()

    def process_payment(self, order: Order, token: str) -> str:
        # 纯业务逻辑实现
        return f"Order {order.order_id} processed successfully."
第四步:在 __init__.py 中封装对外暴露门面(Facade)
使调用方依然可以使用极简的方式使用系统,无需感知内部子目录变迁:
# order_system/__init__.py
from .models.order import Order
from .services.payment import PaymentService

__all__ = ["Order", "PaymentService"]
monolithic_order.py 并将其实现改为直接转发(Proxy)自新包对象,并触发 DeprecationWarning 告警,待所有调用方完成迁移后再彻底下线旧文件。
六、单模块与多模块包全维度对比决策
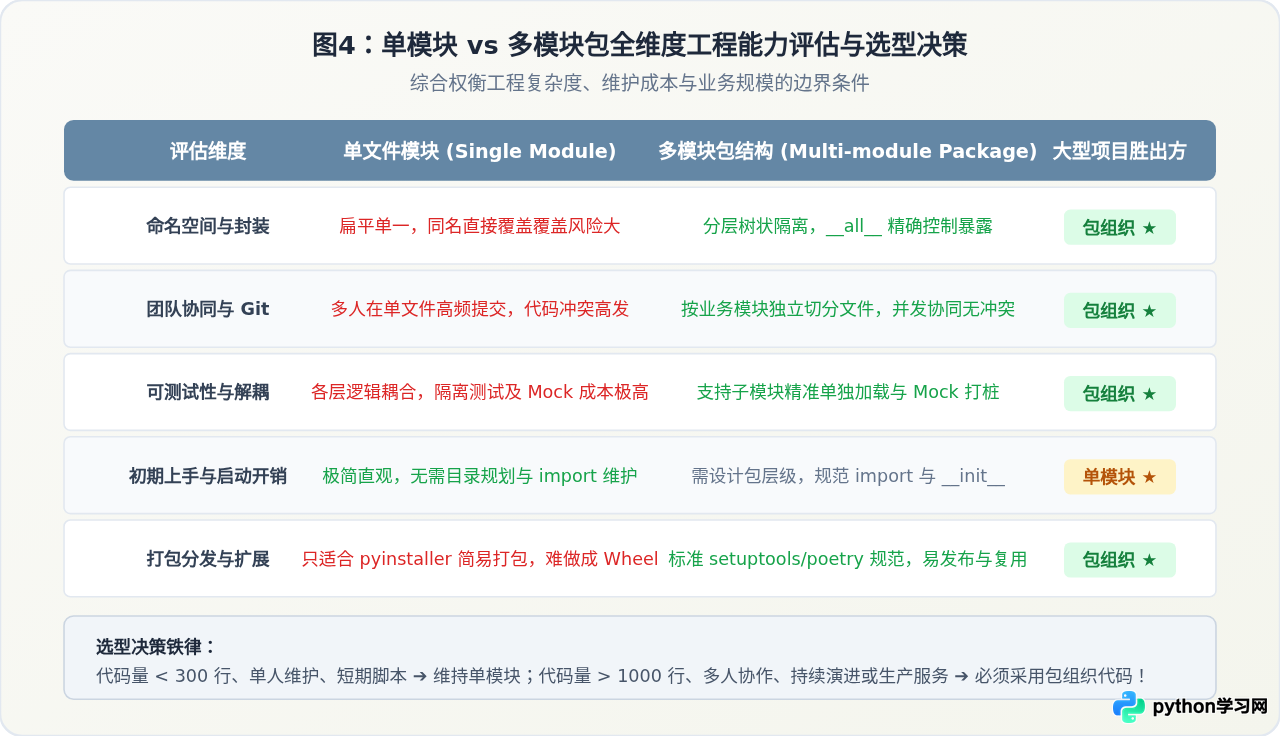
下表从实际工程落地场景出发,全方位对比两种组织模式的核心指标:
| 评估维度 | 单文件模块 (Single Module) | 多模块包组织 (Multi-module Package) | 大型项目需求 |
|---|---|---|---|
| 命名空间管理 | 单一全局命名空间,容易出现同名覆盖事故 | 树状分层隔离,各子模块私有变量互不冲突 | 必须具备严格的作用域隔离 |
| 多人协作体验 | 多人修改同一文件,Git 合并冲突频繁 | 各人负责独立功能目录,极少产生代码冲突 | 必须支持 5~50+ 工程师无锁并发协作 |
| 测试与 Mock 成本 | 导入时执行全局连接,单测隔离极其困难 | 按需导入细粒度模块,方便隔离打桩测试 | 必须具备高自动化单测覆盖率与秒级测试 |
| 代码理解与维护 | 文件长达数千行,需全局跳读,认知负荷沉重 | 目录结构映射业务领域,可按模块专注阅读 | 新人入职必须能够快速理解单一业务切面 |
| 打包与生态分发 | 难以构建为标准 Wheel 包供内外部项目依赖 | 原生契合 pyproject.toml 标准,一键构建分发 |
大型系统往往拆分为底层公共包与业务服务包 |
| 项目初始化成本 | 极低,新建单个 .py 即可立刻运行 |
需要预先规划目录层级、导入路径与配置文件 | 初期投入换取长期的系统可伸缩性 |
七、总结与选型决策铁律
综上所述,Python 大型项目之所以必须使用包组织代码,核心动因在于控制软件系统的不可逆熵增。当系统规模不断扩张时,单模块的扁平结构无法承担多维度的业务职责,必然导致命名冲突、巨石膨胀、协作阻塞与测试失控。
在日常架构选型时,可遵循以下决策准则:
- 何时坚守单模块:单人开发的自动化运维临时脚本、数据处理一次性脚本、概念验证(PoC)的原型代码,代码总行数在 300 行以内且预期无演进需求。
- 何时果断重构为包:业务逻辑多于 2 个独立领域、代码行数突破 500~1000 行、有 2 人以上共同维护、需要编写完备的自动化测试、或期望将核心能力沉淀为公司私有库进行跨服务共享。
采用规范的包结构组织 Python 代码,是每个 Python 开发者从编写“脚本”迈向构建“企业级健壮软件系统”的必由之路。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









