

Python截取字符串前几位时长度不足会报错吗
深入解答Python截取字符串前几位时长度不足是否会报错的问题,详细解析切片自动容错机制与索引越界报错的底层区别,并提供实用工程示例。
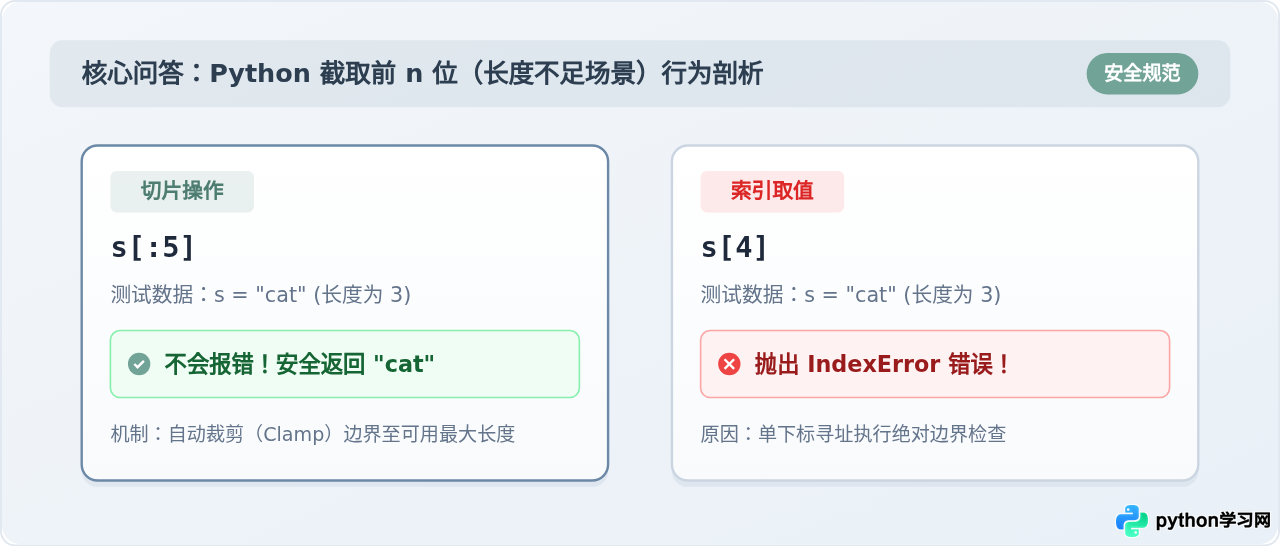
核心结论:不会报错。在 Python 中使用切片语法 s[:n] 截取字符串前 n 位时,即使字符串长度小于 n(甚至是空字符串),Python 也不会抛出异常,而是会安全地返回当前字符串所包含的所有字符;只有在使用单字符索引(如 s[n])时,超出实际长度才会引发 IndexError。
一、切片截取前几位的实际运行表现
在日常开发中,我们经常需要提取字符串的前几位字符,例如截取订单号前缀、日志时间戳或手机号归属地。实现这一需求最标准的写法就是利用 Python 的序列切片:s[:n]。
为了验证各种边界情况下的实际表现,我们通过具体代码依次检验不同长度输入下的输出结果:
# 定义不同长度的测试字符串
text_normal = "HelloWorld"  # 长度 10
text_short  = "Hi"          # 长度 2(小于截取长度 5)
text_empty  = ""            # 长度 0(空字符串)

# 场景 1:字符串长度充足时,截取前 5 位
res1 = text_normal[:5]
print(f"res1: {repr(res1)}")  # 输出: 'Hello'

# 场景 2:字符串长度不足 5 位时截取
res2 = text_short[:5]
print(f"res2: {repr(res2)}")  # 输出: 'Hi' (正常返回全部字符,无任何报错)

# 场景 3:空字符串截取前 5 位
res3 = text_empty[:5]
print(f"res3: {repr(res3)}")  # 输出: '' (正常返回空字符串,无任何报错)

# 场景 4:截取长度超大值(如 1000 位)
res4 = text_short[:1000]
print(f"res4: {repr(res4)}")  # 输出: 'Hi'
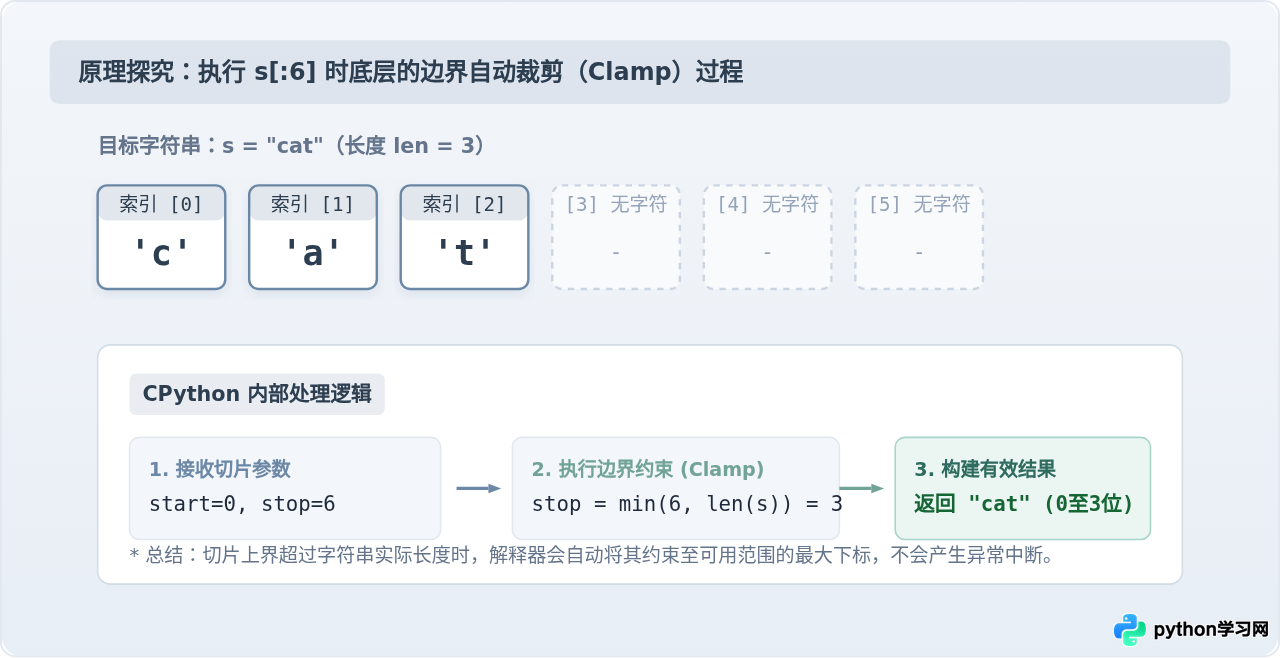
从执行结果可以清楚看到:无论指定的结束位置 n 有多大,只要使用 s[:n],Python 都会返回一个崭新的字符串对象。当长度不足时,它会自动在字符串末尾停下,绝不会中断程序运行。
二、为什么切片不报错,而索引会报错?
很多初学者之所以担心“长度不足会报错”,是因为在接触切片之前,通常先学习了通过单字符索引来访问字符串中的特定位置。例如:
s = "cat"  # 长度为 3,有效索引为 0, 1, 2

# 尝试通过索引获取第 5 个字符
try:
    char = s[4]
except IndexError as e:
    print(f"捕获异常: {e}")
    # 输出: 捕获异常: string index out of range
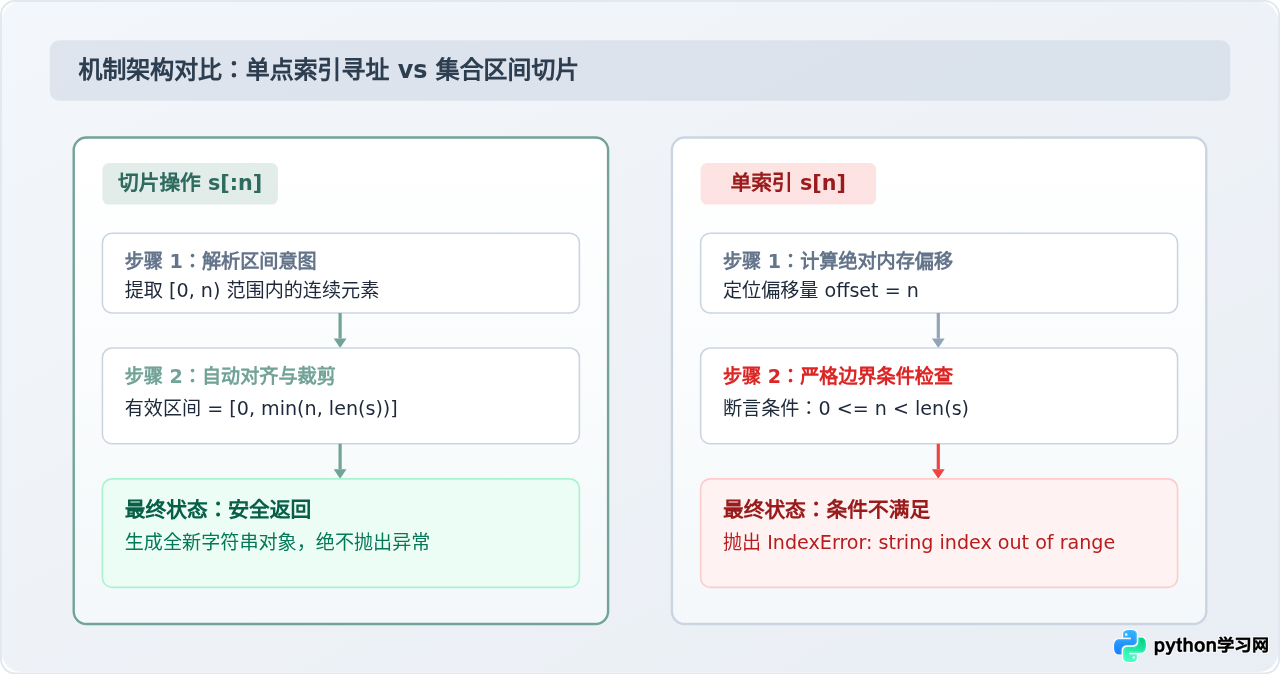
同样是面对超出边界的下标,为什么“单索引访问”和“切片截取”会有完全相反的行为表现?两者的根本差异在于语言语义和底层实现:
-
单字符索引(
s[i]): 语义是“精准取回某一个确定位置的元素”。在内存寻址模型中,既然开发者指定要第i个元素,那么该元素就必须真实存在。如果允许访问不存在的内存地址,将违背代码确定性,因此 CPython 会触发严格的下标校验,不满足-len <= i < len立即抛出IndexError。 -
区间切片(
s[start:stop]): 语义是“获取位于指定区间内的元素集合”。集合概念本身允许包含“0个到多个元素”。因此,在底层实现(如 CPython 的PySlice_GetIndicesEx函数)中,上下界会自动按照当前序列的实际长度进行钳位对齐(Clamp)。即使要求的区间全部在有效范围之外,也只是返回一个空的集合(空字符串""),在逻辑上完全自洽且安全。
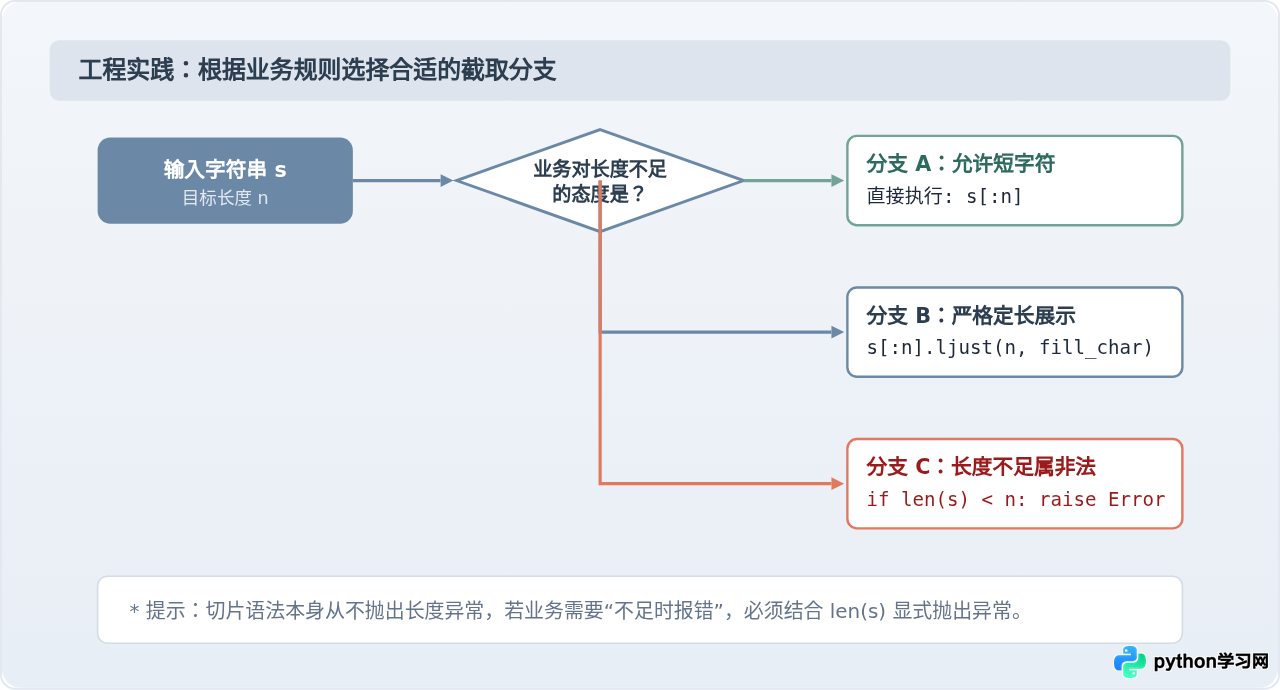
三、业务中截取前几位的 4 种应对策略
虽然切片默认“不报错”保证了程序的健壮性,但在不同实际业务场景下,长度不足可能代表不同的逻辑含义。我们需要根据业务契约选用合适的策略:
策略 1:容错截取(直接切片,接受短字符)
适用场景: 文本摘要、列表卡片预览、日志输出前缀等。这类场景的核心目标是“尽可能展示更多内容,但绝不超过最大宽度”,长度不足直接显示原本内容即可。
def get_preview_title(title: str, max_len: int = 10) -> str:
    # 长度不足时自然返回原字符串,超出时截取
    return title[:max_len]

print(get_preview_title("Python入门教程"))  # 输出: 'Python入门教程' (共8字)
print(get_preview_title("超长的新闻资讯标题展示")) # 输出: '超长的新闻资讯标题' (前10字)
策略 2:补齐填充(确保输出固定长度)
适用场景: 银行卡号掩码、定长数据报文生成、代码格式对齐。截取前几位后,若长度不足必须使用特定字符(如空格、0 或下划线)补足到固定长度。
def get_fixed_prefix(code: str, length: int = 6, fill_char: str = "0") -> str:
    # 先切片限制最大长度,再用 ljust 向右补齐
    return code[:length].ljust(length, fill_char)

print(get_fixed_prefix("ABC"))       # 输出: 'ABC000' (自动补齐到6位)
print(get_fixed_prefix("ABCDEFGH"))  # 输出: 'ABCDEF' (超出部分截断)
策略 3:严格校验(长度不足时主动报错)
适用场景: 金融交易协议解析、定长业务码拆分(例如前2位是省份代码、中间4位是机构码)。此时若长度不足属于非法输入,如果切片默默返回短串反而会导致后续逻辑产生静默错误,必须主动抛出异常拦截。
def parse_order_prefix(order_id: str, prefix_len: int = 4) -> str:
    if len(order_id) < prefix_len:
        raise ValueError(f"订单号 '{order_id}' 长度不足 {prefix_len} 位,无法解析前缀!")
    return order_id[:prefix_len]

try:
    prefix = parse_order_prefix("ORD")
except ValueError as e:
    print(f"业务拦截: {e}")
    # 输出: 业务拦截: 订单号 'ORD' 长度不足 4 位,无法解析前缀!
策略 4:带备用值的安全提取
适用场景: 兼容空值、None 或异常数据的防御性编码。
def safe_extract_prefix(text: str | None, n: int = 3, default: str = "N/A") -> str:
    if not text:
        return default
    return text[:n]

print(safe_extract_prefix(None))   # 输出: 'N/A'
print(safe_extract_prefix(""))     # 输出: 'N/A'
print(safe_extract_prefix("abc"))  # 输出: 'abc'
四、容易混淆的注意事项
在掌握切片安全截取特性的同时,还有几个与字符串切片和截取密切相关的细节需要注意,避免写出潜在的逻辑漏洞:
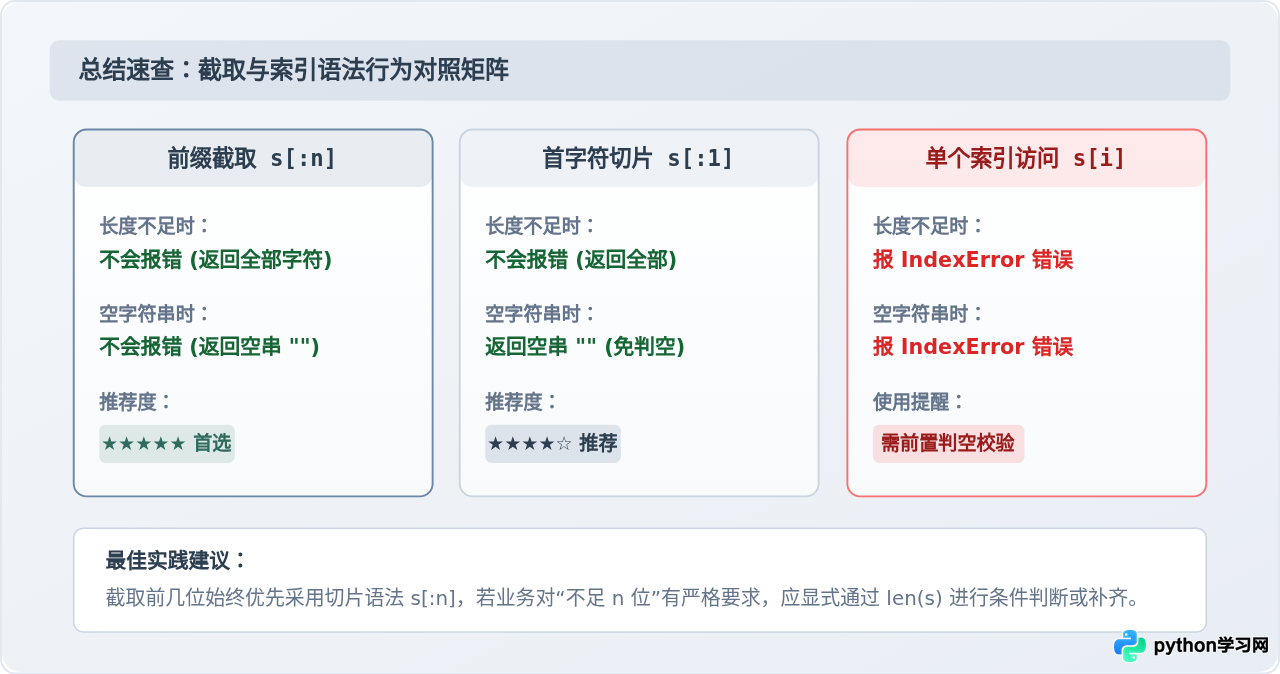
1. 获取单个字符时:切片 s[:1] 与索引 s[0] 的差异
如果只想获取字符串的第一个字符:
- 使用
s[0]:如果s为空字符串"",会立刻抛出IndexError; - 使用
s[:1]:如果s为空字符串,会安全返回空字符串""。
因此在不确定输入是否为空时,使用切片 s[:1] 可以免去额外的判空逻辑。
2. 步长与反向切片时的边界陷阱
当切片中带有步长(特别是负数步长)时,边界的默认处理方向会发生逆转。例如 s[::-1] 表示倒序,此时起始和结束位置的默认缺省值会与正向切片相反。在日常截取前几位时,建议始终使用标准的 s[:n] 正向切片,避免引入不必要的步长参数。
3. 中文字符与多字节长度
在 Python 3 中,字符串(str)是按 Unicode 字符 进行计数的,而不是按底层的 UTF-8 字节数:
cn_text = "你好世界"
print(len(cn_text))       # 输出: 4 (字符数为4)
print(cn_text[:2])        # 输出: '你好' (正常按字截取)
如果对接某些外部系统(如数据库 varchar 限制或网络传输协议)要求的是“字节长度”(如限制最多 10 字节),则不能直接用 s[:10],而需要先对字符串编码为 bytes 后再行截取或按字节计算边界。
五、全文总结
回到文章最初的问题:“Python截取字符串前几位时长度不足会报错吗?”
答案可以概括为以下三点核心认知:
- 切片绝对安全: 使用标准切片
s[:n]时,即使字符串长度小于n或为空字符串,Python 也绝不会抛出任何异常,而是会自动将上界收敛至可用范围的最大下标,返回实际包含的全部字符。 - 混淆来源于索引访问: 单字符索引
s[i]要求目标下标必须真实存在,超出范围会报IndexError;而切片代表区间范围,天然具备边界宽容与自动裁剪特性。 - 工程中因地制宜: 如果业务允许“有多少展示多少”,直接使用
s[:n]即可;如果业务要求固定宽度,可配合ljust()进行填充;如果业务要求长度不足属于错误输入,应显式通过len(s) < n抛出明确的业务异常。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









