

Python中==与is有什么区别?值相等与身份比较辨析
深入剖析Python中==与is运算符的本质区别。详细解析值相等与对象身份比较的底层机制、内存模型、CPython小整数缓存陷阱、自定义类__eq__重写以及工程中的最佳决策与避坑指南。
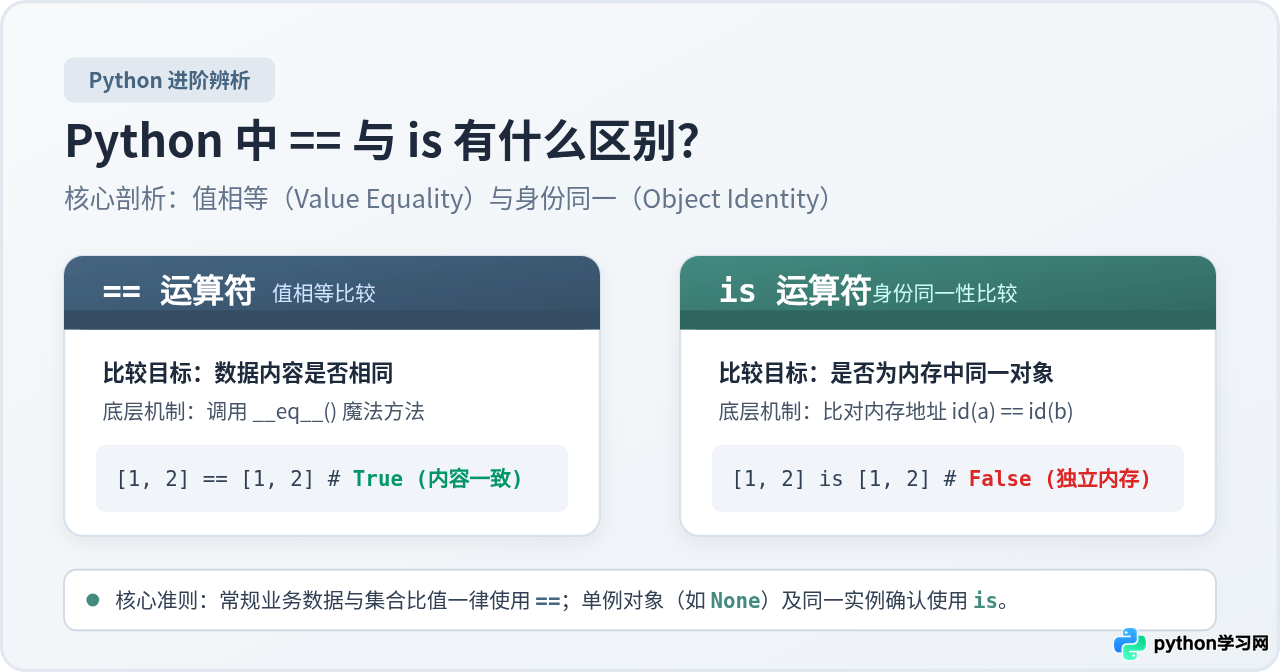
== 与 is 虽然都可以用作两个对象的比较,但它们衡量的技术维度截然不同:== 比较的是“值”(Value Equality),用于判断两个对象所包含的数据内容是否相等,底层调用对象的 __eq__() 魔法方法;而 is 比较的是“身份”(Object Identity),用于判断两个变量是否在内存中指向同一个对象实例,底层比对的是两者的内存地址(等价于 id(a) == id(b))。在绝大部分业务数据对比中,应当始终使用 ==;仅在判断单例对象(如 None)或明确验证同一内存实例时才使用 is。
一、本质区别:值相等与对象身份的底层模型
要彻底分清 == 与 is,首先需要理解 Python 解释器在内存中组织对象的基本结构。在 Python 体系中,“万物皆对象”。任何一个在内存中创建的对象,都具备三个核心要素:
- 身份(Identity):对象在内存中的唯一标识符。在 CPython 实现中,这就是对象在堆内存中的内存地址,可以通过内置函数
id()获取; - 类型(Type):描述对象能存储什么数据、支持哪些操作,可以通过
type()查看; - 值(Value):对象所持有的实际数据内容。
== 运算符只关心“值”是否相等。两个对象即使位于完全不同的物理内存区域,只要它们的数据内容按照逻辑规则一致,== 计算结果就是 True。例如两个独立创建的列表 [1, 2] 和 [1, 2]。
相反,is 运算符是纯粹的“指针级别比对”。它完全不解析对象内部的具体数值,只比对变量所引用的内存地址是否一模一样。只要地址不同,哪怕内容分毫不差,is 的判定也是 False。
# 示例 1:创建两个内容相同的独立列表
a = [1, 2, 3]
b = [1, 2, 3]
c = a  # 将变量 c 绑定到 a 所指向的同一个对象

print(a == b)  # 示例输出: True  (内容完全相同)
print(a is b)  # 示例输出: False (两块独立的内存堆对象)
print(a is c)  # 示例输出: True  (指向同一个内存地址)

print(hex(id(a)))  # 示例输出: 0x10a48b3c0
print(hex(id(b)))  # 示例输出: 0x10a48b480 (地址不同)
print(hex(id(c)))  # 示例输出: 0x10a48b3c0 (与 a 完全一致)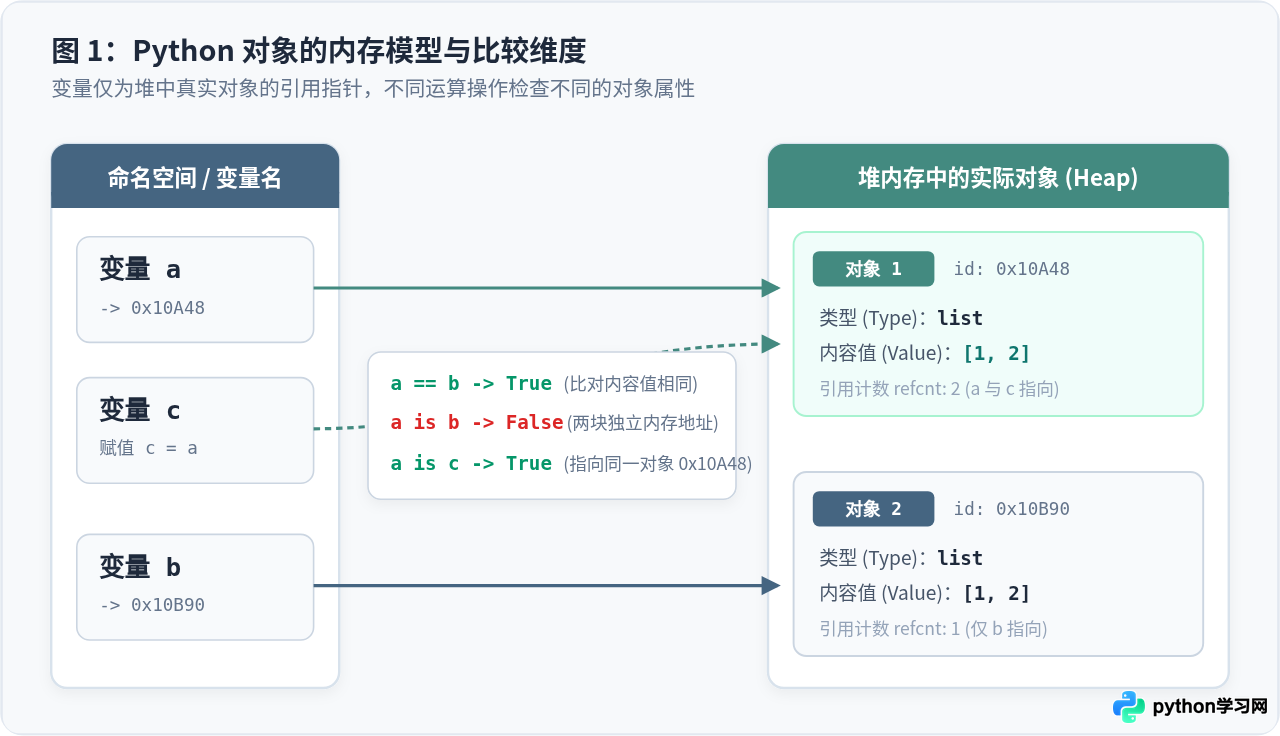
从图 1 可以直观看出:变量 a 和 b 分别分配了独立的堆内存空间,内存地址不同,因此 a is b 必定为 False;但因为各自持有的元素序列完全一致,在调用 __eq__() 进行内容逐项比较时,a == b 返回 True。赋值语句 c = a 仅是将 c 的指针指向 a 的现有地址,并没有新建对象,因此 a is c 返回 True。
二、CPython 内部优化陷阱:小整数池与字符串驻留
许多开发者在初学 Python 时,常常在交互式终端(REPL)中写出类似下面的实验代码,并由此产生误解:
>>> x = 100
>>> y = 100
>>> x is y
True

>>> m = 1000
>>> n = 1000
>>> m is n
False
同样是整数,为什么 100 is 100 为 True,而 1000 is 1000 却为 False?这正是很多误用 is 的根源所在——混淆了语言规范与解释器的内部缓存优化。
1. 小整数对象池(Small Integer Caching)
在标准的 CPython 实现中,整数是不可变对象。为了避免频繁创建和销毁常用的数字所带来的性能损耗,CPython 在解释器启动时,就预先创建了一个全局数组,把 [-5, 256] 闭区间内的所有整数全部实例化并常驻在内存中。
只要你的代码中用到了这个区间的整数,CPython 都会直接返回预先创建好的同一对象指针。因此,x = 100 和 y = 100 实际上指向了完全相同的全局单例,x is y 自然返回 True。而 1000 超过了小整数池的范围,解释器在每次遇到时都会在堆上开辟新内存,因此 m is n 为 False。
2. 字符串驻留机制(String Interning)
类似于小整数池,CPython 还对某些满足特定规则的不可变字符串实现了驻留优化(Interning)。如果字符串只包含 ASCII 字母、数字或下划线,且长度较短,解释器会将其存入内部字典保证唯一性。但是,一旦字符串中包含空格、特殊标点符号,或者由运行时拼接产生,解释器就不会保证驻留。
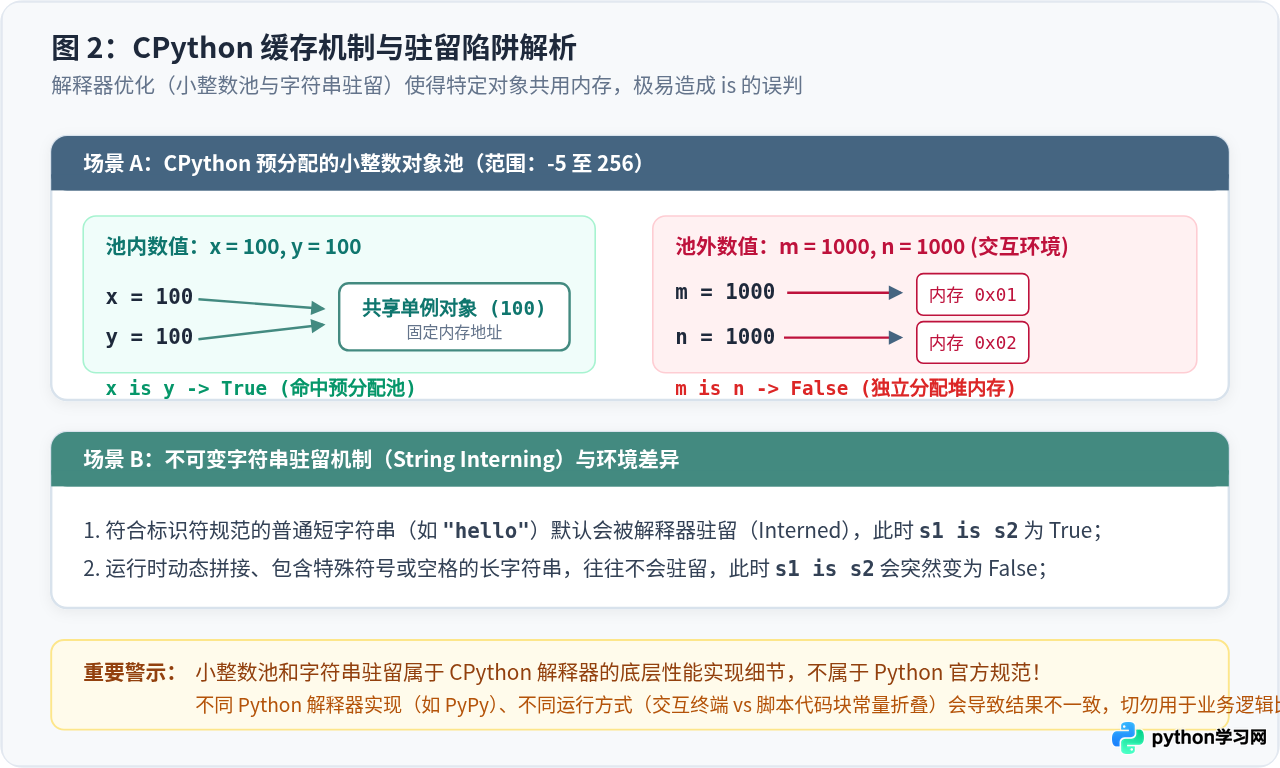
[-5, 256])和字符串驻留机制纯属 CPython 解释器的实现细节,并没有写进 Python 语言规范。不同的运行环境(例如在 .py 脚本中整个代码块编译时会做常量折叠优化,而在 REPL 逐行执行时不会)或者使用 PyPy 等其他解释器时,两者的行为表现可能完全不同。在任何涉及数值大小、文本匹配的业务场景中,必须且只能使用 ==。
三、运算符选型指南:何时该用 ==,何时该用 is?
在实际项目编码中,如何准确选择比较运算符?可以遵循以下清晰的工程准则与决策流程。
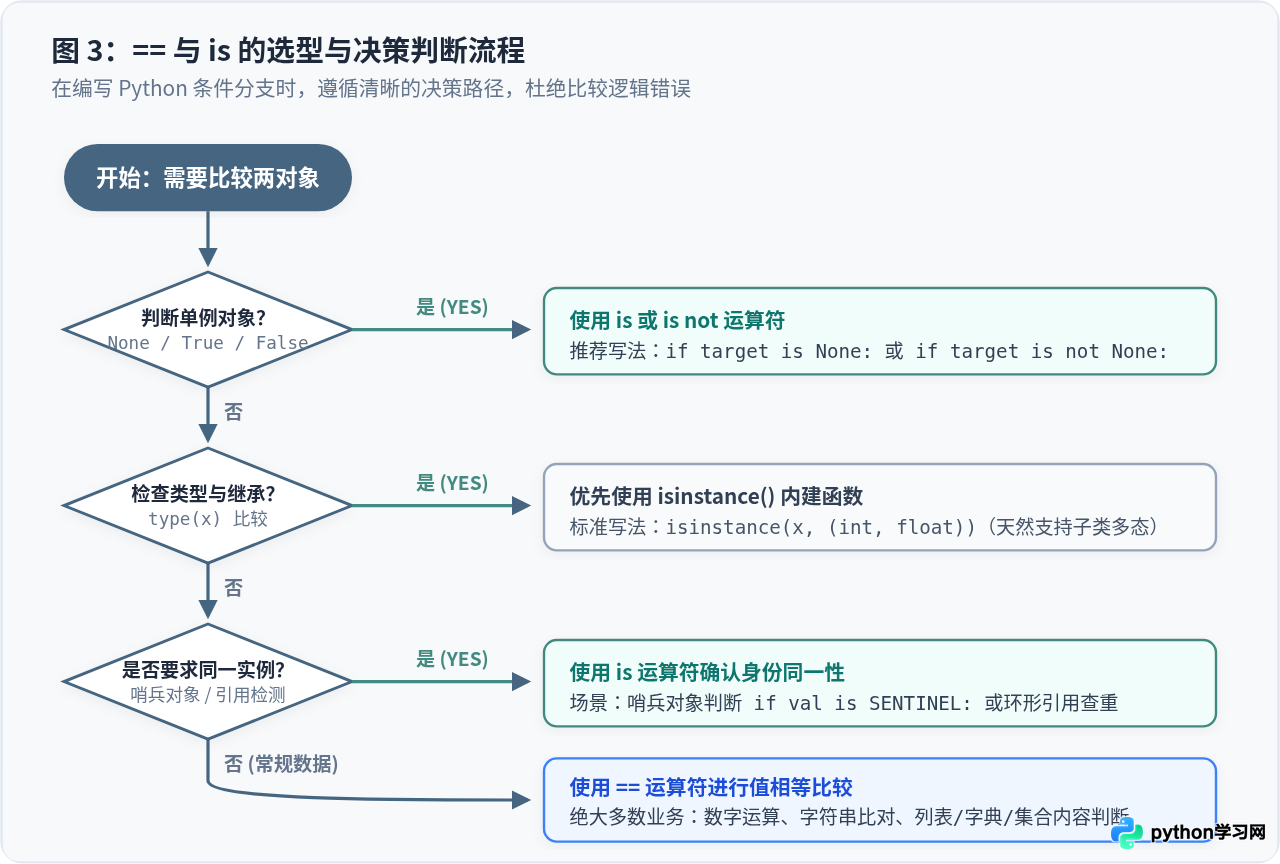
规则一:检测单例对象时,必须使用 is
Python 中的 None 是最典型的全局单例对象(Singleton),在整个运行时生命周期中永远只有一个实例。PEP 8 官方编码规范明确指出:所有针对 None 的检查必须使用 is 或 is not,严禁使用 == None。
# 正确规范的写法(PEP 8 推荐)
if result is None:
    print("无返回数据")

# 错误不规范的写法
if result == None:  # 存在潜在风险,性能较慢且易受 __eq__ 干扰
    print("无返回数据")
为什么要对 None 这么严格?原因有两点:
- 执行性能:
is只是单步的指针比对,耗时恒定在几纳秒级别;而==会调用左侧对象的__eq__()方法,带来函数调用开销; - 行为安全性:如果某个自定义类恶意或错误地重写了
__eq__()方法(例如恒定返回True),那么my_obj == None就会产生灾难性的逻辑误判;但is是不可被重写的语言级操作,不会被绕过。
规则二:布尔值判断遵循真值测试,不显式比对 True / False
虽然 True 和 False 也是单例,但在条件语句中,PEP 8 推荐直接利用其布尔真值特性,不要多此一举地写 == True 或 is True:
# 推荐写法(Pythonic)
if is_active:
    process_task()

# 仅在需要严格区分 True 与 1 或其它 Truthy 值时,使用 is
if is_active is True:
    process_task()
规则三:常规业务数据与集合比值,一律使用 ==
无论是字符串、整数、浮点数、列表、字典、集合还是自定义业务数据模型,比较的目的是确认“数据是否符合预期”,此时必须使用 ==。
四、进阶理解:自定义类与 __eq__ 机制辨析
== 并不是系统黑盒,它的实际运作依赖于 Python 的魔法方法 __eq__()。理解这个机制能够帮助我们更好地设计自定义类。
当你定义一个常规 Python 类时,它默认继承自顶层基类 object。在 object 的默认实现中,__eq__() 实际上退化成了 is,即只有同一个实例才被视作相等:
class RawUser:
    def __init__(self, user_id, name):
        self.user_id = user_id
        self.name = name

u1 = RawUser(101, "Alice")
u2 = RawUser(101, "Alice")

print(u1 == u2)  # 示例输出: False (默认比较内存地址,等同于 u1 is u2)
在实际业务中,我们通常希望“只要两名用户的 user_id 相同,就视为同一用户”。为此,我们可以重写 __eq__() 方法:
class User:
    def __init__(self, user_id, name):
        self.user_id = user_id
        self.name = name

    def __eq__(self, other):
        if not isinstance(other, User):
            return False
        return self.user_id == other.user_id

u3 = User(101, "Alice")
u4 = User(101, "Alice")

print(u3 == u4)  # 示例输出: True  (自定义逻辑:user_id 相同即可)
print(u3 is u4) # 示例输出: False (底层内存地址依然独立)is 运算符进行任何语法重载。这是一种至关重要的防御性设计:保证无论上层业务代码、第三方库对对象如何封装和重载魔法方法,开发者总能在底线处拥有一个百分之百可信的手段,能够无歧义地确认“此时此刻打交道的,究竟是不是内存里的这同一个对象”。
五、全维度对比与避坑指南
为了便于查阅和在团队中建立统一规范,我们将 == 与 is 的各维度差异总结如下:
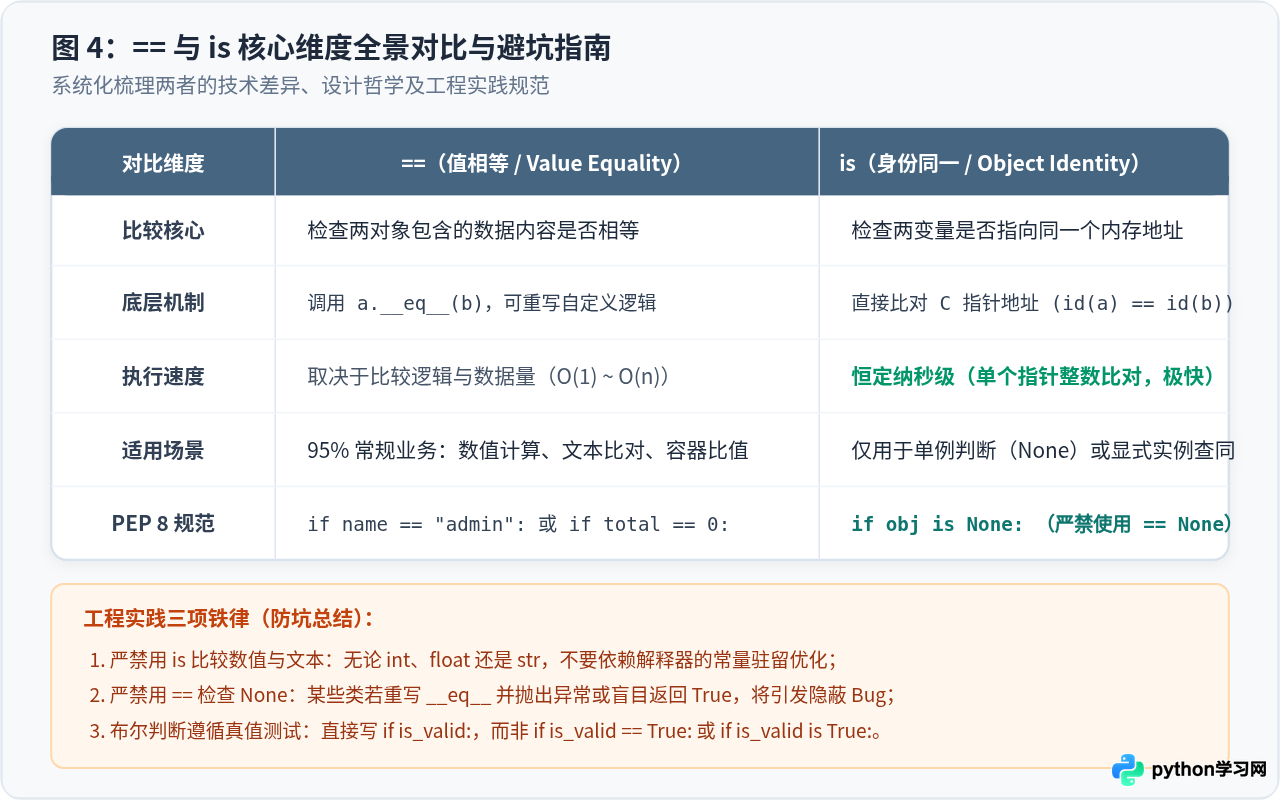
| 比较维度 | == 运算符(值相等) |
is 运算符(身份同一) |
|---|---|---|
| 核心目标 | 比较两对象包含的具体数据内容是否一致 | 比对两个变量是否引用内存中的绝对同一对象 |
| 底层原理 | 调用 __eq__() 魔法方法 |
直接比较对象的内存地址(C 指针值) |
| 可定制性 | 支持在自定义类中自由重写实现 | 语言核心级保留操作,无法重写 |
| 执行效率 | 取决于数据规模与比较逻辑,可能触发深层遍历 | 纳秒级别极速比对,仅执行单次整数指针运算 |
| 典型场景 | 普通数值、字符串、列表、元组、字典、实体模型比值 | 单例判断(x is None)、哨兵对象、引用一致性检查 |
| 常见误区 | 误写 x == None,可能受恶意 __eq__ 影响 |
拿 is 当普通比值工具,掉入解释器缓存陷阱 |
常见错误排查与修复速查
-
错误场景 1:数字范围超出导致逻辑突变
if user_count is 300:❌(在某些环境或大数字下判定失败)
修复:必须统一使用if user_count == 300:✔️ -
错误场景 2:字符串动态拼接后 is 判定失效
if full_name is "John Doe":❌(运行时拼接的字符串通常不驻留)
修复:必须统一使用if full_name == "John Doe":✔️ -
错误场景 3:检查变量是否为 None 时使用 ==
if response == None:❌(违背 PEP 8 规范,且有隐患)
修复:统一改为if response is None:✔️
六、全文总结
区分 == 与 is 是写出健壮、符合 Python 规范代码的基础功:
只要记住八个字:“查值用等号,判空用身份”。即面对常规业务数据时,始终优先使用 ==;面对 None、全局哨兵(Sentinel)或需要严格确认为内存同一实体的场景时,才坚定使用 is。遵循这个规则,就能彻底避免由 CPython 内部优化机制引发的各种隐蔽 Bug。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









