

Python CUDA编程库对比:CuPy、Numba与PyCUDA怎么选
深入对比CuPy、Numba与PyCUDA在Python GPU编程中的核心定位、开发模式、显存机制与性能开销,提供详实的代码示例与明确的技术选型决策指南。
一、核心定位与技术栈层级解析
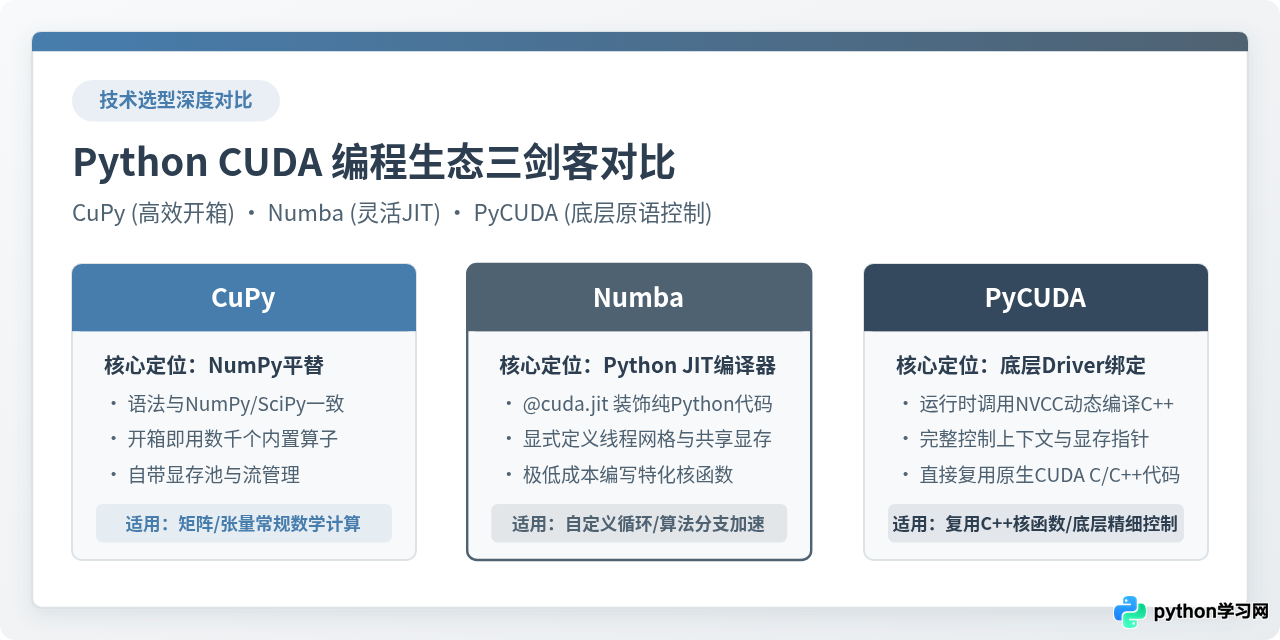
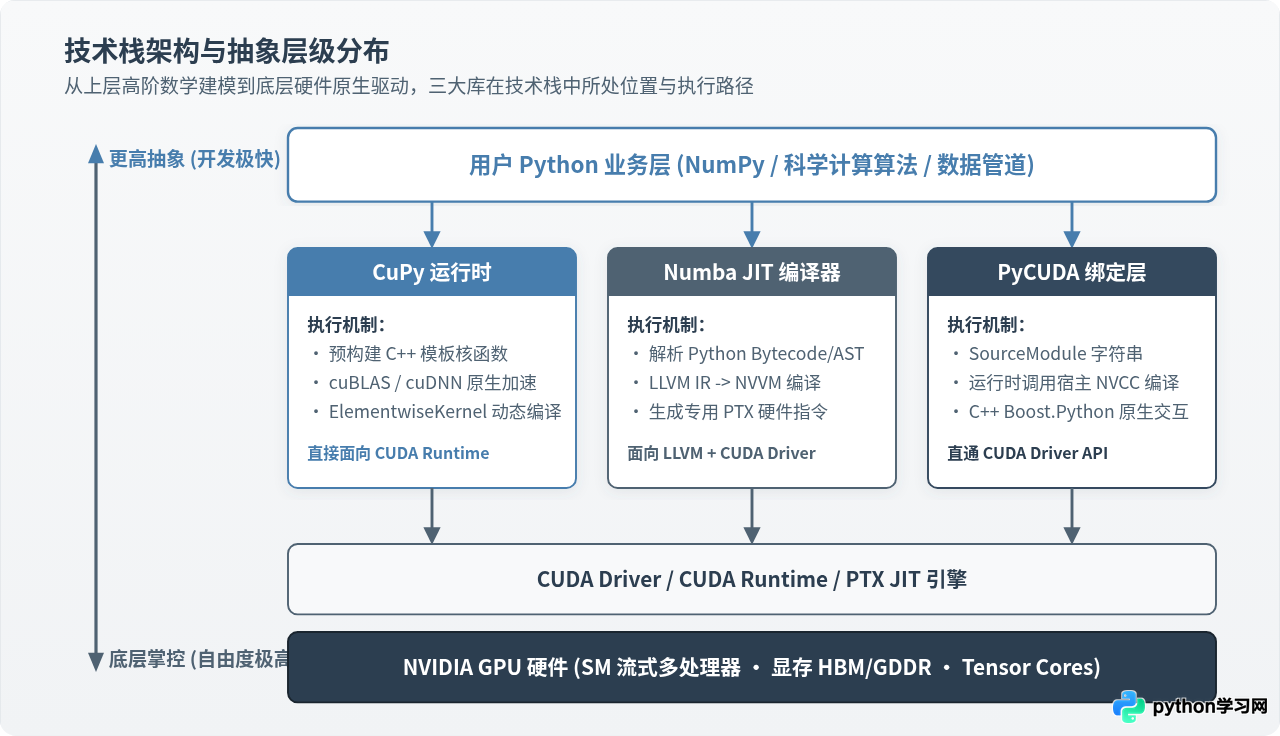
在 Python 生态中调用 NVIDIA GPU 进行高性能计算,本质上都是在与底层 CUDA 驱动(Driver API)和运行时(Runtime API)打交道。然而,CuPy、Numba 和 PyCUDA 切入的技术栈层级截然不同,这决定了它们各自的编程心智模型与性能边界。
CuPy 的定位是“GPU 版的 NumPy/SciPy”。它并不是一个编译器,而是一个由预构建算子与 C++ 模板支撑的高层张量库。当你调用 cupy.dot 或 cupy.exp 时,底层直接触发的是高度优化的 NVIDIA 官方库(如 cuBLAS、cuDNN、cuFFT)或经过深度调优的 CUDA C++ 模板核函数。对于数组级别的常规数值计算,CuPy 的吞吐量基本等同于手写优化的 C++ 代码,开发者完全不需要理解线程块(Block)与网格(Grid)的概念。
Numba(特别是 numba.cuda 子模块) 是一个基于 LLVM 的动态编译器。它接受纯 Python 编写的函数,在运行时分析其抽象语法树(AST),生成 LLVM 中间表示(IR),再调用 NVIDIA 提供的 NVVM 编译器将其直接编译为 GPU 原生 PTX 机器码。Numba 让开发者可以在不写一行 C/C++ 代码的前提下,精确使用 cuda.threadIdx、cuda.blockIdx 以及共享显存(Shared Memory)手写细粒度并行核函数。
PyCUDA 则走了一条更偏向底层的桥接路线。它由 PyOpenCL 的作者 Andreas Klöckner 主导开发,其核心机制是在 Python 运行时接收包含 C/C++ 语法的原生 CUDA 源码字符串,调用本地安装的 nvcc 编译器完成即时编译,并通过 Boost.Python 将显存指针、模块句柄和 CUDA Driver API 完整映射到 Python 端。PyCUDA 的自由度极高,但也要求开发者具备扎实的 C++ CUDA 编程能力。
二、典型代码模式对比:同一计算任务的三种实现
为了直观展示三者的开发范式差异,我们以一个具体的数值计算为例:计算二维网格中各点到中心原点的指数衰减场,公式为 \( Z_{i, j} = \exp(-lpha \cdot (X_{i, j}^2 + Y_{i, j}^2)) \)。我们对比三者在代码表达、显存分配与执行调用上的具体写法。
1. CuPy 实现:纯数组向量化表达
CuPy 的代码与标准 NumPy 几乎完全一致,只需将模块别名由 np 替换为 cp。显存分配、线程网格划分与内核启动均在底层自动完成:
import cupy as cp

# 在 GPU 显存中直接创建坐标网格
x = cp.linspace(-3.0, 3.0, 4096, dtype=cp.float32)
y = cp.linspace(-3.0, 3.0, 4096, dtype=cp.float32)
xx, yy = cp.meshgrid(x, y)

alpha = 0.5
# 向量化算子调用:底层触发 CUDA 预编译复合算子
zz = cp.exp(-alpha * (xx**2 + yy**2))

# 如果需要将结果回传到 CPU 主机内存:
host_result = cp.asnumpy(zz)
这种模式代码量极少,适合绝大多数常规矩阵运算。但如果算法中包含无法向量化的特殊条件分支或局部迭代,单纯依赖 CuPy 的全局算子会导致多次启动 GPU 内核并产生临时显存变量。
2. Numba 实现:装饰器驱动的纯 Python 核函数
使用 Numba 时,开发者以标量计算的视角书写单个线程的行为,并显式利用 cuda.grid(2) 计算当前线程所负责的二维数据索引:
import numpy as np
from numba import cuda
import math

# 使用 @cuda.jit 声明 GPU 核函数
@cuda.jit
def decay_kernel(x, y, z, alpha):
    i, j = cuda.grid(2)
    n_rows, n_cols = z.shape
    if i < n_rows and j < n_cols:
        dist_sq = x[j] * x[j] + y[i] * y[i]
        z[i, j] = math.exp(-alpha * dist_sq)

# 准备数据并显式搬运到 GPU 显存
h_x = np.linspace(-3.0, 3.0, 4096, dtype=np.float32)
h_y = np.linspace(-3.0, 3.0, 4096, dtype=np.float32)
d_x = cuda.to_device(h_x)
d_y = cuda.to_device(h_y)
d_z = cuda.device_array((4096, 4096), dtype=np.float32)

# 配置执行网格 (Block 与 Grid 尺寸)
threads_per_block = (16, 16)
blocks_per_grid_x = math.ceil(d_z.shape[0] / threads_per_block[0])
blocks_per_grid_y = math.ceil(d_z.shape[1] / threads_per_block[1])
blocks = (blocks_per_grid_x, blocks_per_grid_y)

# 启动 GPU 核函数
decay_kernel[blocks, threads_per_block](d_x, d_y, d_z, 0.5)

# 同步并拷回 CPU 主机
result = d_z.copy_to_host()
Numba 的核心优势在于将内存访问合并(Memory Coalescing)和共享显存的优化主动权交还给开发者,同时保持代码可读性,无需配置外部 C++ 编译环境。
3. PyCUDA 实现:内联 C++ CUDA 源码与 Driver API
在 PyCUDA 中,算法内核是以 C++ 字符串形式编写的,运行时由 SourceModule 调用 nvcc 编译成二进制模块:
import numpy as np
import pycuda.autoinit
import pycuda.driver as cuda
from pycuda.compiler import SourceModule

# 定义原生 C++ CUDA 核函数字符串
mod = SourceModule("""
__global__ void decay_kernel(const float *x, const float *y, float *z, float alpha, int n) {
    int i = blockIdx.y * blockDim.y + threadIdx.y;
    int j = blockIdx.x * blockDim.x + threadIdx.x;
    if (i < n && j < n) {
        float dist_sq = x[j] * x[j] + y[i] * y[i];
        z[i * n + j] = expf(-alpha * dist_sq);
    }
}
""")

h_x = np.linspace(-3.0, 3.0, 4096, dtype=np.float32)
h_y = np.linspace(-3.0, 3.0, 4096, dtype=np.float32)
h_z = np.empty((4096, 4096), dtype=np.float32)

# 获取核函数句柄并以底层显存指针执行
func = mod.get_function("decay_kernel")
block_dim = (16, 16, 1)
grid_dim = ((4096 + 15) // 16, (4096 + 15) // 16)

# 借助 In/Out 辅助原语完成自动分配与传输
func(cuda.In(h_x), cuda.In(h_y), cuda.Out(h_z), np.float32(0.5), np.int32(4096),
     block=block_dim, grid=grid_dim)
PyCUDA 允许直接使用 CUDA 独有的底层内建函数(如 __syncthreads()、原子操作 atomicAdd 以及 PTX 内联汇编)。如果你已经有成熟的 .cu 文件,PyCUDA 是在 Python 中将其驱动起来的最快路径。
三、自定义算子开发与执行步骤
无论是使用 Numba 还是 PyCUDA 进行自定义核函数开发,其工程化流程均遵循清晰的生命周期:从线程坐标拓扑设计,到显存连续性校验,再到执行流水线调度与结果同步。
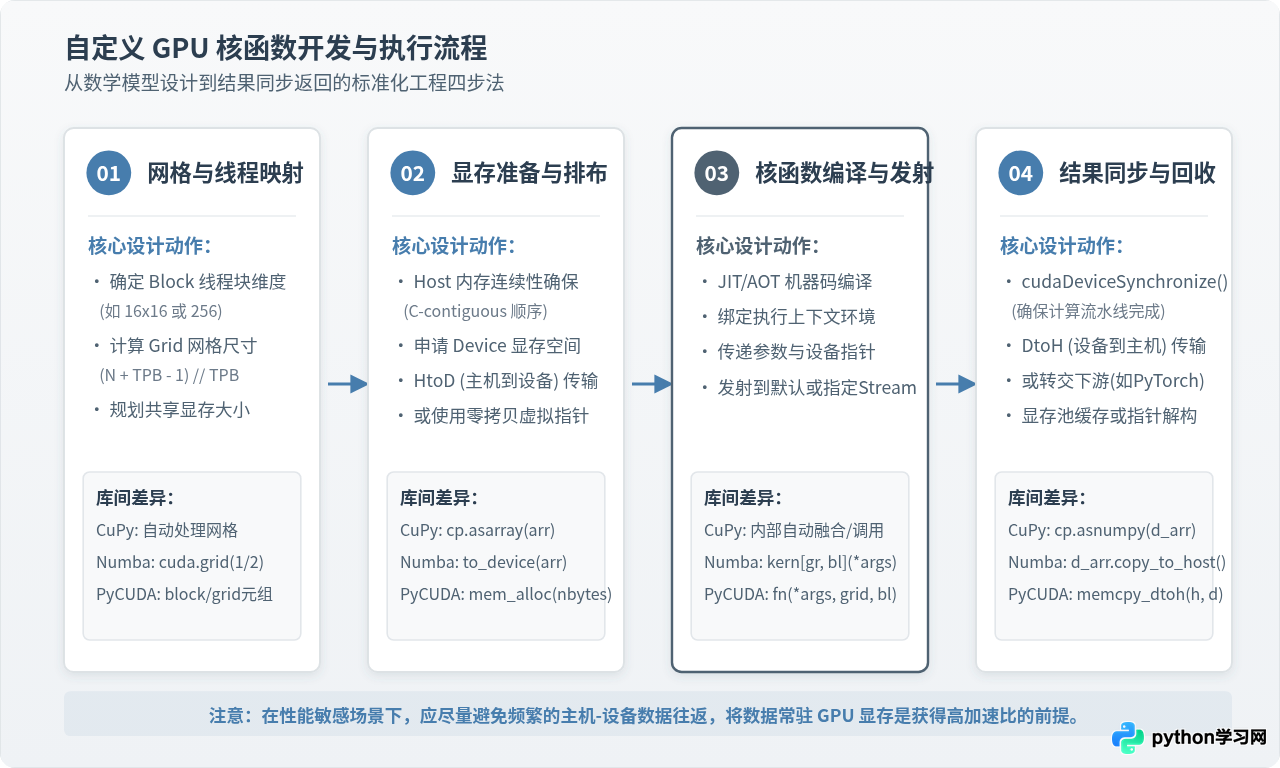
在实际操作中,最容易被忽视的步骤是显存数据的内存连续性(Memory Contiguity)。在向 GPU 发射核函数前,必须确保输入的 NumPy 数组是按 C 语言格式连续存储的(np.ascontiguousarray(a))。如果传入了经过步幅切片(Strided Slice)的非连续内存块,GPU 线程在解算线性偏移时会出现越界访问或数据错位。
四、显存管理机制与跨库数据交互
GPU 计算的瓶颈往往不在算力,而在 PCIe 总线传输带宽与显存分配延迟。因此,理解三个库对显存的处理方式至关重要。
1. 显存分配策略的深层差异
- CuPy 的内存池(Memory Pool):标准的
cudaMalloc和cudaFree是耗时极长的同步操作。CuPy 默认启用自研的显存池,当某个数组被释放时,其显存并不会归还给操作系统,而是保留在池中等待下一次复用。这在高频创建临时矩阵的迭代算法中能够带来数倍的吞吐提升。 - Numba 的统一内存(Unified Memory):Numba 提供了对 CUDA UVA(统一虚拟寻址)的原生支持,通过
cuda.managed_array分配的内存由系统驱动在 CPU 与 GPU 之间按需自动迁移(Page Fault 机制),非常适合显存容量受限或不想手动管理to_device的探索性实验。 - PyCUDA 的 Driver 原语:PyCUDA 提供最透明的
cuda.mem_alloc,返回一个包装了裸设备指针的DeviceAllocation对象。当其引用计数归零时,析构函数触发cuMemFree。但需注意,在涉及 Python 多线程并发时,必须严格配合cuda.Context.push()和pop()管理上下文状态,否则会引发静默段错误。
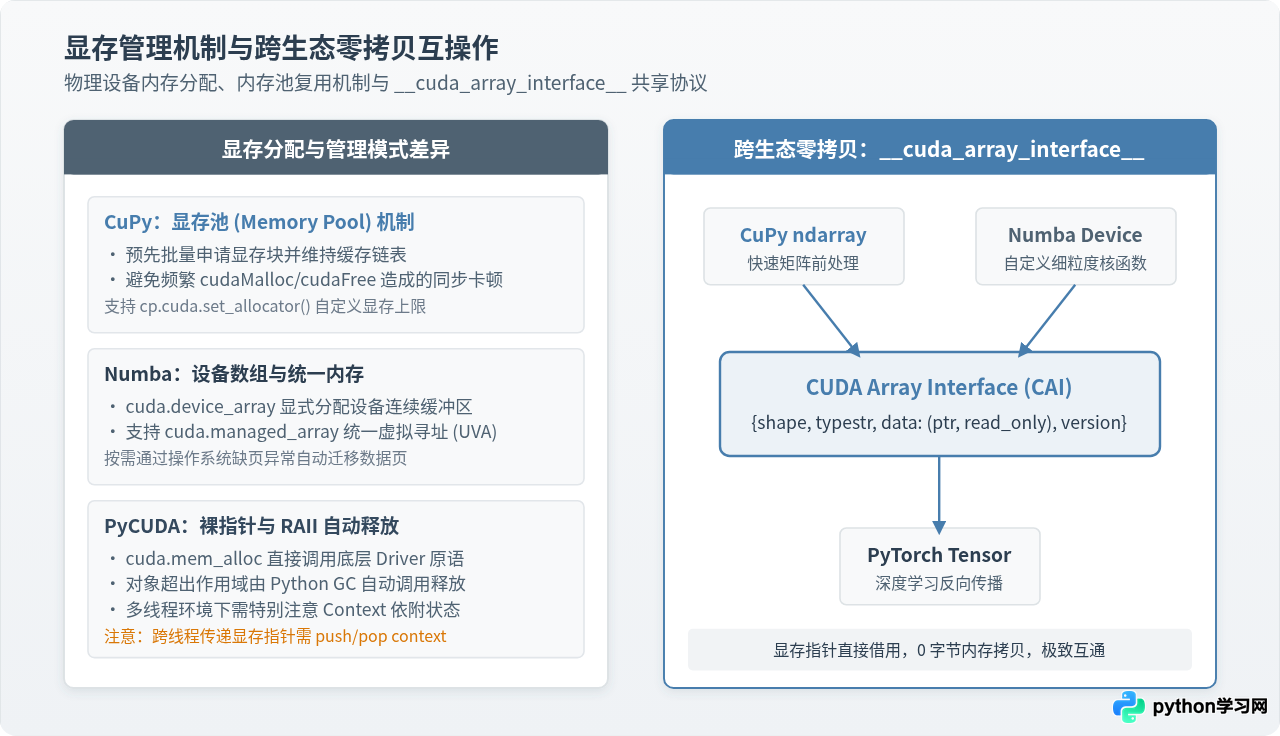
2. 零拷贝互操作:__cuda_array_interface__
在现代 Python 科学计算栈中,我们往往希望“组合搭配”:例如用 CuPy 快速做快速傅里叶变换(FFT),随后将中间矩阵直接交给 Numba 的手写核函数做复杂滤波,最后无缝传递给 PyTorch 进行模型反向传播。如果每次交接都要通过 CPU 内存中转,性能损耗将不可承受。
当前主流生态普遍遵循由 Numba 社区发起的 __cuda_array_interface__(简称 CAI 规范)。任何实现了该接口的对象都会暴露一个轻量字典,包含当前显存指针地址(data: (ptr, read_only))、形状(shape)与类型字符串(typestr)。利用这个机制,无需任何显存拷贝,指针即可在库之间直接借用:
import cupy as cp
from numba import cuda

# 1. 在 CuPy 中分配并做前处理
cp_arr = cp.ones((1024, 1024), dtype=cp.float32) * 2.0

# 2. 零拷贝封装为 Numba DeviceArray (耗时通常小于 5 微秒)
nb_arr = cuda.as_cuda_array(cp_arr)

# 3. 直接传入 Numba 自定义核函数中修改内容
# 对 nb_arr 的原地修改会立即反映在 cp_arr 上,两者的底层显存地址完全相同
五、综合选型维度与避坑指南
为了帮助开发者根据项目实际情况快速确定技术路线,下表从六个关键工程维度对三个库进行了横向评测:
| 评测维度 | CuPy | Numba (numba.cuda) | PyCUDA |
|---|---|---|---|
| 学习曲线 | 极低(熟练使用 NumPy 即可上手) | 中等(需理解 GPU 网格与线程模型) | 较高(需熟练掌握 C/C++ CUDA 语法) |
| 开发效率 | 极高(算子开箱即用,代码量极少) | 高(纯 Python 语法,无需 C++ 编译) | 中等(需维护 C++ 字符串及类型匹配) |
| 自定义细粒度算法能力 | 较弱(复杂循环需依赖 ElementwiseKernel 拼接) | 极强(支持灵活分支、共享内存与原子操作) | 极致(支持任意原生 CUDA C++ 特性与内联汇编) |
| 主机编译链依赖 | 无需系统编译器(提供预编译 wheel 包) | 无需系统 nvcc(内建 NVVM 编译链路) | 强依赖系统安装的完整 nvcc 与 C++ 编译器 |
| 显存管理便利性 | 全自动显存池,无需手动介入 | 提供统一内存与 DeviceArray,半自动化 | 需显式管理指针与 Context 状态 |
| 生态兼容性 | 支持 CAI,可与 PyTorch/JAX 零拷贝互通 | 支持 CAI,可与 CuPy/PyTorch 零拷贝互通 | 提供基础指针接口,需手动封装转换为张量 |
- Numba 的 Python 语法子集限制:在
@cuda.jit修饰的函数体内部,不能调用 Python 的内置列表创建、字符串格式化、字典操作或标准库函数。核函数内部仅支持基本标量数学运算与局部数组索引。 - CuPy 小算子链式发射开销:如果连续执行数十个小型标量表达式(如
a = b + c; d = a * 2; e = d - 1),虽然每次运算都在 GPU 上执行,但反复从 CPU 发射核函数会带来明显的 Driver 开销。此时应使用cupy.fuse()装饰器将多个小算子融合成单一核函数。 - PyCUDA 多线程 Context 污染:CUDA 驱动 API 的上下文是线程绑定的。在 Python 的多线程任务或 Celery Worker 中调用 PyCUDA 时,如果未在子线程中显式调用
ctx.push(),程序会抛出CUDA_ERROR_INVALID_CONTEXT异常。
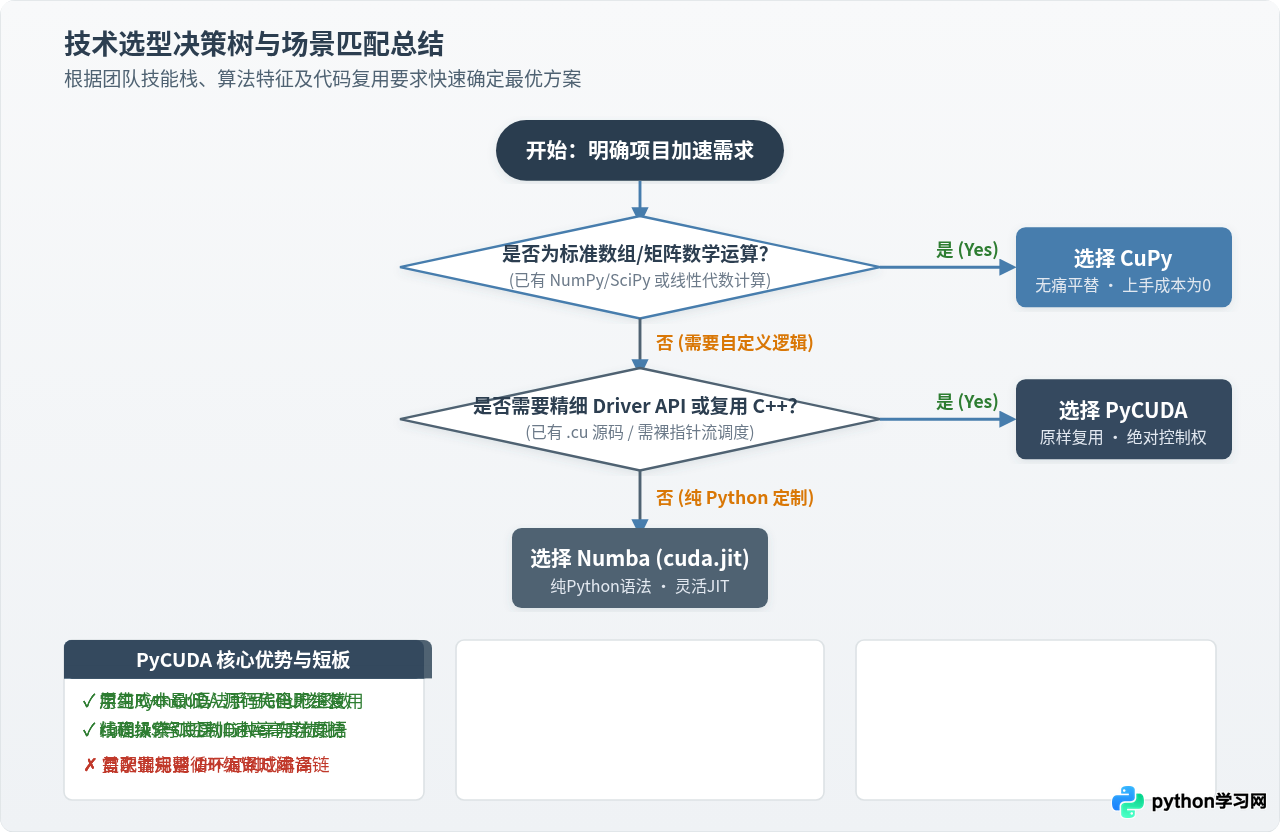
六、明确的选择路径
根据团队现状与项目目标,按照以下优先级进行选择:
- 第一选择(优先默认):如果你的代码逻辑可以通过矩阵、向量、切片和张量广播表达,或者项目目标是对现有数据分析流程加速,坚决使用 CuPy。你将以最小的代码侵入性和近乎为零的学习成本,获得 NVIDIA 官方优化库的极致加速。
- 第二选择(算法特化):如果你要实现的算法包含复杂的物理模拟网格更新、图遍历、局部卷积或非规则迭代,无法被标准矩阵算子向量化表达,同时你希望团队保持统一的纯 Python 技术栈,选用 Numba。利用
cuda.jit编写专用核函数,并配合__cuda_array_interface__与 CuPy 协同工作。 - 第三选择(系统级集成与 C++ 复用):如果你手头已有经过充分验证的高性能 C/C++ CUDA 核函数代码库,需要将其封装暴露给上层 Python 流水线,或者需要使用最新的 GPU 硬件指令、纹理内存(Texture Memory)或复杂的 CUDA Driver 原语,选用 PyCUDA。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









