

Python浮点数取余精度问题及math.fmod用法
深入解析 Python 浮点数取余中 5.5 % 1.1 不为 0 的精度问题根源,对比内置运算符 % 与 math.fmod 的数学机制、正负符号差异,并给出 3 种工业级高精度解决方案。
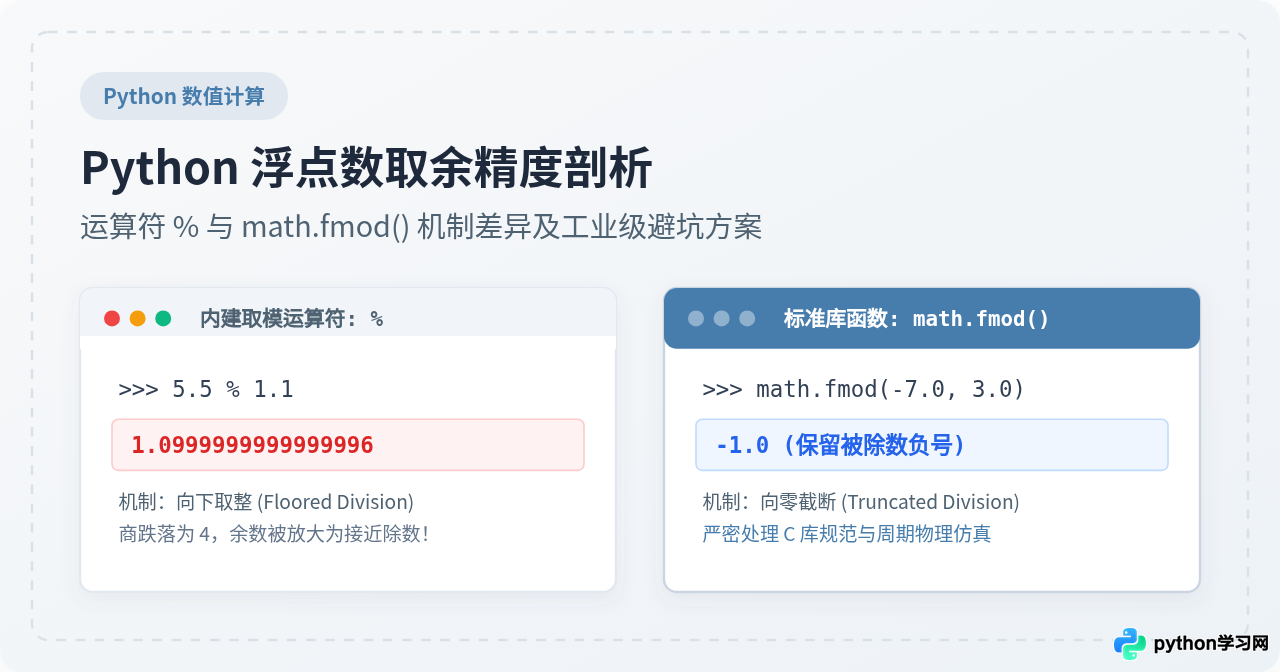
5.5 % 1.1 的计算结果不是 0.0,而是 1.0999999999999996;1.0 % 0.1 结果为 0.09999999999999995。许多人误以为标准库的 math.fmod() 是为了修正这种浮点精度而设计的,但传入同样的值后发现残差依然存在。本文将讲清浮点取余精度问题的物理根源——IEEE 754 浮点二进制表示与商取整的阶跃雪崩效应,拆解 Python 内置运算符 % 与 math.fmod 的数学定义与符号规则差异,并给出 3 种生产环境下可靠的解决方案。
现象与实测:浮点取余为何“看似失效”?
在日常开发中,我们常常使用取模(取余)操作来判断步长、分箱区间或检查整除性。对于整数,Python 的行为非常符合预期;然而,一旦操作数中包含浮点数,结果就可能出现令人困惑的偏差。
在 Python 交互式环境中执行以下测试,可以观察到两类典型的异常现象:
>>> # 现象一:明明能整除,余数却无限接近除数自身
>>> 5.5 % 1.1
1.0999999999999996
>>> 1.0 % 0.1
0.09999999999999995

>>> # 现象二:接近整除时产生微小的机器残差
>>> 2.1 % 0.7
2.220446049250313e-16
在数学逻辑上,5.5 恰好是 1.1 的 5 倍,余数理应严格为 0;1.0 是 0.1 的 10 倍,余数也应当为 0。但 Python 却输出了几乎等于除数的数值。如果程序中包含 if (5.5 % 1.1) == 0: 这类整除分支判断,条件将直接判定为 False,进而引发难以察觉的业务隐患。
有些开发者查阅 Python 官方文档时,看到关于 math.fmod() 的说明:“当处理浮点数时,通常更推荐使用 math.fmod()”。但如果你尝试直接用 math.fmod 来“解决”上述问题,结果会令人大失所望:
>>> import math
>>> math.fmod(5.5, 1.1)
1.0999999999999996
>>> math.fmod(1.0, 0.1)
0.09999999999999995结果完全没有改变。这说明:math.fmod() 的诞生根本不是用来消除二进制浮点表示误差的。要彻底理解这一问题,必须从两者的底层运算推导链路谈起。
根源深究:二进制存储与商取整的“雪崩效应”
为什么 5.5 % 1.1 没有得到 0.0,而是得到了 1.0999999999999996?这个看似诡异的数值并非 Python 的软件缺陷,而是现代计算机遵循 IEEE 754 双精度浮点标准时的物理必然。我们可以将整个运算拆解为三个微观阶段:
第一阶段:十进制小数到二进制表示的微小截断
在十进制下,5.5 可以写成 $5 + 1/2 = 2^2 + 2^0 + 2^-1$,对应二进制为有限小数 101.1,因此 5.5 在计算机内部能够被完全精确地存储。
然而,1.1 在二进制下是一个无法整除的无限循环小数:
1.1 (十进制) = 1.000110011001100110011... (二进制无限循环)IEEE 754 双精度浮点数只有 53 位二进制尾数(约 15~17 位有效十进制数字),多余的位数只能进行舍入截断。截断后,内存中实际存储的并非绝对纯净的 1.1,而是一个稍微偏大的数值:
1.100000000000000088817841970012523233890533447265625第二阶段:浮点除法运算的微小下溢
当执行除法时,分子是精确的 5.5,分母是微大于 1.1 的数值。由于“分母偏大,商必偏小”,真除法计算出来的理论值不再是 5.0,而是一个无穷接近 5 但严格小于 5 的数字:
5.5 / 1.1000000000000000888... = 4.99999999999999911182158029987476...注意,这个商与理想值 5 仅仅相差了不到 $10^{-15}$,属于机器精度极限内的合理漂移。
第三阶段:整数化取整阶段的“阶跃断崖”
取模运算的核心公式是:先求商的整数部分,再计算余数 $r = x - q imes y$。无论是运算符 % 所采用的向下取整 floor(),还是 math.fmod() 所采用的向零截断 trunc(),由于 4.9999999999999991 严格小于 5,取整结果毫无悬念地变成了 4!
这一步发生了质的突变:一个只有 $10^{-16}$ 量级的微小表示偏差,在整数化断崖处直接导致商被扣除了整整 1 个单位。随后进行余数回乘相减:
r = 5.5 - 4 * 1.1 = 5.5 - 4.4 = 1.1 (浮点存储为 1.0999999999999996)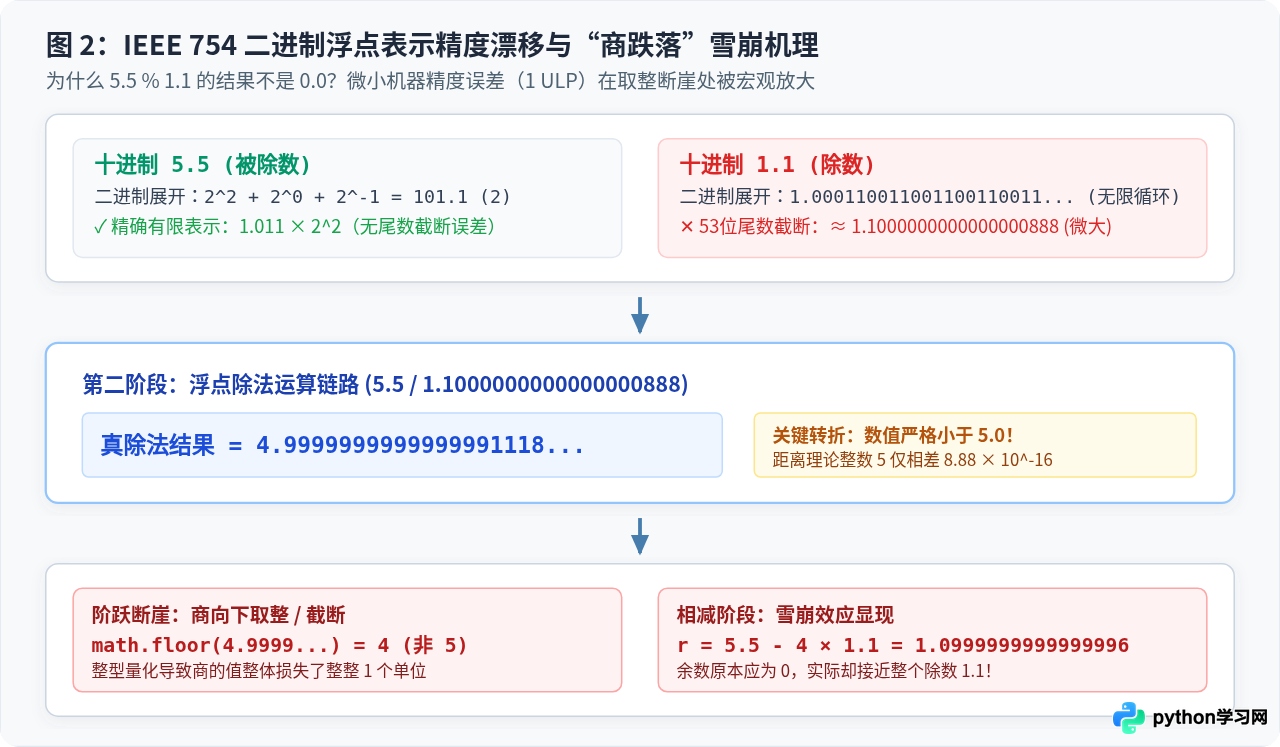
机制剖析:Python % 与 math.fmod 的核心差异
既然 math.fmod 也不能消除二进制浮点表示误差,那为什么官方文档依然强调“对于浮点数,通常推荐 math.fmod()”?它们两者的真正区别究竟是什么?
答案在于两点:取整策略与正负符号规则。
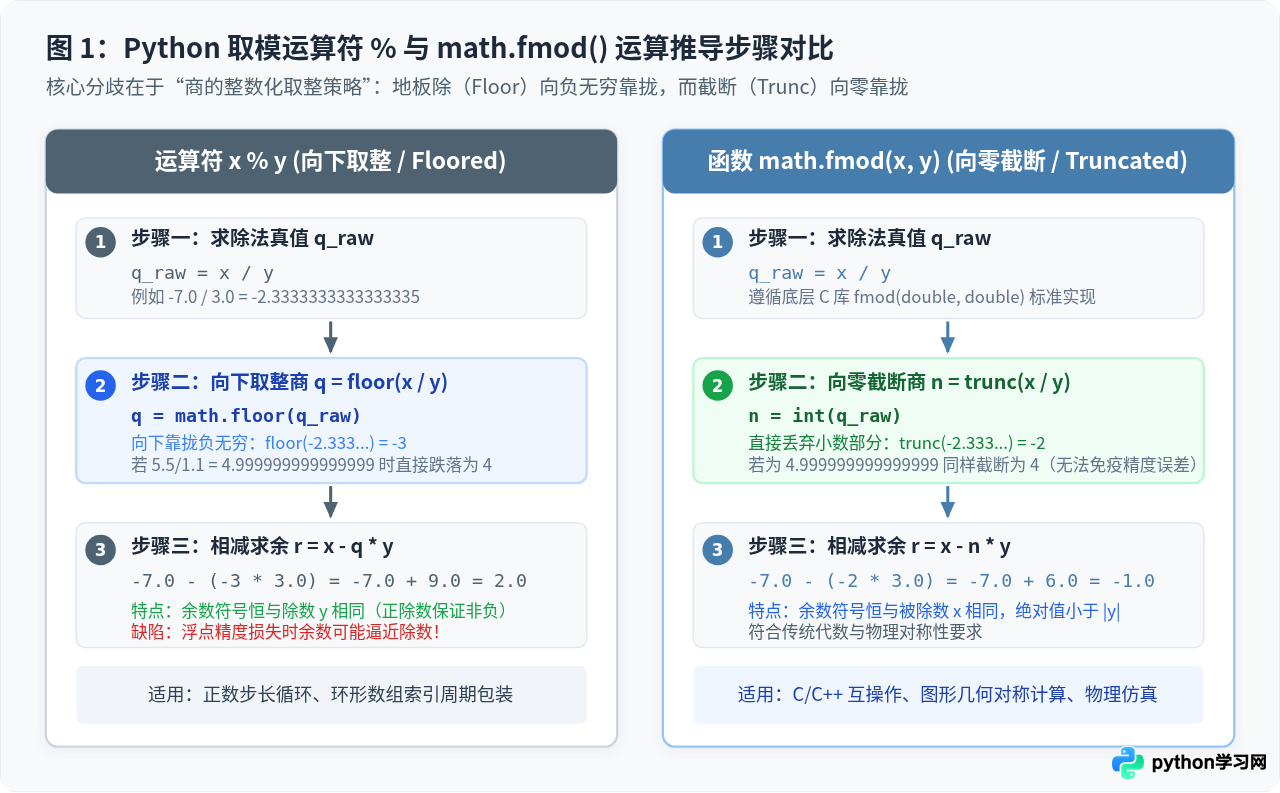
1. 数学定义对比
- Python 运算符
x % y:采用高德纳(Donald Knuth)倡导的地板除(Floored Division)。商定义为 $q = \lfloor x / y floor$(向下取整,朝负无穷方向靠拢)。余数满足:余数的符号永远与除数 $y$ 保持一致(若余数不为零)。 - 标准库函数
math.fmod(x, y):封装自标准 C 语言数学库函数fmod(double x, double y),遵循 IEEE 754 规定的向零截断除法(Truncated Division)。商定义为 $n = ext{int}(x / y)$(直接截断小数部分,朝零靠拢)。余数满足:余数的符号永远与被除数 $x$ 保持一致,且其绝对值严格小于 $|y|$。
2. 四种正负号组合完整测试
由于这两种取整机制在正数区间表现一致,只有当输入包含负数时,分歧才会彻底展现。我们可以通过一个典型的测试矩阵直观对比:
| 测试输入 (x, y) | 商真值 (x / y) | Python % 结果 | math.fmod() 结果 | 差异说明 |
|---|---|---|---|---|
(7.0, 3.0) |
+2.3333 |
1.0 相同 |
1.0 相同 |
同为正数,向下取整与向零截断商均为 2,余数相同 |
(-7.0, 3.0) |
-2.3333 |
2.0 随除数 +3.0 |
-1.0 随被除数 -7.0 |
% 的商为 -3,余数为正;fmod 商为 -2,余数保持负号 |
(7.0, -3.0) |
-2.3333 |
-2.0 随除数 -3.0 |
1.0 随被除数 +7.0 |
% 的商为 -3,余数随除数变负;fmod 商为 -2,余数保持正号 |
(-7.0, -3.0) |
+2.3333 |
-1.0 相同 |
-1.0 相同 |
商为正数,两者商均为 2,余数符号重新对齐 |
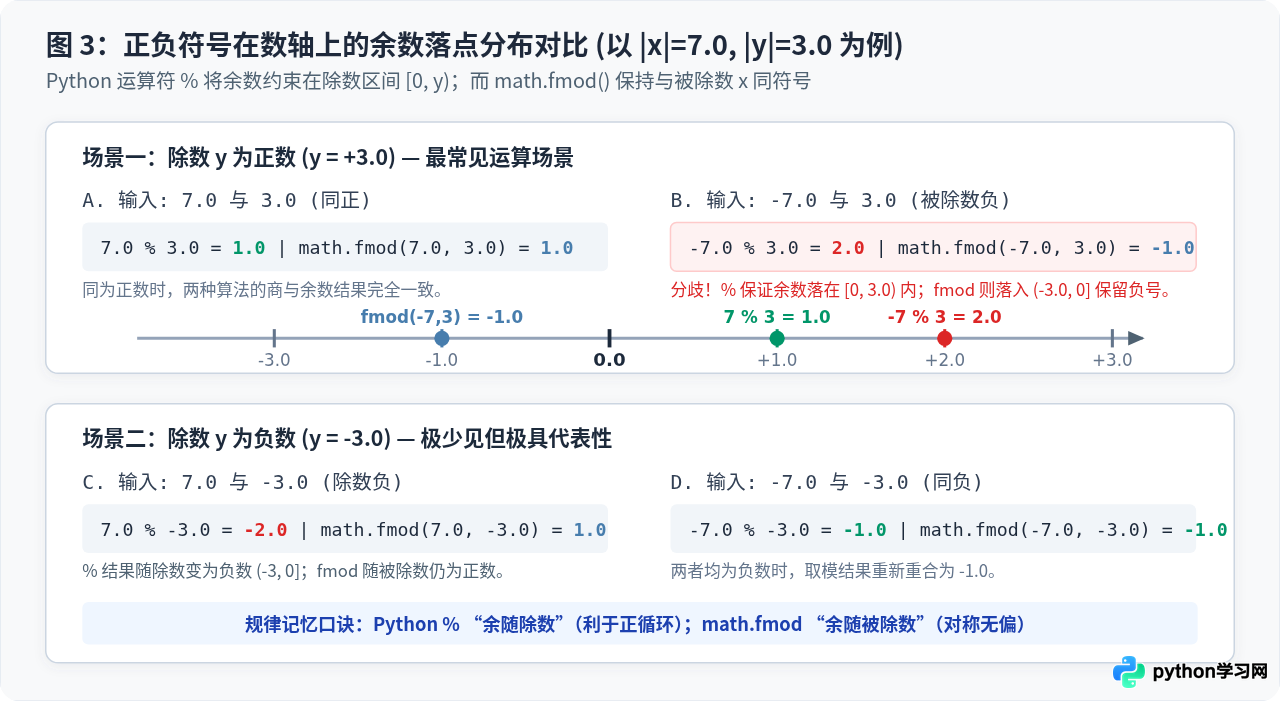
为什么 Python 会把 % 设计为“随除数符号”?
在计算机科学中,取模运算最核心的用途之一是周期性循环与环形数组包装。例如在时间计算或索引轮转时,我们希望将任意实数 $x$ 映射到长度为 $T$ 的区间内。当除数 $T > 0$ 时,Python 的 % 能严格保证计算结果落在 $[0, T)$ 半开区间内,哪怕传入负坐标也可以自动平滑循环:
# 无论 index 是正数还是负数,结果恒为有效的数组索引 0, 1, 2
arr = ['A', 'B', 'C']
assert arr[-1 % 3] == arr[2]  # -1 % 3 = 2,自然对应数组倒数第一个元素
但对于物理学模拟、音频信号处理、几何对称计算或调用底层 C/C++ 动态链接库时,工程师通常要求运算关于原点中心对称(即 $f(-x) = -f(x)$)。此时若使用 %,负坐标会被强行折叠到正数端,破坏了对称性,而 math.fmod 则忠实地满足这一物理直觉。
工程级解决方案:如何安全处理浮点数取余?
明确了问题的物理根源与设计初衷后,针对实际项目中“浮点数取余精度丢失”的隐患,可以采取以下 3 种工程级应对方案:
方案一:采用标准库 decimal.Decimal 进行真十进制计算
如果业务场景涉及金融货币结算、电表计费、固定阶梯计价或严格的规约检验,绝不能使用 IEEE 754 原生二进制浮点数,而应当使用 Python 内置的高精度十进制模块 decimal:
from decimal import Decimal

# 注意:必须传入字符串或直接使用字符串字面量构建 Decimal
# 若写成 Decimal(5.5),浮点误差在传入前就已经发生
a = Decimal('5.5')
b = Decimal('1.1')

rem = a % b
print(f"Decimal 取余结果: {rem}")  # 输出精确的 0.0
print(f"是否能整除: {rem == Decimal('0.0')}") # TrueDecimal 模块在软件层模拟了十进制的算术运算,能够彻底规避 0.1、1.1 在二进制下循环不尽的物理问题,是金融级精确计算的唯一标准解法。
方案二:按比例缩放为纯整数取余
如果计算处于高频循环(如游戏物理引擎、图形栅格化渲染),无法承受 Decimal 对象的性能开销,但运算步长具有明确的最小精度刻度(如已知保留 2 位或 3 位小数),可以将数值放大为整数后使用整数取模:
def scaled_mod(x: float, y: float, decimals: int = 4) -> float:
    factor = 10 ** decimals
    int_x = round(x * factor)
    int_y = round(y * factor)
    return (int_x % int_y) / factor

# 测试验证
print(scaled_mod(5.5, 1.1))  # 0.0
print(scaled_mod(1.0, 0.1))  # 0.0
print(scaled_mod(5.75, 1.25, decimals=2))  # 0.75
这种方法保持了 C 级别的原生整数执行速度,同时完全避开了浮点商截断的阶跃陷阱。
方案三:引入绝对容差阈值的近零修正(math.isclose)
如果输入是连续的测量值或科学计算结果,小数位数并不固定,我们不能盲目做等值判断 rem == 0.0,而应当封装一个具备容差修正的安全取模函数:
import math

def safe_float_mod(x: float, y: float, tol: float = 1e-9) -> float:
    """
    具备容差修复的安全浮点取余:
    当余数接近 0 时自动归零;当余数接近除数 y 时修正为 0
    """
    rem = math.fmod(x, y)

    # 情况一:余数极其微小(接近 0)
    if math.isclose(rem, 0.0, abs_tol=tol):
        return 0.0

    # 情况二:发生商跌落,余数极其接近除数 y(或 -y)
    if math.isclose(abs(rem), abs(y), abs_tol=tol):
        return 0.0

    return rem

# 结果对比
print("原生 % 结果:      ", 5.5 % 1.1)            # 1.0999999999999996
print("安全函数修正后:   ", safe_float_mod(5.5, 1.1))  # 0.0
print("非整除正常情况:   ", safe_float_mod(5.8, 1.1))  # 0.3000000000000007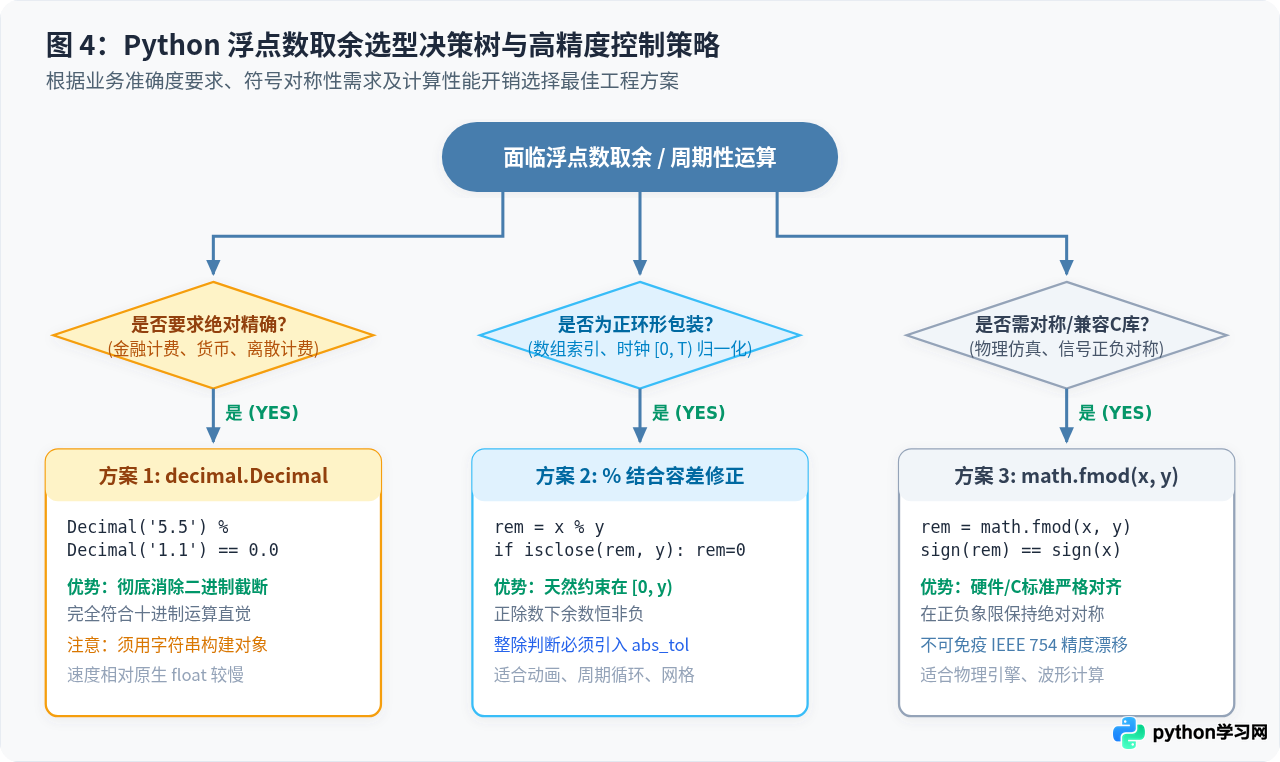
选型指南与常见误区总结
为了在实际开发中快速做出准确的技术选型,可参照下表进行权衡:
| 方案 / 语法 | 符号特征 | 能否免疫 5.5 % 1.1 精度误差? | 典型适用场景 | 性能开销 |
|---|---|---|---|---|
Python % |
余数符号随除数 $y$ | 不能 | 环形数组、时钟循环周期包装、确保非负区间 | 极低 (原生指令) |
math.fmod() |
余数符号随被除数 $x$ | 不能 | C 库对接、物理引擎、关于零点中心对称算法 | 极低 (C 动态库调用) |
decimal.Decimal |
十进制严格准确 | 能彻底解决 | 银行/电商计费、离散定价步长、严格业务校验 | 较高 (软件模拟) |
| 整型放大缩放 | 依整数规则 | 能彻底解决 | 已知固定小数位的网格坐标、动画帧步长 | 极低 |
isclose 容差修正 |
支持自定义规则 | 修正至 0.0 | 科学工程计算、几何连续测量、通用浮点防护 | 低 |
math.fmod解决的是与 C 语言符号规则统一和对称除法标准的问题,并不是用来处理 IEEE 754 精度漂移的。- 只要涉及浮点数的整除判断,严禁直接使用
rem == 0.0,必须通过容差比较math.isclose()或整型缩放进行防御。 - 对精度要求极高的业务,从数据输入源头就应当全面切换为
decimal.Decimal。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









