

Python怎么批量将列表或DataFrame中的大写字母转小写
详细讲解在Python中批量将列表元素、Pandas DataFrame列名及单元格文本由大写字母转换为小写的具体实现方法、容错机制与工程注意事项。
df.columns.str.lower() 赋值,处理单个文本列采用向量化的 .str.lower(),而对整表或多列混合数据批量转换时,则推荐使用 df.map() 结合自定义类型安全判断。
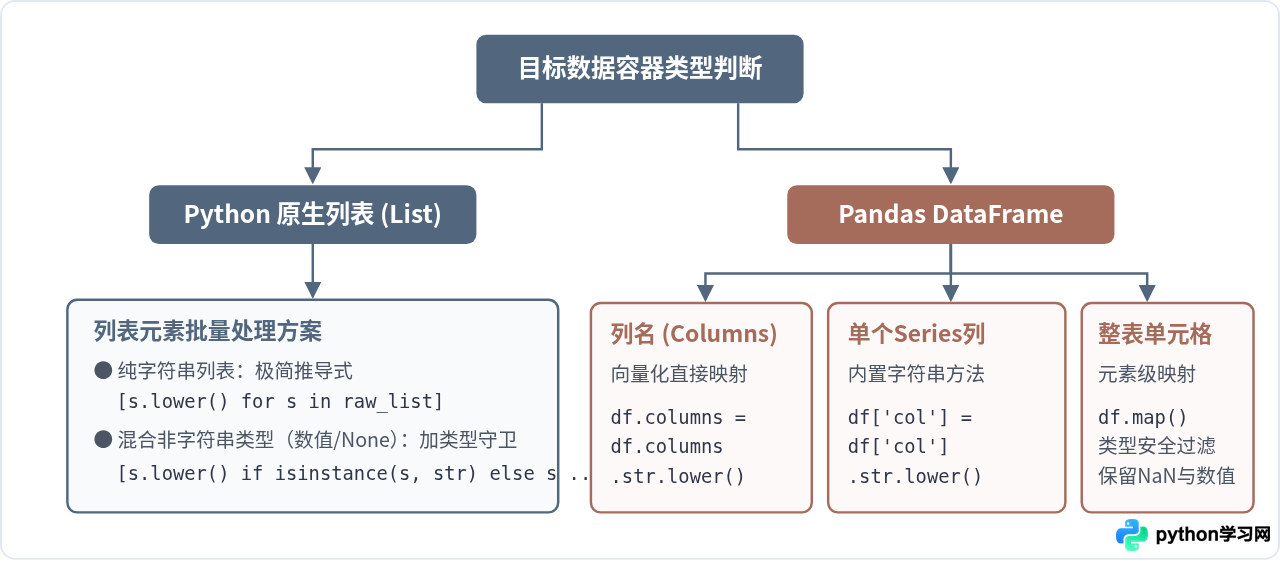
一、列表(List)批量转小写的实现与容错
在纯 Python 环境中,列表本身没有内置像 Pandas 那样的向量化属性。将列表里的字符串大写字母转小写,核心在于对列表内的每个元素调用原生 str.lower()。但在工程实践中,列表元素的纯度决定了代码的健壮性。
1. 纯字符串列表:列表推导式
如果确定列表中全部是合法的字符串类型,使用列表推导式(List Comprehension)是语法最简洁、执行速度最快的方式。
# 纯字符串输入列表
words = ["PYTHON", "DATA_FRAME", "JUPYTER", "HTML5"]

# 列表推导式快速转换
lower_words = [item.lower() for item in words]

print(lower_words)2. 包含非字符串元素的混合列表:安全类型守卫
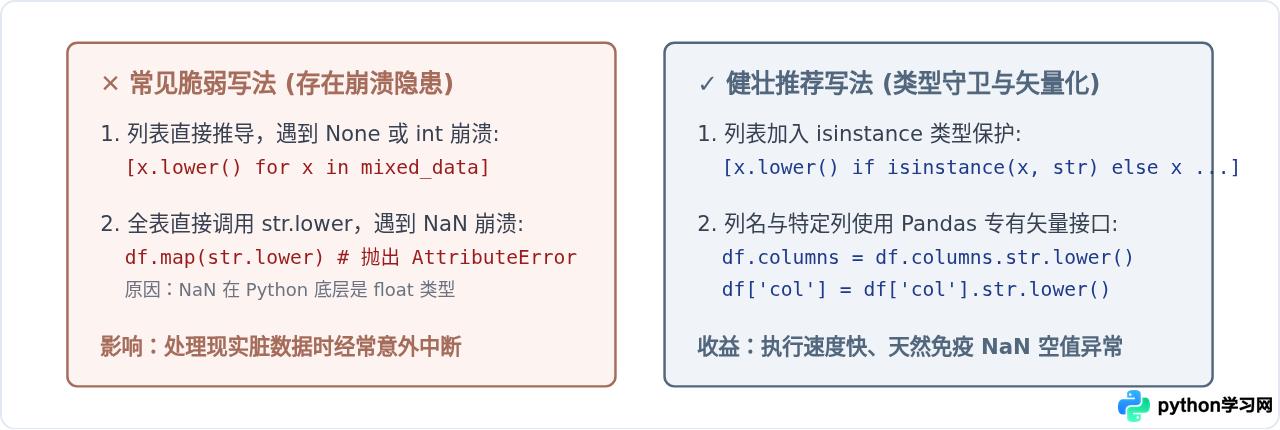
真实场景(如解析日志、CSV 文件或接口返回数据)中,列表可能混杂了数字(int/float)、布尔值或 None。如果对非字符串对象直接调用 .lower(),程序会立刻抛出 AttributeError: 'int' object has no attribute 'lower'。
为此,必须在推导式中加入 isinstance(item, str) 三元表达式,仅对字符串执行转换,其他类型保持原样:
# 包含数字、空值与字符串的混合列表
mixed_list = ["SERVER_A", 1024, None, "SUCCESS", True]

# 增加类型判断,确保非字符串元素不抛出异常
safe_lower_list = [item.lower() if isinstance(item, str) else item for item in mixed_list]

print(safe_lower_list)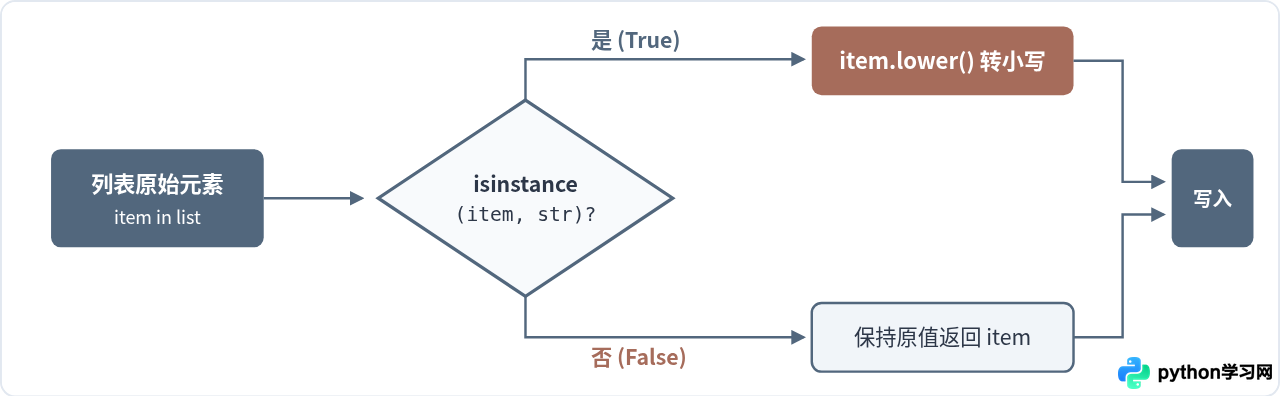
二、DataFrame 列名与索引批量转小写
在进行数据建模或 SQL 入库时,字段名大小写不一致经常导致键错误。Pandas 的 Index 对象(包括 df.columns 与 df.index)自带 .str 属性访问器,提供了极其优雅的矢量化处理能力。
1. 直接通过 .str.lower() 重新赋值列名
这是最常见也最高效的写法。通过 df.columns.str.lower() 可以在内存中直接生成小写索引对象并一次性重赋给数据帧:
import pandas as pd

# 创建示例数据
df = pd.DataFrame({
    'USER_ID': [101, 102],
    'USER_NAME': ['ALICE', 'BOB'],
    'USER_ROLE': ['ADMIN', 'GUEST']
})

# 批量将所有列名转为小写
df.columns = df.columns.str.lower()

print(df.columns.tolist())2. 使用 rename(columns=str.lower) 进行链式调用
如果你在写连续的数据管道(Pipeline)或希望返回一个全新的 DataFrame 副本而不修改原对象,推荐使用 df.rename():
# 通过函数引用实现列名小写转换
df_clean = df.rename(columns=str.lower)
如果 DataFrame 的行标签(Index)也包含大写字母(例如按日期或英文分类代码作为索引),完全可以使用相同的逻辑:df.index = df.index.str.lower()。
三、DataFrame 单元格内容批量转小写
处理 DataFrame 内部保存的具体数据内容时,情况比列表更为复杂,主要因为表格通常具有多列混合类型(整数、浮点数、布尔值及包含 np.nan 的缺失值)。
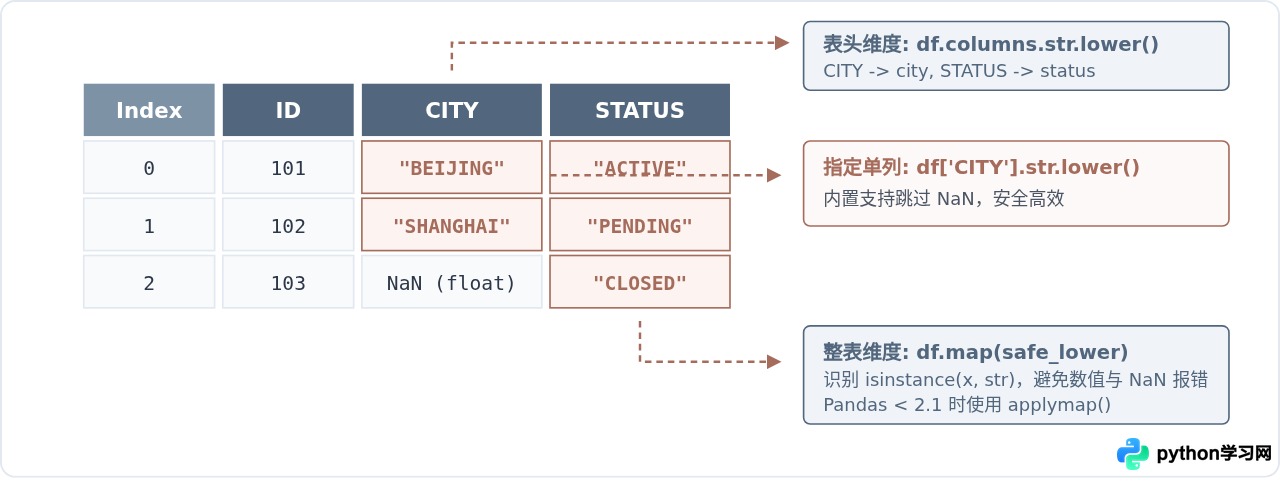
1. 针对单一文本列:使用内置向量化 .str.lower()
如果只需转换某一个特定列,直接使用 Series 的 .str.lower() 是最优解。不仅运行效率最高,而且它会自动保留缺失值(NaN),不会因为遇到空值而报错。
import numpy as np

# 包含 NaN 的示例列
df['CITY'] = ['BEIJING', 'SHANGHAI', np.nan]

# 单列转换为小写
df['CITY'] = df['CITY'].str.lower()

print(df['CITY'])1 shanghai
2 NaN
Name: CITY, dtype: object
2. 针对多个指定文本列:结合 apply()
当表格中存在多个文本列需要同时转小写时,可以筛选出列名列表,结合 .apply() 批量处理:
# 选定需要转小写的列
target_cols = ['CITY', 'STATUS']

# 批量执行向量化转换
df[target_cols] = df[target_cols].apply(lambda col: col.str.lower())
3. 针对整张表批量转换:使用 map() 与类型安全函数
如果希望对整张表的所有单元格进行批量遍历转换,注意不能直接调用 df.map(str.lower)。因为在 Pandas 中,缺失值 np.nan 的底层类型为 float,调用 float.lower() 会直接引发 AttributeError。
安全做法是编写一个防御性映射函数:
# 定义类型安全的转换函数
def safe_to_lower(val):
    if isinstance(val, str):
        return val.lower()
    return val

# 对全表单元格批量映射
# 注:Pandas 2.1.0 及以上版本使用 .map(),旧版本使用 .applymap()
df_lower = df.map(safe_to_lower)
四、避坑指南与核心方法总结
在进行批量大小写转换时,最容易出现的两个问题是:忽略了 Pandas 中的 NaN 是浮点数,以及未区分列名修改与单元格值修改的作用域。下表总结了各场景的最优推荐方案与风险点:
| 操作对象 | 核心实现代码 | 缺失值/异常处理机制 | 推荐指数 / 场景 |
|---|---|---|---|
| 普通列表 (纯字符串) | [s.lower() for s in lst] |
遇到 None 或数值会报错 | ★★★★★ 明确已知纯文本列表 |
| 混合类型列表 | [s.lower() if isinstance(s, str) else s for s in lst] |
安全跳过非字符串元素 | ★★★★★ 数据清洗通用防崩写法 |
| DataFrame 列名 | df.columns = df.columns.str.lower() |
直接覆盖列索引 | ★★★★★ 清洗字段名首选 |
| DataFrame 单列 | df['col'] = df['col'].str.lower() |
底层自动保留 NaN,不抛错 | ★★★★★ 针对具体文本列 |
| DataFrame 全表 | df.map(lambda x: x.lower() if isinstance(x, str) else x) |
防御 float (NaN) 及整数 | ★★★★☆ 全表纯文本或大范围清洗 |
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









