

怎么用Python批量将GBK编码文件转换为UTF-8
本文详细讲解如何使用Python批量将GBK或GB18030编码文件安全转换为UTF-8编码。从编码底层差异、递归目录扫描、预检防破坏到临时文件原子替换,提供完整可运行的代码与验证方案。
pathlib 递归扫描目标文件夹并筛选后缀;读取时优先采用超集编码 gb18030 解码为Python内部字符串,再以 utf-8 写入临时文件;最后通过系统级 os.replace 完成原子替换。这一做法兼顾了向下兼容生僻字与防止程序意外中断损坏原文件。
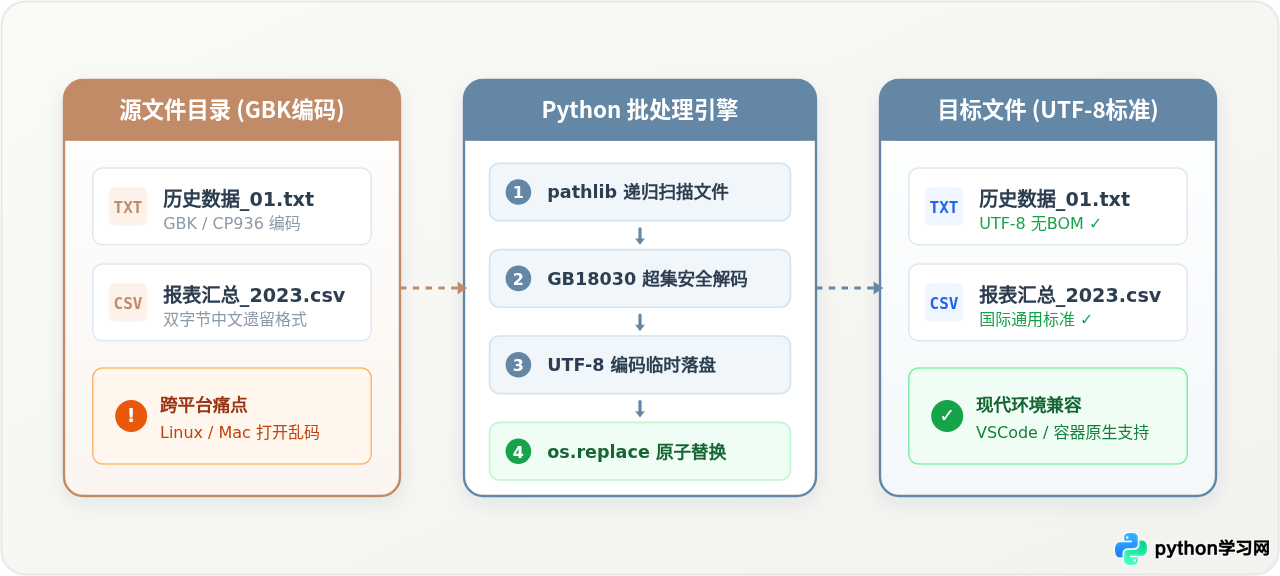
一、准备工作与编码选择:为何解码优先用 GB18030
在编写转码脚本之前,明确具体的中文编码标准是避免乱码和报错的关键前提。很多开发者在编写代码时习惯直接指定 encoding='gbk',但在处理大规模或来源复杂的历史文件时,极易遇到 UnicodeDecodeError: 'gbk' codec can't decode byte... 报错。
其根本原因在于汉字字符集的演进过程。GB2312 收录了 6763 个常用汉字;GBK 是其扩展,收录了 21003 个汉字;而 GB18030 则是中国国家强制标准,不仅完全向下兼容 GBK 和 GB2312,还收录了超过 70000 个汉字(包含大量少数民族文字、人名生僻字和古籍用字)。
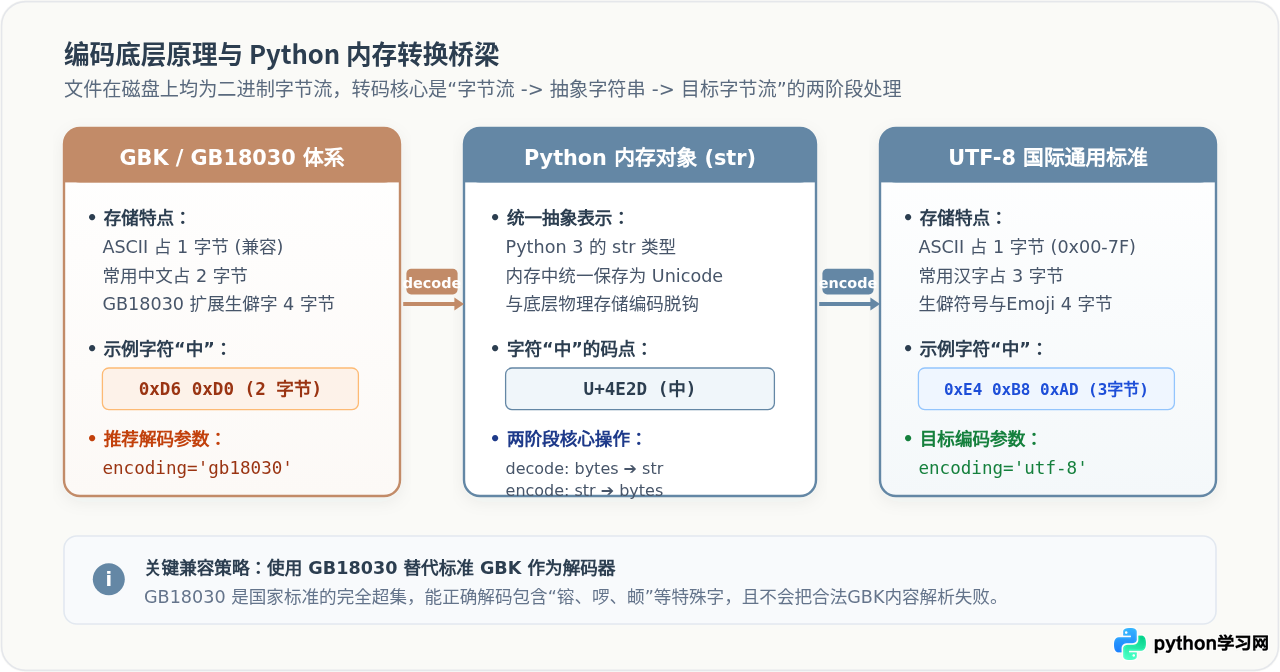
如上图所示,Python 内部的所有字符串都是以 Unicode 统一表示的抽象对象。从文件读入内存时执行 decode(),写入磁盘时执行 encode()。在读取 GBK 编码的文件时,直接在 Python 中使用 encoding='gb18030' 作为解码参数,既能完美解析所有标准 GBK 内容,又能避免生僻汉字因字节越界而中断整个批量任务。
二、批量转换的操作步骤与核心逻辑
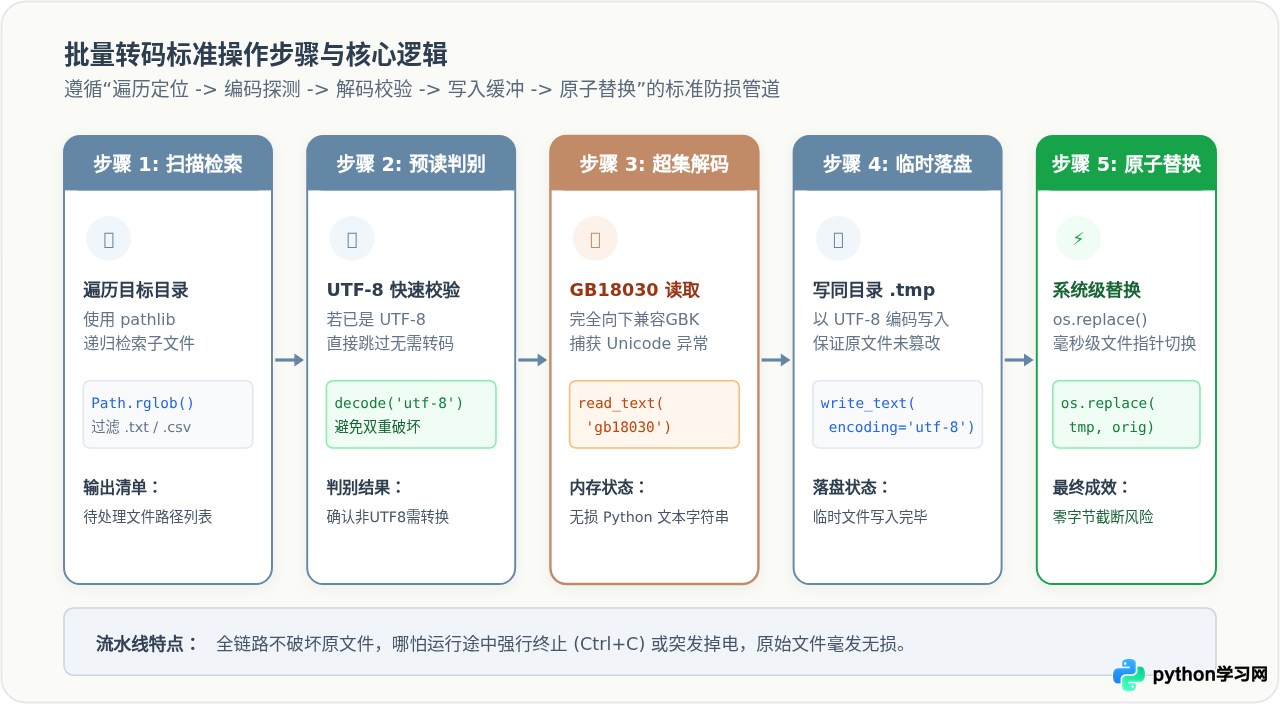
一个稳定可用的批量转码流程应该具备防护机制,避免对无关文件做误操作,也避免转码中途崩溃造成数据破坏。完整流程通常分为五个步骤:
- 扫描与路径过滤:利用
pathlib.Path.rglob()递归遍历指定目录,根据后缀名(如.txt、.csv、.log、.json等)过滤出目标文件,避免误改二进制图片或可执行文件。 - 智能预读判别:部分目录可能已经混杂了 UTF-8 编码的文件。通过先尝试以 UTF-8 解码读取前几千字节,如果能够正常解码,说明该文件已是 UTF-8,直接跳过,避免将正常文件二次破坏。
- 安全超集解码:对未通过 UTF-8 校验的文件,以
gb18030编码读入内存。如遇极少数损坏字节,可配合异常捕获或容错参数。 - 写入同级临时文件:先以
utf-8编码将内容写入一个形如filename.ext.tmp的临时文件,确认完整写入落盘。 - 系统原子替换:使用
os.replace(tmp_path, target_path)进行原子重命名覆盖。这不仅跨平台支持,而且能保证文件切换瞬间完成。
三、完整的 Python 批量转换脚本实现
以下提供一份结构清晰、包含参数配置、异常捕获与计数统计的完整 Python 脚本。该脚本仅依赖 Python 官方标准库(Python 3.6+ 即可直接运行),无需使用 pip 安装第三方依赖。
import os
import sys
from pathlib import Path

def is_already_utf8(file_path: Path) -> bool:
    """
    检查文件是否已经是合法的 UTF-8 编码。
    读取前 64KB 内容进行探测,若完全符合 UTF-8 规则则返回 True。
    """
    try:
        with open(file_path, 'rb') as f:
            chunk = f.read(65536)
            if not chunk:
                return True  # 空文件视同兼容
            chunk.decode('utf-8')
        return True
    except UnicodeDecodeError:
        return False

def convert_single_file(file_path: Path, errors: str = 'strict') -> bool:
    """
    将单个 GBK/GB18030 文件安全转换为 UTF-8 编码。
    采用写临时文件 + os.replace 原子替换方案,杜绝中断造成数据截断丢失。
    """
    if is_already_utf8(file_path):
        print(f"[跳过] 已经是 UTF-8: {file_path}")
        return False

    temp_path = file_path.with_name(f".{file_path.name}.tmp")
    try:
        # 1. 以 gb18030 超集解码读取文件内容
        with open(file_path, 'r', encoding='gb18030', errors=errors) as src:
            content = src.read()

        # 2. 以 utf-8 编码写入同目录临时文件
        with open(temp_path, 'w', encoding='utf-8') as dst:
            dst.write(content)

        # 3. 系统级原子替换,覆盖源文件
        os.replace(temp_path, file_path)
        print(f"[成功] 已转为 UTF-8: {file_path}")
        return True

    except UnicodeDecodeError as e:
        print(f"[解码失败] 无法用 GB18030 解析: {file_path}, 原因: {e}", file=sys.stderr)
        if temp_path.exists():
            temp_path.unlink()
        return False
    except Exception as e:
        print(f"[操作异常] 处理 {file_path} 时出错: {e}", file=sys.stderr)
        if temp_path.exists():
            temp_path.unlink()
        return False

def batch_convert(target_dir: str, extensions: tuple = ('.txt', '.csv', '.log')):
    """
    递归扫描目标文件夹,批量转换指定扩展名的文件。
    """
    folder = Path(target_dir).resolve()
    if not folder.exists() or not folder.is_dir():
        print(f"[错误] 目标目录不存在: {folder}", file=sys.stderr)
        return

    print(f"=== 开始批量转码 ===")
    print(f"扫描目录: {folder}")
    print(f"目标扩展名: {extensions}")

    total_scanned = 0
    converted_count = 0
    skipped_count = 0
    failed_count = 0

    # 递归查找匹配扩展名的文件
    for ext in extensions:
        # 兼容小写与大写扩展名
        pattern = f"**/*{ext}"
        for file_path in folder.glob(pattern):
            if not file_path.is_file():
                continue
            total_scanned += 1
            res = convert_single_file(file_path)
            if res:
                converted_count += 1
            else:
                # 若是编码跳过或解码失败
                if is_already_utf8(file_path):
                    skipped_count += 1
                else:
                    failed_count += 1

    print("
=== 处理结果统计 ===")
    print(f"匹配扫描文件: {total_scanned} 个")
    print(f"成功转码文件: {converted_count} 个")
    print(f"跳过已有文件: {skipped_count} 个")
    print(f"处理失败文件: {failed_count} 个")

if __name__ == '__main__':
    # 将此路径替换为实际需要批量转换的文件夹绝对路径或相对路径
    DIRECTORY_TO_CONVERT = "./my_legacy_data"
    TARGET_EXTENSIONS = ('.txt', '.csv', '.log', '.json')

    batch_convert(DIRECTORY_TO_CONVERT, TARGET_EXTENSIONS)
运行该脚本后,控制台会输出清晰的执行细节与汇总统计信息。例如:
=== 开始批量转码 ===
扫描目录: /data/project/my_legacy_data
目标扩展名: ('.txt', '.csv', '.log', '.json')
[成功] 已转为 UTF-8: /data/project/my_legacy_data/2021_summary.txt
[跳过] 已经是 UTF-8: /data/project/my_legacy_data/readme.txt
[成功] 已转为 UTF-8: /data/project/my_legacy_data/reports/q3_finance.csv

=== 处理结果统计 ===
匹配扫描文件: 3 个
成功转码文件: 2 个
跳过已有文件: 1 个
处理失败文件: 0 个
四、健壮性设计与异常防护策略
在工程实践中,批量修改磁盘文件必须高度重视数据安全。许多初学者写出的脚本直接使用 with open(f, 'w') 原地写回,这隐藏着极高的数据清空风险。
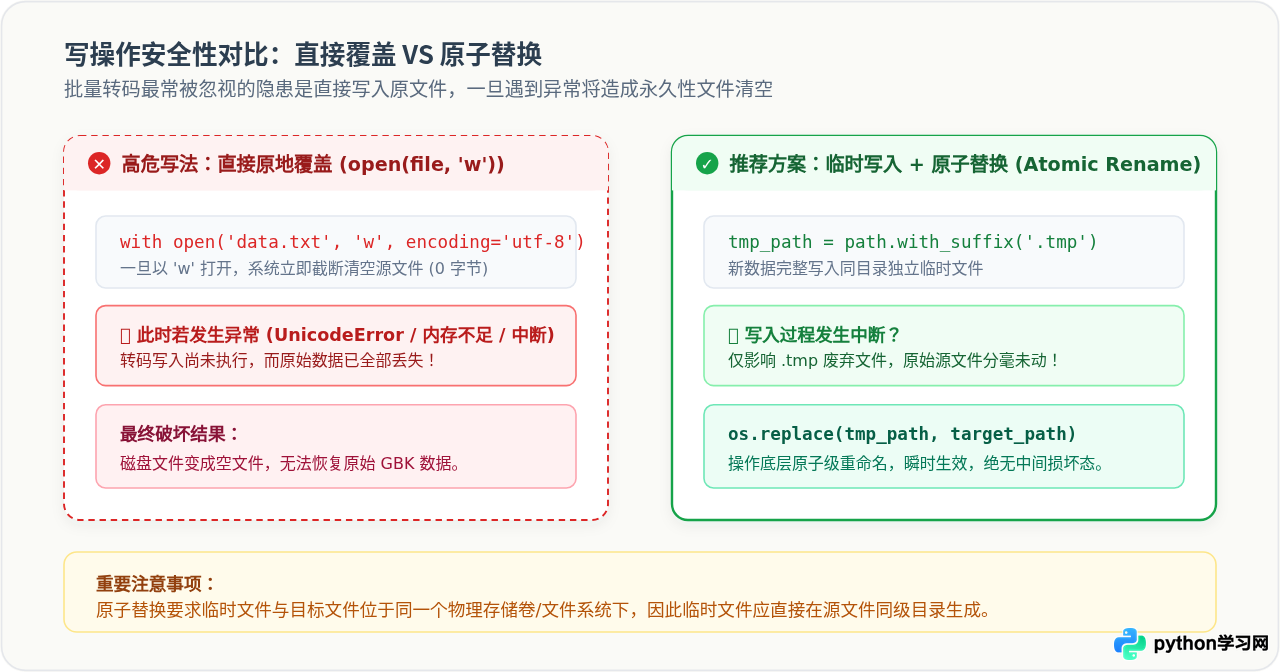
1. 原地写回的致命缺陷与原子替换解决办法
当在 Python 中以 'w' 模式打开一个文件时,操作系统会首先调用 truncate() 系统调用,立刻将现有文件长度截断为 0 字节。此时一旦随后发生写入异常(如编码转换报错、磁盘写满、用户强行按 Ctrl+C 中断或程序崩溃),原本保存在文件里的全部旧数据已经不可逆地消失了。
使用如代码所示的 temp_path + os.replace 方案,整个新文件在完全写入并关闭后,才发起单次系统调用切换文件指针。即便中途报错,遗留的仅仅是一个隐藏的 .tmp 临时文件,原始 GBK 文件依旧完整无损。
os.replace() 在 Windows、macOS 和 Linux 上均有原子性保证,但前提是临时文件与目标文件处于同一个物理卷/分区。因此,将临时文件存放在 file_path.with_name(...) 同级目录下是最稳妥的实践。
2. 非法字节的容错处理
如果原始文件曾经被不同编辑器多次混编,导致个别字节彻底损坏,errors='strict' 会直接抛出 UnicodeDecodeError。此时可以根据业务容忍度调整 errors 参数:
errors='strict'(默认):遇到任何解码错误立即报错。适用于对数据完整性要求极高、不允许丢字的财务、审计场景。errors='replace':将无法识别的非法字节转换为 Unicode 占位符�(即黑色菱形问号),确保批量流程不中断。errors='ignore':直接忽略并丢弃非法字节。通常用于非关键文本日志解析。
五、转换结果验证与常见问题排查
批量转换执行完毕后,应当通过外部工具与程序化双重手段验证转码结果,确认中文字符正确显示且编码已被操作系统识别为 UTF-8。
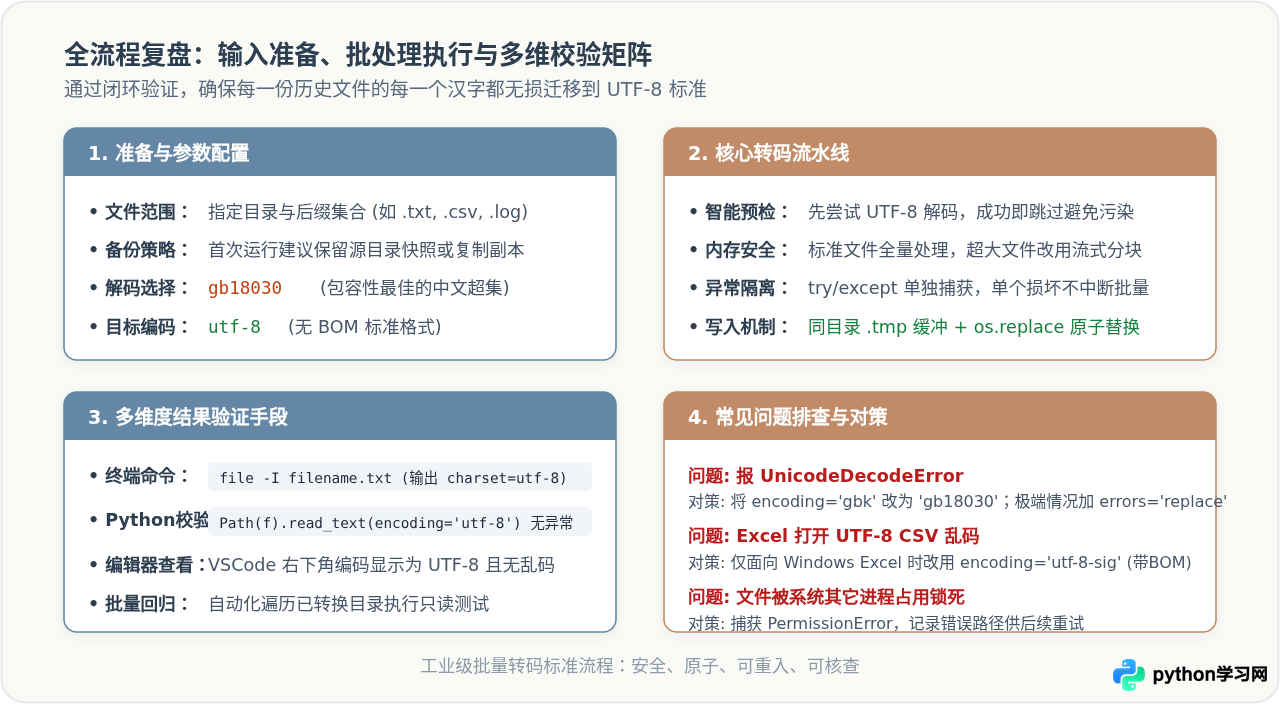
1. 如何准确验证文件编码
- 使用终端
file命令:在 Linux 或 macOS 终端执行file -I 目标文件.txt(macOS)或file -i 目标文件.txt(Linux),输出应当包含charset=utf-8。 - 使用 Python 快速校验:编写一行命令进行只读测试:
若无报错且控制台打印的中文整齐清晰,即表明转换完全成功。python -c "from pathlib import Path; print(Path('目标文件.txt').read_text(encoding='utf-8')[:100])" - 代码编辑器确认:在 VS Code 中打开文件,观察右下角状态栏显示的编码应为
UTF-8,文本正文不再有菱形问号或“锟斤拷”等典型乱码现象。
2. 常见问题与排查指南
| 异常现象 | 根本原因 | 解决对策 |
|---|---|---|
| 出现“锟斤拷”乱码 | 源文件在转换前就已经被用错误的 UTF-8 解码为“”,并再次保存为 GBK。 | 此乱码属于历史性二次污染,无法程序还原,须从最初始的未篡改备份重新转码。 |
| Excel 打开转换后的 CSV 出现乱码 | Windows 版 Excel 默认只将包含 BOM(字节顺序标记)的文本识别为 UTF-8。 | 若主要面向 Windows Excel 用户,写文件时将编码参数改为 encoding='utf-8-sig'。 |
| 报 PermissionError 权限错误 | 目标文件正在被其他程序(如 Excel、Word、运行中的服务)独占打开。 | 先退出占用文件的第三方程序,检查当前终端对目录的写入权限后再重新运行脚本。 |
通过遵循上述先预检、后解码、临时缓冲与原子替换的规范,开发者可以使用简洁的 Python 原生代码安全、高效地完成数千上万个 GBK 历史文件的平滑迁移。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









