

非计算机专业转行学Python可行吗?文科生与传统行业从业者的机会分析
深入分析非计算机专业(尤其是文科生与传统行业从业者)转行学习Python的可行性、核心阻碍、真实机会场景与四阶段实施路线图,避开盲目刷题陷阱,实现业务与技术的差异化破局。
一、路径分化:纯研发死胡同与业务复合突破口
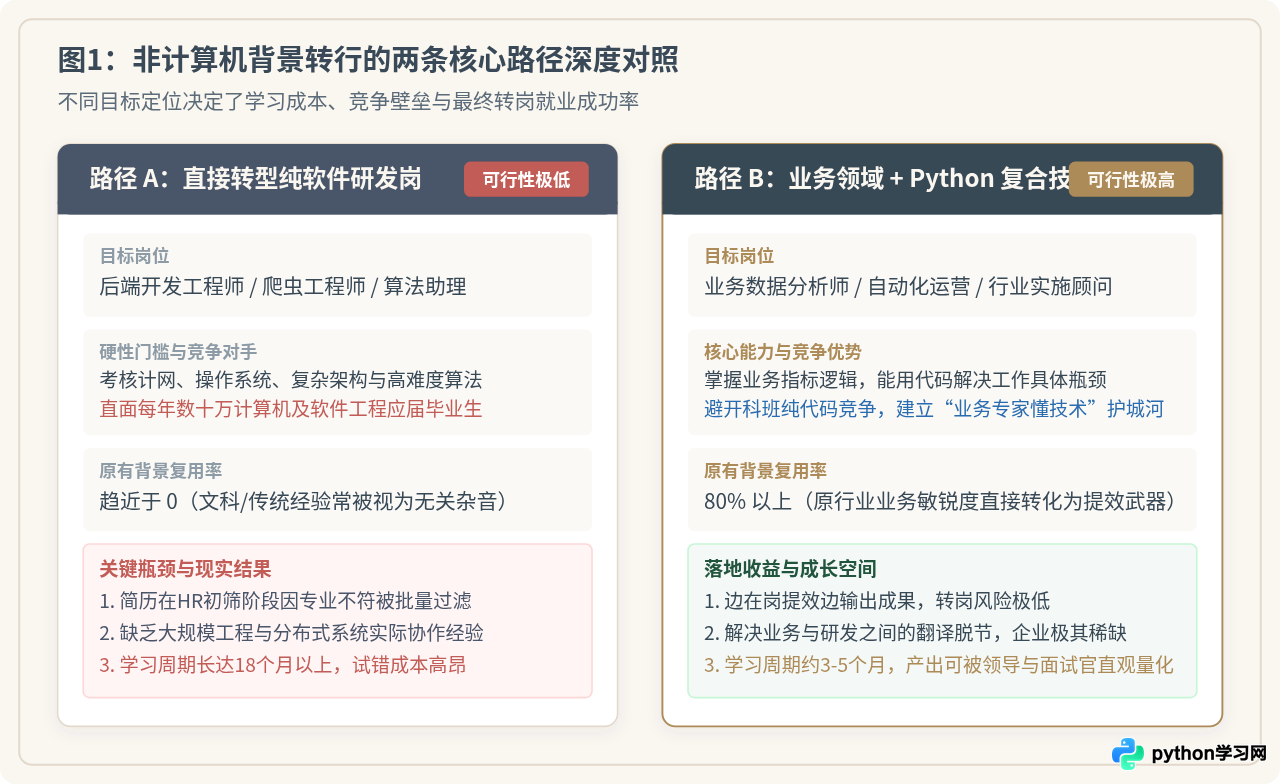
探讨非计算机专业转行Python是否可行时,最大的误区在于将“学Python”等同于“成为纯软件研发工程师”。在招聘市场上,软件工程与后端研发岗位考核的是涵盖计算机网络、操作系统、体系结构、内存管理以及高并发分布式架构的完整工程体系。缺乏四门核心专业课积累的转行者,往往在简历初筛阶段就会被高学历科班生挤压。
与此相对,各类实体企业、出海品牌、传统制造、专业服务机构中,存在大量深陷海量杂乱数据与手工机械流程的业务部门。软件研发团队不了解具体业务痛点,而业务骨干又受制于Excel卡死与系统割裂。掌握Python脚本能力的业务从业者,恰好能够成为填补这片鸿沟的“胶水型人才”。
| 对比维度 | 路径 A:纯软件研发工程师 | 路径 B:业务领域 + Python复合岗位 |
|---|---|---|
| 核心目标岗位 | Python后端开发、爬虫研发、算法工程 | 业务数据分析师、数字化运营、行业实施顾问 |
| 考核重点 | 计算机底层基础、LeetCode算法、系统设计 | 业务指标拆解、数据清洗自动化、痛点解决结果 |
| 原有经验复用度 | 极低(既有行业知识几乎无法转化为研发优势) | 极高(原行业知识是数据逻辑与业务判断的核心壁垒) |
| 转行周期与阻力 | 12-18个月以上,简历学历门槛极高 | 3-5个月边干边练,能在原岗位直接验证并交付 |
二、文科生的突围点:非结构化文本、内容洞察与出海运营
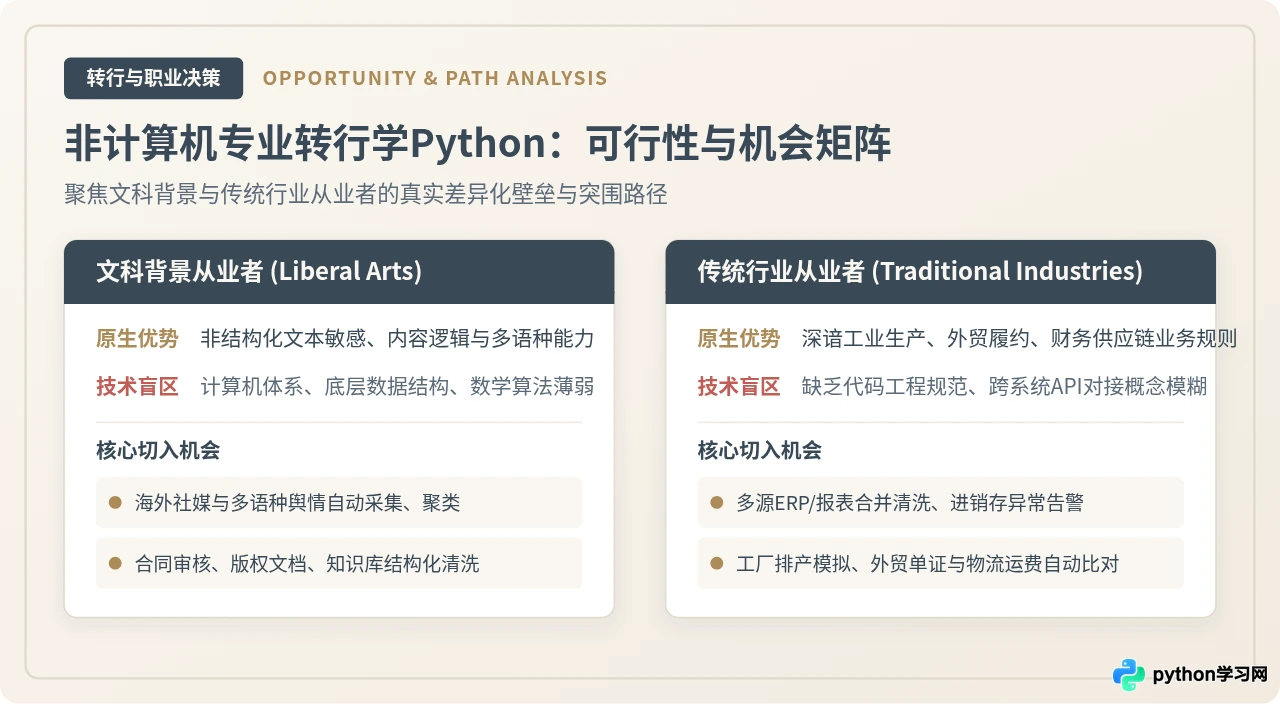
文科专业(语言学、新闻传播、文史哲、法律等)的学习者通常具备出色的文字组织能力、语言敏感度和对复杂语义环境的理解力,但普遍担忧自己的逻辑抽象与数学基础不足。在传统数值计算或底层架构开发中,数学确实是硬门槛;然而在现代信息处理中,高达80%的企业数据是以非结构化文本形式存在的。
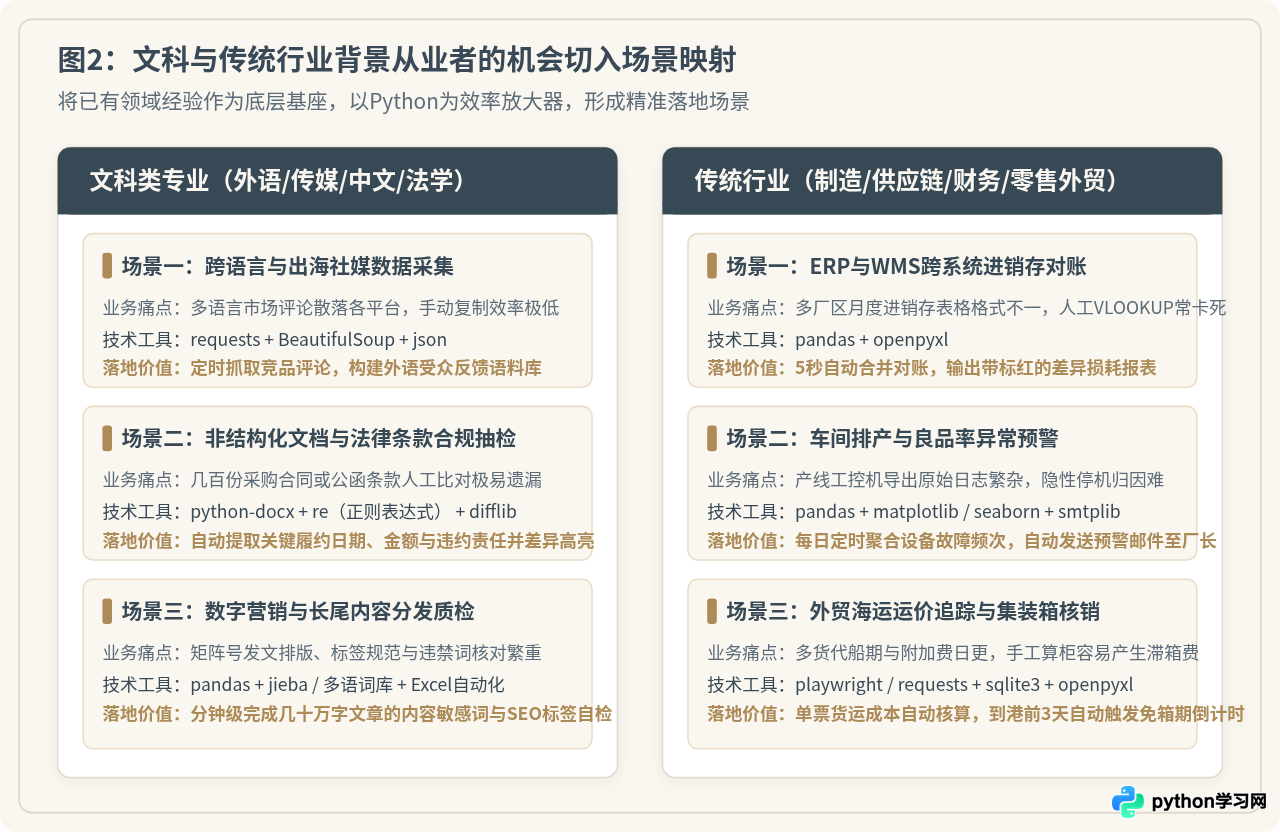
文科生转型学习Python的最佳切入点,正是非结构化文本的采集、质检、聚类与跨语言分析。例如在跨境电商与出海营销中,海外本土消费者的评价内容夹杂大量口语俚语与多语种混用,纯技术人员难以设计精准的清洗规则,而具备外语与传播背景的人员配合Python正则表达式与轻量文本库,便能快速产出极具商业价值的消费者痛点报告。
实战示例:多语种海外用户反馈自动化提取与清洗
以下是一个文科生在跨境运营或海外舆情分析中常见的工作脚本示例:从导出的杂乱多语种文本数据中,利用正则表达式与pandas进行异常字符清洗、关键情感短语标记与自动化聚类整理。
import re
import pandas as pd

# 示例输入:模拟出海电商平台收集的多语种、夹杂格式杂乱的原始评论数据
raw_feedbacks = [
    {"id": 101, "lang": "en", "text": "Delivery was slow (over 14 days), but the sound quality is top-notch! #audio"},
    {"id": 102, "lang": "es", "text": "El paquete llego roto. Muy mala experiencia con el envio. [[REF:9921]]"},
    {"id": 103, "lang": "en", "text": "Contacted support 3 times, NO RESPONSE AT ALL. Totally unacceptable."},
    {"id": 104, "lang": "fr", "text": "Excellente finition, conforme a la description! Livré en 3 jours."},
    {"id": 105, "lang": "en", "text": "Great packaging, but Bluetooth disconnects frequently during workouts."}
]

def clean_text_content(text: str) -> str:
    """剔除文档中的特殊标记、URL或非文本标签,规范化空格"""
    # 过滤类似 [[REF:xxxx]] 或 #tag 等元数据标签
    cleaned = re.sub(r"\[\[.*?\]\]", "", text)
    cleaned = re.sub(r"#[A-Za-z0-9_]+", "", cleaned)
    # 消除连续冗余空格并修剪首尾
    cleaned = re.sub(r"\s+", " ", cleaned).strip()
    return cleaned

def tag_logistics_issue(text: str) -> bool:
    """根据语境关键词识别是否属于物流/配送客诉"""
    logistics_keywords = ["delivery", "slow", "envio", "livr", "package", "days", "días"]
    pattern = re.compile(r"\b(" + "|".join(logistics_keywords) + r")\b", re.IGNORECASE)
    return bool(pattern.search(text))

# 执行处理流水线
df = pd.DataFrame(raw_feedbacks)
df["cleaned_text"] = df["text"].apply(clean_text_content)
df["is_logistics_issue"] = df["cleaned_text"].apply(tag_logistics_issue)

# 筛选存在物流配送痛点的记录
logistics_report = df[df["is_logistics_issue"]][["id", "lang", "cleaned_text"]]
print(logistics_report.to_string(index=False))UnicodeDecodeError。文科背景转行者在读取本地文件时,必须显式声明字符编码格式,如 open('data.txt', 'r', encoding='utf-8') 或针对旧版Windows文件指定 encoding='gb18030',避免依赖操作系统的默认隐式编码。
三、传统行业从业者的机会:扎根业务护城河与流程自动化
对于从事机械制造、仓储供应链、外贸货代、财务审计或零售连锁的人员而言,核心竞争力从不是写出多么高深的代码,而是“对行业隐性规则和业务异常的高度敏锐”。
在传统行业中,各类ERP、WMS(仓储管理系统)或MES(制造执行系统)大多存在数据孤岛问题。月末跨系统对账、多工厂物料差异核算、物流运费多扣重扣排查等工作,往往依赖业务人员手工操作几万行容量的Excel文件。传统行业的转行者只需要掌握Python的表格处理与数据库交互,就能将原有需要3天完成的对账与报表统计缩减至数秒钟完成,并能主动定位数据偏差根源。
实战示例:跨系统库存差异对账与超期库存自动告警
以下展示制造业或供应链仓储中,如何利用pandas将“仓库实物盘点表”与“财务ERP账面表”进行双向比对,自动标记账实不符并计算潜在资金沉淀。
import pandas as pd

# 示例数据源1:WMS实物扫码盘点表
wms_data = pd.DataFrame([
    {"sku": "SKU-A101", "wms_qty": 450, "warehouse": "华东一号仓"},
    {"sku": "SKU-B202", "wms_qty": 120, "warehouse": "华东一号仓"},
    {"sku": "SKU-C303", "wms_qty": 80,  "warehouse": "华东一号仓"},
    {"sku": "SKU-D404", "wms_qty": 300, "warehouse": "华北二号仓"},
])

# 示例数据源2:财务ERP账面库存与单价表
erp_data = pd.DataFrame([
    {"sku": "SKU-A101", "erp_qty": 500, "unit_cost": 25.0},
    {"sku": "SKU-B202", "erp_qty": 120, "unit_cost": 88.0},
    {"sku": "SKU-C303", "erp_qty": 65,  "unit_cost": 150.0},
    {"sku": "SKU-E505", "erp_qty": 10,  "unit_cost": 320.0},
])

# 以SKU为键进行外连接对账(确保两边遗漏的SKU均被检出)
recon = pd.merge(wms_data, erp_data, on="sku", how="outer").fillna(0)

# 计算数量差异:实物数量 - 账面数量(负数代表盘亏盘损,正数代表账外盘盈)
recon["diff_qty"] = recon["wms_qty"] - recon["erp_qty"]
recon["diff_amount"] = recon["diff_qty"] * recon["unit_cost"]

# 筛选出存在异常的记录
anomaly_records = recon[recon["diff_qty"] != 0].copy()
anomaly_records["status"] = anomaly_records["diff_qty"].apply(
    lambda x: "盘亏 (缺少)" if x < 0 else "盘盈 (多余)"
)

print(anomaly_records[["sku", "warehouse", "wms_qty", "erp_qty", "diff_qty", "diff_amount", "status"]].to_string(index=False))四、非科班转行的四阶实操路径规划
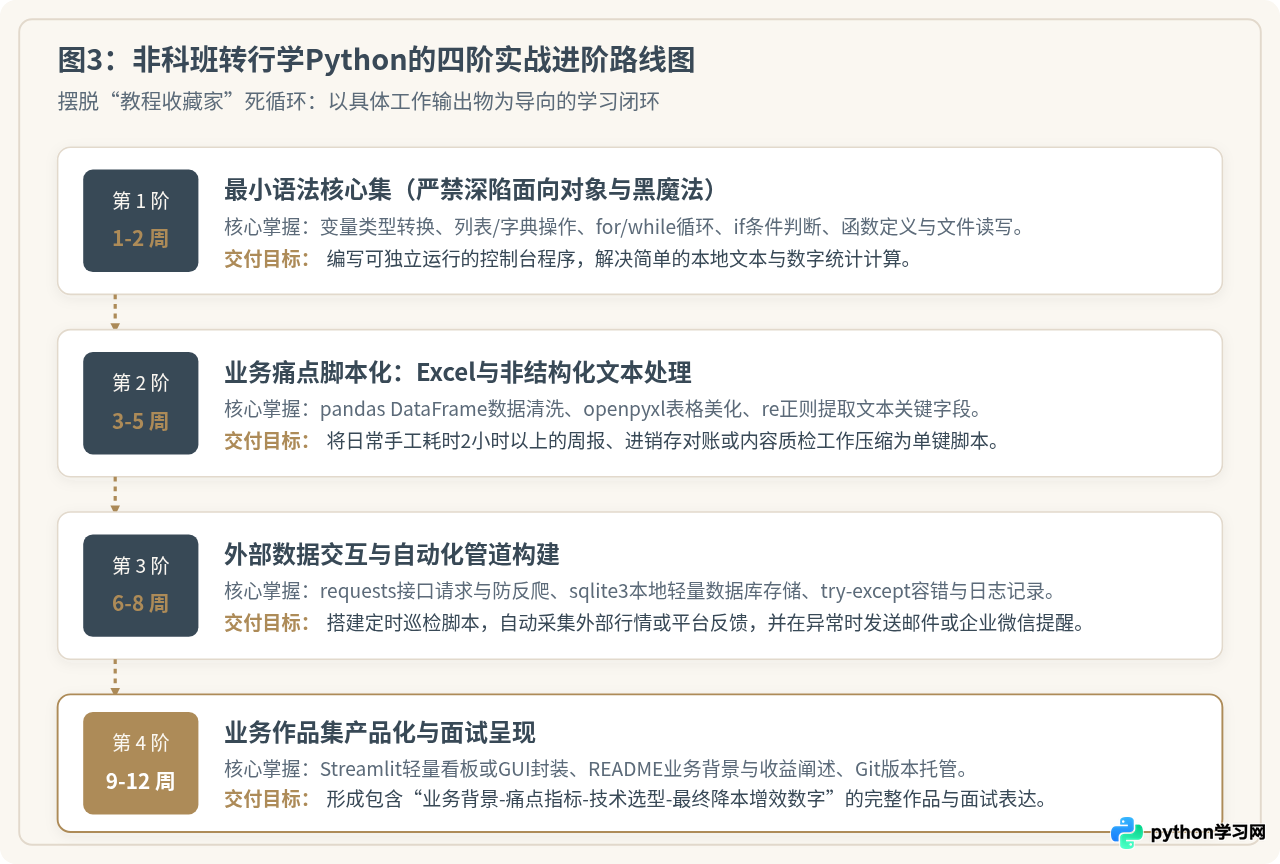
多数人转行失败的原因在于陷入了“找全套视频教程 -> 从第一集看到最后一集 -> 照抄代码 -> 关掉视频一片空白”的假性学习循环。非科班学习必须以“工作任务交付”为核心驱动力,分阶段推进:
-
阶段一:掌握语法核心最小闭环(耗时约1至2周)
严格克制学习范围,只学:字符串/整数/布尔值、列表与字典、for/while循环、if-else判断、自定义函数、文件基础读写。跳过面向对象的高阶继承、元编程与装饰器底层原理。只要能写出顺序执行的逻辑块即可。 -
阶段二:面向工作痛点的脚本化落地(耗时约3周)
立即引入pandas和openpyxl。在自己的实际工作中寻找最耗费时间的表格合并、拆分、去重和公式匹配任务,编写针对性脚本。这一阶段的标志是:在当前岗位上通过自动化每天为自己省出1-2小时时间。 -
阶段三:外部数据管道与异常防御(耗时约3周)
学习requests发起HTTP调用、理解JSON结构化解析,学会用try-except捕捉网络超时与缺失键值,并引入sqlite3记录本地执行流水。完成从“单次执行脚本”到“稳定自动化流水线”的升级。 -
阶段四:业务项目产品化与面试呈现(耗时约3至4周)
利用轻量交互工具(如Streamlit)将脚本包装为带按钮与图表的网页应用。撰写技术README时,重点阐述“解决了何种业务损失、提升了多少百分比的流转效率”,构建能够让面试官一目了然的项目集。
五、必须规避的三个典型误区与决策总结
明确了可行的切入点后,避开资源错配同样关键。以下三项误区在非计算机背景转行群体中发生率极高,需严格自查:
-
误区一:脱离业务背景盲目死磕算法题库。
有些转行者误以为学编程就必须先刷几百道力扣题。纯技术研发岗确实用算法题筛人,但业务复合型岗位看重的是对业务指标的理解和对清洗工具的熟练度。盲目刷题会耗尽初期耐心,并严重挤占积累业务作品的时间。 -
误区二:盲目冲刺前沿大模型与深度学习算法研发。
AI大模型的底层训练与算法微调对高等数学、线性代数、算力资源和顶级学术论文有极高的硬性要求。转行者的切入点应当是如何“使用”API和工具解决业务流转,而非试图去复现或修改底层神经网络架构。 -
误区三:项目作品缺乏真实业务闭环与数据指标。
很多求职者简历上的项目千篇一律是网课附带的“天气预报查询”或“电影Top250爬虫”。这种缺乏真实场景和商业价值的项目无法打动任何用人单位。真正具备说服力的作品,必须包含真实的痛点背景、清洗规则选择依据以及可量化的效能提升数据。
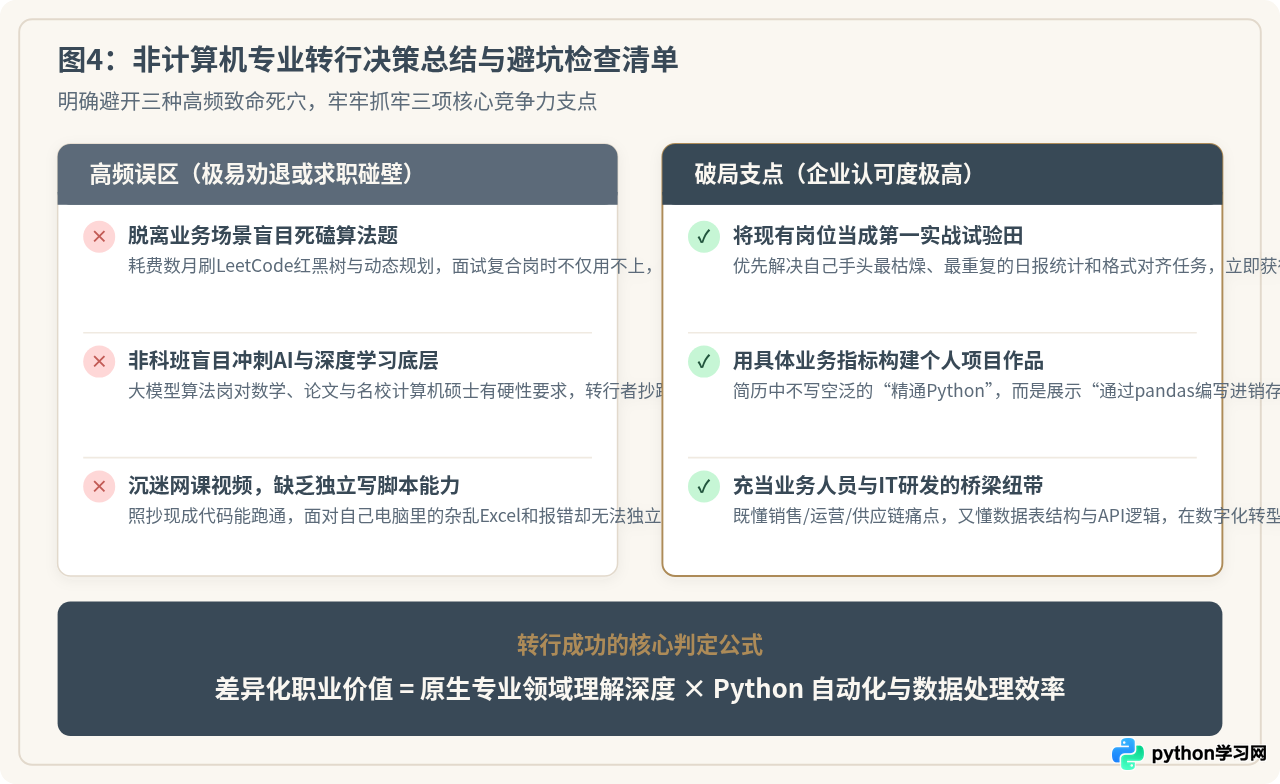
综合而言,非计算机专业学习Python的可行性,取决于能否将Python从一门孤立的编程技能,转化为自身原有专业领域的“效能杠杆”。文科生的语义与逻辑优势、传统行业从业者的业务规则积累,正是科班研发人员在短期内无法替代的宝贵财富。找准定位、以用促学,才是非科班人员转行最具确定性的突破之道。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









