

除了Selenium,Python还有哪些高效的动态网页抓取工具
深入解析除Selenium之外的Python高效动态网页抓取方案,从底层通信协议对比入手,详尽介绍Playwright异步并发与路由拦截、DrissionPage动静双模无缝切换以及工业级逆向接口调用的具体实现与选型策略。
面对现代前端单页应用(SPA)与高频 JavaScript 渲染页面,很多开发者习惯性地选用 Selenium 作为首选采集方案。然而,随着抓取规模上升,Selenium 往往暴露出启动缓慢、内存开销巨大、并发调度阻塞以及容易触发反爬虫特征等显著瓶颈。实际上,在 Python 数据采集生态中,已经演化出一批专为高性能场景设计的现代化工具:微软推出的 Playwright 具备强大的原生协程并发与网络路由拦截能力;国人开源的 DrissionPage 实现了无驱动 CDP 直控与“请求-渲染”双模式极速切换;结合 Scrapy-Playwright 则可直接支撑工业级分布式任务;而通过浏览器抓包直接穿透隐藏的 JSON API 更是效率最高、资源消耗趋近于零的终极手段。本文将深入剖析这些工具的底层差异、使用方法与最佳实践场景。
一、架构之别:Selenium 的瓶颈与现代抓取工具的进化
要理解替代方案为什么“高效”,必须先看清传统 Selenium 在设计上的固有局限。Selenium 最初诞生于网页自动化测试领域,其核心设计目标是“忠实模拟真实用户在多款浏览器中的操作行为”,而非追求大规模数据采集的高吞吐量。
在底层通信中,Selenium 依赖经典的 W3C WebDriver 协议。当 Python 脚本执行一条查找元素或翻页指令时,指令必须先被打包成 HTTP 请求,发送给本地运行的 chromedriver 独立进程;驱动程序解析后再通过端口向真实浏览器下发控制指令,最后把执行结果按原路打包返回。这种“三层中转、同步轮询”的链路带来了不可避免的毫秒级协议延迟。更致命的是,Selenium 缺乏对 Python asyncio 原生协程的深度支持,如果要并发抓取,开发者通常只能启动多个完整的独立浏览器进程或多线程,这会瞬间吃满服务器的 CPU 与内存。
相比之下,现代工具(如 Playwright 与 DrissionPage)绕过了中间驱动服务,直接使用 WebSocket 与浏览器核心的 Chrome DevTools Protocol (CDP) 建立长连接双向通信。这种架构上的跃迁,彻底打破了传统通信的多层瓶颈。
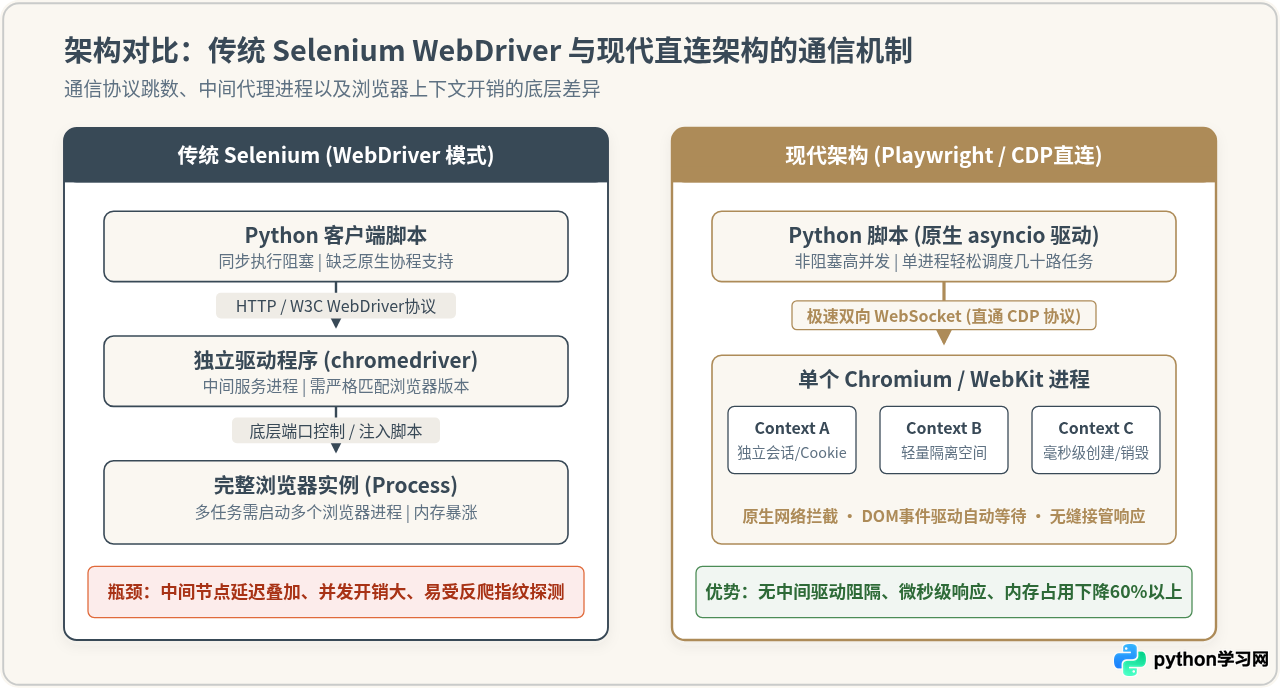
从上图的对比中可以清晰看到现代工具的核心优势所在:
- 零中间代理进程:无需额外维护与浏览器小版本严格绑定的
chromedriver,减少了单点崩溃风险与安装维护负担。 - 轻量级上下文隔离(BrowserContext):在 Playwright 中,一个主浏览器进程启动后,可以毫秒级切分出数十个相互独立的上下文环境。各个上下文拥有完全隔离的 Cookie、LocalStorage 和缓存,相当于“在单进程内开启几十个无痕独立窗口”,内存占用比 Selenium 开启多进程降低 60% 以上。
- 事件驱动与自动等待:传统 Selenium 常因元素未加载完成而报错,促使许多新手写出
time.sleep(3)这类低效代码。而现代工具基于 DOM 事件总线监听节点就绪,一旦元素可交互立即触发执行,网络慢则等、网络快则秒过。
二、方案一:Playwright —— 原生异步高并发与路由拦截利器
Playwright 是微软开源的新一代浏览器自动化与爬虫工具,原生支持 Chromium、Firefox 以及 WebKit 引擎。对于 Python 开发者而言,Playwright 最大的杀手锏在于提供了完备的 async_api,可以与 Python 的 asyncio 无缝结合,在单个进程内实现高密度的协程并发抓取。
1. 网络路由拦截:节省 70% 静态资源带宽
在动态网页抓取过程中,浏览器通常会加载大量的图片(PNG/JPG)、高清背景视频、字体文件(WOFF2)以及第三方打点追踪代码。这些资源对数据采集毫无用处,却消耗了 70% 以上的带宽与渲染计算资源。Selenium 很难优雅地精细化阻断特定请求,而 Playwright 的 page.route() 提供了细粒度的网络拦截能力:
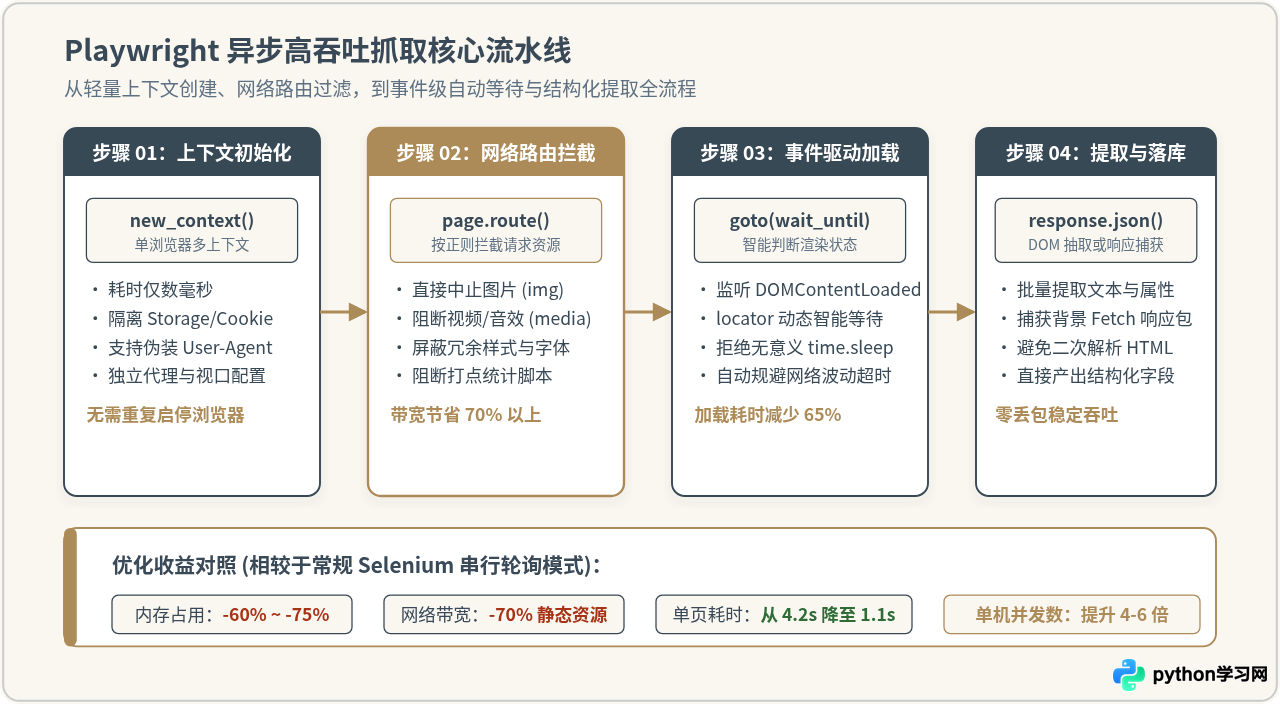
2. 完整实战代码示例:异步并发与数据抓取
下面是一个标准的 Playwright 异步采集脚本。该脚本演示了如何配置无头浏览器、创建隔离上下文、拦截非必要媒体资源,并从目标列表页提取数据:
import asyncio
from playwright.async_api import async_playwright

async def intercept_unwanted_resources(route):
    # 如果请求资源是图片、字体或样式表,直接在网络层中止请求
    if route.request.resource_type in ["image", "font", "media"]:
        await route.abort()
    else:
        await route.continue_()

async def scrape_page(context, page_index):
    page = await context.new_page()
    target_url = f"https://quotes.toscrape.com/js/page/{page_index}/"

    # 注册路由监听器
    await page.route("**/*", intercept_unwanted_resources)

    try:
        # 导航并等待 DOM 就绪,消除硬性 sleep
        await page.goto(target_url, wait_until="domcontentloaded", timeout=15000)

        # 等待数据卡片节点渲染出现
        await page.wait_for_selector(".quote", timeout=5000)

        # 批量获取页面所有卡片节点并提取文本
        quotes = await page.locator(".quote").all()
        results = []
        for item in quotes:
            text = await item.locator(".text").inner_text()
            author = await item.locator(".author").inner_text()
            results.append({"author": author, "text": text})

        print(f"[成功] 第 {page_index} 页抓取完成,共提取 {len(results)} 条记录")
        return results
    finally:
        await page.close()

async def main():
    async with async_playwright() as p:
        # 启动无头浏览器并配置反检测参数
        browser = await p.chromium.launch(
            headless=True,
            args=["--disable-blink-features=AutomationControlled"]
        )
        # 创建单个轻量隔离上下文
        context = await browser.new_context(
            user_agent="Mozilla/5.0 (Macintosh; Intel Mac OS X 10_15_7) AppleWebKit/537.36"
        )

        # 通过 asyncio.gather 调度 5 个页面的高并发抓取
        tasks = [scrape_page(context, i) for i in range(1, 6)]
        all_results = await asyncio.gather(*tasks)
        await browser.close()

if __name__ == "__main__":
    asyncio.run(main())
pip install playwright && playwright install chromium。如果目标网站采用了高强度的 Cloudflare 或 Akamai 浏览器指纹防护,可直接搭配社区开源的 patchright 或 playwright-stealth 插件,一键抹除 CDP 特征。
三、方案二:DrissionPage —— 动静双模与无需驱动的国产利器
如果说 Playwright 是现代国际标准级工业框架,那么 DrissionPage 则是针对日常爬虫痛点量身定制的高效利器。它的名字来源于 Driver 和 Session 的结合,核心特色在于:将底层纯 HTTP 请求(类似 Requests)与 Chromium 浏览器渲染控制融为一体。
1. 为什么 DrissionPage 运行更快、开发更省心?
- 真正的无驱动直连:DrissionPage 不需要下载配置任何版本的
chromedriver,它直接与系统已安装的 Chrome 或 Edge 浏览器的 CDP 端口通信,免去了驱动不匹配的一切烦恼。 - 天然规避 WebDriver 检测:在传统 Selenium 中,
navigator.webdriver属性会被默认置为true,极易被各大网站的风控系统拦截。DrissionPage 由于完全基于原生 CDP 协议驱动,该属性天然为undefined,具备极佳的免杀效果。 - 动静双模瞬时切换:面对需要登录或拖拽滑块的网站,常规做法是用浏览器全程模拟到底。而 DrissionPage 允许你使用浏览器模式(
d_mode)完成滑块验证与登录后,直接将获得的完整 Cookies 与 Session 凭证瞬间注入请求模式(s_mode),后续成千上万个列表和详情页直接走微秒级的纯 HTTP 请求,整体吞吐性能飙升数十倍。
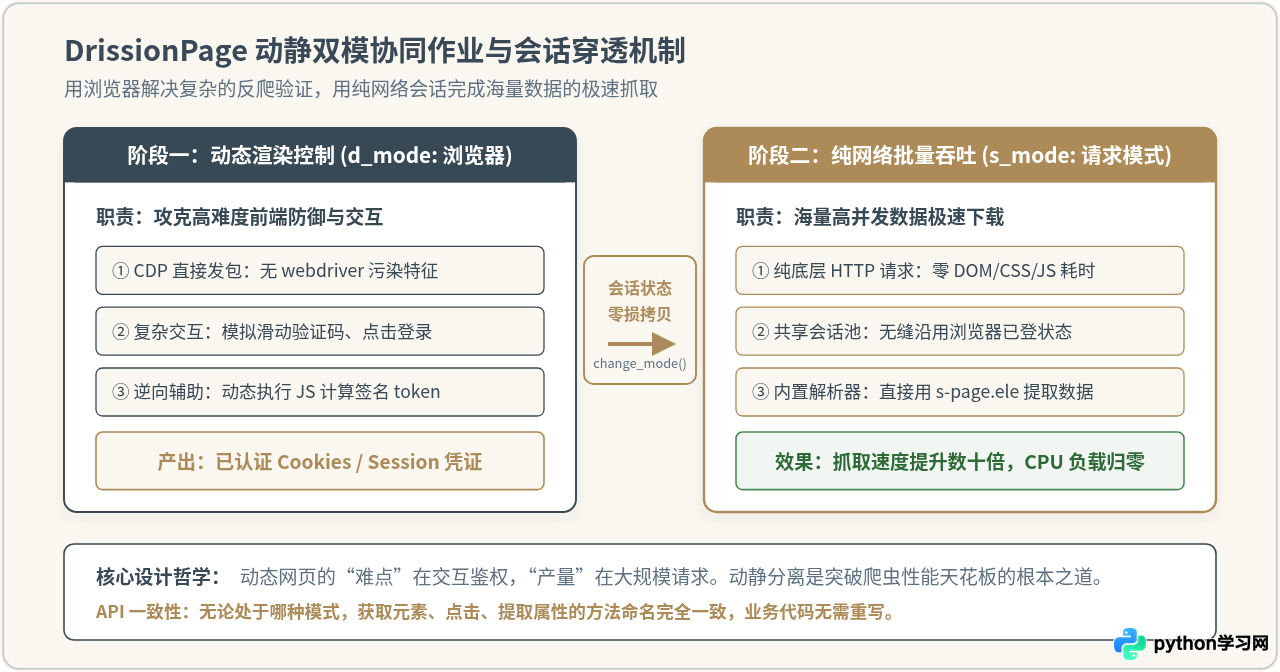
2. 实战示例:从浏览器渲染无缝切换至纯请求模式
以下代码清晰演示了 DrissionPage 如何在同一个对象中无缝跨越两种工作形态:
from DrissionPage import ChromiumPage, SessionPage

# 1. 启动 ChromiumPage (d_mode:浏览器渲染模式)
page = ChromiumPage()
page.get("https://example.com/login")

# 模拟填写登录表单并处理前端交互
page.ele("#username").input("crawler_demo")
page.ele("#password").input("Secret123!")
page.ele("button[type='submit']").click()

# 等待登录成功后进入个人中心
page.wait.load_start()
print("浏览器交互鉴权成功,当前网址:", page.url)

# 2. 将浏览器已生成的身份凭据无缝转交至纯 HTTP 会话 (s_mode)
session_page = SessionPage()
# 直接同步 Cookies 与 UA 标头
session_page.cookies.set(page.cookies(as_dict=True))

# 3. 后续 1000 个批量详情页全部走底层的极速纯请求模式
for item_id in range(1001, 1005):
    api_url = f"https://example.com/api/items/{item_id}"
    session_page.get(api_url)
    # 无需启动浏览器渲染,直接以毫秒级提取数据
    title = session_page.ele(".item-title").text
    print(f"[s_mode 采集成功] ID: {item_id}, 标题: {title}")

# 任务完成后关闭浏览器进程释放内存
page.quit()
四、方案三与终极方案:分布式框架集成与接口逆向
除了 Playwright 与 DrissionPage 这两款主流的单机/脚本级替代品,在面对更复杂的工程化项目时,还有以下两套高效解法:
1. 工业级分布式采集:Scrapy + Scrapy-Playwright
当爬取目标不是几个页面,而是包含数百万级深度 URL、复杂的去重队列(Redis)、失败重试与流水线持久化(MySQL/Elasticsearch)时,单体脚本往往力不从心。此时最佳方案是使用 Scrapy 结合官方维护的 scrapy-playwright 下载器中间件。
在该架构下,90% 的静态链接依然享受 Scrapy Twisted 异步引擎的极速吞吐;只有遇到显式打上 meta={"playwright": True} 标签的动态请求时,请求才会被路由至 Playwright 后台共享的浏览器实例进行渲染。这种“按需渲染”的设计,最大程度兼顾了系统吞吐率与复杂渲染能力。
2. 终极高效思维:穿透动态外壳,直击隐藏 JSON API
在资深爬虫工程师的理念中,“最快的动态网页抓取工具,就是不用任何浏览器渲染工具”。
现代 Web 框架(Vue、React、Angular)之所以能呈现动态效果,本质上是因为浏览器向服务端发起异步请求(Fetch / XHR)拉取了纯 JSON 数据包,随后由前端 JavaScript 代码拼接渲染成 HTML 标签。如果你打开浏览器的 F12 开发者工具,切换到“网络(Network)-> Fetch/XHR”面板,并刷新页面,绝大多数情况下都能直接定位到传输核心业务数据的真实 API 接口。
一旦找到该接口,就可以直接使用 httpx 或 requests 模拟请求头并附带必要参数发包。数据不仅以纯净的 JSON 字典格式返回、省去了 CSS/XPath 解析的工作,而且单次请求耗时仅需几十毫秒,消耗的内存不过几兆字节,效率比任何浏览器自动化工具高出几十倍。
五、综合选型对比与决策指南
为了帮助读者根据手头具体任务的技术要求与业务限制快速决策,下表对主流工具的各项核心指标进行了量化横向对比:
| 对比维度 | Selenium | Playwright | DrissionPage | Scrapy-Playwright | Direct API (HTTPX) |
|---|---|---|---|---|---|
| 底层通信协议 | W3C WebDriver HTTP | WebSocket 直连 CDP | 纯 CDP 直控 + Requests | Twisted + CDP | 底层 TCP / HTTP/2 |
| 异步并发支持 | 差(依赖线程/进程) | 极佳(原生 asyncio) | 良好(多线程/多进程) | 极佳(事件循环调度) | 最高(全异步并发) |
| 静态资源拦截 | 困难 / 需配置代理 | 原生支持(page.route) | 可配置 CDP 过滤 | 支持路由拦截 | 不下载任何静态文件 |
| 反爬绕过能力 | 弱(特征指纹明显) | 良(支持 stealth 插件) | 强(无 webdriver 标记) | 良(可定制请求头) | 需手动逆向签名参数 |
| 内存与 CPU 消耗 | 高(每个实例独立重度进程) | 中低(单进程多上下文) | 极低(动静自由切换) | 中(按需分配浏览器) | 几乎可以忽略 |
| 最佳适用场景 | 传统自动化测试系统 | 全功能现代爬虫、复杂 SPA | 单机快速采集、滑块攻坚 | 海量分布式大型抓取集群 | 有明确 API 的所有动态站点 |
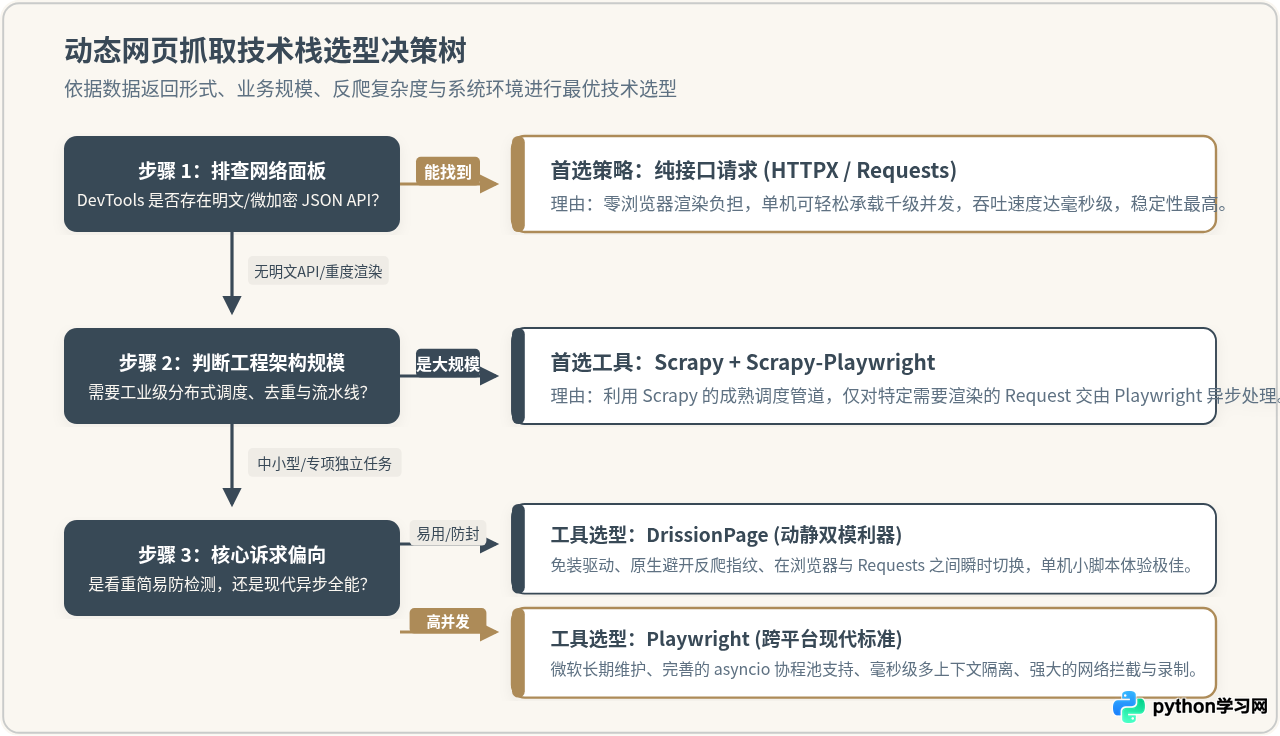
综上所述,当你的动态网页抓取项目遇到性能瓶颈或反爬限制时,摆脱 Selenium 的具体路径非常明确:
- 第一优先级:务必先打开开发者工具观察网络面板,能通过逆向抓包直接调用 JSON 接口的,坚决使用
httpx或requests; - 第二优先级:如果必须在本地编写轻量脚本完成自动化登录、规避滑块反爬,首选无需繁琐驱动配置且支持双模切换的 DrissionPage;
- 第三优先级:对于全平台、高并发、需要拦截无用资源并进行现代化工程管理的任务,首选微软的 Playwright;
- 第四优先级:面对企业级、分布式、百万级 URL 深度遍历项目,直接采用 Scrapy + Scrapy-Playwright 架构。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









