

用Python可以开发哪些实际项目?从爬虫到自动化脚本的案例清单
系统梳理使用Python进行实际开发的项目清单,涵盖日常办公自动化、定向网页数据采集、接口服务与系统监控工具的落地方案、代码范例与注意事项。
掌握了变量、循环和函数等基础语法后,学习Python最有效的方式是将其投入具体问题的解决中。Python丰富的生态库让它在办公文件处理、网络数据定向抓取、轻量API开发以及系统运维等场景下具备极高的工程效率。本文将梳理四类典型应用方向的落地清单,拆解核心逻辑、运行代码与执行边界,帮助你将技术转化为可复用的工具。
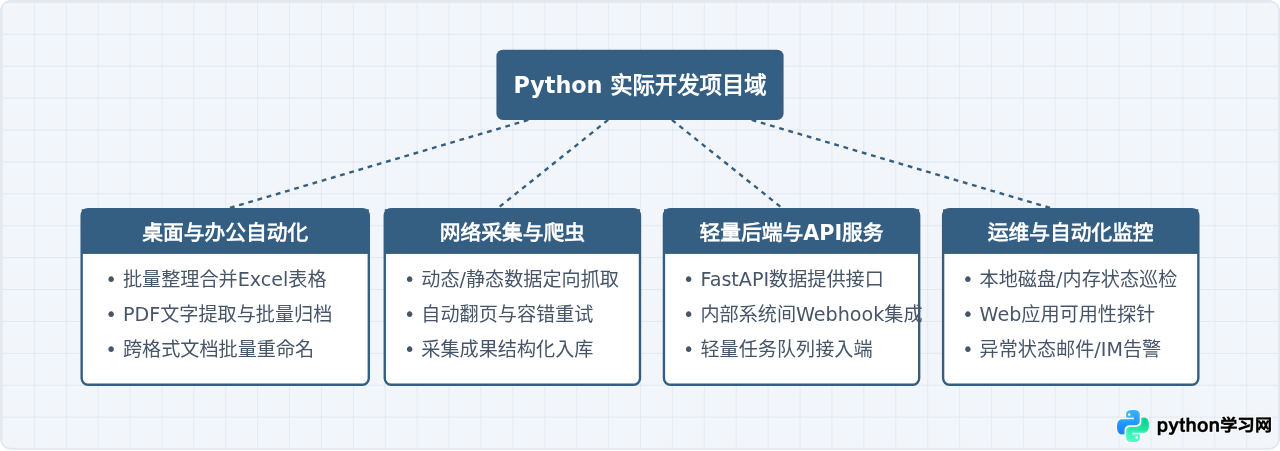
一、桌面与办公自动化项目
日常工作中,重复处理表格与文件往往占用大量机械劳动时间。借助标准库与成熟第三方库,Python可以代替人工完成这类确定性的操作。
项目案例:多部门月度报表合并与汇总工具
需求场景:每个月各业务组会提交格式一致但内容独立的 Excel 销售表。人工逐个复制粘贴不仅效率低,且极易遗漏记录或产生行列错位。
技术工具:pandas(用于数据合并与计算)或 openpyxl(用于样式保持)。针对纯数据分析任务,使用 pandas 可以在十几行代码内完成整个管道。
# 依赖安装:pip install pandas openpyxl
import os
import pandas as pd

def merge_excel_reports(source_dir, output_file):
    all_data = []
    # 遍历目标目录下的所有 .xlsx 文件
    for filename in os.listdir(source_dir):
        if filename.endswith(".xlsx") and not filename.startswith("~"):
            filepath = os.path.join(source_dir, filename)
            # 读取当前表格
            df = pd.read_excel(filepath)
            # 记录来源部门或文件名便于后续追溯
            df["来源文件"] = filename
            all_data.append(df)

    if not all_data:
        print("未找到可处理的 Excel 文件。")
        return

    # 纵向拼接所有表格并保存
    merged_df = pd.concat(all_data, ignore_index=True)
    merged_df.to_excel(output_file, index=False)
    print(f"合并完成,总计 {len(merged_df)} 行数据,已输出至:{output_file}")

# 示例调用
# merge_excel_reports("./sales_data", "2026年度汇总表.xlsx")pandas.concat 时,各子表的表头命名必须严格统一,否则表头不一致的列会分裂成多列并填充缺失值(NaN)。
二、定向网络数据采集与爬虫
数据采集是Python最典型的应用场景之一。从静态页面的HTML解析,到应对前后端分离的动态接口调用,合理运用库能降低请求与提取的阻力。
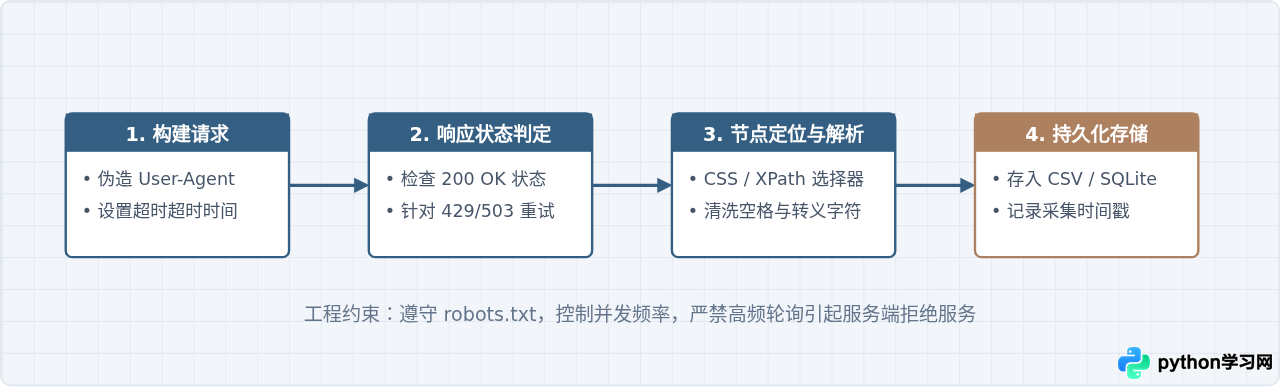
项目案例:行业资讯标题与时间定向采集器
需求场景:定期追踪某一技术论坛或新闻频道的最新发帖,将标题、链接及发布日期固化到本地,便于做趋势跟踪。
技术工具:requests 提供网络通信,BeautifulSoup(来自 bs4)解析 HTML 文档树。
# 依赖安装:pip install requests beautifulsoup4
import requests
from bs4 import BeautifulSoup
import csv
import time

def fetch_news_articles(target_url, output_csv):
    headers = {
        "User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36"
    }

    try:
        response = requests.get(target_url, headers=headers, timeout=10)
        response.raise_for_status() # 抛出 HTTP 错误码
    except requests.RequestException as e:
        print(f"请求失败: {e}")
        return

    soup = BeautifulSoup(response.text, "html.parser")
    articles = []

    # 根据页面实际 DOM 结构筛选目标标签(示例采用假定选择器)
    for item in soup.select(".news-card"):
        title_tag = item.select_one(".title a")
        date_tag = item.select_one(".post-date")

        if title_tag and date_tag:
            title = title_tag.get_text(strip=True)
            link = title_tag.get("href")
            date = date_tag.get_text(strip=True)
            articles.append({"标题": title, "链接": link, "日期": date})

    # 持久化到 CSV
    if articles:
        with open(output_csv, mode="w", newline="", encoding="utf-8-sig") as f:
            writer = csv.DictWriter(f, fieldnames=["标题", "链接", "日期"])
            writer.writeheader()
            writer.writerows(articles)
        print(f"成功采集并存储 {len(articles)} 条数据到 {output_csv}")
    else:
        print("未提取到匹配结构的数据,请检查选择器配置。")

# 示例调用
# fetch_news_articles("https://example.com/news", "news_export.csv")time.sleep() 延时控制,避免对目标服务器造成负荷;针对动态加载(由 JavaScript 异步渲染)的网页,优先通过浏览器“网络”(Network)选项卡排查原始 JSON 接口,若无公开接口再考虑引入 playwright 或 selenium。
三、轻量后端接口与数据微服务
很多时候,脚本分析产出的结果需要以接口的形式提供给团队前端、内网大屏或移动端。构建重型框架(如 Django)在小工具中略显冗余,而现代轻量框架能用更少的样板代码解决问题。
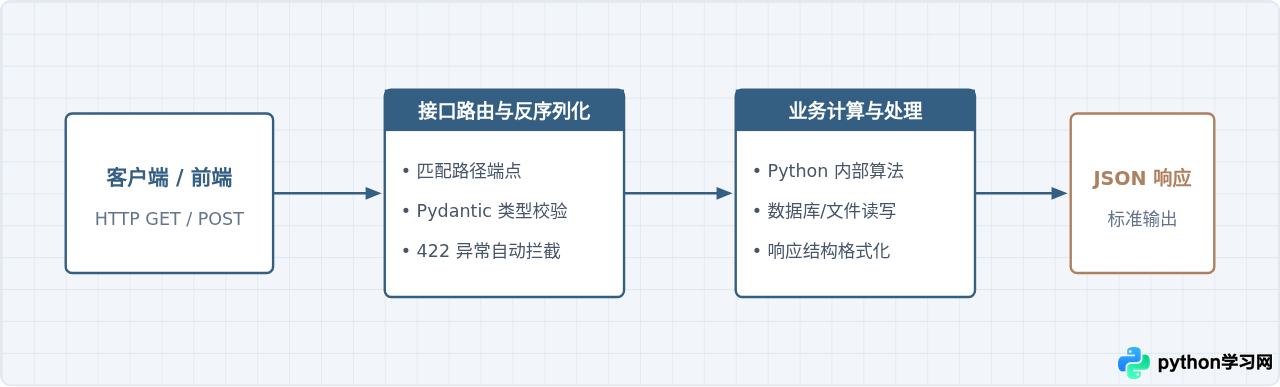
项目案例:文本分词与敏感词过滤 API
需求场景:业务系统需要一个轻量级的服务,在用户发帖或评论前对其进行词汇合规性检测,并输出检测结果与统计计数。
技术工具:FastAPI(异步Web框架)搭配 uvicorn(ASGI 服务器),结合 Pydantic 严格校验输入参数。
# 依赖安装:pip install fastapi uvicorn pydantic
from fastapi import FastAPI
from pydantic import BaseModel
from typing import List

app = FastAPI(title="内容检测服务", version="1.0.0")

# 定义黑名单字典
PROHIBITED_WORDS = {"违禁词A", "违规链接", "作弊软件"}

# 定义入参格式模型
class TextCheckRequest(BaseModel):
    content: str
    threshold: int = 1

# 定义输出格式模型
class TextCheckResponse(BaseModel):
    is_safe: bool
    detected_words: List[str]
    total_violations: int

@app.post("/api/v1/check", response_model=TextCheckResponse)
def check_text_safety(payload: TextCheckRequest):
    found = [word for word in PROHIBITED_WORDS if word in payload.content]
    is_safe = len(found) < payload.threshold

    return TextCheckResponse(
        is_safe=is_safe,
        detected_words=found,
        total_violations=len(found)
    )

# 启动命令(在终端中执行,非文件内):
# uvicorn filename:app --host 127.0.0.1 --port 8000 --reload
启动后,访问 http://127.0.0.1:8000/docs 即可获得由系统自动生成的交互式 Swagger API 文档,无需手动编写接口调试文档。
四、系统运维与自动化监控工具
生产服务器或个人工作站的硬件负载、存储容量和运行健康度,需要稳定的巡检机制。Python 标准库和底层监控库能够快速构建这类无界面守候进程。
项目案例:磁盘空间巡检与阈值预警脚本
需求场景:开发或备份服务器经常因为日志爆满导致系统宕机。通过定时任务监控指定挂载点的剩余空间,当使用率超过 85% 时触发告警。
技术工具:psutil 获取精准系统资源指标;smtplib 发送预警邮件,或通过 urllib.request 触发 Webhook 发送企业通讯软件消息。
# 依赖安装:pip install psutil
import psutil
import datetime

def check_disk_usage(threshold_percent=85.0):
    partitions = psutil.disk_partitions()
    warnings = []

    for partition in partitions:
        # 跳过只读系统文件或虚拟设备
        if "cdrom" in partition.opts or partition.fstype == "":
            continue
        try:
            usage = psutil.disk_usage(partition.mountpoint)
            if usage.percent >= threshold_percent:
                warnings.append({
                    "挂载点": partition.mountpoint,
                    "总容量(GB)": round(usage.total / (1024**3), 2),
                    "已用比例": f"{usage.percent}%"
                })
        except PermissionError:
            continue

    current_time = datetime.datetime.now().strftime("%Y-%m-%d %H:%M:%S")
    if warnings:
        print(f"[{current_time}] 触发磁盘容量告警!详情如下:")
        for item in warnings:
            print(f"  挂载点: {item['挂载点']} | 容量: {item['总容量(GB)']}GB | 当前占用: {item['已用比例']}")
        # 此处可扩展:调用 Webhook 或发送邮件通知
        return False
    else:
        print(f"[{current_time}] 磁盘空间正常,未超过阈值 {threshold_percent}%。")
        return True

# 示例调用
# check_disk_usage(threshold_percent=80.0)crontab -e 设置每小时定时运行该脚本;在 Windows 环境下,可使用“任务计划程序”配置开机或周期触发,将输出结果重定向到本地日志文本中。
五、项目类型选型与复杂度参考
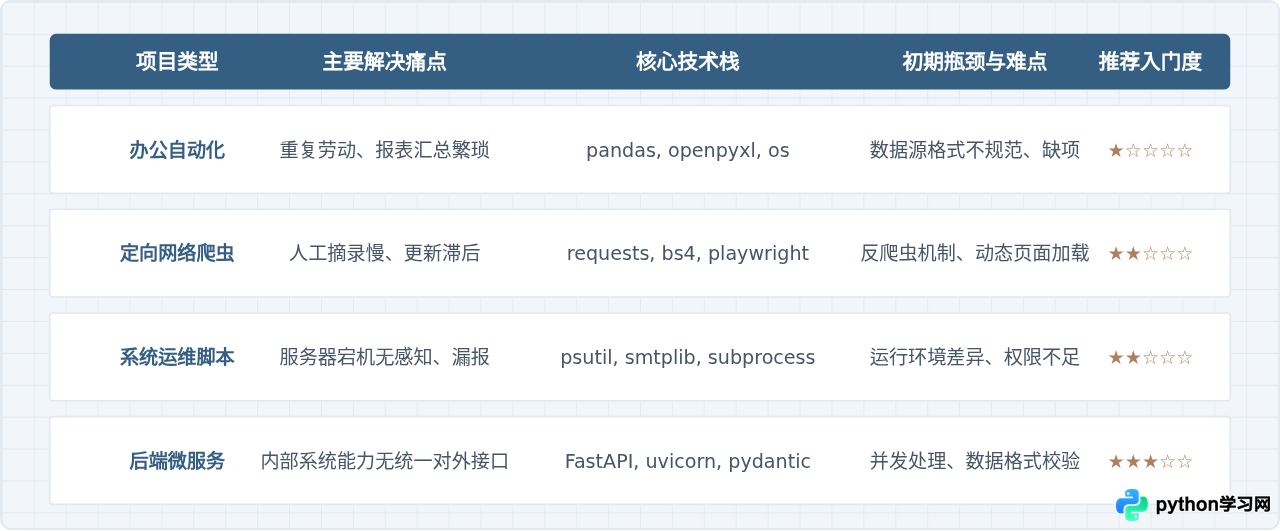
为了帮助读者根据当前的 Python 掌握程度选择合适的项目练手,下表归纳了不同项目的难点、常用核心库及产出效果:
六、总结与开发推进建议
在开展上述项目时,建议遵循“从最小闭环做起”的原则:
- 先写核心功能单点代码:例如做爬虫时,先通过一次
requests.get确认返回内容与解析表达式正确,再去写批处理循环与防封禁机制; - 尽早加入异常保护:所有的文件操作与网络通信都要套上
try...except,避免单行数据异常或单一请求超时导致整个长期运行的脚本崩溃退出; - 重视结构化输出:自动化脚本的终点往往是数据存储或告警,统一以 CSV、JSON 或 SQLite 等具备规整字段的格式沉淀,能为下一步的二次开发留出清晰的对接边界。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









