

怎么用函数封装Python计算器逻辑以提高代码可读性
详解如何通过职责拆分、纯运算函数提取、输入校验隔离与字典映射分发,将杂乱的Python计算器脚本重构为结构清晰、易于阅读和扩展的函数化代码。
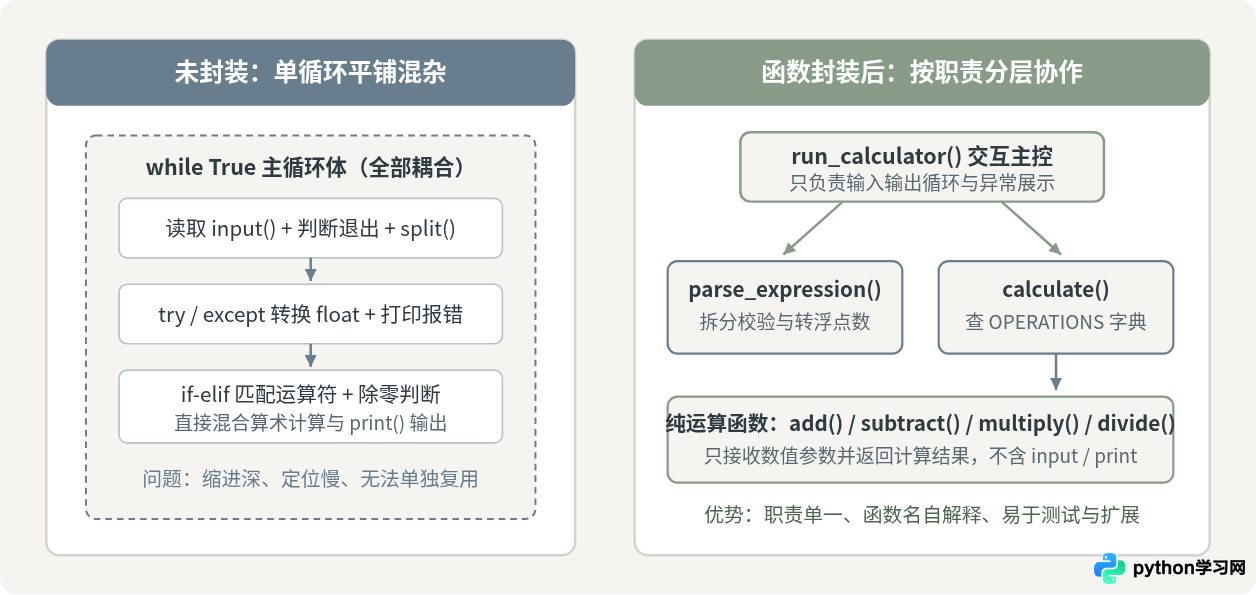
用函数封装 Python 计算器逻辑,核心做法是将原本混杂在同一个循环里的“读取输入、转换数值、判断运算符、执行计算、打印结果”拆分为职责独立的函数:由基础运算函数负责数学计算,由输入解析函数负责文本拆分与类型转换,由字典映射表代替冗长的 if-elif 分支完成路由,再由主函数串联交互流程。这样改动后,读者只需看函数名和参数就能理解每一步在做什么,修改某个规则时也不会误伤其他代码。
为什么未封装的计算器脚本难以阅读
初学者编写命令行计算器时,最常见的写法是把所有代码放进一个 while True 循环中。这种平铺式写法在只支持两个数相加时看似简短,但只要加入四则运算、除零检查、非数字输入捕获以及退出指令,循环体内部就会出现多层缩进嵌套。
下面是一段典型的未封装计算器代码(保存为 raw_calculator.py,适用于 Python 3.8 及以上环境):
# 文件名:raw_calculator.py
while True:
    raw = input("请输入算式(如 12 + 5,输入 q 退出): ").strip()
    if raw.lower() == "q":
        print("已退出计算器。")
        break
    parts = raw.split()
    if len(parts) != 3:
        print("格式错误:请按【数字 运算符 数字】格式输入,中间用空格分隔。")
        continue
    try:
        a = float(parts[0])
        b = float(parts[2])
    except ValueError:
        print("输入错误:操作数必须是有效数字。")
        continue

    op = parts[1]
    if op == "+":
        print("结果:", a + b)
    elif op == "-":
        print("结果:", a - b)
    elif op == "*":
        print("结果:", a * b)
    elif op == "/":
        if b == 0:
            print("计算错误:除数不能为 0。")
        else:
            print("结果:", a / b)
    else:
print(f"不支持的运算符: {op}")这段代码可以正常运行,但阅读和维护时会遇到三个明显障碍:第一,读者必须从头读到尾才能搞清楚程序支持哪些输入格式和哪些运算符;第二,input()、print() 与算术逻辑绑在一起,无法在其他脚本或单元测试中直接调用计算过程;第三,每增加一种新运算(比如求幂或取余),都要继续往主循环的 elif 链条里塞代码,主循环会越来越长。
用函数封装计算器逻辑的四个步骤
要把上面的脚本改造成高可读性的代码,不需要引入复杂的类或第三方库,只需按照“一个函数只做一件事”的原则,分四步完成封装。
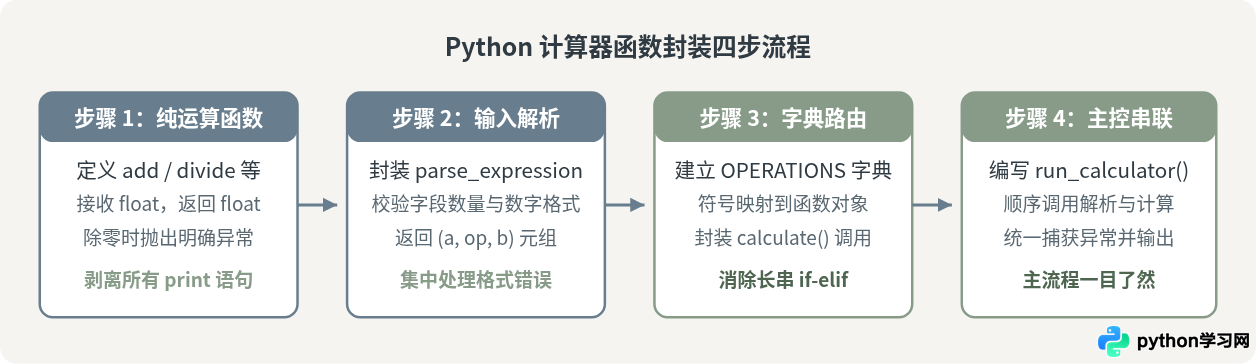
第一步:提取纯数学运算函数,分离计算与输出
首先把加、减、乘、除四种算术规则提取成独立的顶层函数,加上类型注解(Type Hints)。这些函数只接收两个浮点数 a 和 b,并通过 return 返回计算结果,内部绝对不调用 print()。
def add(a: float, b: float) -> float:
    """返回两个数的和。"""
    return a + b


def subtract(a: float, b: float) -> float:
    """返回 a 减去 b 的差。"""
    return a - b


def multiply(a: float, b: float) -> float:
    """返回两个数的乘积。"""
    return a * b


def divide(a: float, b: float) -> float:
    """返回 a 除以 b 的商;当 b 为 0 时抛出 ZeroDivisionError。"""
    if b == 0:
        raise ZeroDivisionError("除数不能为 0。")
    return a / b
之所以不在 divide() 里面直接 print("除数不能为 0"),是因为一旦用打印代替报错,当 b == 0 时函数默认会返回 None。如果后续代码接着拿返回值去做其他运算或格式化输出,就会触发意外的 TypeError。主动抛出 ZeroDivisionError 可以让调用方明确知道计算失败的原因。
第二步:封装输入解析函数,隔离字符串处理细节
用户输入的是原始字符串(例如 "12.5 * 4"),而计算函数需要的是两个浮点数和一个运算符字符串。将“拆分字符串、检查段数、转换浮点数”的过程封装进 parse_expression() 函数中,能够把繁琐的格式校验从主循环里彻底拿走。
def parse_expression(raw_input: str) -> tuple[float, str, float]:
    """
    将形如 '12 + 5' 的字符串解析为 (左操作数, 运算符, 右操作数)。
    若格式或数字无效,抛出带中文说明的 ValueError。
    """
    parts = raw_input.strip().split()
    if len(parts) != 3:
        raise ValueError("格式错误:请按【数字 运算符 数字】格式输入,中间用空格分隔。")

    left_str, operator, right_str = parts
    try:
        left_num = float(left_str)
        right_num = float(right_str)
    except ValueError as exc:
        raise ValueError("输入错误:运算符两侧必须是有效的数字。") from exc

    return left_num, operator, right_num
注意这里使用了元组解包 left_str, operator, right_str = parts,比在多处写 parts[0]、parts[1]、parts[2] 更容易读懂每个元素的含义。
第三步:用字典映射封装运算分发,替代长串 if-elif
在拿到解析后的 (left_num, operator, right_num) 后,下一步是根据运算符找到对应的计算函数。这里有两种常见写法:一种是继续在函数里写 if-elif 分支,另一种是使用 Python 字典将运算符字符串直接映射到函数对象。在相同的功能条件下,两者的差异如下:
| 对照维度 | 做法 A:在分发函数内写 if-elif 分支 |
做法 B:使用字典映射表 OPERATIONS 分发 |
|---|---|---|
| 代码表现形式 | 每个运算符占 2 行(一行判断条件、一行调用返回),运算符越多函数体越长。 | 配置表与执行逻辑分离,字典集中声明支持的所有符号,查找与调用只需 3 行固定代码。 |
| 新增运算时的改动范围 | 必须修改 calculate() 函数内部的条件分支结构。 |
calculate() 函数一行不改,只需定义新运算函数并在字典中增加一行键值对。 |
| 自解释与自省能力 | 无法直接通过代码结构获取“当前支持哪些运算符”的列表,报错提示需手动拼接。 | 可通过 OPERATIONS.keys() 动态生成支持的运算符列表,提示信息自动同步。 |
这种差异之所以重要,是因为当计算器支持求幂(**)、取余(%)、整除(//)等更多运算时,字典映射能让调度函数保持恒定长度,一眼就能看清全部支持的符号与对应函数的关系:
from typing import Callable

# 运算符到运算函数的映射表(注意:函数名后不要加括号)
OPERATIONS: dict[str, Callable[[float, float], float]] = {
    "+": add,
    "-": subtract,
    "*": multiply,
    "/": divide,
}


def calculate(a: float, operator: str, b: float) -> float:
    """根据运算符查找并执行对应的数学运算函数。"""
    operation_func = OPERATIONS.get(operator)
    if operation_func is None:
        supported = "、".join(OPERATIONS.keys())
        raise ValueError(f"不支持的运算符 '{operator}',当前仅支持:{supported}")
return operation_func(a, b)OPERATIONS 字典时,字典的值必须写函数名本身(如 "+": add),不能写成 "+": add()。如果加上括号,Python 会在定义字典的瞬间立即调用该函数并因缺少参数而报错;不加括号则是把函数对象存入字典,等 operation_func(a, b) 时才真正执行。
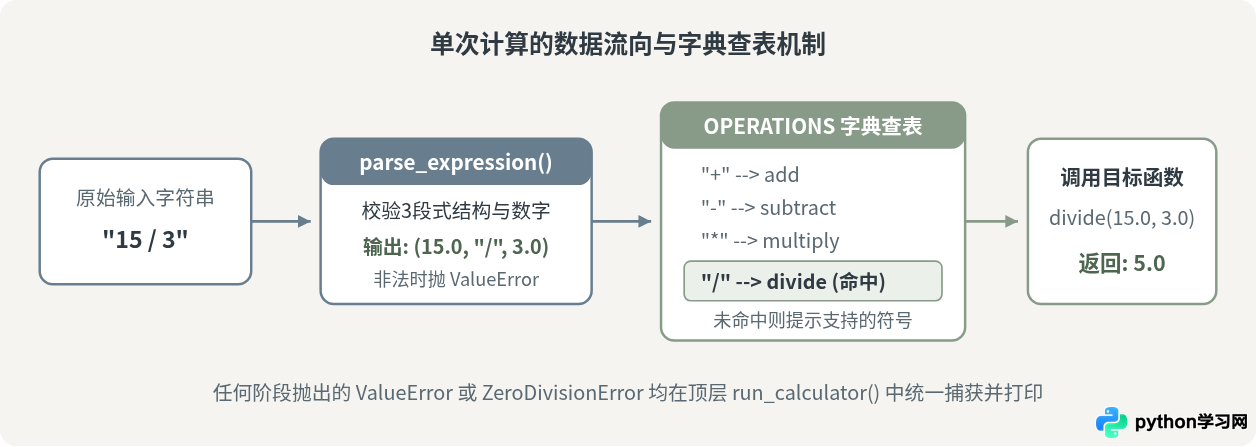
第四步:编写主控函数串联流程,统一处理交互与异常
当底层计算、输入解析和路由分发都已经封装完毕后,顶层的主控函数 run_calculator() 就不再需要关心任何底层算术细节。它的任务只剩下三个:读取用户输入、依次调用 parse_expression() 与 calculate()、捕获可能出现的异常并向用户打印友好提示。
为了让输出更符合日常阅读习惯(例如 12 + 5 显示为 17 而不是 17.0,而 7 / 2 显示为 3.5),还可以顺手封装一个小巧的 format_number() 辅助函数。
完整可运行的封装后代码与验证
将上述四个步骤组合起来,保存为工作目录下的 calculator.py(需要 Python 3.9 及以上版本以支持内置泛型注解 tuple[float, str, float];若使用 Python 3.7 或 3.8,可在文件第一行加上 from __future__ import annotations):
# 文件名:calculator.py
from __future__ import annotations
from typing import Callable


# ==================== 1. 纯数学运算层 ====================
def add(a: float, b: float) -> float:
    """返回两个数的和。"""
    return a + b


def subtract(a: float, b: float) -> float:
    """返回 a 减去 b 的差。"""
    return a - b


def multiply(a: float, b: float) -> float:
    """返回两个数的乘积。"""
    return a * b


def divide(a: float, b: float) -> float:
    """返回 a 除以 b 的商;除数为 0 时抛出异常。"""
    if b == 0:
        raise ZeroDivisionError("计算错误:除数不能为 0。")
    return a / b


# ==================== 2. 路由映射与调度层 ====================
OPERATIONS: dict[str, Callable[[float, float], float]] = {
    "+": add,
    "-": subtract,
    "*": multiply,
    "/": divide,
}


def calculate(a: float, operator: str, b: float) -> float:
    """根据运算符符号调用对应的数学运算函数。"""
    operation_func = OPERATIONS.get(operator)
    if operation_func is None:
        supported = "、".join(OPERATIONS.keys())
        raise ValueError(f"不支持的运算符 '{operator}',当前支持:{supported}")
    return operation_func(a, b)


# ==================== 3. 输入解析与格式化层 ====================
def parse_expression(raw_input: str) -> tuple[float, str, float]:
    """将用户输入的算式字符串解析为 (左操作数, 运算符, 右操作数)。"""
    parts = raw_input.strip().split()
    if len(parts) != 3:
        raise ValueError("格式错误:请按【数字 运算符 数字】格式输入,中间用空格分隔。")

    left_str, operator, right_str = parts
    try:
        left_num = float(left_str)
        right_num = float(right_str)
    except ValueError as exc:
        raise ValueError("输入错误:运算符两侧必须是有效的数字。") from exc

    return left_num, operator, right_num


def format_number(value: float) -> str:
    """若浮点数恰好为整数则去掉小数点后的 .0,否则保留原样。"""
    if value.is_integer():
        return str(int(value))
    return str(round(value, 10))


# ==================== 4. 命令行交互主控层 ====================
def run_calculator() -> None:
    """启动命令行计算器交互循环。"""
    supported_ops = " ".join(OPERATIONS.keys())
    print(f"=== Python 命令行计算器(支持运算符:{supported_ops},输入 q 退出)===")

    while True:
        raw_input = input("\n请输入算式: ").strip()
        if not raw_input:
            continue
        if raw_input.lower() in ("q", "quit", "exit"):
            print("已退出计算器。")
            break

        try:
            left_num, operator, right_num = parse_expression(raw_input)
            result = calculate(left_num, operator, right_num)
            print(f"计算结果: {format_number(result)}")
        except (ValueError, ZeroDivisionError) as err:
            print(err)


if __name__ == "__main__":
    run_calculator()
在终端中进入 calculator.py 所在目录,执行以下命令启动程序:
python3 calculator.py依次输入正常算式、小数算式、除零算式、错误格式和退出指令进行验证,以下为终端的示例输出:
=== Python 命令行计算器(支持运算符:+ - * /,输入 q 退出)===

请输入算式: 12 + 5
计算结果: 17

请输入算式: 7.5 * 2
计算结果: 15

请输入算式: 10 / 4
计算结果: 2.5

请输入算式: 9 / 0
计算错误:除数不能为 0。

请输入算式: 12+5
格式错误:请按【数字 运算符 数字】格式输入,中间用空格分隔。

请输入算式: q
已退出计算器。
观察重构后的 run_calculator(),它的核心逻辑只有三行:parse_expression() 解析输入、calculate() 计算结果、print() 输出格式化后的结果。即使是不了解内部细节的协作者,也能在几秒钟内看懂主循环在做什么。
如何验证封装后的扩展性与可测试性
衡量函数封装是否真正提高了代码可读性与可维护性,可以通过两个具体场景来检验。
场景一:新增“求幂”与“取余”功能
假设现在需要为计算器增加求幂(**)和取余(%)运算。在封装后的结构下,完全不需要阅读或改动 parse_expression() 和 run_calculator(),只需补充两个纯函数并在 OPERATIONS 字典中注册:
def power(a: float, b: float) -> float:
    """返回 a 的 b 次方。"""
    return a ** b


def modulo(a: float, b: float) -> float:
    """返回 a 除以 b 的余数;除数为 0 时抛出异常。"""
    if b == 0:
        raise ZeroDivisionError("计算错误:取余运算的除数不能为 0。")
    return a % b


OPERATIONS: dict[str, Callable[[float, float], float]] = {
    "+": add,
    "-": subtract,
    "*": multiply,
    "/": divide,
    "**": power,
    "%": modulo,
}
保存后重新运行程序,启动横幅和错误提示中的“支持运算符列表”会自动包含 ** 和 %,无需手动修改任何提示文字。
场景二:不启动交互循环,直接用代码验证计算逻辑
因为在文件末尾使用了 if __name__ == "__main__": 保护入口,并且计算函数不含 input() 和 print(),你可以在同一个目录下新建 test_calc.py,直接导入函数并用 assert 自动验证核心逻辑:
# 文件名:test_calc.py
from calculator import parse_expression, calculate

# 验证输入解析
assert parse_expression("  3.5   +  2 ") == (3.5, "+", 2.0)

# 验证四则运算结果
assert calculate(10, "+", 5) == 15.0
assert calculate(10, "-", 3) == 7.0
assert calculate(4, "*", 2.5) == 10.0
assert calculate(9, "/", 2) == 4.5

print("所有断言验证通过!")
这种无需人工反复在终端敲键盘就能验证代码正确性的能力,正是将 I/O 交互与核心计算函数解耦带来的直接收益。
函数封装提升可读性的关键检查清单
在日常编写或重构类似的小工具时,可以对照以下四个要点检查函数拆分是否到位:
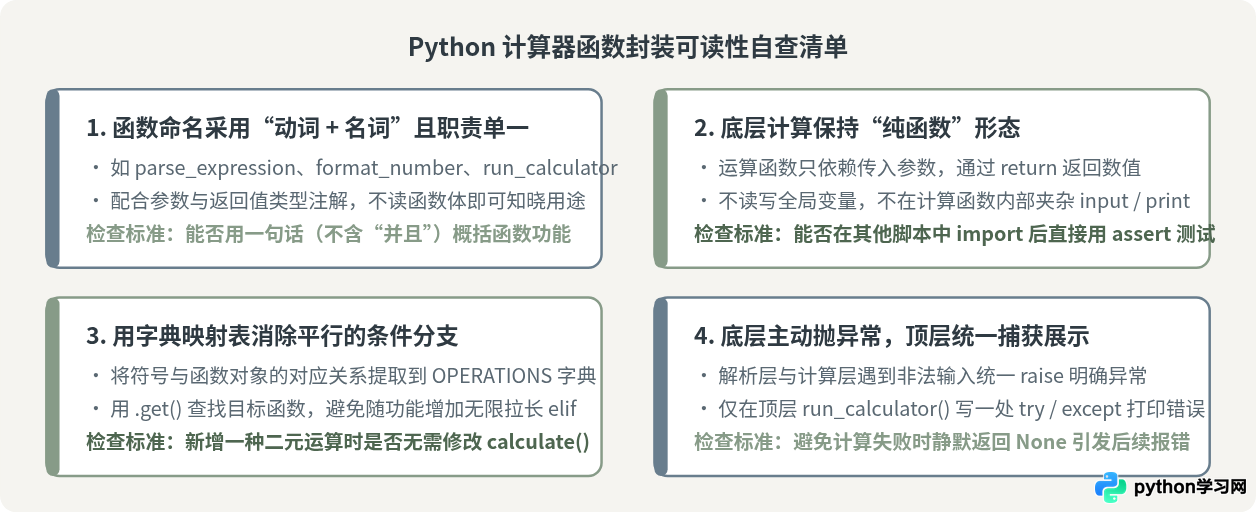
- 看主函数是否像目录:顶层函数应当只包含高层步骤的调用(解析输入、执行计算、打印结果),让人一眼看清全貌,而不是陷入字符串分割或算术公式的细节。
- 看计算函数是否足够纯粹:所有算术函数都不应该包含
input()或print(),也不修改外部全局变量,相同的参数永远返回相同的结果。 - 看分支是否转化为了配置:当多个
if-elif分支做的事情都是“根据某个符号调用签名一致的函数”时,优先用字典映射表替代条件判断。 - 看错误处理是否边界清晰:在发现问题的底层函数中通过
raise报告具体原因,在负责与用户对话的顶层函数中通过try...except统一接收并打印,避免到处散落错误处理代码。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









