

解决PyTorch非标量张量求导报错:gradient参数正确用法
深入解析PyTorch非标量张量调用backward()报错的数学本质与工程根源,详解gradient参数的正确赋值方法、标量化规约(sum/mean)的选型依据及排查指南。
y.backward() 时,程序会抛出 RuntimeError: grad can be implicitly created only for scalar outputs 错误。核心解决方案分为两类:如果模型仅需单一总体损失,应当先调用 y.sum() 或 y.mean() 进行标量规约再反向传播;如果需要保留各分量的独立导数,则必须向 backward() 显式传入与 y 形状相同的 gradient 权重张量。
1. 报错复现与数学根源解析
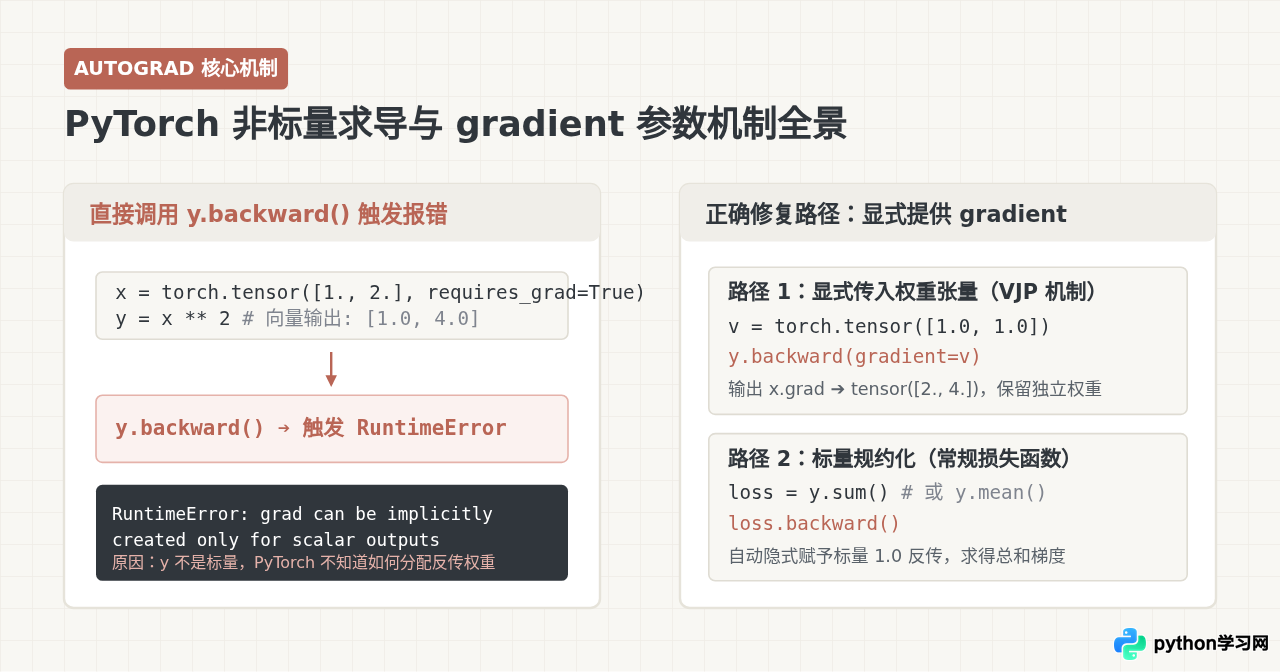
在深度学习日常开发中,绝大多数模型训练的最终输出都是一个标量损失(例如交叉熵或均方误差标量)。此时调用 loss.backward() 不需要任何额外参数,程序能够正常执行。但当目标张量是一个多维数组或一维向量时,直接调用 backward() 便会立即报错。
1.1 经典报错代码复现
通过以下简单的示例可以稳定复现该报错:
import torch

# 定义包含两个元素的输入向量
x = torch.tensor([2.0, 3.0], requires_grad=True)

# 进行逐元素运算,y 输出形状仍为 [2],属于非标量张量
y = x ** 2 + 3 * x

# 错误调用方式:直接对非标量张量执行反向传播
y.backward()
终端中输出的错误栈如下:
RuntimeError: grad can be implicitly created only for scalar outputs1.2 为什么必须是标量?浅析雅可比向量积(VJP)
从数学角度来看,假设输入变量是 $n$ 维向量 $\mathbf{x} = [x_1, x_2, \dots, x_n]^T$,输出也是一个 $m$ 维向量 $\mathbf{y} = [y_1, y_2, \dots, y_m]^T$。在多元微积分中,$\mathbf{y}$ 对 $\mathbf{x}$ 的完全导数是一个 $m \times n$ 的雅可比矩阵(Jacobian Matrix)$J$:
J = [ ∂y_i / ∂x_j ] (其中 i=1..m, j=1..n)
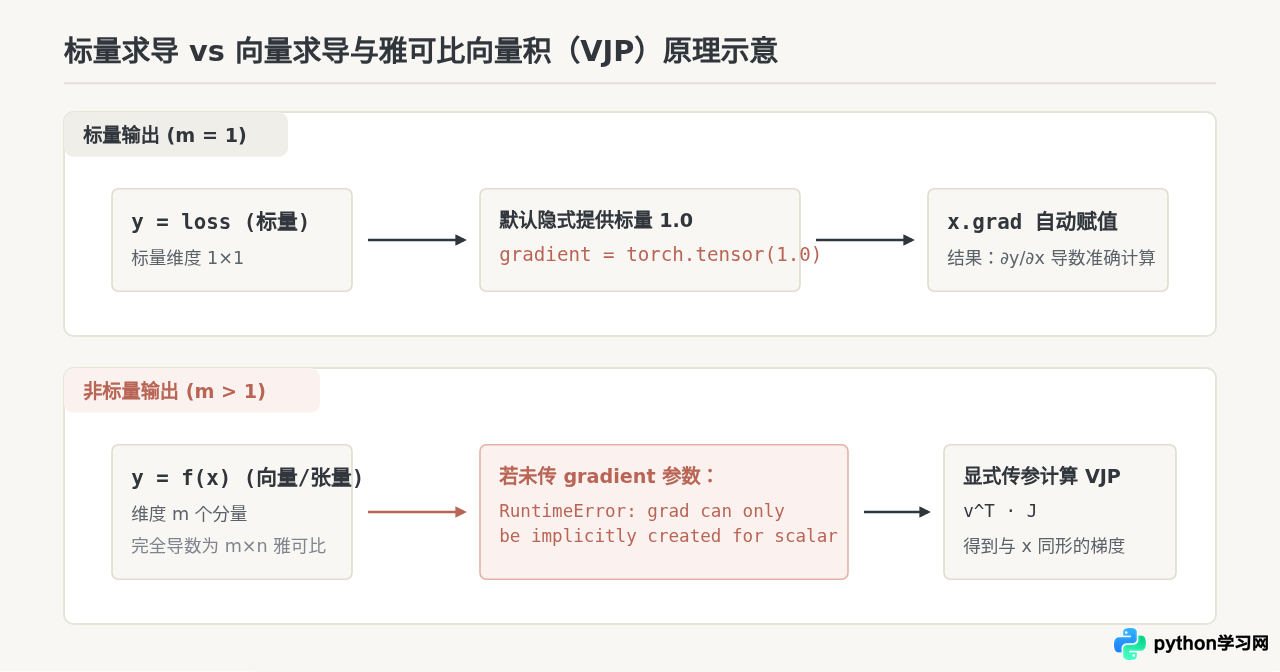
PyTorch 的自动求导引擎(Autograd)在设计上并不是用来直接计算和存储完整的雅可比矩阵的,因为在现代神经网络中,输出与输入的维度动辄数百万,直接实例化完整的雅可比矩阵会导致内存瞬间爆炸。Autograd 真正执行的是雅可比向量积(Vector-Jacobian Product, 简称 VJP):给定一个外部权重向量 $\mathbf{v}$,计算 $\mathbf{v}^T J$。
当输出 $\mathbf{y}$ 是标量时(即 $m=1$),雅可比矩阵退化为一个行向量,此时外部向量 $\mathbf{v}$ 只能是标量 $1.0$。PyTorch 在内部默认隐式传递了 torch.tensor(1.0),因而开发者无需手动指定。但当 $\mathbf{y}$ 是非标量时,外部向量 $\mathbf{v}$ 有无限种取值可能,PyTorch 无法猜测开发者的意图,因此强制要求开发者通过 gradient 参数提供向量 $\mathbf{v}$。
2. 解决方案一:通过标量规约(sum / mean)解决
在绝大多数深度学习任务中,例如批处理(batch)损失计算,网络的前向传播可能为每个样本分别计算了一个损失值,从而导致输出张量维度为 [batch_size]。如果业务目标是求出整个批次的总梯度或平均梯度,那么最简单直接、也最符合直觉的方案就是先将向量规约为标量。
2.1 使用 sum() 或 mean() 规约
import torch

x = torch.tensor([2.0, 3.0], requires_grad=True)
y = x ** 2 + 3 * x  # y 为 [10.0, 18.0]

# 方案 A:求和规约。数学等价于为每个分量赋予权重 1.0
loss_sum = y.sum()
loss_sum.backward()
print("sum() 规约梯度:", x.grad)
# 输出: tensor([7., 9.])  (由 2*x + 3 计算而来)

# 重置梯度
x.grad.zero_()

# 方案 B:均值规约。数学等价于为每个分量赋予权重 1/N
loss_mean = y.mean()
loss_mean.backward()
print("mean() 规约梯度:", x.grad)
# 输出: tensor([3.5000, 4.5000])
何时选择此方案? 当每个输出分量最终都要聚合为一个总体目标(如最小化总损失)时,无需引入 gradient 参数,直接在计算图中加入 sum() 或 mean() 是最规范的做法。
3. 解决方案二:正确传入 gradient 参数
如果业务场景要求保留各输出分量的独立权重,或者需要分别提取某个特定分量对于输入的偏导数(例如物理仿真、敏感度分析、对抗样本生成),就不能直接规约,而必须使用 gradient 参数。
3.1 基本用法:形状严格匹配
gradient 参数必须满足两个核心硬性条件:张量形状必须与当前调用 backward() 的张量完全一致;设备(CPU/CUDA)与浮点精度(dtype)必须匹配。
import torch

x = torch.tensor([2.0, 3.0], requires_grad=True)
y = x ** 2 + 3 * x  # y 的 shape 为 torch.Size([2])

# 创建与 y 形状完全一致的外部权重向量 v
v = torch.tensor([1.0, 1.0], dtype=torch.float32)

# 正确调用:通过 gradient 显式传入权重向量
y.backward(gradient=v)

print("反向传播梯度:", x.grad)
# 输出: tensor([7., 9.]),与 y.sum().backward() 的计算结果完全一致
3.2 高级场景:计算特定输出分量的偏导数
假设我们只想求 $y_1$ 对 $x$ 的导数,而忽略 $y_2$。我们只需将权重向量构造为一个单热(One-hot)基向量:
x.grad.zero_()

# 若需要多次 backward,需保留计算图 retain_graph=True
y = x ** 2 + 3 * x

# 仅对第一个分量求导:v = [1.0, 0.0]
v1 = torch.tensor([1.0, 0.0])
y.backward(gradient=v1, retain_graph=True)
print("仅针对 y[0] 的梯度:", x.grad)
# 输出: tensor([7., 0.])

# 清空梯度后,对第二个分量求导:v = [0.0, 1.0]
x.grad.zero_()
v2 = torch.tensor([0.0, 1.0])
y.backward(gradient=v2)
print("仅针对 y[1] 的梯度:", x.grad)
# 输出: tensor([0., 9.])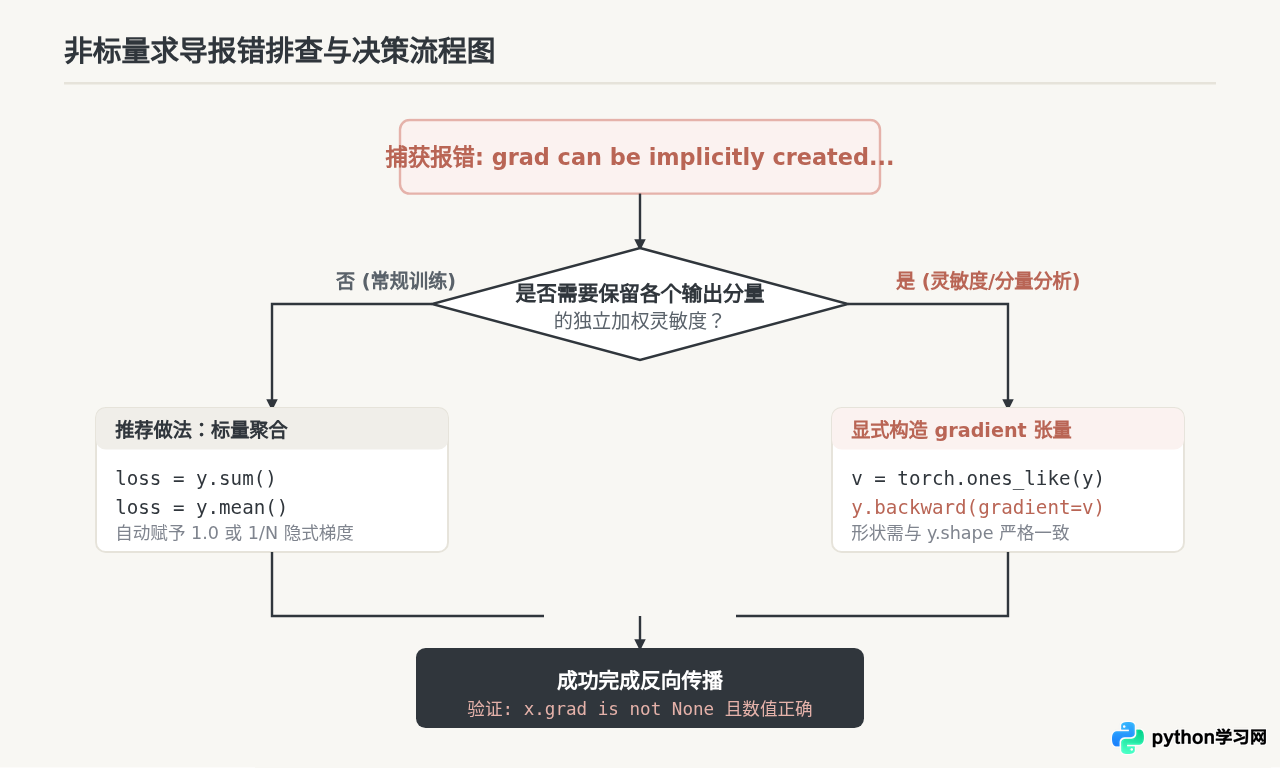
4. gradient 参数与标量规约的详细对比
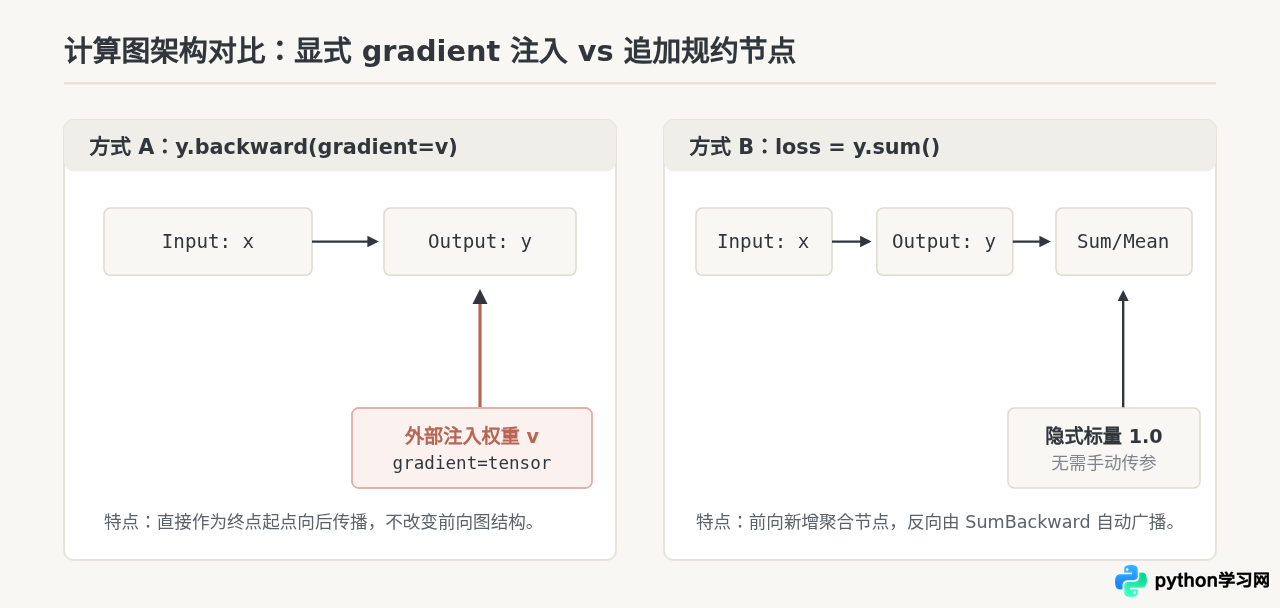
很多初学者会疑惑:y.backward(gradient=torch.ones_like(y)) 和 y.sum().backward() 是否完全相同?从数学计算结果来看,两者完全等价。但在底层机制、内存开销以及实际工程用途上存在明显区别。
| 对比维度 | 显式传参:y.backward(gradient=v) | 标量规约:y.sum().backward() |
|---|---|---|
| 计算图节点 | 不向计算图增加新的聚合操作节点 | 在计算图中追加一个 SumBackward0 运算节点 |
| 显存/内存占用 | 需在 Python 侧显式分配张量 v | 节点在 C++ 引擎中即时计算,无需外部显式分配 |
| 权重分配灵活性 | 极高:可为每个元素独立定制任意实数权重 | 固定:所有元素均匀权重(sum 为 1,mean 为 1/N) |
| 典型应用场景 | 雅可比矩阵逐列提取、灵敏度分析、GAN特定损失加权 | 普通深度学习模型常规训练批处理损失 |
5. 避坑指南:使用 gradient 时的三大常见错误
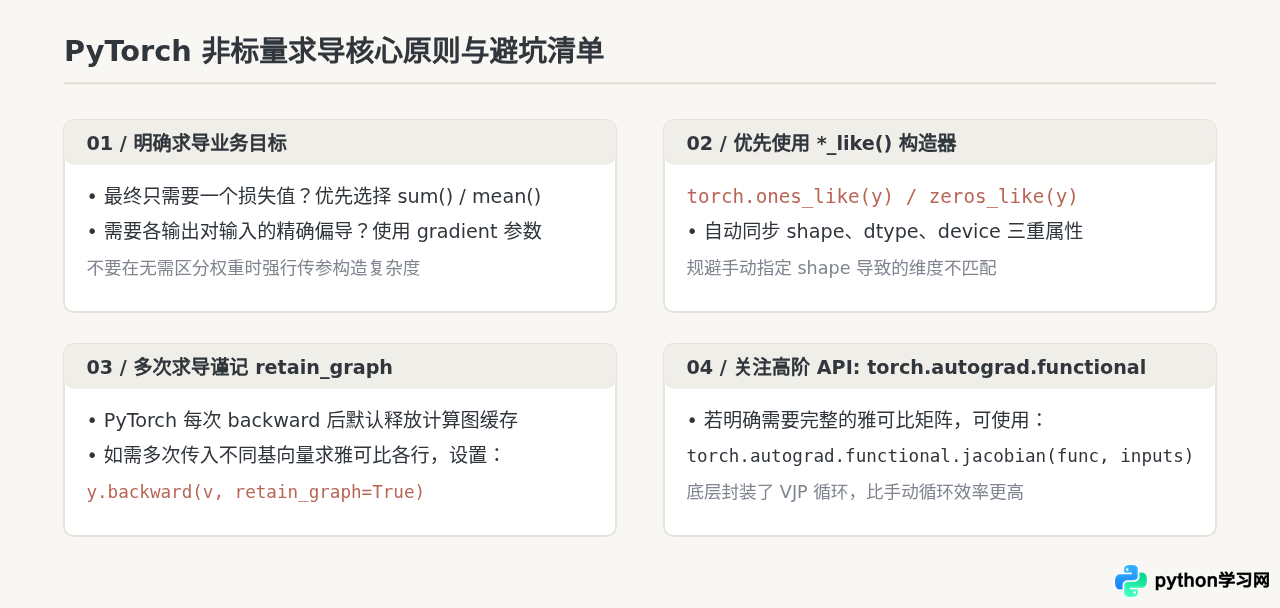
如果 y 的形状是 [2, 3],传入形状为 [6] 或 [1, 6] 的张量会导致 RuntimeError: Mismatch in shape: grad_output[0] has a different size ...。解决办法: 使用 torch.ones_like(y) 构造与 y 严格同形同设备的张量。
当模型与数据在 GPU(CUDA)上运行时,如果在 CPU 上创建了 gradient = torch.tensor(...) 并传入,会引发设备不一致报错。解决办法: 创建时显式指定 device=y.device,或使用 v = torch.ones_like(y),它会自动继承 y 的设备配置。
若输入张量 x 和输出 y 采用双精度 torch.float64 或半精度 torch.float16,而 gradient 使用默认单精度 torch.float32,可能引发精度降级或类型不匹配。解决办法: 指定 dtype=y.dtype 保持一致。
6. 总结
遇到 RuntimeError: grad can be implicitly created only for scalar outputs 时,读者不必慌张,这只是 PyTorch 保护机制的一部分——提示当前求导目标包含多个输出分量,引擎无法确定各分量的聚合权重。处理流程可归纳为两句话:
- 若需要将各分量汇聚为总体标量,在反向传播前使用
.sum()或.mean(); - 若需要保留各分量的独立导数,使用
torch.ones_like(y)或特定基向量作为gradient参数传入y.backward(gradient=...)。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









