

Python ThreadPoolExecutor实现多任务并发处理教程
深入浅出讲解 Python 标准库 concurrent.futures.ThreadPoolExecutor 的使用方法与原理,包含工作队列、submit 与 map 的用法区别、as_completed 异步收集、异常处理及工程落地的参数配置指南。
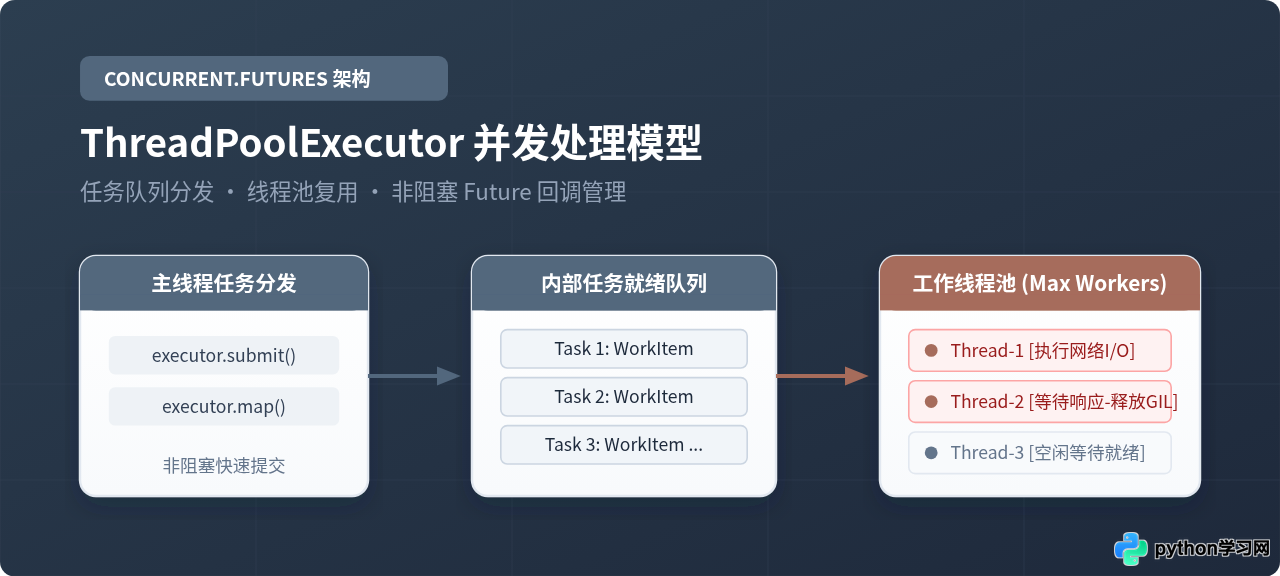
在编写 Python 脚本处理网络抓取、调用第三方 REST API 或进行大批量文件下载时,以传统的单线程循环方式执行往往效率低下。因为网络请求和磁盘读写绝大部分时间消耗在等待外部响应的 I/O 阻塞上,CPU 大部分时间处于闲置状态。Python 标准库自带的 concurrent.futures.ThreadPoolExecutor 提供了高层次的线程池抽象,使得开发者无需手动管理底层线程创建、生命周期与同步锁,只需将函数和参数投递给线程池,即可安全、高效地实现多任务并发调度。
一、ThreadPoolExecutor 核心架构与运行机制
理解 ThreadPoolExecutor 的运转流程有助于我们在后续编写代码时避开资源泄漏与死锁。从架构上看,它主要由三大部分构成:工作队列(WorkQueue)、工作线程池(Worker Pool)以及Future 对象。
当开发者向线程池提交一个任务时,该任务连同其传入的参数被打包为一个工作项(_WorkItem),并放入内部的线程安全先进先出队列中。线程池内维护了一组固定或动态上限的工作线程,这些线程不断从队列中争抢就绪任务进行执行。任务完成后,线程将返回值或触发的异常写入关联的 Future 对象中,并唤醒所有正在等待该任务的主线程监听者。
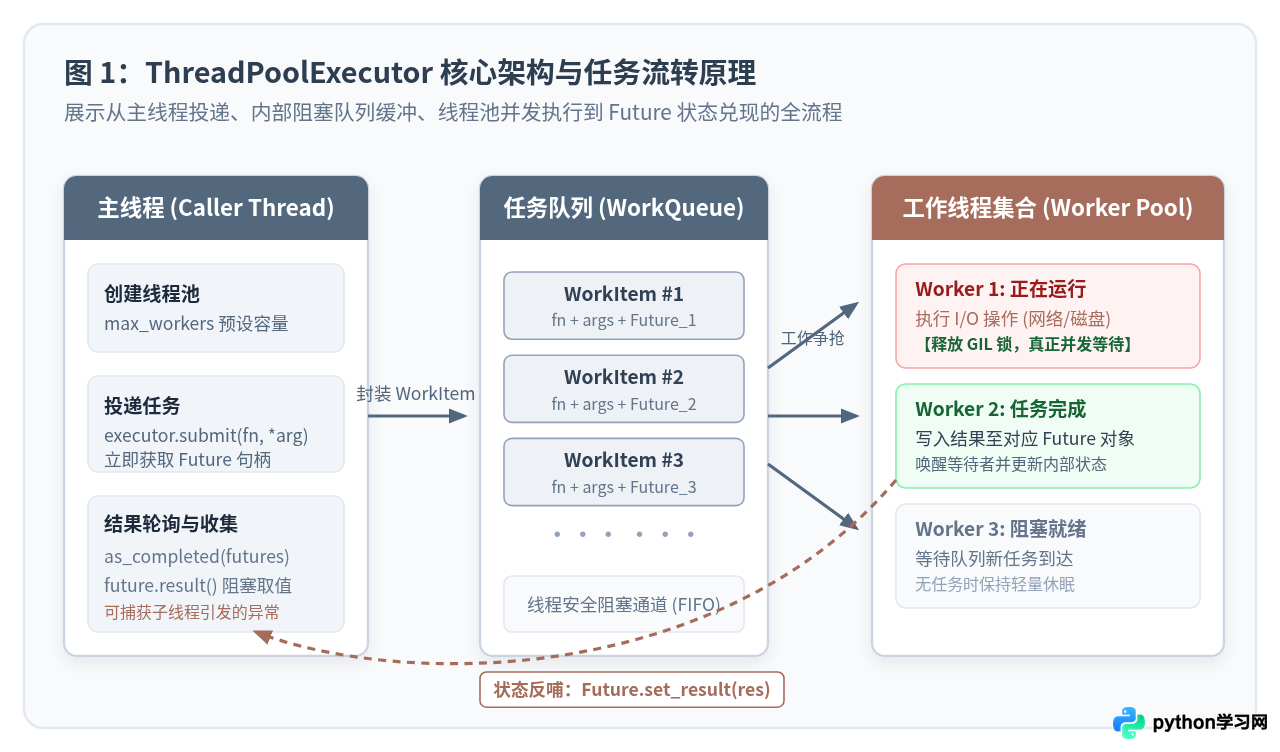
很多初学者会疑惑:Python 不是有全局解释器锁(GIL,Global Interpreter Lock)吗?多线程真的能并发吗?这里的关键在于任务类型。在纯算力消耗(如密集数学矩阵计算、视频软件解码)等 CPU 密集型任务中,GIL 确实会强制单核执行,导致多线程无法提速甚至因频繁上下文切换变慢。但在网络 I/O、磁盘读写或 time.sleep 期间,Python 底层 C 扩展与操作系统系统调用会主动释放 GIL。此时其他工作线程即可获得 GIL 并在 CPU 上运行,实现多个网络或读写请求在内核层面的真正并发等待。
二、标准调用规范:上下文管理器与基础示例
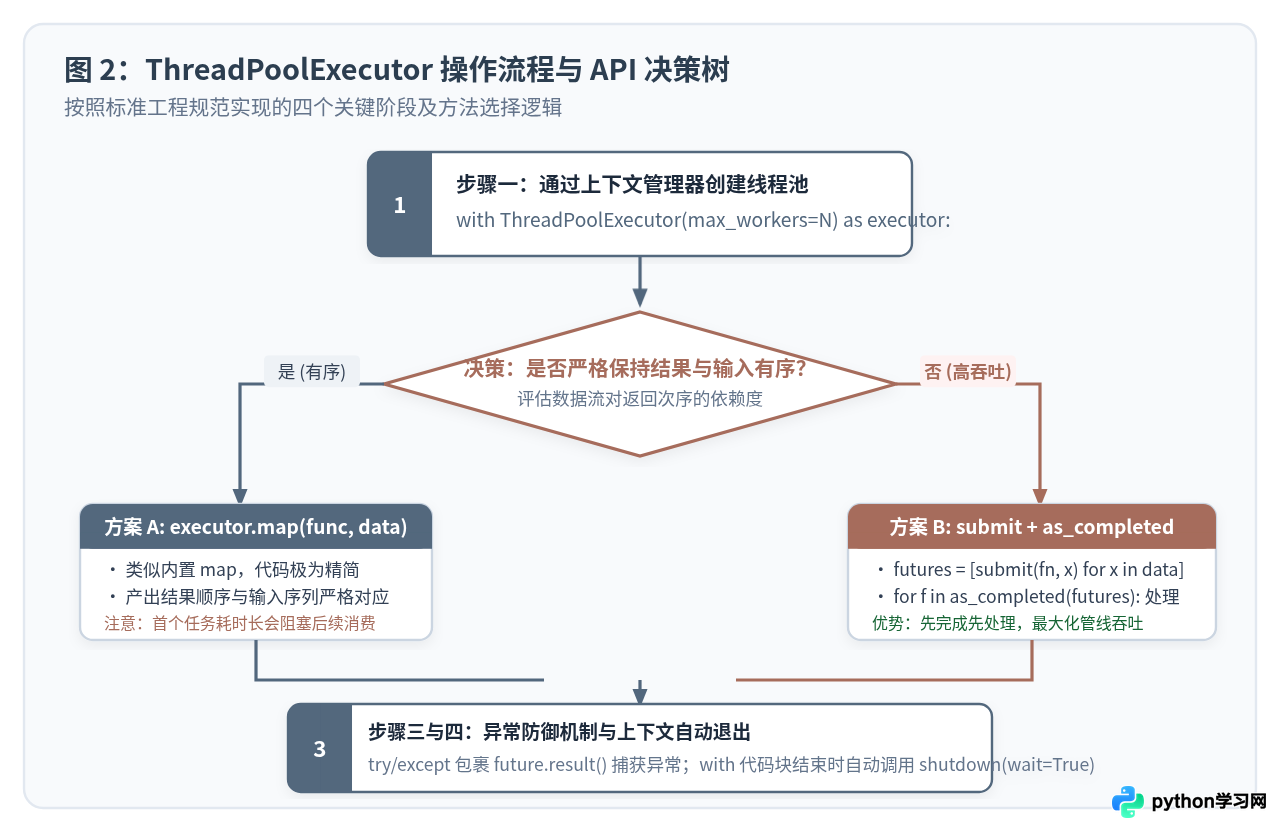
使用 ThreadPoolExecutor 最规范的方式是借助 Python 的 with 上下文管理器语法。这样能确保在代码块执行结束或意外抛出异常跳出时,线程池能够自动执行 shutdown(wait=True),妥善回收内部系统线程并等待既有任务收尾,避免线程游离失控。
下面是一个模拟批量抓取网页内容的完整示例。我们在本地执行环境中使用标准库模拟执行时间与并发效果:
import time
from concurrent.futures import ThreadPoolExecutor

def fetch_task(task_id: int, delay_seconds: float) -> str:
    """模拟一个耗时的网络 I/O 任务"""
    print(f"[{time.strftime('%X')}] 任务 {task_id} 开始执行,预计耗时 {delay_seconds} 秒")
    time.sleep(delay_seconds)
    print(f"[{time.strftime('%X')}] 任务 {task_id} 执行完毕")
    return f"任务 {task_id} 结果数据"

if __name__ == "__main__":
    tasks = [(1, 1.5), (2, 0.8), (3, 1.2), (4, 0.5)]
    start_time = time.time()

    # 创建一个容量为 3 的工作线程池
    with ThreadPoolExecutor(max_workers=3) as executor:
        # 使用 submit 分别投递每个任务
        futures = [executor.submit(fetch_task, tid, delay) for tid, delay in tasks]

        # 逐个获取任务结果
        for f in futures:
            print(f"主线程收到返回值: {f.result()}")

    total_time = time.time() - start_time
    print(f"所有任务执行完毕,总耗时: {total_time:.2f} 秒")
[14:30:00] 任务 1 开始执行,预计耗时 1.5 秒
[14:30:00] 任务 2 开始执行,预计耗时 0.8 秒
[14:30:00] 任务 3 开始执行,预计耗时 1.2 秒
[14:30:00] 任务 2 执行完毕
[14:30:00] 任务 4 开始执行,预计耗时 0.5 秒
[14:30:01] 任务 4 执行完毕
[14:30:01] 任务 3 执行完毕
[14:30:01] 任务 1 执行完毕
主线程收到返回值: 任务 1 结果数据
主线程收到返回值: 任务 2 结果数据
主线程收到返回值: 任务 3 结果数据
主线程收到返回值: 任务 4 结果数据
所有任务执行完毕,总耗时: 1.51 秒
在单线程串行模式下,4 个任务的总耗时将是各个任务时长的累加:1.5 + 0.8 + 1.2 + 0.5 = 4.0 秒。而在 3 个工作线程的并发调度下,总耗时缩减至 1.51 秒,耗时取决于并发执行中最长的那条时间线,效率提升非常显著。
三、核心 API 选型:submit 与 map 的异同与时序差异
在 ThreadPoolExecutor 中,分发任务有两个核心入口方法:executor.submit() 和 executor.map()。它们虽然都能派发任务,但在返回值组织方式、调用时序以及异常展现上存在根本差别。
1. executor.map():保持输入次序的快速映射
executor.map(func, *iterables) 的语法与 Python 内置的 map() 非常相似。它直接接收一个函数和一个可迭代参数列表,返回一个生成器,逐个产出执行结果。
它的核心特性在于保序性:无论子线程中哪个任务先跑完,map() 生成器产出元素的顺序必须与传入的列表顺序完全一致。如果第一个任务耗时很长,即使后面的短任务早就执行完成,遍历 map 结果的迭代器也会挂起等待,直到第一个任务出列后才继续输出。
2. executor.submit() + as_completed():无序的高性能流式消费
如果后续逻辑并不依赖任务的原始排列顺序,只希望“谁先完成就立即处理谁”,那么应该使用 executor.submit() 搭配 concurrent.futures.as_completed()。
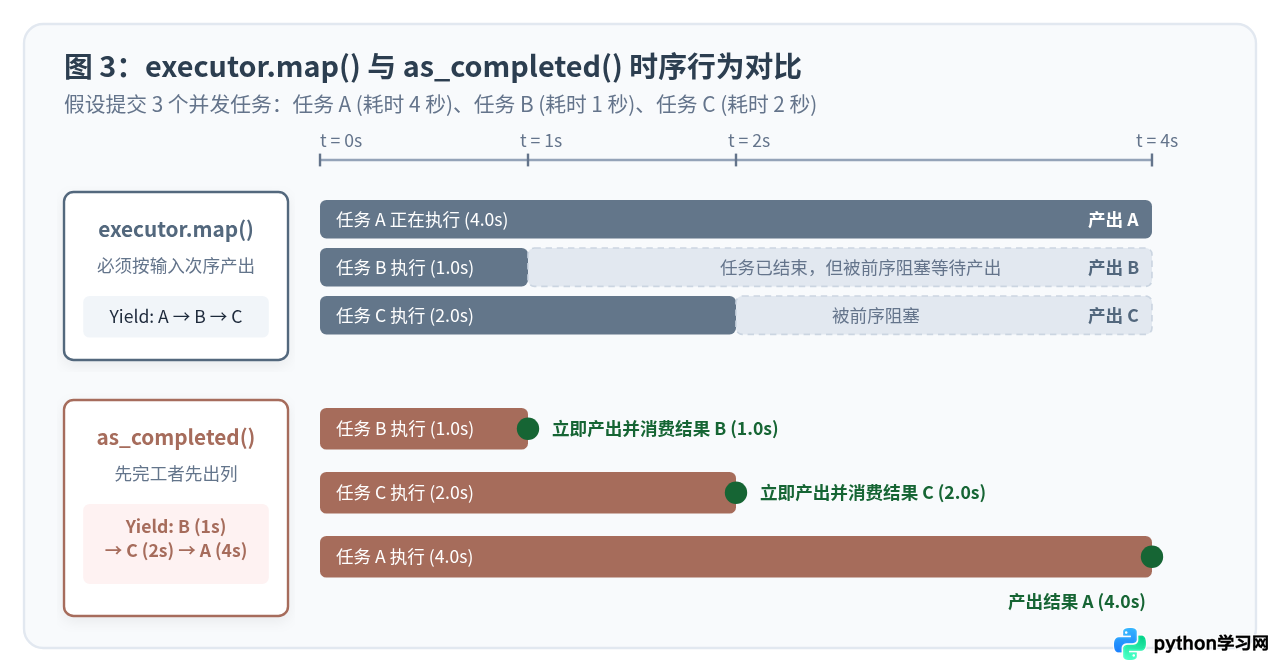
对比两者的时序图可以清晰看到:在存在任务耗时分布不均的真实场景下,as_completed() 可以在 1.0 秒时立刻释放处理资源,而 map() 必须在 4.0 秒首个长任务完成后才集中吐出。对于管道流水线(如爬取一个页面立即解析存库)的场景,as_completed() 的吞吐表现要优越得多。
from concurrent.futures import ThreadPoolExecutor, as_completed
import time

def scrape_url(url: str, cost: int) -> dict:
    time.sleep(cost)
    return {"url": url, "status": 200, "cost": cost}

url_data = [
    ("https://api.example.com/item/A", 4),
    ("https://api.example.com/item/B", 1),
    ("https://api.example.com/item/C", 2),
]

with ThreadPoolExecutor(max_workers=3) as executor:
    # 建立 Future 与原始请求参数的映射字典,便于回调追踪
    future_to_url = {
        executor.submit(scrape_url, url, cost): url
        for url, cost in url_data
    }

    # 按照实际完成的时间先后产出
    for future in as_completed(future_to_url):
        origin_url = future_to_url[future]
        try:
            res = future.result()
            print(f"[{time.strftime('%X')}] 消费完成: {origin_url} (耗时: {res['cost']}s)")
        except Exception as exc:
            print(f"[{time.strftime('%X')}] {origin_url} 发生异常: {exc}")
[14:35:01] 消费完成: https://api.example.com/item/B (耗时: 1s)
[14:35:02] 消费完成: https://api.example.com/item/C (耗时: 2s)
[14:35:04] 消费完成: https://api.example.com/item/A (耗时: 4s)
四、关键细节:异常处理与线程安全锁
在实际生产编码中,多线程并发最常见的隐患有两个:一是子线程报错未能及时察觉导致业务静默中断;二是多个线程同时操作共享内存引起数据错乱。
1. 警惕子线程异常的“静默吞没”
与单线程代码不同,如果工作线程执行任务函数时内部抛出未捕获的异常,主程序并不会立刻崩溃退出。相反,这个异常会被工作线程捕获并暂存在关联的 Future 实例中。
future.result() 时,暂存的异常才会被重新在调用线程中抛出;或者显式调用 future.exception() 检查是否存在错误。如果你提交任务后从未读取 result(),任务内部的报错就会被彻底掩盖。
def unsafe_division(x: int) -> float:
    return 100 / x

with ThreadPoolExecutor(max_workers=2) as executor:
    futures = [executor.submit(unsafe_division, val) for val in [10, 0, 5]]
    for f in futures:
        try:
            val = f.result()
            print(f"运算成功: {val}")
        except ZeroDivisionError:
            print("捕获除零异常,已安全进行降级处理")
        except Exception as err:
            print(f"捕获未知错误: {err}")
2. 共享变量与 threading.Lock 加锁
多线程运行在同一个 Python 进程中,共享全局变量与堆对象。如果在并发任务中包含自增计数器或操作公共列表、字典,即使类似 count += 1 这样看似简短的代码,在底层字节码也是由“读取、修改、写回”多步完成的,高并发下会出现严重的竞态冲突(Race Condition)。
解决方式是保持任务函数的无状态设计,即让任务各自返回计算好的数值,由主线程负责收集汇总;若必须跨线程实时写共享资源,必须配合 threading.Lock 进行加锁防护:
import threading
from concurrent.futures import ThreadPoolExecutor

shared_counter = 0
counter_lock = threading.Lock()

def safe_increment():
    global shared_counter
    # 模拟读写操作
    with counter_lock:
        shared_counter += 1

with ThreadPoolExecutor(max_workers=10) as executor:
    for _ in range(100):
        executor.submit(safe_increment)

print(f"最终准确计数: {shared_counter}")  # 始终保证等于 100
五、线程池容量规划与工程总结
设置 max_workers 时并非数值越大越好。每个系统线程都会占用独立的栈内存(Linux 默认通常为 8MB),且操作系统的线程上下文切换也会带来调度损耗。如果针对同一个目标接口开启过多并发,还极易触发服务端的限流与封禁机制。
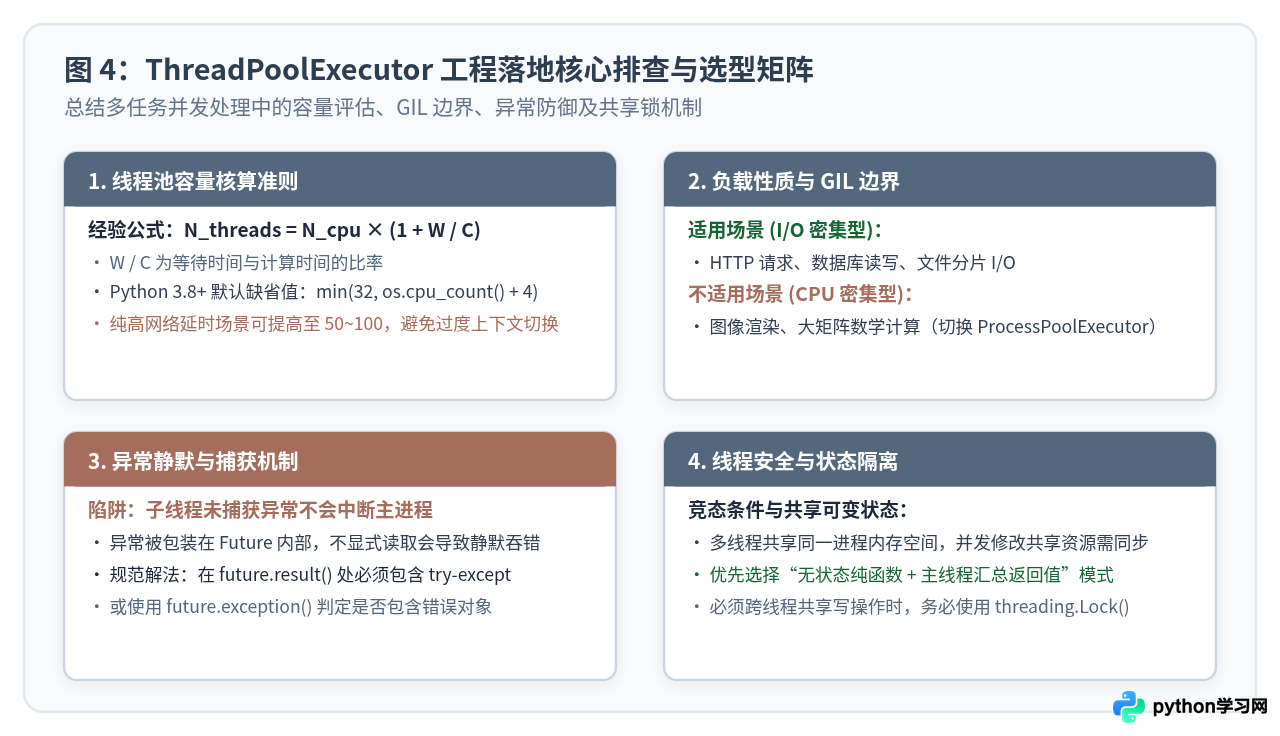
线程池大小的设置参考公式
对于 I/O 密集型任务,计算机体系结构通常采用如下公式作为初版预估:
线程数 = CPU 核心数 × (1 + 平均 I/O 等待时间 / 平均 CPU 计算时间)
在网络抓取等重度网络等待场景中,等待时间远大于计算时间(例如等待 950ms,计算 50ms),此时 W/C 接近 19,设置 20~50 甚至更多的线程是完全合理的。Python 3.8 之后的官方默认缺省策略调整为 min(32, os.cpu_count() + 4),避免了过往版本直接按倍数开辟带来的巨量内存消耗。
| 对比维度 | executor.map() | executor.submit() + as_completed() |
|---|---|---|
| 代码风格 | 极简声明式,类似内置 map | 灵活编程式,需显式管理 Future 列表 |
| 返回顺序 | 严格保证与输入顺序一致 | 完成即出列,顺序取决于实际耗时 |
| 长耗时阻塞 | 首个任务慢会阻断整个消费链条 | 无首任务阻塞,整体吞吐更平滑 |
| 异常发现时机 | 迭代遍历遇到出错位置时触发 | 遍历具体完成的 Future 调用 result() 时触发 |
| 推荐场景 | 数据必须严格按 ID 对齐的批处理 | Web 爬虫、分布式 API 轮询、批量下载 |
总结来说,concurrent.futures.ThreadPoolExecutor 是 Python 处理 I/O 密集型多任务并发的首选利器。通过规范使用 with 上下文管理器建立生命周期边界、依据顺序要求在 map 与 as_completed 间灵活抉择、在 result() 处建立完备的异常防御,开发者可以在兼顾代码可读性的同时,显著提高系统并发处理性能。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









