

Python哪些词不能做变量名?保留字清单与冲突检查
系统梳理Python中不可作为变量名的核心词汇,涵盖35个硬保留字清单、3个软关键字、常见内置函数与类型遮蔽陷阱,并提供利用keyword和builtins模块进行动态代码冲突自查的方法与避让方案。
一、绝对禁止:35个语法保留字清单与分类
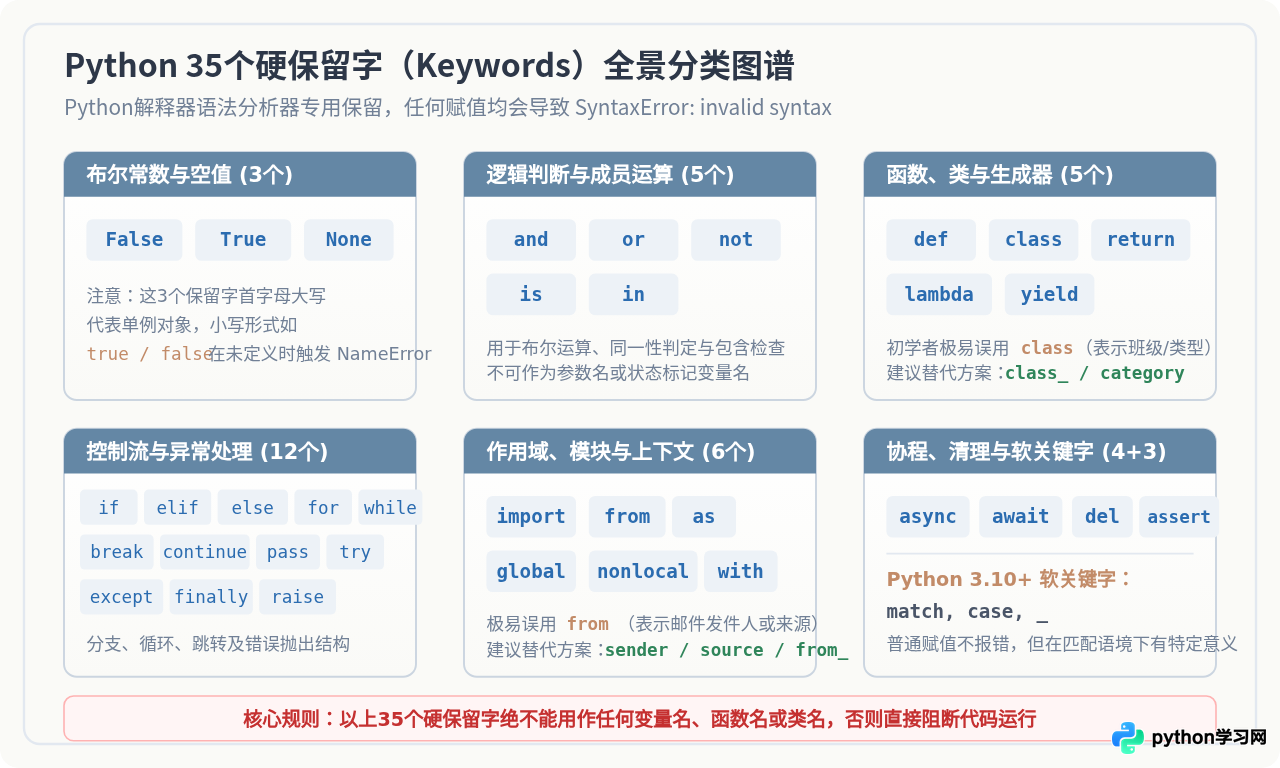
Python的保留字(Keywords)是解释器语法分析器(Parser)用于构建程序结构的专有名词。Python规范严格禁止使用保留字作为任何自定义标识符(包括变量名、函数名、类名及模块名)。如果强行将其放在等号左侧进行赋值,解释器会在编译阶段直接抛出 SyntaxError: invalid syntax 错误,代码根本无法启动。
在现代标准Python中,硬保留字共有35个。我们可以按照其在语法中的实际职能,将其划分为六大核心类别:
| 分类类型 | 保留字列表 | 常见误用场景与解析 |
|---|---|---|
| 布尔与空值常量 | False, None, True |
唯一首字母大写的3个保留字。代表Python内建单例常量,不能被重定义。小写的 true / false 虽然不是关键字,但在未定义时会报 NameError。 |
| 逻辑与包含运算 | and, or, not, is, in |
用于条件布尔计算及同一性、成员资格校验。常被新手误用作状态参数名(如用 in 存储输入数据)。 |
| 函数、类与生成器 | def, class, return, lambda, yield |
用于定义代码结构与控制返回值。其中 class 极易被误用于表示学生“班级”或商品“类别”,应改用 class_ 或 category。 |
| 分支循环控制流 | if, elif, else, for, while, break, continue, pass |
主导程序的执行路径与循环迭代跳转。在任何情况下均不可拆解或借用。 |
| 异常与错误处理 | try, except, finally, raise |
构建结构化异常捕获与抛出体系。常有初学者尝试用 except 做过滤排除标记变量,导致语法崩溃。 |
| 模块、作用域与上下文 | import, from, as, global, nonlocal, with |
控制模块导入、修饰全局/闭包作用域与上下文管理器。其中 from 常被误用于邮件发件人或数据来源字段,建议改用 from_ 或 source。 |
| 协程与底层指令 | async, await, del, assert |
异步编程核心语法、内存对象解除引用以及调试断言。 |
软关键字(Soft Keywords)的特殊说明
从 Python 3.10 开始,语言引入了结构化模式匹配(Pattern Matching),同时增加了 match、case 和通配符 _ 作为“软关键字(Soft Keywords)”。
与普通硬保留字不同,软关键字仅在模式匹配的特定上下文语句中才会被解释器识别为语法关键字。在普通赋值语句中,执行 match = 100 或 case = "test" 并不会报错。然而,出于代码可读性与团队协作维护考虑,官方强烈建议在日常编码中同样避免将软关键字用作普通变量名,防止造成语义混淆。
二、语法规则底线:标识符的构成限制
除了避开保留字清单外,Python在词法层面为标识符(Identifier)设定了严格的基础语法规则。任何不符合以下规则的名称,都会在词法分析阶段被拦截并引发语法错误。
-
必须以字母(a-z, A-Z)或下划线(_)开头:
绝对不能以数字开头。例如
user_1是合法的,但1_user或1st_item会触发SyntaxError: invalid decimal literal。 -
主体只能包含字母、数字和下划线:
严禁包含空格、连字符(
-)、标点符号或任何特殊符号(如@,$,%,!,?,#,.)。例如user-name会被解释器误判为“变量 user 减去 变量 name”,从而报出计算错误或变量未定义。 -
大小写敏感(Case-Sensitive):
Python对标识符的大小写严格区分。
count、Count和COUNT在解释器眼中是三个截然不同、独立存在的变量。虽然True是硬保留字不能赋值,但全小写的true在词法上符合标识符规则(但为了避免混淆,不建议定义)。 -
下划线命名的特殊约定:
单个下划线
_常用于临时丢弃变量;单下划线开头(如_internal_val)代表模块或类内的内部私有约定;双下划线开头(如__private_attr)会触发类名称修饰(Name Mangling);双下划线开头和结尾(如__init__)属于特殊魔术方法(Dunder Method),开发者绝不应自定义同名普通变量。
三、隐形陷阱:严禁占用的内置函数与类型(Built-ins)
很多初学者在避开35个保留字后,依然会掉进一个更隐蔽的“深坑”——内置标识符遮蔽(Shadowing Built-ins)。
Python拥有丰富的内置命名空间(由 builtins 模块管理),例如列表类型 list、字符串类型 str、字典类型 dict,以及常用函数 print、len、id、type、input 等。
list = [1, 2, 3] 时,Python解释器不会报错,因为 list 不是语法保留字,语法分析器完全允许将其当作全局或局部变量名进行绑定。
遮蔽机理与灾难性后果
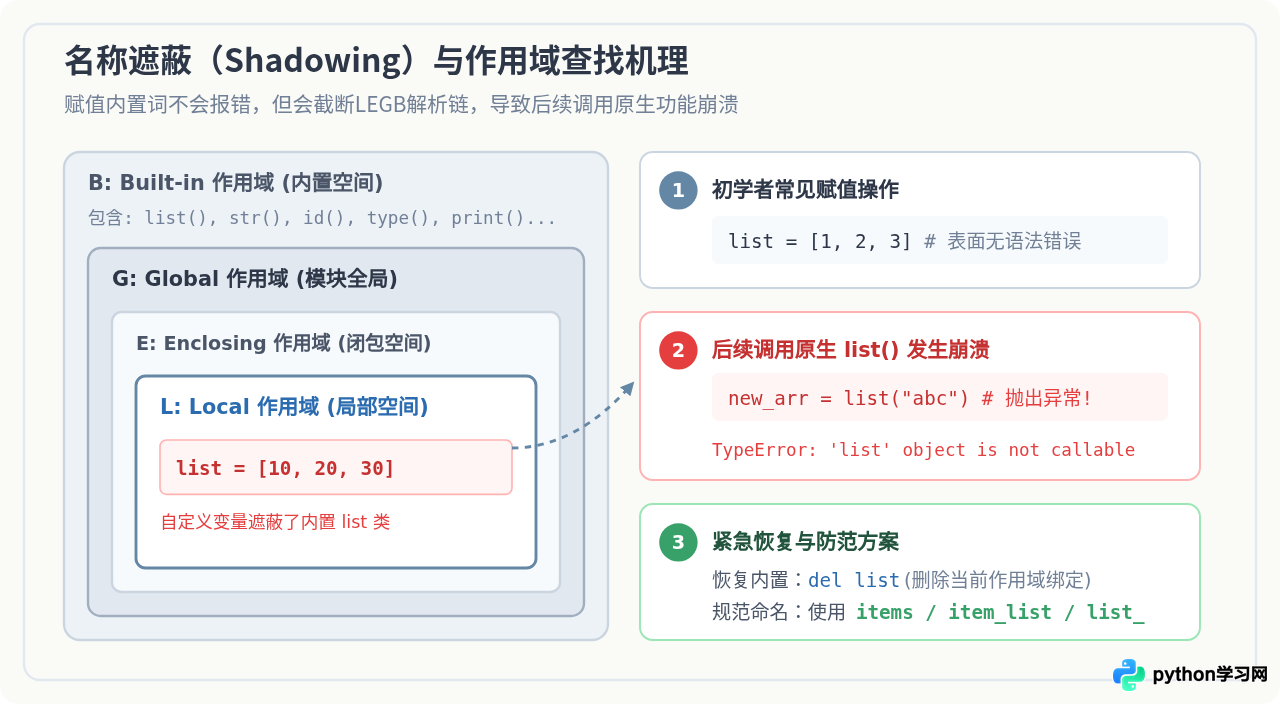
Python在解析变量时,遵循严格的 LEGB 作用域查找顺序:Local(局部) → Enclosing(闭包) → Global(全局) → Built-in(内置)。
一旦你在当前作用域定义了名为 list 的变量,后续所有的 list 访问都会优先命中你刚才创建的列表对象,而永远无法穿透到底层的内置 builtins.list 类。当你后续尝试利用类型转换将数据转换为列表时,灾难就会发生:
# 错误示范:将内置类型用作变量名
list = ["apple", "banana", "cherry"]

# 此时 list 不再代表内置列表构造器,而是一个具体的列表实例
# 几行代码后,尝试创建新列表:
new_data = list("hello")File "<stdin>", line 6, in <module>
TypeError: 'list' object is not callable
报错提示“'list' 对象不可调用”,这是因为此时的 list 已经被你的变量覆盖,试图调用一个列表实例自然会引发异常。这种错误往往不在定义行暴露,而在几百行之后的无辜代码处爆发,排查极其困难。
最常被误占用的内置名称清单
- 数据类型类:
list,dict,set,str,int,float,bool,tuple,bytes - 内置工具函数:
len,id,type,print,input,range,open,sum,max,min,dir,help,all,any,filter,map
del <name>(例如 del list)删除当前命名空间中的覆盖绑定,使LEGB查找链重新回退到底层的内置空间。
四、代码实操:自动化冲突检查与验证步骤
在实际开发、编写动态配置解析器或构建低代码平台时,我们需要用代码自动校验用户输入的字符串是否可以作为合法的Python变量名。Python标准库提供了开箱即用的专业模块。
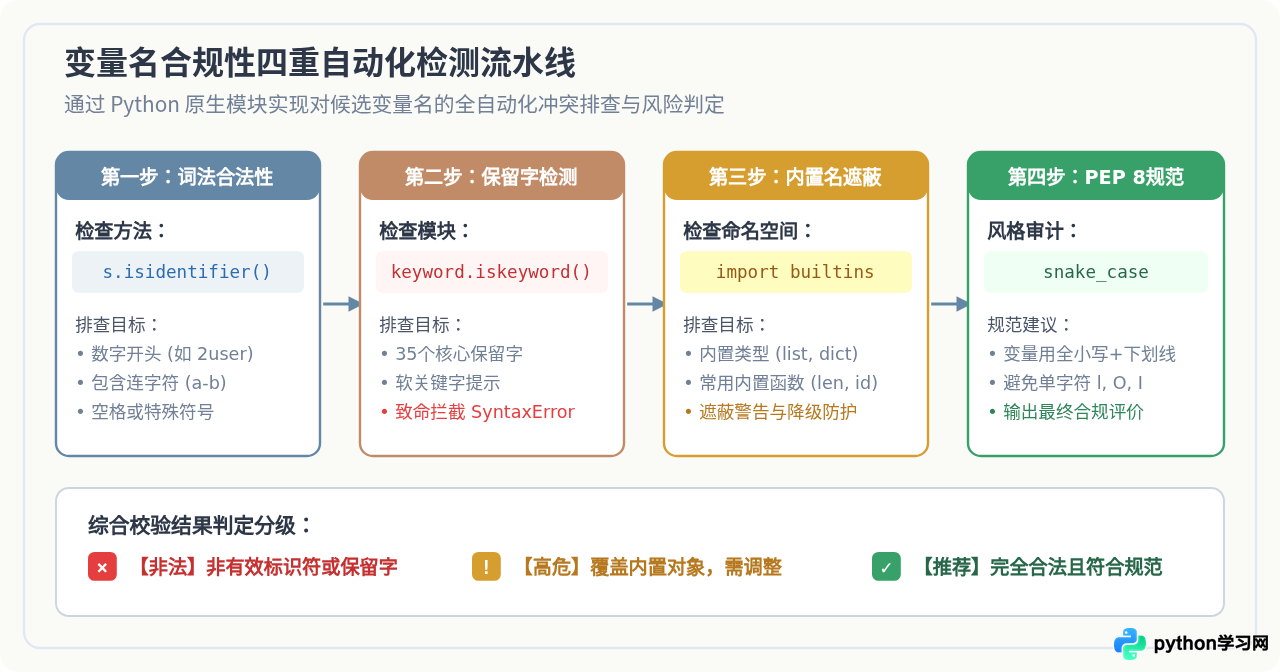
步骤 1:使用 str.isidentifier() 检验基础语法
内置字符串方法 str.isidentifier() 可检测字符串是否符合Python标识符的词法结构(是否仅由字母、数字、下划线组成且不以数字开头)。
print("user_name".isidentifier())  # 输出: True
print("2nd_item".isidentifier())   # 输出: False (数字开头)
print("user-id".isidentifier())    # 输出: False (包含连字符)
print("for".isidentifier())        # 输出: True (注意:isidentifier不会过滤保留字!)
注意:isidentifier() 只检查词法形态,它会对 "for"、"class" 等硬保留字返回 True。因此必须结合下一步进行排查。
步骤 2:使用 keyword 模块排除硬保留字与软关键字
Python官方内置的 keyword 模块能够动态获取当前Python解释器版本的保留字清单。
import keyword

# 查看当前Python版本的全部硬保留字
print("保留字数量:", len(keyword.kwlist))
print(keyword.kwlist)

# 精确检测某名称是否为硬保留字
print(keyword.iskeyword("class"))  # 输出: True
print(keyword.iskeyword("name"))   # 输出: False

# 检测是否为软关键字 (Python 3.10+)
if hasattr(keyword, "issoftkeyword"):
    print(keyword.issoftkeyword("match"))  # 输出: True
步骤 3:使用 builtins 模块筛查内置名称遮蔽
通过检查目标名称是否存在于内置模块 builtins 的属性字典中,可以有效预防变量覆盖风险。
import builtins

print("list" in dir(builtins))   # 输出: True (属于内置类型,存在遮蔽隐患)
print("score" in dir(builtins))  # 输出: False (非内置名称,安全)
步骤 4:构建完整的命名冲突自查工具函数
结合上述三个维度的检测,我们可以编写一个完整的变量名合规性自查脚本,并在生产环境中进行前置校验:
import keyword
import builtins

def validate_variable_name(name: str) -> dict:
    """
    对候选变量名进行多维度合规检查
    返回检测状态字典: valid (是否可用), level (等级), message (详细说明)
    """
    # 1. 基础词法校验
    if not name.isidentifier():
        return {
            "valid": False,
            "level": "ERROR",
            "message": f"'{name}' 语法非法!必须以字母或下划线开头,且只能包含字母、数字和下划线。"
        }

    # 2. 检查硬保留字
    if keyword.iskeyword(name):
        return {
            "valid": False,
            "level": "ERROR",
            "message": f"'{name}' 是Python保留字(关键字),严禁作为变量名使用,否则引发SyntaxError。"
        }

    # 3. 检查软关键字 (Python 3.10+)
    if hasattr(keyword, "issoftkeyword") and keyword.issoftkeyword(name):
        return {
            "valid": True,
            "level": "WARNING",
            "message": f"'{name}' 是软关键字(用于match/case),语法允许赋值但不推荐。"
        }

    # 4. 检查内置名称遮蔽
    if name in dir(builtins):
        return {
            "valid": True,
            "level": "WARNING",
            "message": f"'{name}' 与Python内置对象重名!存在遮蔽风险,建议改用 '{name}_' 或添加具象业务前缀。"
        }

    return {
        "valid": True,
        "level": "SAFE",
        "message": f"'{name}' 格式完全合法,未与任何保留字或内置对象冲突。"
    }

# 运行测试示例
test_names = ["user_id", "1st_num", "class", "list", "match"]
for t in test_names:
    result = validate_variable_name(t)
print(f"[{result['level']}] {t} -> {result['message']}")[ERROR] 1st_num -> '1st_num' 语法非法!必须以字母或下划线开头,且只能包含字母、数字和下划线。
[ERROR] class -> 'class' 是Python保留字(关键字),严禁作为变量名使用,否则引发SyntaxError。
[WARNING] list -> 'list' 与Python内置对象重名!存在遮蔽风险,建议改用 'list_' 或添加具象业务前缀。
[WARNING] match -> 'match' 是软关键字(用于match/case),语法允许赋值但不推荐。
五、规范避让与决策树总结
在日常开发中,不可避免会遇到业务概念天然与保留字或内置名称重合的情况。例如ORM实体中的 class(班级)、网络请求中的 from(发件人)、数据库查询中的 type(类型)或 id(编号)。
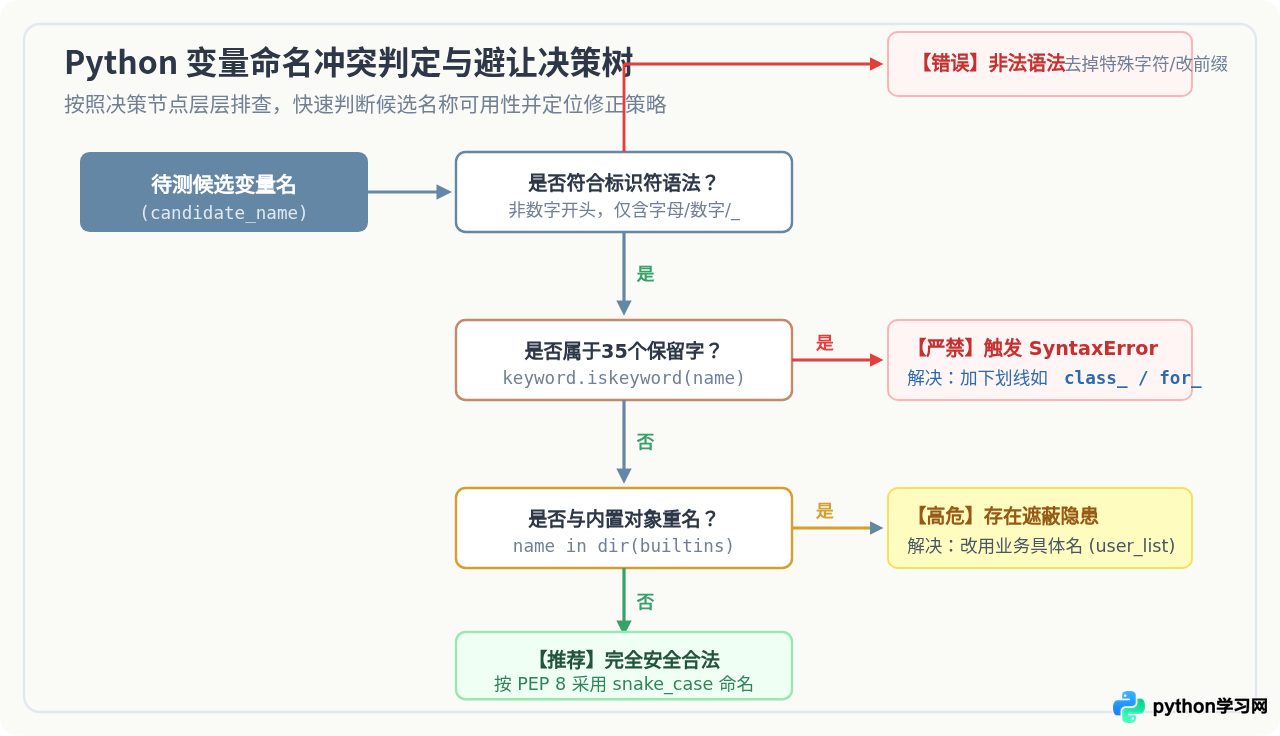
优雅避让的三大行业标准方案
-
方案一:添加单后置下划线(PEP 8 官方推荐)
当最贴切的变量名恰好与关键字或内置名称冲突时,PEP 8(Python官方代码风格指南)明确推荐在末尾追加单下划线: 例如使用class_代表班级,type_代表类型,id_代表对象标识符,from_代表发送方。这种做法既保留了词义完整性,又完美规避了语法冲突。 -
方案二:添加更具象的业务上下文前缀
比单下划线更好的做法是丰富词汇的上下文内涵。例如: 将list改为user_list或student_names; 将str改为response_text或input_str; 将id改为order_id或employee_id。不仅完全杜绝重名,还极大提升了代码自解释能力。 -
方案三:使用清晰的英文近义词替代
选择表达相近的替代词汇。例如用category或kind代替type;用sender或origin代替from;用classroom或grade代替class。
核心自查速记表
| 检查维度 | 检验规则与标准 | 常见违规反例 | 正确修正示范 |
|---|---|---|---|
| 语法格式 | 以字母或 _ 开头,不含标点、连字符和空格 | 9item, order-id, my name |
item_9, order_id, my_name |
| 硬保留字 | 绝对不能属于 35 个 keyword.kwlist |
class = "A", from = "NY" |
class_ = "A", from_addr = "NY" |
| 内置名称 | 尽量避免使用 dir(builtins) 中的内建名 |
list = [1, 2], id = 101 |
items = [1, 2], user_id = 101 |
| 风格规范 | 变量遵循 PEP 8 蛇形命名(全小写+下划线) | TotalCount, userList |
total_count, user_list |
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









