

Java与Python就业前景对比:后端开发与AI数据科学方向
深入对比Java后端开发与Python AI数据科学方向的就业前景、岗位供给体量、技术门槛要求、职业成长路径与选型决策,提供清晰的求职与技术规划指南。
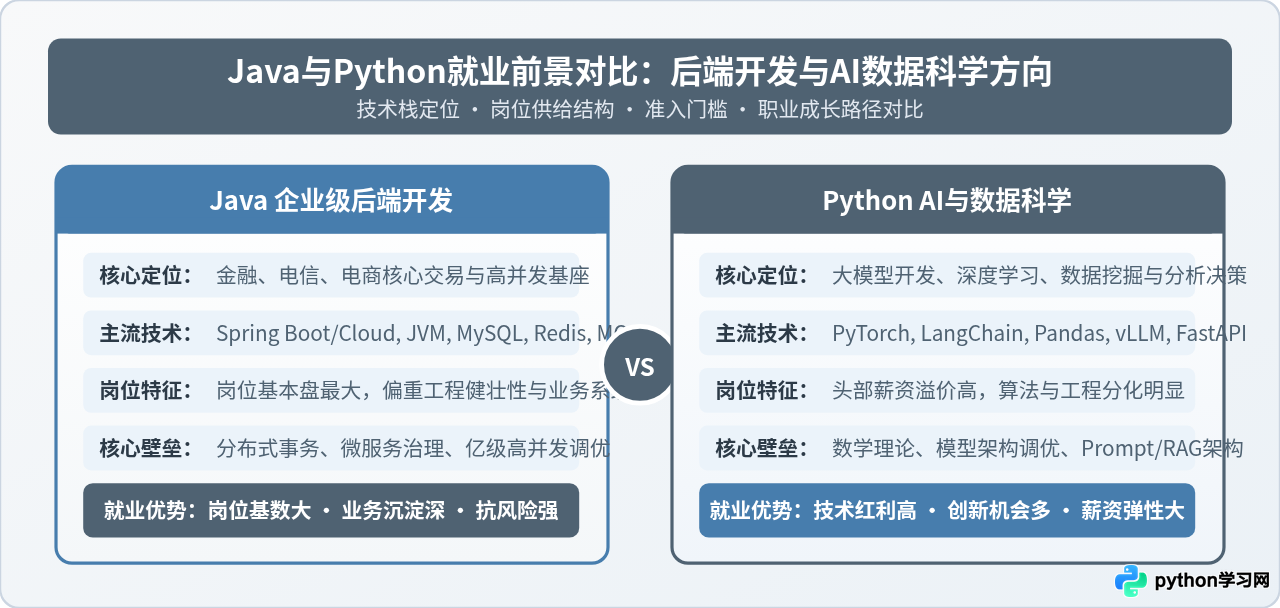
一、核心战场界定:工业级系统基座与算法实验链路
评估Java与Python的就业前景,必须先厘清两者在企业生产环境中承担的具体职责。后端开发与AI数据科学并非互斥的对立面,而是运行在企业技术栈不同层级的协同系统。
Java在企业级软件工程中承担的是“承重墙”角色。在银行金融、电商交易、电信计费、政企管理平台和大型SaaS服务中,系统的首要目标是保证7×24小时高可用、强事务一致性以及毫秒级的稳定响应。静态强类型、成熟的JVM垃圾回收机制、完善的线程模型以及经过数十年验证的Spring生态,使得Java成为构建复杂微服务集群的工业标准语言。
Python在AI与数据科学中承担的是“智慧引擎与敏捷落地”角色。从经典的NumPy、Pandas数据处理,到PyTorch深度学习框架,再到当下的大语言模型(LLM)微调、LangChain Agent编排和向量检索系统,Python构成了全球AI研发的核心通用语言。它的核心价值在于以极短的开发迭代周期完成数据清洗、模型训练验证与推理工程编排。
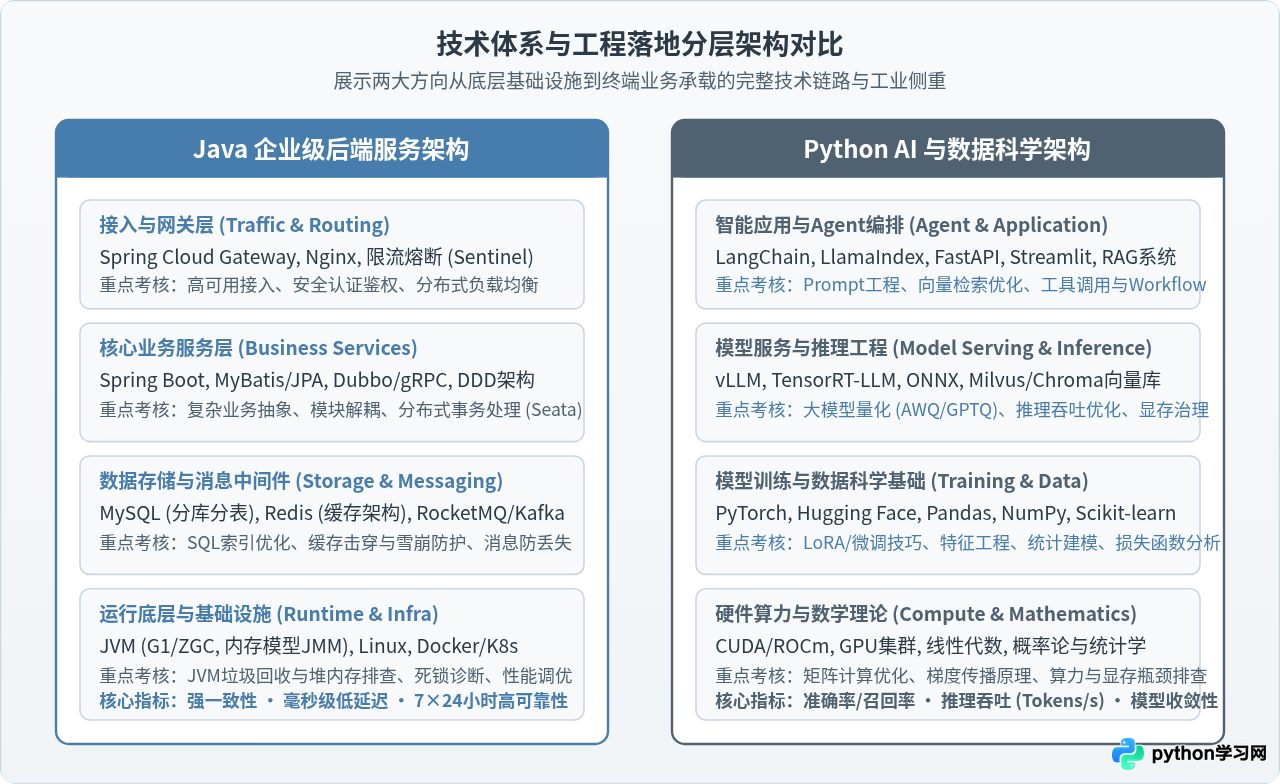
1.1 Java后端典型技术链路与工程特征
Java开发者的核心竞争力在于驾驭庞大工程系统的能力。典型的生产环境Java应用通常采用分层微服务架构,开发者需要保证高并发请求下数据库的连接安全、分布式事务的一致性以及缓存与底层存储的数据同步:
// 典型Spring Boot业务层:高并发场景下的事务控制与分布式缓存联动示例
@Service
public class OrderProcessingService {

    @Autowired
    private OrderRepository orderRepository;
    @Autowired
    private StringRedisTemplate redisTemplate;
    @Autowired
    private RocketMQTemplate mqTemplate;

    @Transactional(rollbackFor = Exception.class)
    public OrderResult createOrder(OrderDTO dto) {
        // 1. 分布式限流与库存前置校验
        Long stock = redisTemplate.opsForValue().decrement("sku:stock:" + dto.getSkuId());
        if (stock == null || stock < 0) {
            throw new BusinessException(ErrorCode.STOCK_INSUFFICIENT);
        }
        // 2. 核心订单持久化
        OrderEntity entity = OrderConverter.toEntity(dto);
        orderRepository.save(entity);
        // 3. 异步发送事务消息驱动后续物流与积分链路
        mqTemplate.syncSendOrderly("order-topic", entity.getId(), entity.getUserId());
        return OrderResult.success(entity.getId());
    }
}
1.2 Python AI与数据工程典型链路与特征
Python开发者的核心竞争力在于数据表征、算法调用与模型落地能力。在生成式AI与大模型应用场景中,工程实现通常围绕Prompt编排、向量相似度匹配和流式推理展开:
# 典型Python大模型工程应用:构建企业私域知识库RAG检索链路示例
from fastapi import FastAPI
from langchain_community.vectorstores import Chroma
from langchain_openai import OpenAIEmbeddings, ChatOpenAI
from langchain.chains import RetrievalQA

app = FastAPI(title="Enterprise RAG Service")

# 1. 向量模型与本地向量库挂载
embedding_model = OpenAIEmbeddings(model="text-embedding-3-small")
vector_db = Chroma(persist_directory="./kb_index", embedding_function=embedding_model)
retriever = vector_db.as_retriever(search_kwargs={"k": 3})

# 2. 组装问答检索执行链
llm = ChatOpenAI(model="gpt-4o-mini", temperature=0.2)
qa_chain = RetrievalQA.from_chain_type(llm=llm, retriever=retriever)

@app.post("/v1/knowledge/query")
async def query_knowledge_base(prompt: str):
    response = qa_chain.invoke({"query": prompt})
    return {"query": prompt, "answer": response["result"]}
二、就业招聘供给量与企业分布结构
评估就业前景最直接的依据是市场有效岗位的规模与企业分布。当前招聘市场中,Java与Python呈现出截然不同的供需分布特征。
2.1 Java:基数大、行业覆盖广、地域下沉深
Java的岗位总供给量长期稳居编程语言前列。其核心招聘主体不仅包括头部互联网科技企业,还广泛分布于:
- 国有银行与金融机构:国有六大行、股份制银行、证券与保险公司的核心业务系统几乎全部基于Java技术栈开发;
- 传统制造业与政企数字化:国家电网、电信运营商、烟草及各地大型国企的内部ERP、供应链系统偏好Java的稳定性;
- 二三线城市软件企业:在非一线城市的信息化外包、地方政企项目中,Java工程师是需求量最为庞大的研发工种。
这意味着学习Java的求职者具备宽广的缓冲空间。即使互联网行业招聘放缓,传统行业、政企及金融机构依然能够提供稳定的招聘底盘。
2.2 Python:一线聚集、增量高弹性、沙漏型结构
Python在纯Web后端领域(如Django、Flask)的岗位数量远少于Java,其主要就业吸纳能力集中在以下三个细分领域:
- 核心算法与大模型研发:包括基础模型预训练、多模态架构设计、量化微调等,主要分布在北京、上海、深圳、杭州等一线城市的AI独角兽与头部科技大厂实验室;
- AI工程化落地与应用研发:包括RAG私有知识库开发、AI Agent协同工作流编排、FastAPI微服务封装,在中小创新型团队中需求增速明显;
- 商业数据分析与数据挖掘:分布在电商、出海、金融量化交易企业,负责指标监控、用户行为建模与策略回测。
Python相关岗位的供求呈现出典型的“沙漏型”特征:顶端核心算法岗位薪资极高但门槛严苛,底端基础数据统计岗位进入壁垒低但可替代性强,中段腰部工程岗位正在随着大模型工业化工具链的成熟而逐渐扩容。
三、求职技术门槛与面试考核重点差异
明确用人单位在面试中的考核侧重点,是选择技术方向的关键依据。不同方向的专业考察维度差异明显。
| 考核模块 | Java 企业级后端开发 | Python AI与数据科学 |
|---|---|---|
| 语言底层与运行机制 | JVM内存模型(堆/栈/方法区)、GC垃圾收集算法(G1/ZGC)、类加载机制、多线程并发锁(AQS/CAS) | GIL全局解释器锁原理、内存管理与垃圾回收、装饰器/生成器机制、C/C++扩展绑定 |
| 核心库与框架 | Spring Boot自动装配原理、Spring Cloud微服务组件、MyBatis缓存、Dubbo RPC机制 | PyTorch自动求导与张量计算、Hugging Face Transformers、LangChain/LlamaIndex、Pandas |
| 存储与并发 | MySQL索引B+树底层、事务隔离级别与MVCC、Redis分片与集群锁、消息队列可靠投递 | 向量数据库(Milvus/Chroma)检索算法(HNSW/IVF-PQ)、GPU显存管理、批量数据Pipeline |
| 理论与数学基础 | 数据结构与算法、设计模式(工厂/单例/责任链等)、操作系统IO多路复用(epoll) | 高等数学、线性代数(矩阵分解/SVD)、概率论与数理统计、反向传播与损失函数推导 |
在Java面试中,仅会使用@Autowired或编写常规SQL已不具备竞争优势,面试官通常会深入追问并发场景下的线程安全、缓存击穿解决方案以及生产环境线上OOM排查排错流程。
在Python AI面试中,单纯调用OpenAI API或套用Hugging Face流水线同样缺乏壁垒,重点在于是否理解Transformer注意力机制计算复杂度、模型微调参数量化损失控制以及检索召回精度的量化调优。
四、职业成长阶段与技术阶梯推进
技术选型不仅决定了入行时的第一份工作,还深刻影响着未来3至10年的技术积累方式和职业成长节奏。
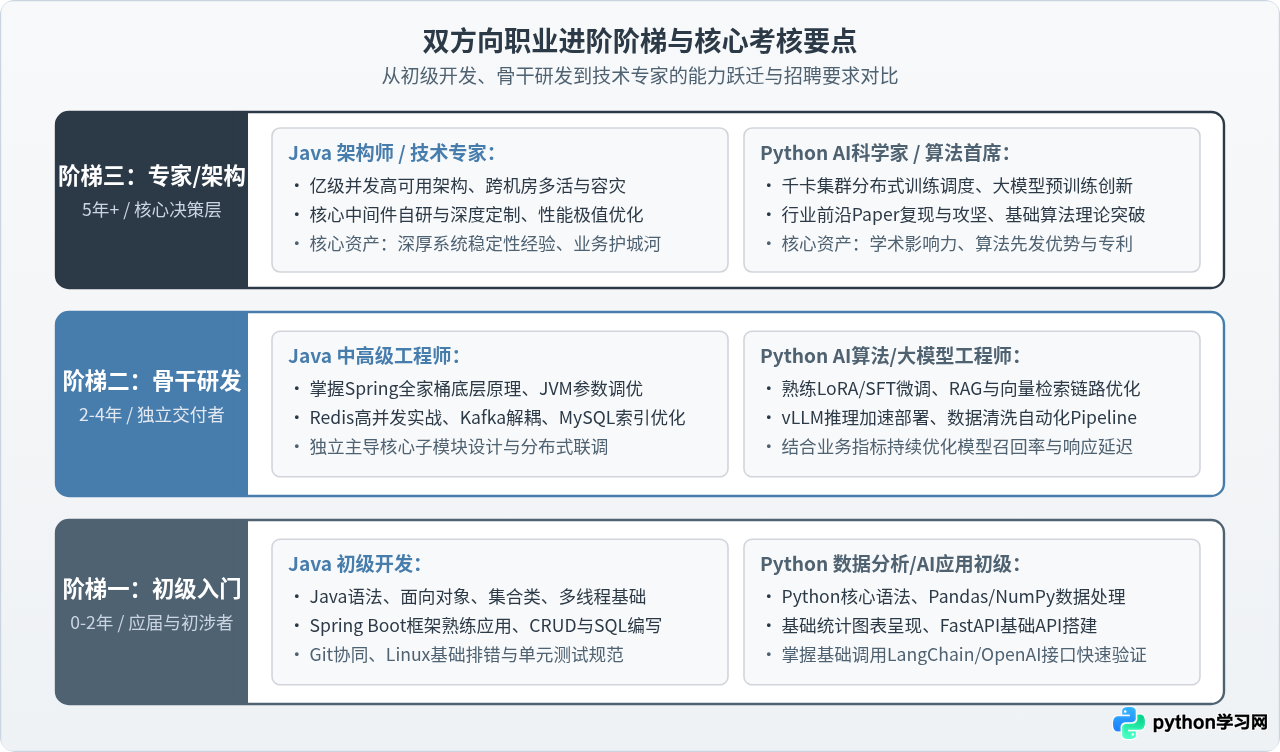
4.1 阶段一:初级开发阶段(0-2年)
Java初级开发者的主要任务是在既定工程框架下完成业务CRUD与接口联调。考核核心在于编码规范性、数据库索引使用合理性以及基础异常处理能力。这一阶段招聘看重基本功是否扎实,代码是否健壮可靠。
Python数据与AI方向初级人员则主要负责数据清洗脚本编写、业务指标可视化报表搭建,或者基于开源大模型搭建简单的知识库Demo。此阶段的求职难点在于初级岗位竞争激烈,若缺乏完整上线项目的支撑,容易陷入只懂调用高层接口而缺乏工程落地能力的窘境。
4.2 阶段二:骨干研发阶段(2-5年)
进入骨干期后,Java开发者的优势在于“经验复利”。经过数年积累,开发者对分布式微服务架构、千万级数据表优化、分库分表策略以及高可用保障(容灾、限流、降级)有了深刻的工程感知。由于底层设计模式与中间件原理多年保持稳定,此前积累的技术经验能够持续转化为生产力。
Python AI开发者的骨干阶段则面临高强度的“持续学习压力”。随着模型技术体系快速更迭,开发者需要熟练掌握LoRA/SFT参数高效微调、vLLM显存优化与推理吞吐提升、跨模态数据对齐等实战技能。此阶段技术溢价显著,具备端到端落地经验的工程师往往能够获得可观的薪资涨幅。
4.3 阶段三:架构专家与科学家阶段(5年以上)
在高级架构层面,Java架构师负责掌控整个企业的信息化核心命脉,主导异地多活数据中心设计、核心计费交易链路重构及大型研发团队的代码规范演进,属于越老越吃香的系统型专家。
Python方向则进一步分化为算法科学家与AI架构师:前者主导基础算法创新与学术突破,后者主导异构算力调度、分布式千卡训练容错集群以及企业级模型服务化平台的工程搭建,二者均处于科技行业薪资金字塔的顶端。
五、选型决策路径:不同背景候选人的匹配指南
面对两个发展前景清晰但路径迥异的技术方向,候选人应当依据自身的客观条件,通过结构化的决策逻辑进行取舍,避免盲目跟风。
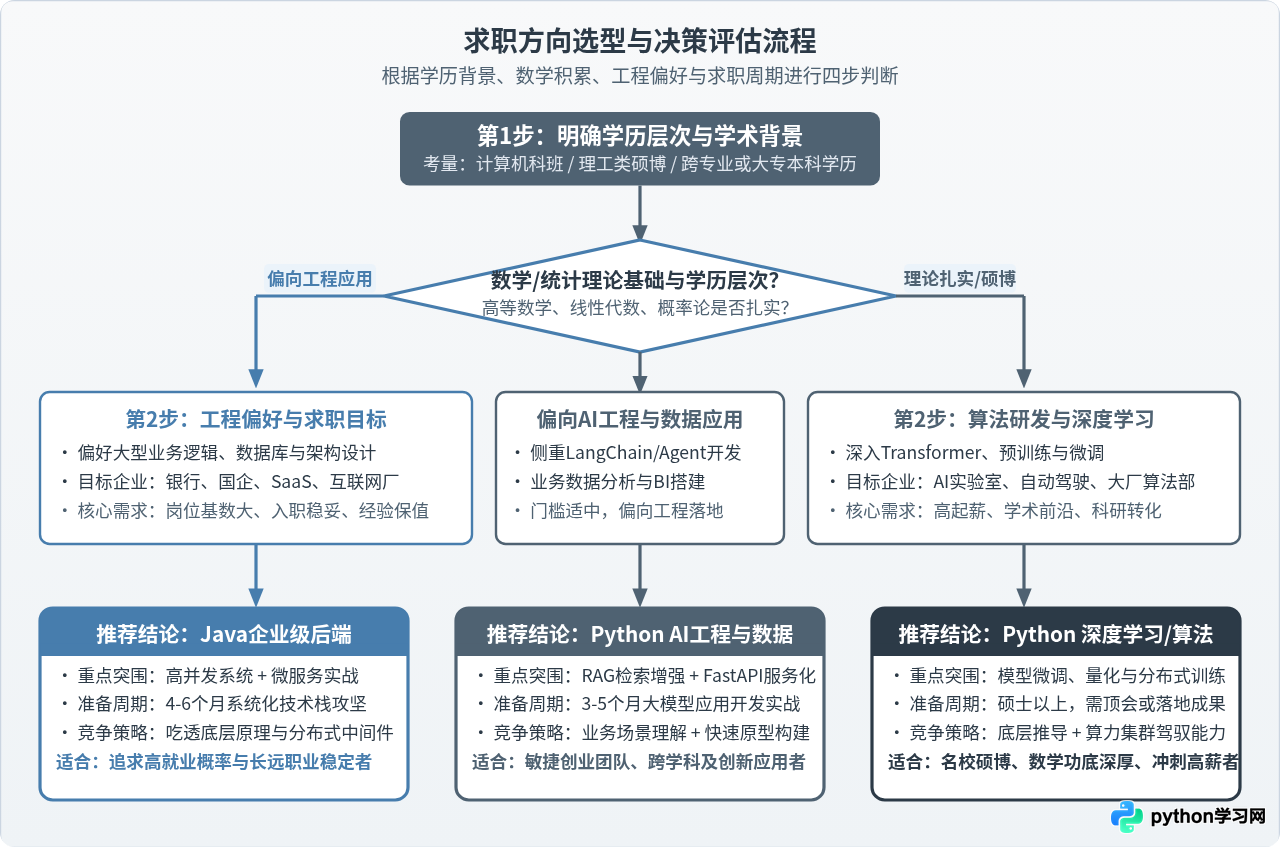
5.1 决策评估四步法
-
第一步:检视学历层级与专业背景。
若为重点高校理工科硕士或博士,且具备良好的数学推导能力与英文论文阅读习惯,进入Python AI算法研发方向能够最大化释放学历溢价;若为本科学历(计算机或理工相关专业),或跨专业转码求职,Java企业级后端由于其广泛的招聘需求和清晰的考核指标,具有更高的求职容错率与上岸成功率。 -
第二步:明确工作地域与生活预期。
AI与数据科学的高薪岗位高度集中在超一线城市和极少数新一线科创园区。如果职业规划包含在二三线城市定居,或者希望进入银行总行研发中心、省属国企科技公司,Java是几乎具备绝对垄断优势的选项。 -
第三步:评估知识更新与抗压偏好。
后端开发的知识体系更偏向“深度积累”,一旦掌握底层网络、操作系统、数据库和JVM调优,知识体系生命周期可达5至10年;而AI数据科学技术更新迅猛,前沿论文与开源工具数月一迭代,要求从业者保持高度的技术敏感度与持久的学习精力。 -
第四步:确立备考突围策略。
选定Java后,应集中攻克分布式锁、消息幂等、高并发调优等工业级场景项目;选定Python后,应聚焦在开源真实数据集的处理、主流模型微调部署或具体领域RAG Agent开发上,产出可交互的在线Demo以建立竞争优势。
六、综合维度矩阵对比与常见误区排查
为了给求职与技术规划提供全面的参照,我们将六项关键指标进行系统化对比,并剖析求职过程中最容易出现的认知偏差。
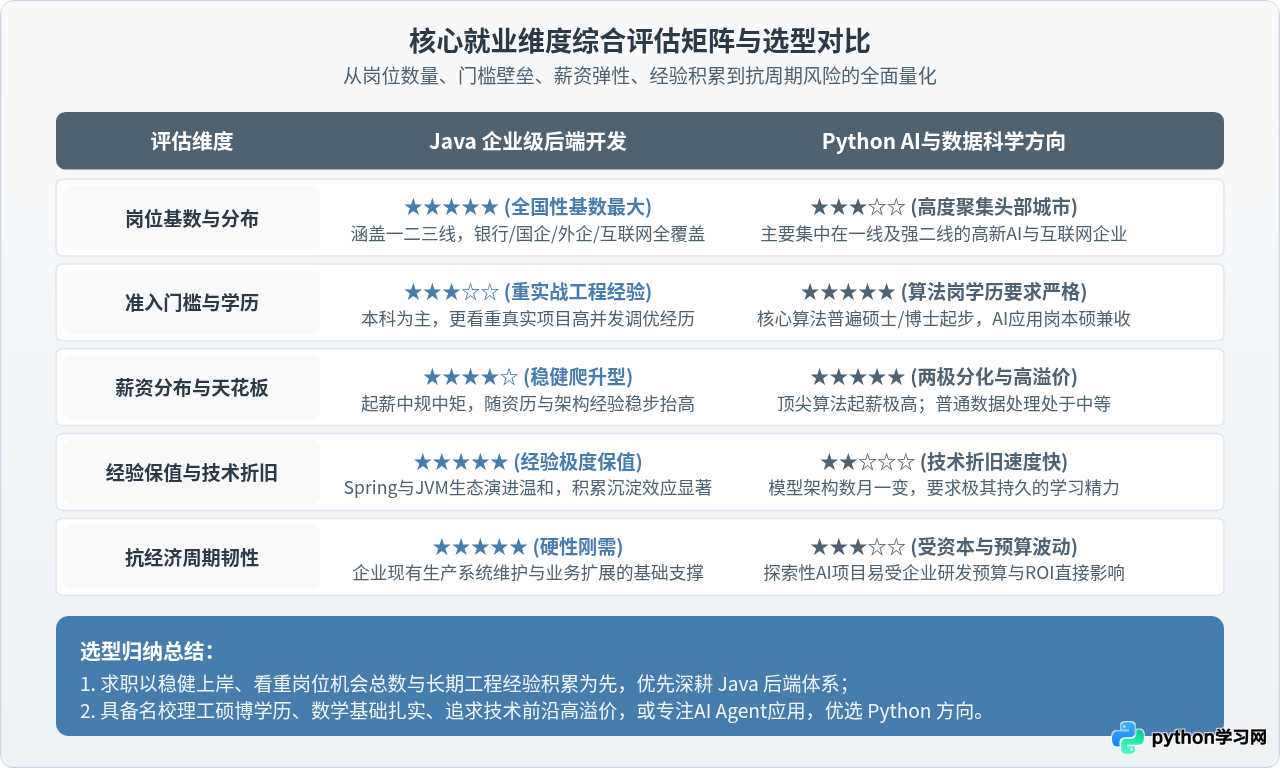
6.1 必须澄清的典型认知误区
事实:掌握Python语法只是AI开发的起点。核心算法岗位对应聘者的线性代数、概率统计、微积分以及深层网络理论有着严格要求。大多数企业在招聘算法岗位时设定了名校硕博及发表顶会论文的硬性门槛。普通学习者应理性将定位调整为“AI工程落地开发”或“数据应用分析”,而非盲目冲刺前沿基础模型研发。
事实:全球现代金融、电子商务、政务系统底层90%以上的关键业务数据依然运行在Java构建的分布式系统上。Java语言本身在持续演进(虚拟线程Virtual Threads、GraalVM原生镜像),企业对能够保障高并发、高可用、高扩展的资深后端人才的需求不仅没有消失,反而随着系统复杂度的提高而愈发迫切。
事实:优秀的后端工程师通常掌握Python用于快速脚本处理和数据解析;而成熟的AI工程师也需要借鉴Java工程化中的面向对象思想、架构设计与服务治理规范。两者的分工是领域分工,而非语法优劣之争。
七、行动建议与实施总结
在具体的求职准备过程中,建议采取以下务实的操作步骤:
对于Java后端方向的求职者:将有限的时间投入到“高含金量技术深度”中。不要在简历上堆砌几十个简单的增删改查单体Demo,而是打造一个具备真实并发场景的微服务项目,深入钻研数据库死锁排查、JVM GC日志分析、Redis与数据库双写一致性等具备辨识度的技术细节。
对于Python AI与数据科学方向的求职者:如果走AI应用开发路线,应当迅速完成从基础理论到“大模型工程实践”的跨越。通过搭建完整的企业知识库系统、多Agent协同任务调度系统,掌握向量数据库调优与模型推理加速工具,将自己的技术能力直观地展现在代码仓库和可运行的线上服务中。
通过明确自身定位,专注夯实对应领域的底层硬实力,才能在激烈的技术人才竞争中建立真正的职业护城河。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









