

使用Python time.perf_counter()进行高精度代码计时
详细介绍如何使用Python标准库中的time.perf_counter()与time.perf_counter_ns()进行高精度代码耗时测量,涵盖与time.time()、time.process_time()的对比、标准操作步骤、常见误区辨析以及上下文管理器和装饰器封装方法。
在Python中测量一段代码的真实运行耗时,标准库time模块中的time.perf_counter()是首选工具。它直接调用操作系统底层提供的最高精度单调性能计数器,能够以纳秒或亚微秒级分辨率记录代码执行前后的时间差,并且不会因系统时钟同步或人为调整时间而出现倒退。本文将讲解time.perf_counter()的工作机制、标准计时步骤、常见认知误区,以及如何将其封装为可复用的上下文管理器和装饰器。
一、为什么代码计时应优先使用 time.perf_counter()
要在代码中计算耗时,核心需求有两个:一是计时器分辨率足够高,能捕捉毫秒乃至微秒级的短耗时;二是计时过程必须单调递增,不受系统墙上时钟(Wall Clock)跳变的影响。time.perf_counter()正是为此设计的专用计数器,它在待测代码开始前与结束后各采样一次,通过两次返回值的差值反映程序实际经历的真实流逝时间(含I/O等待和线程休眠)。
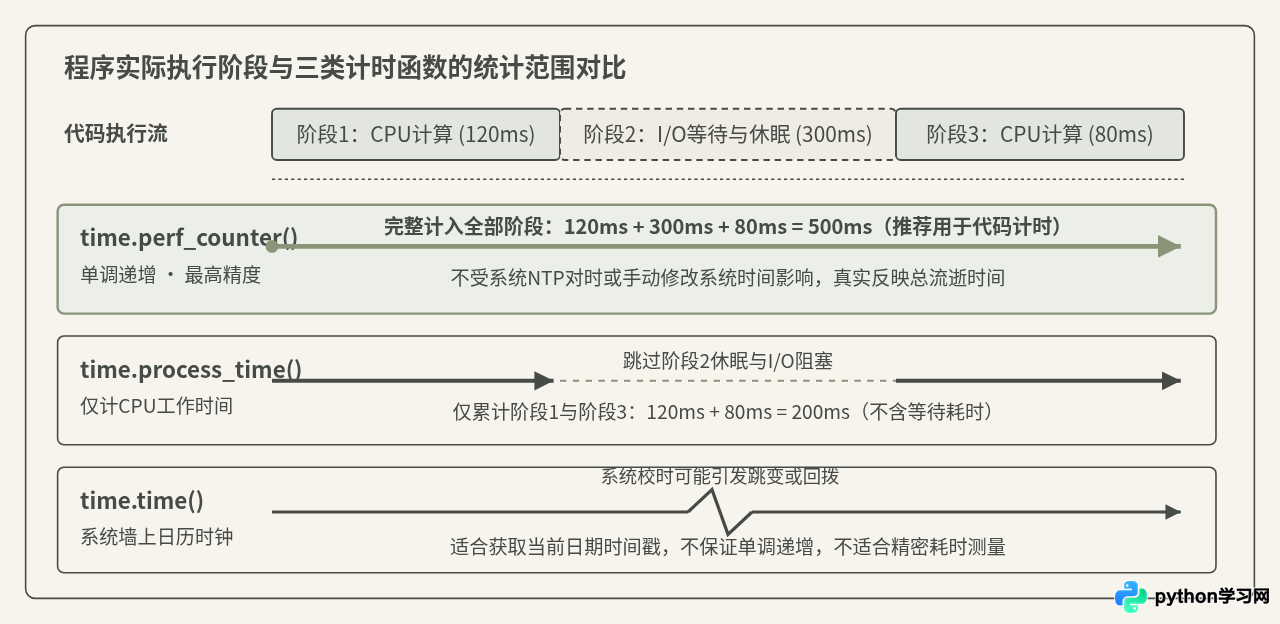
许多初学者习惯用time.time()计算耗时,或者分不清time.perf_counter()与time.process_time()的适用边界。三者底层调用的时钟源不同,直接决定了测量结果的含义:
time.perf_counter():使用系统最高精度的单调性能计数器,计入CPU执行时间、time.sleep()休眠时间以及网络或磁盘I/O等待时间,适合衡量“用户实际等待这段代码执行完成花了多久”。time.time():读取系统实时墙上时钟,主要用于获取当前日历时间戳。如果程序运行期间触发了NTP网络时间同步或手动改表,返回值可能向前跳变甚至倒退,导致计算出的耗时失真或出现负数。time.process_time():仅累加当前进程在CPU上实际消耗的用户态与内核态时间,完全忽略time.sleep()和I/O阻塞等待,只适合纯粹分析CPU计算密集型任务的处理器占用。
可以通过标准库提供的time.get_clock_info('perf_counter')查看当前操作系统下该计时器的底层属性。在Python 3终端或脚本中执行以下代码,即可确认其单调性与理论分辨率:
import time

info = time.get_clock_info("perf_counter")
print(f"底层实现函数: {info.implementation}")
print(f"是否单调递增: {info.monotonic}")
print(f"时钟分辨率(秒): {info.resolution}")二、使用 time.perf_counter() 计时的标准步骤
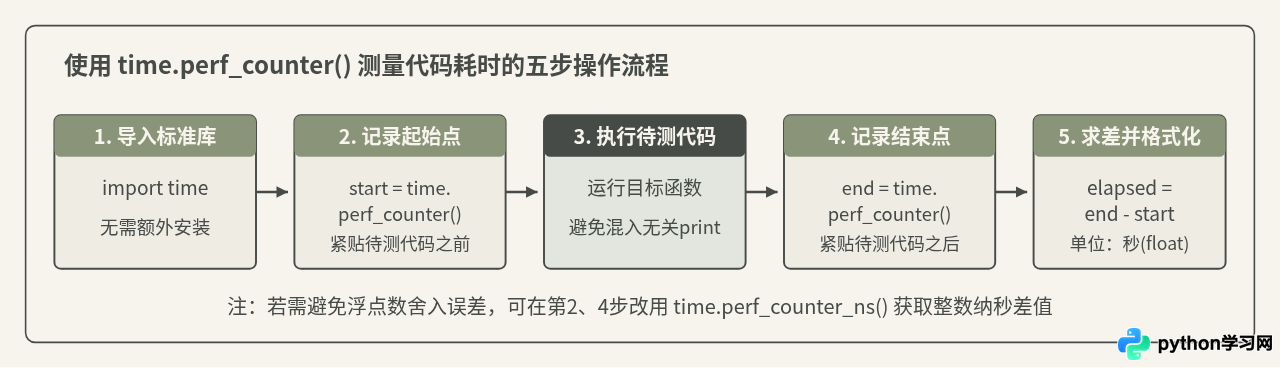
在Python 3.3及以上版本的任意脚本或交互式环境中,使用time.perf_counter()测量代码耗时无需安装第三方依赖,只需遵循“导入模块、记录起点、执行目标代码、记录终点、计算差值”五个步骤。
1. 使用浮点数秒计时的完整示例
创建一个名为measure_demo.py的Python脚本,将time.perf_counter()的两次调用紧贴在待测逻辑的上下方,避免把数据准备或结果打印语句混入计时区间内:
import time


def build_squares_sum(limit: int) -> int:
    """计算从 0 到 limit-1 的平方和"""
    total = 0
    for i in range(limit):
        total += i * i
    return total


if __name__ == "__main__":
    n = 2_000_000

    # 第1步:在紧邻目标函数调用前记录起始计数
    start_time = time.perf_counter()

    # 第2步:执行待测代码
    result = build_squares_sum(n)

    # 第3步:在紧邻目标函数返回后立即记录结束计数
    end_time = time.perf_counter()

    # 第4步:计算差值(单位为秒)并按需换算为毫秒
    elapsed_sec = end_time - start_time
    elapsed_ms = elapsed_sec * 1000

    print(f"计算结果: {result}")
print(f"执行耗时: {elapsed_sec:.6f} 秒 ({elapsed_ms:.3f} 毫秒)")在终端执行python3 measure_demo.py后,可以看到类似如下的输出:
print()输出语句放在start_time与end_time之间。终端I/O输出本身非常耗时,如果夹在计时区间内,测量结果会混入终端渲染耗时,掩盖代码的真实执行速度。
2. 使用 time.perf_counter_ns() 获取整数纳秒
如果运行环境为Python 3.7及以上版本,且待测代码耗时极短(例如仅几百纳秒至几微秒),或者需要将耗时存入数据库做精确整数累加,可以直接使用time.perf_counter_ns()。它直接返回以纳秒($1\text{秒} = 10^9\text{纳秒}$)为单位的int整数,避免了IEEE 754双精度浮点数在极大基准值相减时的尾数精度损失:
import time

start_ns = time.perf_counter_ns()
data = [x * 2 for x in range(1000)]
end_ns = time.perf_counter_ns()

elapsed_ns = end_ns - start_ns
print(f"列表推导耗时: {elapsed_ns} 纳秒 (约 {elapsed_ns / 1_000:.2f} 微秒)")三、常见误区辨析:单次返回值与单次测量误差
在实际使用time.perf_counter()时,有两个容易混淆的说法常导致错误的计时结论。理解它们在什么条件下成立、哪里需要修正,能避免写出看似精确实则无效的测试代码。
误区一:试图把单次 perf_counter() 的返回值换算成当前日期时间
初次调用time.perf_counter()时,读者会看到它返回一个类似34892.1048291的浮点数(单位为秒)。由于time.time()同样返回以秒为单位的浮点数,有人会尝试用datetime.fromtimestamp(time.perf_counter())去解析它,或者把A进程记录的start发给B进程去和B进程的end相减。
这种想法源于对“秒数返回值”的直觉迁移,但Python官方文档明确规定:time.perf_counter()的零点基准(Reference Point)是未定义的。在不同操作系统或不同Python进程中,这个起点可能是机器本次开机启动的时刻,也可能是当前进程初始化的时刻。因此,单次调用perf_counter()得到的数值本身没有任何日历意义,不同进程之间的返回值也无法直接相减;只有同一个进程内两次调用的差值(end - start)才是有效的流逝时间。
误区二:“既然 perf_counter() 精度达到纳秒级,测一次就能代表函数的真实性能”
不少人认为,time.perf_counter()底层分辨率高达$10^{-9}$秒,所以只要在函数前后包一层perf_counter()运行一次,打印出的小数点后六位数字就是该函数的标准耗时。
这一说法看似合理,是因为它把“计时器本身的刻度精度(Resolution)”等同于“代码运行环境的稳定性”。是否只需测量一次,取决于待测任务的类型:
- 单次测量基本够用的条件:待测任务本身耗时较长(例如超过数百毫秒至数秒的批量文件处理、数据库查询或网络请求),或者只是在生产日志中记录某一次具体请求的实际响应时长。此时操作系统毫秒级的调度抖动占总耗时的比例极小,单次测量足以反映该次执行的真实情况。
- 必须修正的场景:当对比两个微秒或毫秒级算法孰优孰劣时,单次测量会受到CPU动态睿频、操作系统时间片抢占、CPU缓存冷热(Cache Miss)以及Python垃圾回收(GC)触发的强烈干扰。
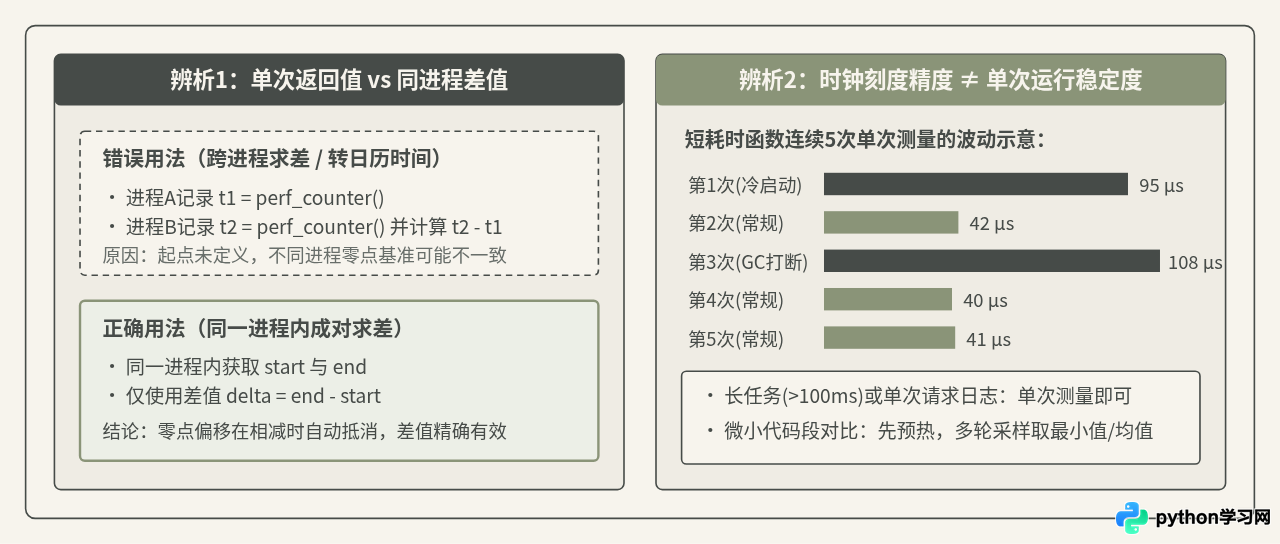
下面的代码示例展示了同一段微秒级函数在连续单次测量下的波动情况,以及如何通过预热(Warm-up)与多轮采样修正误差:
import time
import statistics


def parse_line():
    text = "id=1024;status=active;score=98.5;tag=python_timing"
    return dict(item.split("=") for item in text.split(";"))


# 反例:直接以第一次单次运行作为最终结论(容易混入首次字节码/缓存开销)
t0 = time.perf_counter_ns()
parse_line()
first_run_ns = time.perf_counter_ns() - t0

# 修正做法:先预热1次,再连续采样5轮(每轮执行1000次求单次均值)
parse_line()  # 预热
samples_ns = []
loops = 1000

for _ in range(5):
    start = time.perf_counter_ns()
    for _ in range(loops):
        parse_line()
    end = time.perf_counter_ns()
    samples_ns.append((end - start) / loops)

print(f"首次单次直接测量: {first_run_ns:.1f} 纳秒")
print(f"5轮采样单次耗时(纳秒): {[round(x, 1) for x in samples_ns]}")
print(f"多轮最快耗时(推荐参考): {min(samples_ns):.1f} 纳秒")
print(f"多轮中位数耗时: {statistics.median(samples_ns):.1f} 纳秒")四、封装可复用的计时方式:上下文管理器与装饰器
如果项目中需要在多处代码块或函数上测量耗时,到处手写start = time.perf_counter()和end - start会让业务代码充斥重复变量。将time.perf_counter()封装为上下文管理器(with语句)和函数装饰器(@语法),可以在不侵入核心逻辑的前提下完成计时。
1. 封装代码块计时上下文管理器
当只需要测量函数内部某几行特定语句(例如一次数据库查询或一段循环)时,使用contextlib.contextmanager编写一个timer上下文管理器最为灵活。使用try...finally结构还能保证即使代码块抛出异常,计时结果依然会被打印出来:
import time
from contextlib import contextmanager


@contextmanager
def timer(task_name: str = "代码块"):
    start = time.perf_counter()
    try:
        yield
    finally:
        elapsed_ms = (time.perf_counter() - start) * 1000
        print(f"[{task_name}] 耗时: {elapsed_ms:.3f} ms")


if __name__ == "__main__":
    with timer("生成并排序十万个数字"):
        numbers = [i % 97 for i in range(100_000)]
numbers.sort()2. 封装函数计时装饰器
当需要统计整个函数每次被调用的耗时,可以使用functools.wraps保留原函数元信息,编写一个通用的@measure_time装饰器:
import time
from functools import wraps


def measure_time(func):
    @wraps(func)
    def wrapper(*args, **kwargs):
        start = time.perf_counter()
        try:
            return func(*args, **kwargs)
        finally:
            elapsed_ms = (time.perf_counter() - start) * 1000
            print(f"函数 {func.__name__}() 执行耗时: {elapsed_ms:.3f} ms")
    return wrapper


@measure_time
def fetch_and_process(count: int) -> int:
    time.sleep(0.05)  # 模拟50ms的I/O等待
    return sum(range(count))


if __name__ == "__main__":
    total = fetch_and_process(500_000)
print(f"返回值: {total}")五、计时方法选型总结与注意事项
为了在实际开发中快速决定使用哪一种计时方式,可以根据测量目标和代码粒度参考下表与总结图:
| 计时工具 / 函数 | 核心特点 | 适用场景与选择依据 |
|---|---|---|
time.perf_counter() |
返回浮点数秒,最高精度单调时钟,含休眠与I/O等待 | 绝大多数代码段耗时测量、接口响应耗时统计、通用性能排查 |
time.perf_counter_ns() |
返回整数纳秒,无浮点数尾数精度损失 | 纳秒/微秒级极短操作测量、需要将耗时以整数存储或精确累加的场景 |
time.process_time() |
返回当前进程纯CPU时间,剔除休眠与I/O阻塞 | 专门评估纯算法CPU占用率、排查是否因计算密集导致CPU满载 |
timeit模块(底层默认调用perf_counter) |
自动循环多次执行并暂时关闭垃圾回收(GC) | 在命令行或测试脚本中对单行表达式、小函数做标准化微基准测试 |
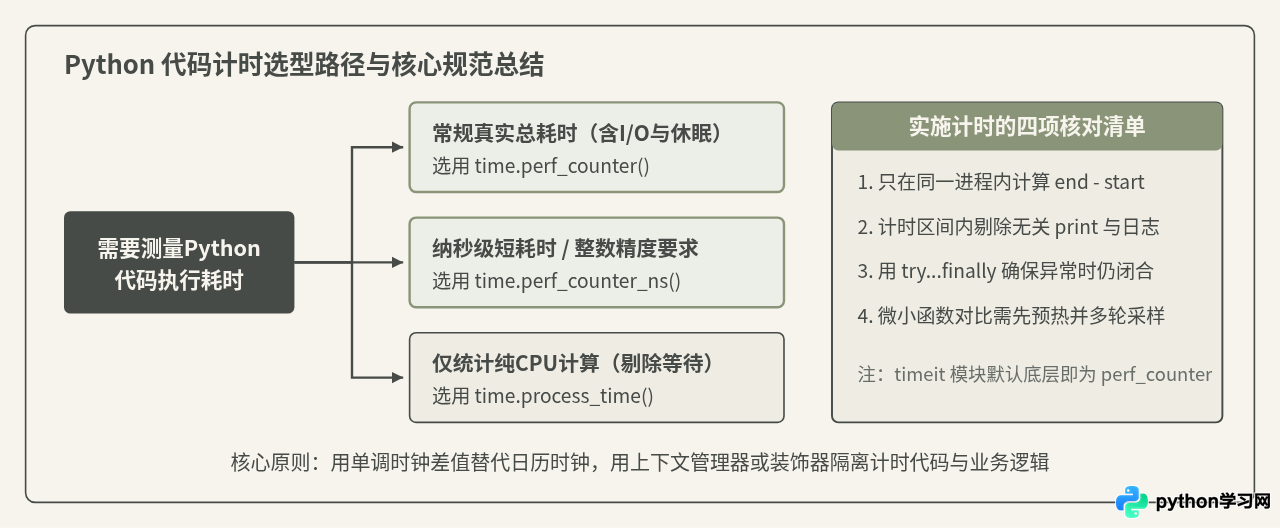
在日常编写性能测试或耗时监控代码时,只需牢记三点边界条件:第一,不要将time.perf_counter()的单个数值持久化存储或跨进程传递,应当直接计算并存储end - start的差值;第二,对于包含异步协程(asyncio)的并发任务,单点perf_counter()测量的是事件循环挂起与恢复的总跨度;第三,当需要对单行代码做严密的微基准测试时,可以直接使用标准库timeit模块,它在底层同样默认采用time.perf_counter()作为计时源,并自动帮你完成了多轮循环与垃圾回收控制。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









