

Python中使用NumPy批量计算数组绝对值的方法
详细介绍在Python中使用NumPy批量计算一维及多维数组绝对值的常用方法,涵盖np.abs核心用法、in-place原地内存优化、特殊数值与复数模长计算,以及常见陷阱规避与选型建议。
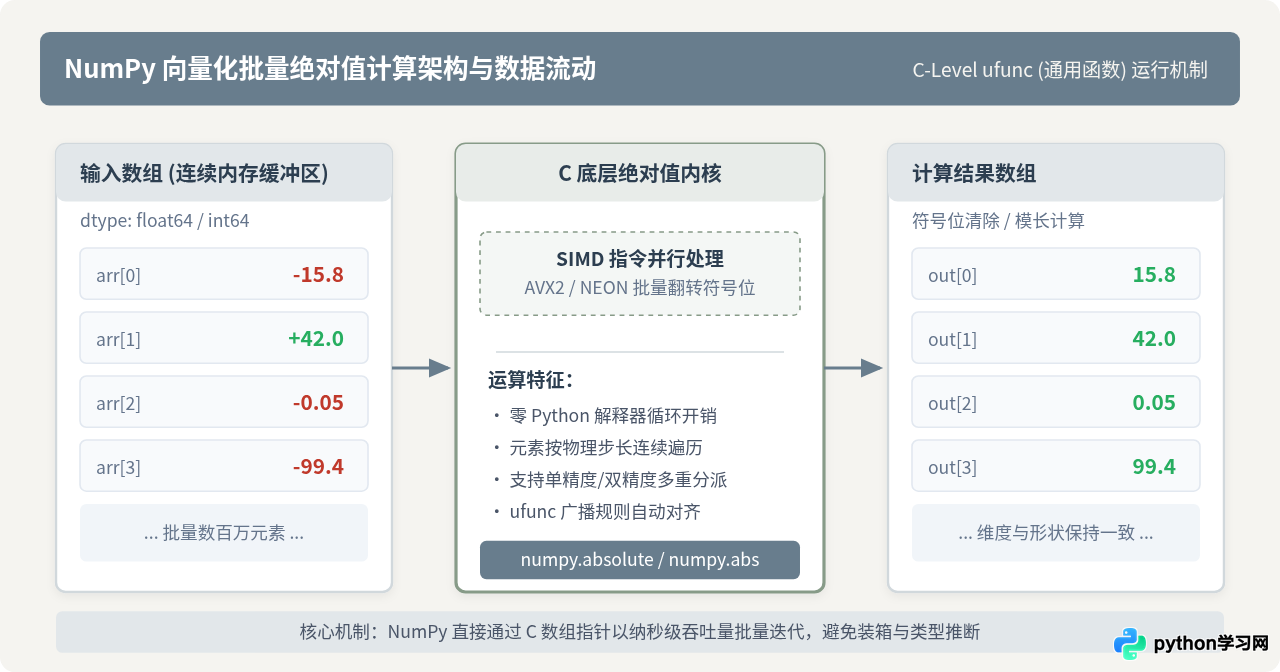
numpy.abs()(或其全称 numpy.absolute())。与Python原生循环逐项计算相比,NumPy通过底层的C语言连续内存缓冲区和现代CPU向量化指令集,能够在纳秒级完成百万甚至千万量级数据的绝对值变换。本文将系统讲解该方法的标准调用规范、多维矩阵批量处理、针对超大数据的原地(in-place)内存复用优化,以及在遇到负零、无穷大、NaN、复数模长和有符号整型极小值溢出时的具体规则与排查方案。
一、核心方法:numpy.abs() 与 numpy.absolute() 的基础使用
在NumPy中,np.abs() 是 np.absolute() 的官方简写别名,二者在底层代码和执行效率上完全一致。它们属于NumPy的通用函数(ufunc),能够自动感知数组维度,无须编写显式循环即可实现全数组元素的逐项映射。
1. 一维数组与多维矩阵的批量绝对值计算
对于一维数组、二维矩阵乃至高维张量,直接将NumPy数组传入 np.abs(),函数会保留输入数组的形状(shape)与步长(strides),生成一个所有元素均取绝对值后的新数组。
import numpy as np

# 1. 一维数组批量绝对值计算
arr_1d = np.array([-4.5, 0.0, 3.2, -18.7, -0.05])
result_1d = np.abs(arr_1d)
print("一维输入:", arr_1d)
print("一维输出:", result_1d)

# 2. 二维多维矩阵批量绝对值计算
arr_2d = np.array([
    [-10, 25, -30],
    [45, -50, -65]
])
result_2d = np.abs(arr_2d)
print("\n二维输出:\n", result_2d)一维输入: [-4.5 0. 3.2 -18.7 -0.05]
一维输出: [ 4.5 0. 3.2 18.7 0.05]
二维输出:
[[10 25 30]
[45 50 65]]在批量处理过程中,NumPy避免了Python解释器在每个元素上的对象装箱(Boxing)与类型检查开销,直接在连续的底层内存块上按步长顺序执行绝对值逻辑,大幅度提升了吞吐率。
二、内存管理对比:常规创建新数组 vs out参数原地修改
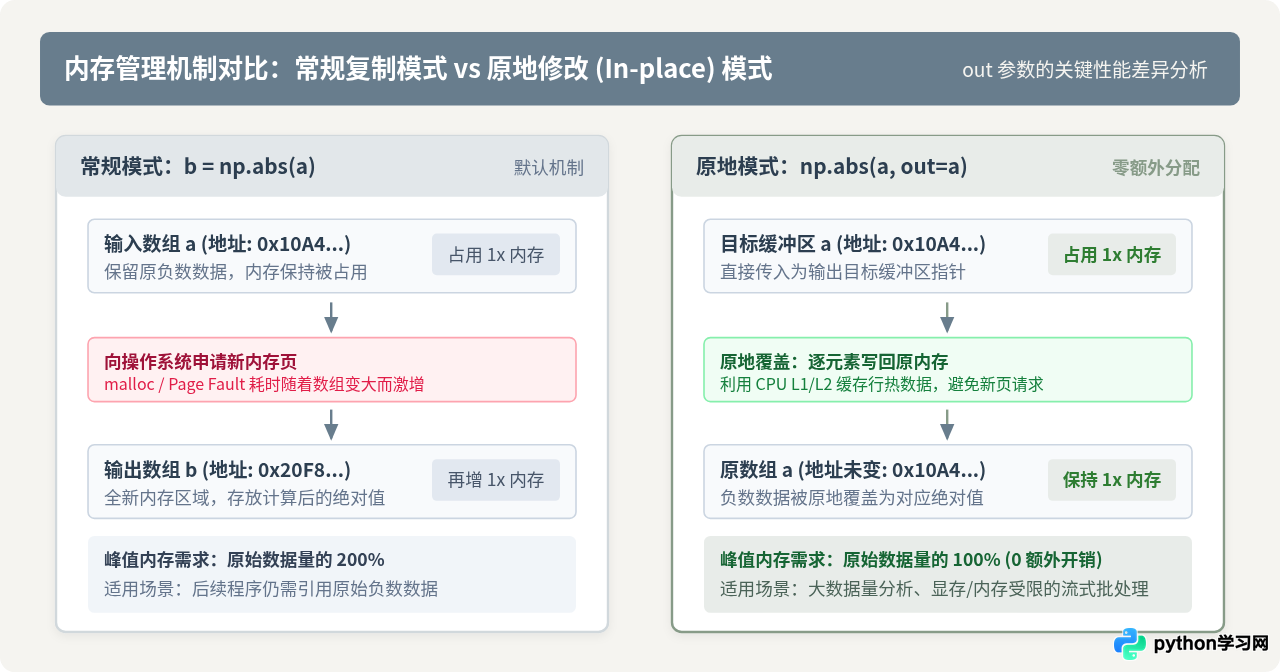
在处理中小型数组时,直接使用 result = np.abs(arr) 是最直观的做法。但在处理数百兆乃至数吉字节(GB)量级的大规模科学数据或机器学习特征时,两种不同的调用方式会对系统内存产生决定性影响。
1. 关键差异及其影响机制
常规模式(默认 out=None):执行 b = np.abs(a) 时,NumPy必须先向操作系统申请一块与数组 a 尺寸完全相同的全新内存空间,随后将计算结果写入新空间。如果数组 a 占用 8 GB 内存,那么在计算瞬间系统总共需要消耗 16 GB 物理内存。若可用内存不足,将直接引发 MemoryError 或触发虚拟内存剧烈换页。
原地模式(out=arr):通过指定通用函数的 out 参数(例如 np.abs(arr, out=arr)),NumPy直接将原数组的数据指针作为写入目标。底层计算引擎在读取每个元素后立即将绝对值结果写回同一个内存地址,峰值内存占用自始至终保持在 8 GB,额外物理内存开销为 0。
import numpy as np

# 创建一个占用较多内存的大型浮点数组(以500万个元素为例)
data = np.random.randn(5000000)

print("原始数组内存地址:", hex(data.ctypes.data))

# 做法 A:常规模式(产生新数组,内存地址改变)
new_data = np.abs(data)
print("常规模式输出地址:", hex(new_data.ctypes.data), "(与原地址不同,双倍内存开销)")

# 做法 B:原地修改模式(复用原内存缓冲区,内存地址保持不变)
np.abs(data, out=data)
print("原地模式处理后地址:", hex(data.ctypes.data), "(与原地址一致,零额外开销)")原始数组内存地址: 0x7fa280010000
常规模式输出地址: 0x7fa292020000 (与原地址不同,双倍内存开销)
原地模式处理后地址: 0x7fa280010000 (与原地址一致,零额外开销)out=arr 原地修改,以显著减少内存抖动和垃圾回收压力。
三、特殊数据类型与数值边界场景
NumPy的 np.abs() 不仅支持常见的浮点数与整型,还能处理复数、负零以及无穷大。不同数据类型在进行绝对值运算时遵循不同的数学定义和底层规范,理解这些细节有助于规避隐蔽的计算缺陷。
1. 复数数组:计算欧几里得模长
当输入数组是复数类型(如 complex64 或 complex128)时,绝对值的数学定义是复数的模长,即 \(|a + bi| = \sqrt{a^2 + b^2}\)。因此:
- 输出结果必然是实数浮点型(
complex128对应的输出类型为float64)。 - 不能直接对复数数组使用原地写回
np.abs(c_arr, out=c_arr),因为NumPy禁止将浮点数直接不经类型转换浇铸(cast)到复数类型容器中,否则会抛出TypeError。
import numpy as np

# 复数数组绝对值批量计算
c_arr = np.array([3.0 + 4.0j, -5.0 + 12.0j, 1.0 - 1.0j], dtype=np.complex128)
c_abs = np.abs(c_arr)

print("复数输入类型:", c_arr.dtype)
print("模长计算结果:", c_abs)
print("结果数据类型:", c_abs.dtype) # 自动转为 float64复数输入类型: complex128
模长计算结果: [ 5. 13. 1.41421356]
结果数据类型: float642. 特殊浮点数:负零、NaN 与 Inf 的运算表现
NumPy严格遵循 IEEE 754 浮点运算标准:
- 负零(-0.0):在浮点数中存在带符号的零,绝对值操作会清除符号位,输出标准的正零
0.0。 - 非数(np.nan):缺失值或无效计算结果在求绝对值后依然保持
nan,不会中断程序,也不会抛出异常。 - 无穷大(-np.inf / np.inf):负无穷大
-inf在绝对值运算后转换为正无穷大inf。
3. 有符号整型极小值溢出陷阱
在固定位宽的有符号整数补码表示中,负数范围总是比正数范围多一个值。例如在 8 位有符号整型 int8 中,数值范围是 [-128, 127]。
np.int8(-128) 执行绝对值计算,理论值应该是 +128。然而由于 128 超出了 int8 所能表达的最大上限 127,C语言底层发生整数溢出回绕,计算结果仍旧是 -128,并且通常不会抛出任何运行时异常!
import numpy as np

# 观察整数极小值溢出行为
int_arr = np.array([-128, -50, 0, 50, 127], dtype=np.int8)
bad_abs = np.abs(int_arr)
print("直接计算 int8 绝对值:", bad_abs)  # 注意首个元素仍然是负数 -128

# 正确做法:先进行数据类型提升(astype),再计算绝对值
safe_arr = int_arr.astype(np.int16)
safe_abs = np.abs(safe_arr)
print("提升为 int16 后计算绝对值:", safe_abs) # 首个元素正确变为 128直接计算 int8 绝对值: [-128 50 0 50 127]
提升为 int16 后计算绝对值: [128 50 0 50 127]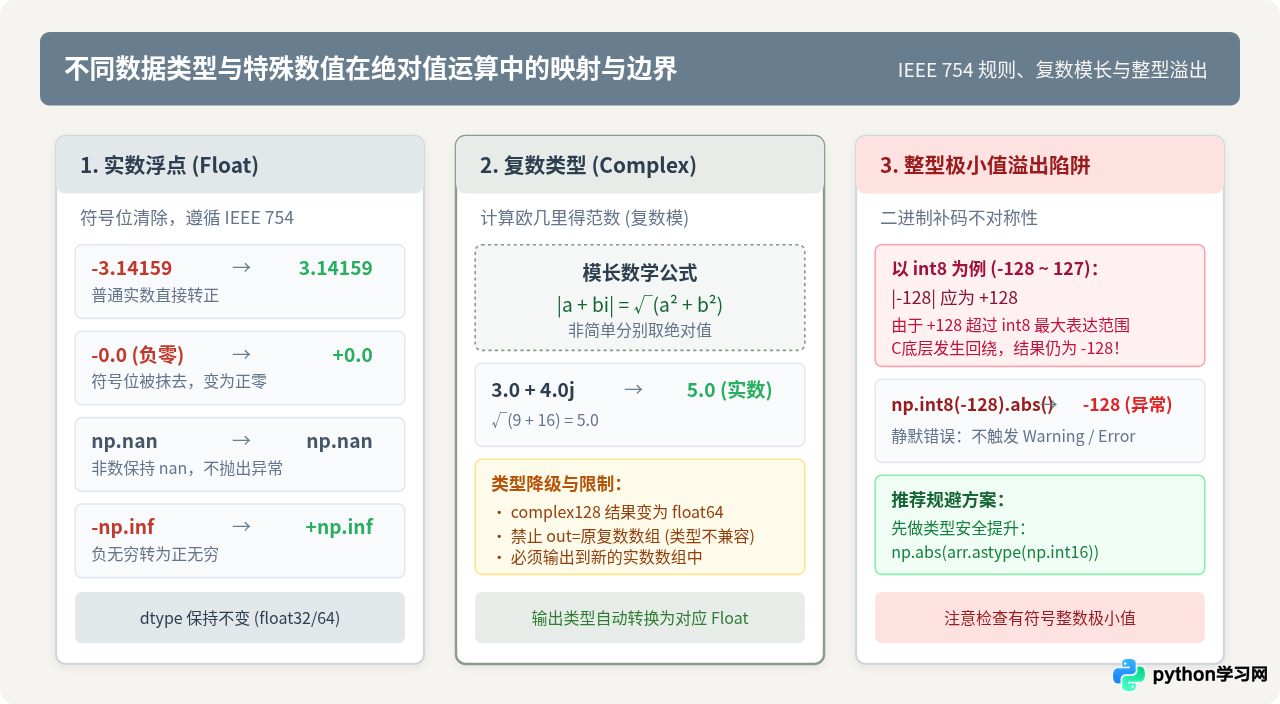
四、批量绝对值计算的标准工程流程
为了在实际工程与数据分析管道中写出健壮、高效的代码,建议按照以下四个标准化步骤组织计算过程:
-
输入检查与数据类型识别:
首先检查输入对象的
dtype。如果是有符号整型且可能包含边界极小值,提前使用astype()提升至更高位宽(如np.int32或np.int64);如果是复数,明确输出将降维为浮点数。 -
评估内存预算并选定计算模式:
通过
arr.nbytes评估内存占用。若数据规模庞大且不需要保留原负数,初始化或复用缓冲区,使用out=arr原地修改;若需保持输入不可变(纯函数模式),使用默认的np.abs(arr)。 -
执行批量向量化计算:
直接调用
np.abs()完成并行计算,避免使用 Python 原生的for循环或列表推导式。 -
后置校验与异常标记:
在金融、遥感或物理仿真场景中,使用
np.isnan()与np.isinf()快速扫描输出数组,验证是否存在因原数据异常导致的非数值残留。
import numpy as np

def batch_absolute_pipeline(data: np.ndarray, inplace: bool = False) -> np.ndarray:
    """
    工业级批量绝对值计算管道示例
    """
    # 步骤 1:处理有符号整型潜在溢出
    if np.issubdtype(data.dtype, np.signedinteger):
        # 如果包含当前类型的极小值,提升位宽
        type_info = np.iinfo(data.dtype)
        if (data == type_info.min).any():
            data = data.astype(np.int64)
            inplace = False  # 转换类型后产生新数组,不再支持原地覆盖

    # 步骤 2 & 3:执行计算
    if inplace:
        # 复数类型不允许原地覆盖
        if np.iscomplexobj(data):
            raise TypeError("复数数组无法原地覆写为浮点模长,请设置 inplace=False")
        np.abs(data, out=data)
        result = data
    else:
        result = np.abs(data)

    # 步骤 4:后置验证(可选)
    nan_count = np.count_nonzero(np.isnan(result))
    if nan_count > 0:
        print(f"[提示] 输出数组包含 {nan_count} 个 NaN 缺失值,需后续插值处理")

    return result

# 测试管道运行
test_matrix = np.array([[-1.2, np.nan], [-np.inf, 4.8]], dtype=np.float64)
clean_result = batch_absolute_pipeline(test_matrix, inplace=False)
print("管道处理输出:\n", clean_result)[提示] 输出数组包含 1 个 NaN 缺失值,需后续插值处理
管道处理输出:
[[1.2 nan]
[inf 4.8]]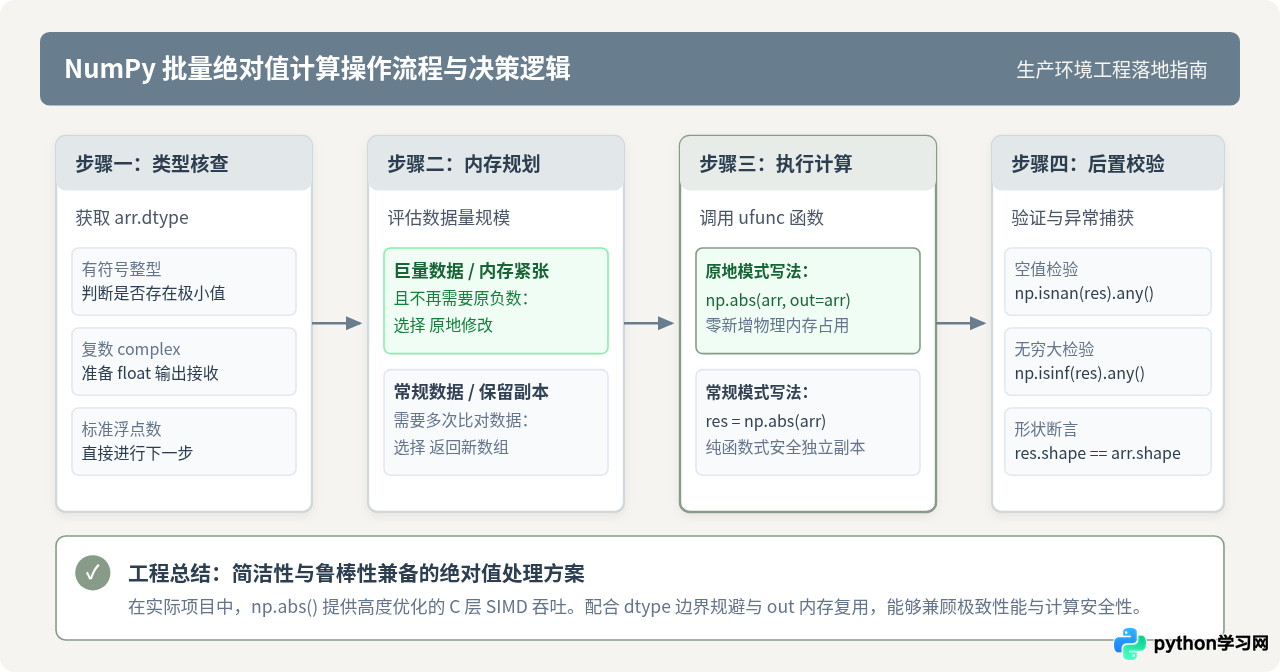
五、常见问题排查与速查总结
在实际编写代码时,开发者通常会在以下两种场景中遇到报错或逻辑疑问:
1. 常见报错排查
-
报错
ValueError: output array is read-only: 当尝试使用out=arr原地修改一个只读数组(例如通过共享内存映射、Pandas 只读视图或设置了arr.flags.writeable = False的数组)时,NumPy会拦截写入并报错。此时必须移除out参数,允许其返回一个全新的可写数组。 -
报错
TypeError: Cannot cast ufunc 'absolute' output from dtype('float64') to dtype('complex128') with casting rule 'same_kind': 该错误通常发生在对复数数组执行np.abs(c_arr, out=c_arr)时。解决办法是让out参数指向一个相同维度的float64数组,或者直接使用real_res = np.abs(c_arr)接收新数组。
2. 核心方法特性速查表
| 方法 / 调用形式 | 内存行为 | 适用数据类型 | 典型应用场景与注意事项 |
|---|---|---|---|
np.abs(arr) |
分配新数组 (1x 额外内存) | 整型、浮点、复数、布尔 | 标准用法,保持原数组不可变,线程安全 |
np.abs(arr, out=arr) |
原地覆盖 (0 额外物理内存) | 整型、浮点数(不可为复数) | 大规模数据批处理、显存或内存极为受限的场景 |
np.abs(arr.astype(...)) |
转换产生临时数组 | 有符号整型 (int8/int16) | 规避二进制补码极小值溢出(如 -128 变成 -128) |
np.abs(complex_arr) |
生成实数浮点数组 | complex64 / complex128 | 计算复数欧几里得模长 \(\sqrt{a^2+b^2}\),输出维度不变 |
综上所述,在Python中使用NumPy批量计算数组绝对值时,np.abs() 凭借其底层优化的通用函数架构提供了优异的计算吞吐。在工程实践中,根据数据规模合理选取常规副本模式或 out 原地模式,并在整型边界与复数模长计算时做好类型管控,即可高效、稳健地完成批量绝对值处理任务。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









