

Python怎么利用property实现计算属性
详细讲解Python中如何使用property装饰器实现计算属性,包括基本用法、带缓存的计算属性、setter验证、常见误区及完整示例。
在Python中,property可以把一个方法伪装成属性,让外部代码用obj.xxx的方式访问,而背后实际执行的是一段计算逻辑。利用这个机制,可以实现"计算属性"——属性的值不是直接存储的,而是在每次访问时根据其他数据动态算出来的。本文从最基础的用法出发,逐步介绍如何用property实现计算属性、怎样给计算属性加上缓存、怎样通过setter做校验,以及几个容易踩的坑。
什么是计算属性
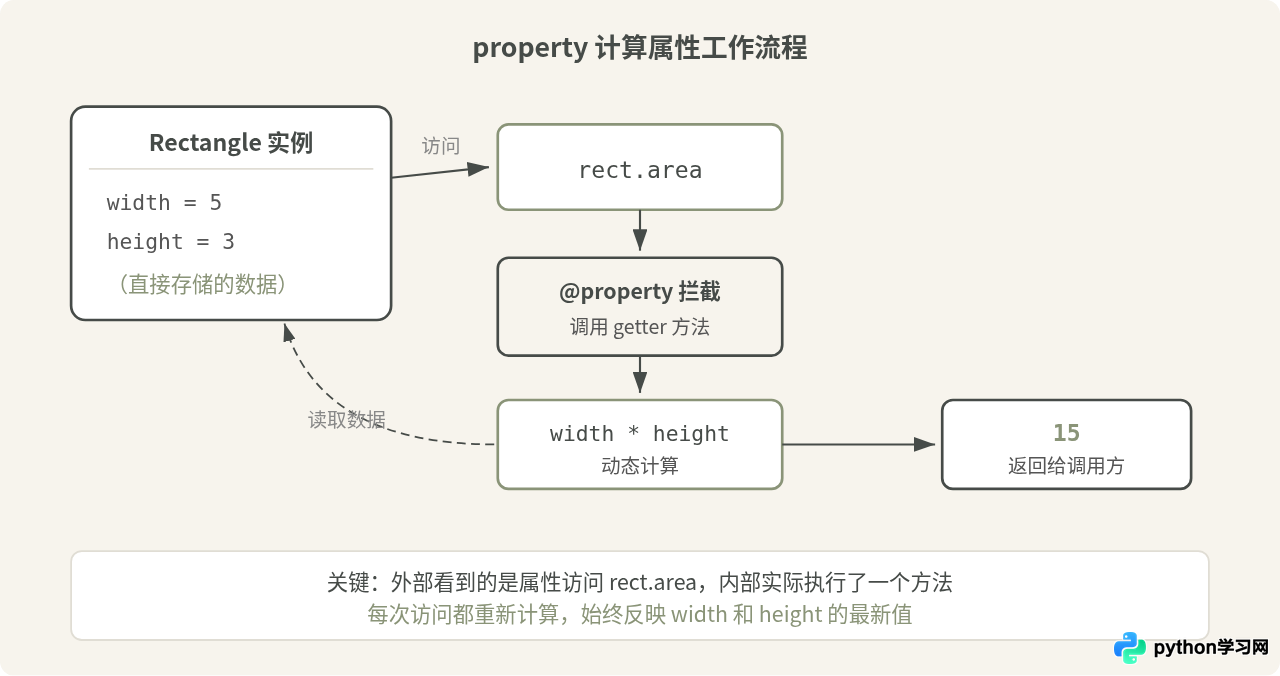
假设有一个Rectangle类,保存了width和height。面积area并不需要单独存储,因为它总是等于width * height。如果把area定义成一个普通方法,调用时必须写rect.area(),加上括号。但面积在语义上更像一个属性,而不是一个动作。这时就适合使用property把方法变成属性访问的形式。
计算属性的特征是:它的值不直接存储在实例字典里,而是在每次读取时通过一段代码从其他属性推导出来。Python标准库中的property正是为这种场景设计的。
property的基本用法
最常见的方式是用@property装饰器。下面的例子定义了一个矩形类,area和perimeter都是计算属性:
class Rectangle:
    def __init__(self, width, height):
        self.width = width
        self.height = height

    @property
    def area(self):
        return self.width * self.height

    @property
    def perimeter(self):
        return 2 * (self.width + self.height)

rect = Rectangle(5, 3)
print(rect.area)        # 15
print(rect.perimeter)   # 16

rect.width = 10
print(rect.area) # 30,自动跟随变化16
30
注意最后三行:访问rect.area时没有括号,就像访问普通属性一样。当width被修改后,再次访问area会重新计算,返回更新后的值。这就是计算属性的核心——它始终反映当前状态,不需要手动同步。
property的另一种写法
除了装饰器语法,property本身是一个内置类,也可以用函数调用的方式使用。这种写法在需要同时指定getter、setter、deleter时比较紧凑:
class Circle:
    def __init__(self, radius):
        self._radius = radius

    def _get_area(self):
        import math
        return math.pi * self._radius ** 2

    def _get_diameter(self):
        return self._radius * 2

    area = property(_get_area, doc="圆的面积(只读计算属性)")
diameter = property(_get_diameter, doc="圆的直径(只读计算属性)")这段代码和使用@property装饰器效果完全一样。选择哪种写法取决于个人习惯,装饰器形式在实际项目中更常见。
给计算属性加上setter
有时候希望计算属性不仅能读,还能写,并且在写入时反向更新底层数据。比如温度转换:
class Temperature:
    def __init__(self, celsius):
        self._celsius = celsius

    @property
    def celsius(self):
        return self._celsius

    @celsius.setter
    def celsius(self, value):
        if value < -273.15:
            raise ValueError("温度不能低于绝对零度 -273.15°C")
        self._celsius = value

    @property
    def fahrenheit(self):
        return self._celsius * 9 / 5 + 32

    @fahrenheit.setter
    def fahrenheit(self, value):
        c = (value - 32) * 5 / 9
        if c < -273.15:
            raise ValueError("温度不能低于绝对零度")
        self._celsius = c

t = Temperature(100)
print(t.fahrenheit)     # 212.0

t.fahrenheit = 32
print(t.celsius) # 0.00.0
这里fahrenheit是一个双向计算属性:读取时从摄氏度换算,写入时反向换算回摄氏度。setter中同时做了范围校验,保证数据始终合法。
@fahrenheit.setter下面定义的函数也必须叫fahrenheit,否则会创建一个新的普通方法,而不是给已有的property添加setter。
带缓存的计算属性
普通的@property每次访问都会重新计算。如果计算比较耗时,而依赖的数据又不常变化,可以加上缓存来避免重复计算。
手动实现缓存
思路是在实例上用一个私有属性存储计算结果和当时的依赖值,访问时先对比依赖是否变化:
class DataSet:
    def __init__(self, values):
        self._values = list(values)
        self._sum_cache = None
        self._cache_snapshot = None

    @property
    def values(self):
        return self._values

    @values.setter
    def values(self, new_values):
        self._values = list(new_values)
        self._sum_cache = None  # 清除缓存

    @property
    def total(self):
        snapshot = tuple(self._values)
        if self._sum_cache is None or self._cache_snapshot != snapshot:
            self._sum_cache = sum(self._values)
            self._cache_snapshot = snapshot
        return self._sum_cache

ds = DataSet([1, 2, 3, 4, 5])
print(ds.total)   # 15,首次计算
print(ds.total)   # 15,命中缓存
ds.values = [10, 20]
print(ds.total)   # 30,数据变了,重新计算
15
30
使用 functools.cached_property
Python 3.8 引入了functools.cached_property,它会在第一次访问时计算结果,然后把结果直接存到实例字典里,后续访问直接读取,不再调用计算方法:
from functools import cached_property

class ExpensiveReport:
    def __init__(self, raw_data):
        self.raw_data = raw_data

    @cached_property
    def summary(self):
        print("正在计算摘要...")  # 只会打印一次
        return {
            "count": len(self.raw_data),
            "total": sum(self.raw_data),
            "average": sum(self.raw_data) / len(self.raw_data)
        }

report = ExpensiveReport([85, 90, 78, 92, 88])
print(report.summary)
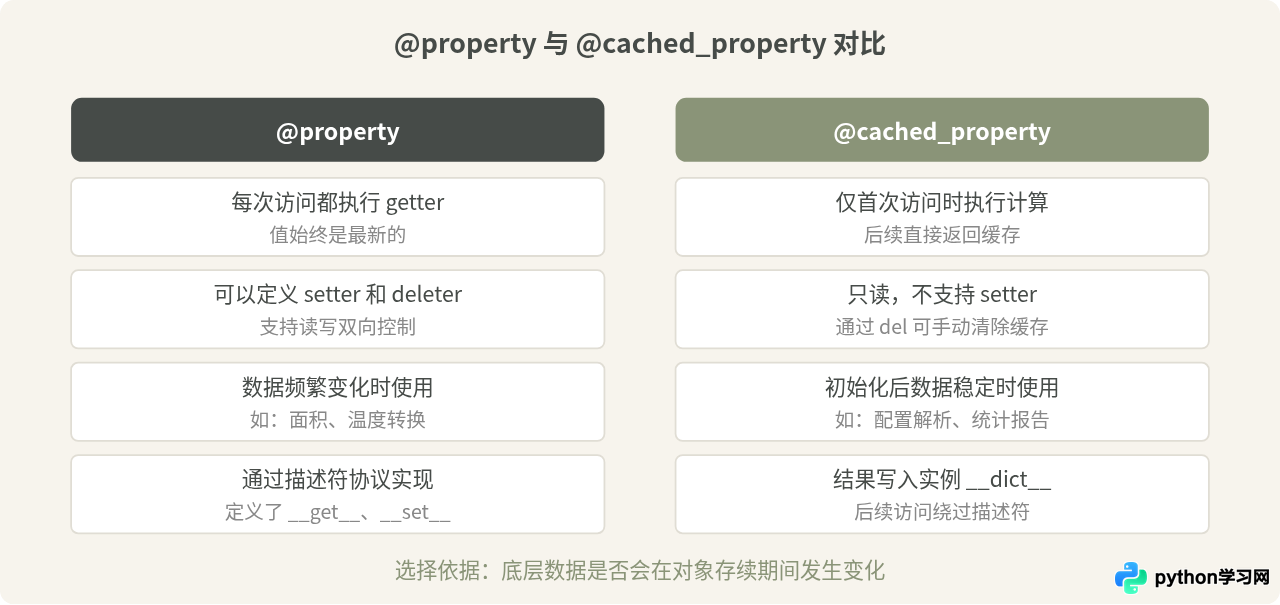
print(report.summary) # 第二次不会再打印"正在计算摘要..."cached_property和property有一个关键区别:cached_property计算一次后就不再更新了。如果底层数据变了,缓存不会自动失效。要手动刷新,需要删掉实例字典中的对应项:
# 手动刷新 cached_property
del report.__dict__["summary"]
print(report.summary) # 重新计算所以cached_property适合那些依赖数据在对象生命周期内不变(或很少变)的场景,比如配置解析、一次性统计。如果数据频繁变化,还是用普通@property更合适。
实际应用:用户模型中的计算属性
下面是一个更贴近实际开发的例子。一个用户模型中包含出生日期,年龄和是否成年都是从出生日期计算得来的:
from datetime import date

class User:
    def __init__(self, name, birth_date):
        self.name = name
        self.birth_date = birth_date   # date对象

    @property
    def age(self):
        today = date.today()
        born = self.birth_date
        age = today.year - born.year
        # 如果今年还没过生日,年龄减1
        if (today.month, today.day) < (born.month, born.day):
            age -= 1
        return age

    @property
    def is_adult(self):
        return self.age >= 18

    @property
    def display_name(self):
        return f"{self.name}({self.age}岁)"

user = User("张三", date(2000, 6, 15))
print(user.age)           # 根据当前日期计算
print(user.is_adult)      # True
print(user.display_name) # 张三(xx岁)这个例子展示了计算属性的几个典型特点:age依赖于当前日期,每次访问都可能得到不同的值;is_adult是在另一个计算属性基础上的二次计算;display_name把多个属性组合成一个格式化字符串。这些都不适合在__init__时一次性赋值,因为它们的值会随时间或其他属性的变化而变化。
容易踩的坑
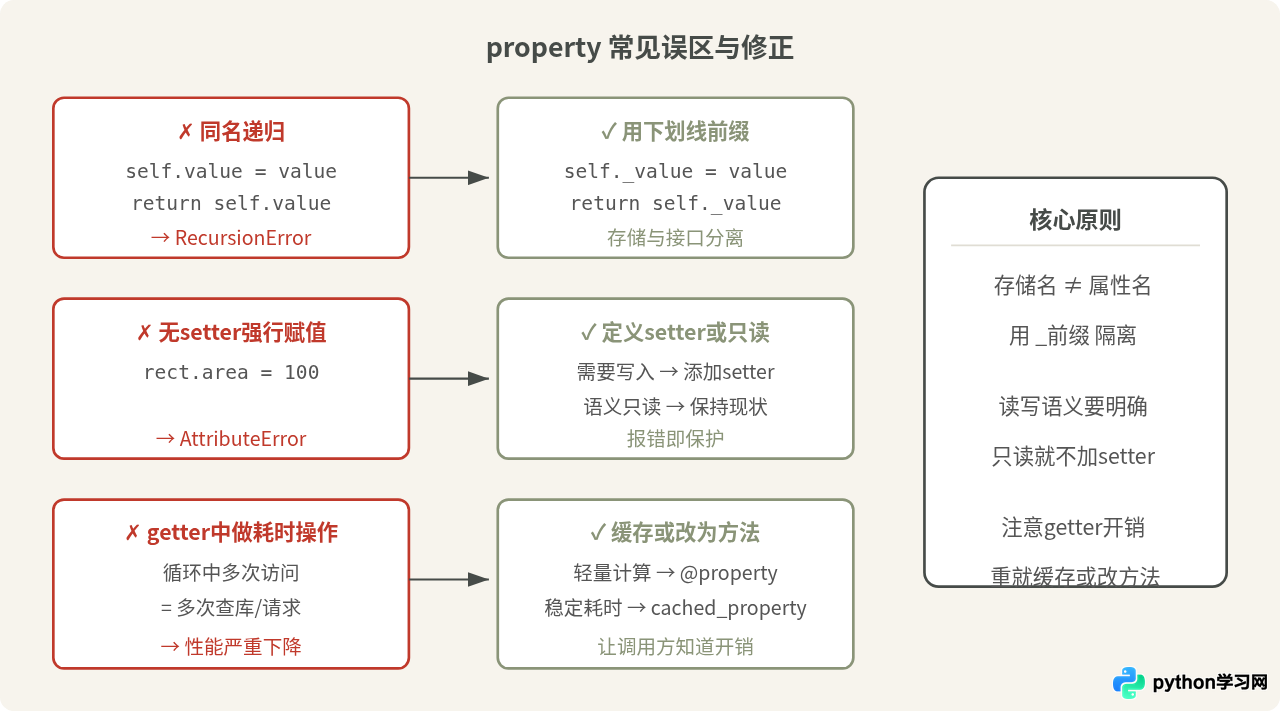
坑一:property和实例属性同名
一个常见错误是在__init__中使用了和property同名的属性,导致递归或行为异常:
# 错误示范
class Bad:
    def __init__(self, value):
        self.value = value  # 这里会触发setter

    @property
    def value(self):
        return self.value   # 递归调用自身!无限循环

    @value.setter
    def value(self, v):
        self.value = v      # 又递归了!
解决办法是用一个带下划线前缀的私有属性存储实际数据:
# 正确写法
class Good:
    def __init__(self, value):
        self._value = value

    @property
    def value(self):
        return self._value

    @value.setter
    def value(self, v):
        self._value = v
坑二:计算属性不可赋值
如果只定义了@property而没有定义setter,给这个属性赋值会报AttributeError:
rect = Rectangle(5, 3)
rect.area = 100  # AttributeError: property 'area' of 'Rectangle' object has no setter
这其实是property的保护功能——面积由宽高决定,直接修改面积没有意义。如果确实需要赋值,就要定义setter并决定赋值时如何反向更新底层数据。
坑三:在property的getter中做耗时操作
因为每次访问obj.xxx都会执行getter方法,如果getter中有数据库查询、文件读取或网络请求等耗时操作,性能会出问题。在一个循环中多次访问这样的property,相当于重复执行了多次耗时操作。解决方法是使用前面提到的缓存策略,或者把耗时操作改成显式方法调用(如load_data()),让调用方意识到这是一个开销较大的操作。
property背后的描述符协议
property之所以能拦截属性访问,是因为它实现了Python的描述符协议。理解这一点有助于在遇到异常行为时排查问题。
当一个类定义了__get__方法(还可以选择定义__set__和__delete__),并且这个类的实例被赋值给另一个类的类属性时,这个实例就是一个描述符。property就是一个内置的描述符类,它的__get__调用你定义的getter函数,__set__调用你的setter函数。
简化来说,当你写rect.area时,Python的查找顺序大致是:
- 检查
Rectangle类(及其父类)中是否有名为area的数据描述符(同时定义了__get__和__set__的描述符)。如果有,调用它的__get__。 - 检查实例的
__dict__中是否有area。 - 检查类中是否有名为
area的非数据描述符(只定义了__get__)。
property定义了__get__和__set__(即使你没写setter,它也有一个默认的__set__会抛出异常),所以它是数据描述符,优先级最高。而cached_property只定义了__get__,是非数据描述符,优先级低于实例字典——这就是它能被缓存覆盖的原因。
完整示例:购物车中的计算属性
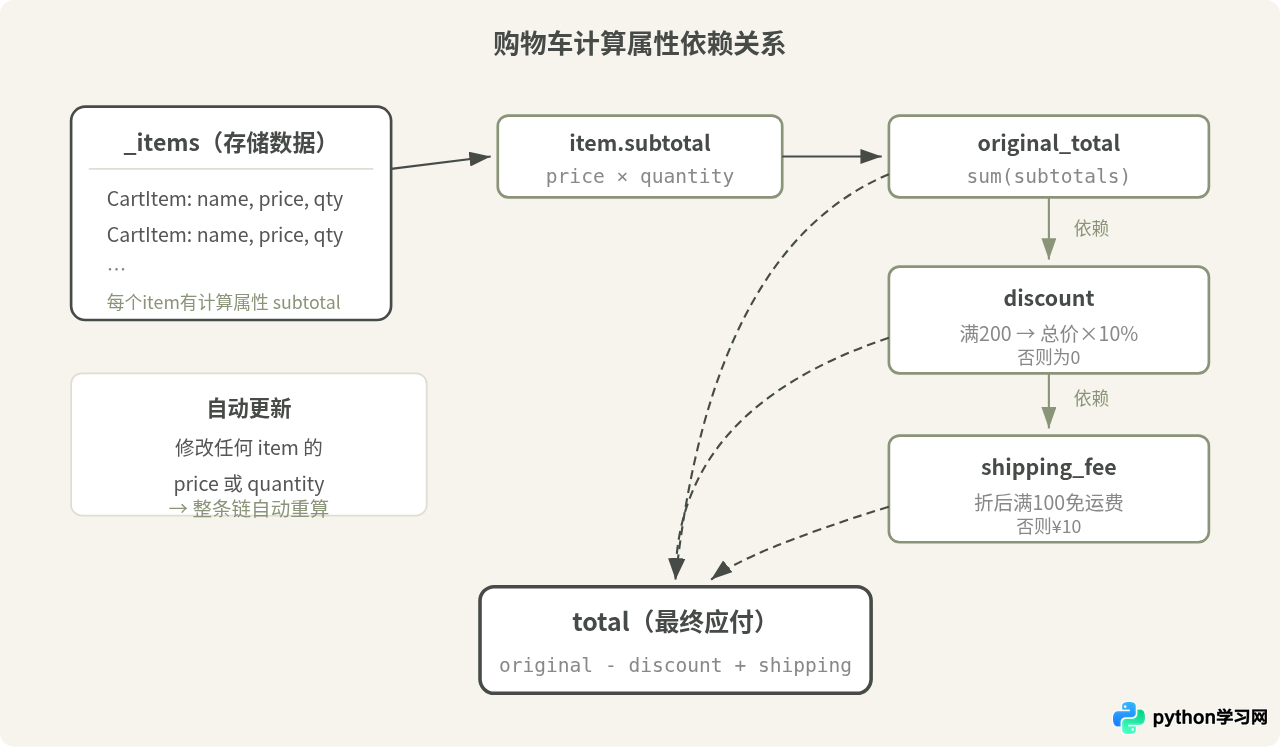
最后通过一个稍复杂的例子把前面的知识串起来。这个购物车类包含多个计算属性,展示了它们之间的依赖关系:
class CartItem:
    def __init__(self, name, price, quantity=1):
        self.name = name
        self.price = price
        self.quantity = quantity

    @property
    def subtotal(self):
        return self.price * self.quantity

    def __repr__(self):
        return f"CartItem({self.name!r}, ¥{self.price}, ×{self.quantity})"


class ShoppingCart:
    DISCOUNT_THRESHOLD = 200   # 满200打折
    DISCOUNT_RATE = 0.9        # 九折
    FREE_SHIPPING_THRESHOLD = 100

    def __init__(self):
        self._items = []

    def add(self, name, price, quantity=1):
        # 检查是否已有同名商品
        for item in self._items:
            if item.name == name:
                item.quantity += quantity
                return
        self._items.append(CartItem(name, price, quantity))

    @property
    def items(self):
        return list(self._items)  # 返回副本,防止外部修改

    @property
    def original_total(self):
        """折扣前的总价"""
        return sum(item.subtotal for item in self._items)

    @property
    def discount(self):
        """折扣金额"""
        if self.original_total >= self.DISCOUNT_THRESHOLD:
            return round(self.original_total * (1 - self.DISCOUNT_RATE), 2)
        return 0

    @property
    def shipping_fee(self):
        """运费"""
        if self.original_total - self.discount >= self.FREE_SHIPPING_THRESHOLD:
            return 0
        return 10

    @property
    def total(self):
        """最终应付金额"""
        return self.original_total - self.discount + self.shipping_fee

    @property
    def summary(self):
        lines = [f"  {item.name}: ¥{item.price} × {item.quantity} = ¥{item.subtotal}"
                 for item in self._items]
        lines.append(f"  原价合计: ¥{self.original_total}")
        if self.discount > 0:
            lines.append(f"  折扣优惠: -¥{self.discount}")
        lines.append(f"  运费: ¥{self.shipping_fee}")
        lines.append(f"  应付总额: ¥{self.total}")
        return "\n".join(lines)


cart = ShoppingCart()
cart.add("Python编程指南", 89)
cart.add("机械键盘", 159)
print(cart.summary)机械键盘: ¥159 × 1 = ¥159
原价合计: ¥248
折扣优惠: -¥24.8
运费: ¥0
应付总额: ¥223.2
这个例子中,original_total→discount→shipping_fee→total形成了一条计算链,每个属性都依赖前面的属性。添加或删除商品后,整条链上的值都会自动更新,不需要手动调用任何刷新方法。这正是计算属性的价值所在。
小结
property让Python可以用属性语法封装计算逻辑,适合那些值由其他数据推导而来、不需要单独存储的场景。使用时把握几个要点:用@property定义getter,用@xxx.setter定义setter;存储用的私有属性加下划线前缀,避免和property同名;轻量计算用@property,稳定不变的耗时计算考虑cached_property;getter中避免放数据库查询等重操作。掌握这些,计算属性就能在保持接口简洁的同时,让数据始终保持一致。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









