

Python面向对象初探:用“学生类”案例解释class与__init__
通过通俗易懂的“学生类(Student)”实际案例,深入剖析Python面向对象编程的核心概念,彻底搞懂class的定义、__init__初始化方法的作用机制、self的本质以及面向对象与面向过程的核心差异。
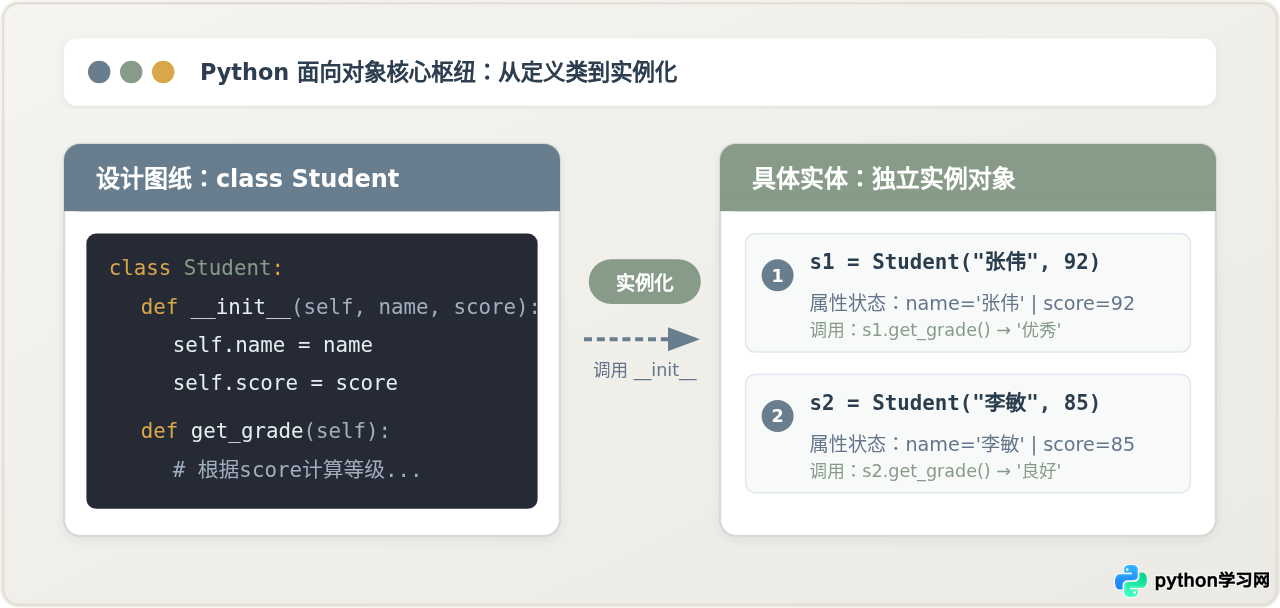
class 负责定义对象的结构蓝图,而 __init__ 方法负责在创建具体对象时完成初始属性赋值。本文以构建一个真实的“学生信息与成绩管理类(Student)”为切入点,拆解类的定义语法、实例化全生命周期中 __init__ 与 self 的协作机制,并通过与面向过程散装字典的对比,理清面向对象设计的基本价值与常见陷阱。
一、从现实到代码:为什么需要 class(类)?
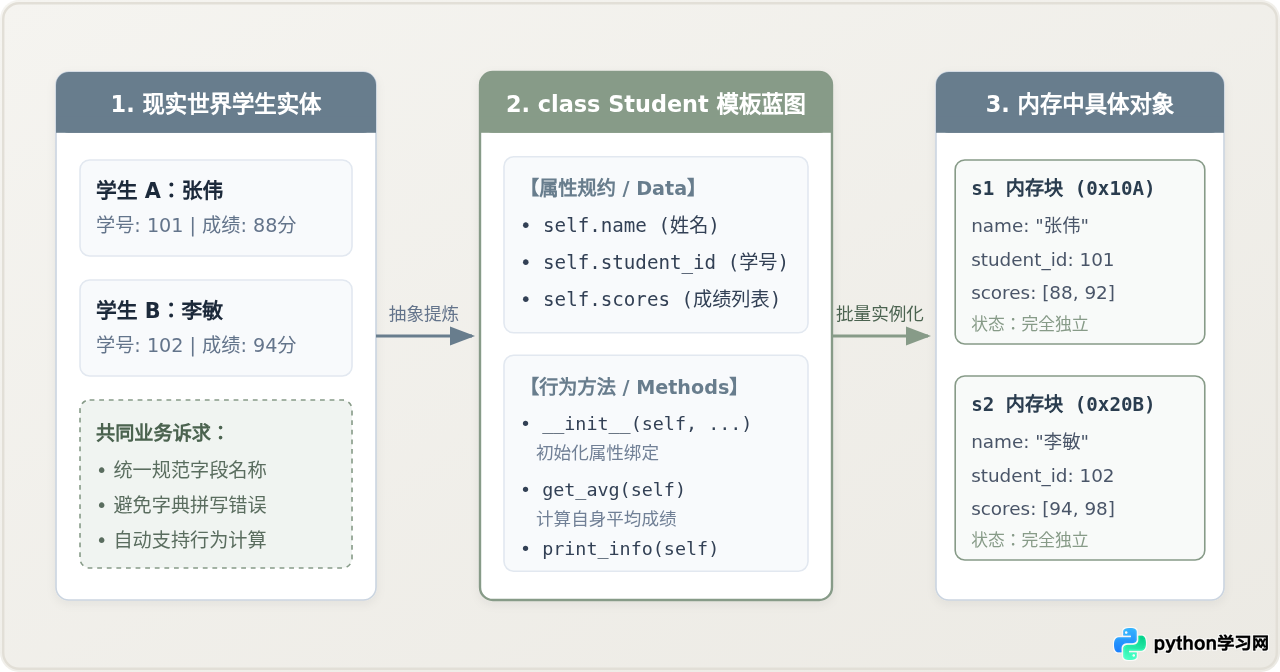
在日常开发中,我们经常需要处理具有固定特征和特定行为的事物。例如在教务系统中,每名“学生”都具备姓名、学号、各科成绩等信息,同时也需要执行计算平均分、打印个人学籍报告等操作。
如果没有面向对象机制,我们往往会用字典或多个分散的变量来存储数据,再编写一堆外部函数来传递这些字典。随着业务规模扩大,数据结构容易被打乱,函数与数据之间也缺乏绑定。
类(Class)正是为了解决这种混乱而诞生的概念:
- 类(Class)是图纸与模具:它规定了这一类事物应该具备哪些属性变量(如名字、成绩),以及拥有哪些功能函数(方法)。类本身并不代表某一个具体的学生,而是一个模板。
- 对象 / 实例(Object / Instance)是具体实体:通过图纸制造出的具体学生(如“张伟”、“李敏”)。每个实例都拥有自己独立的一份属性存储空间,但共享类所定义的方法。
二、类的骨架与初始化:class 与 __init__ 语法拆解
在 Python 中定义一个类非常直接,使用关键字 class 后跟类名即可。根据 PEP 8 命名规范,类名推荐使用大驼峰命名法(PascalCase),即每个单词首字母大写,例如 Student 或 GraduatedStudent。
1. 最小的类定义
class Student:
    pass
虽然上述代码定义了一个合法的类,但由于没有任何属性和方法,它目前除了能够实例化一个空对象外毫无用处。
2. 核心初始化方法:__init__ 与 self
当我们用模具压制出一个学生实例时,必须为他填入具体的姓名、学号等数据。在 Python 中,这项工作由特殊方法 __init__ 承担:
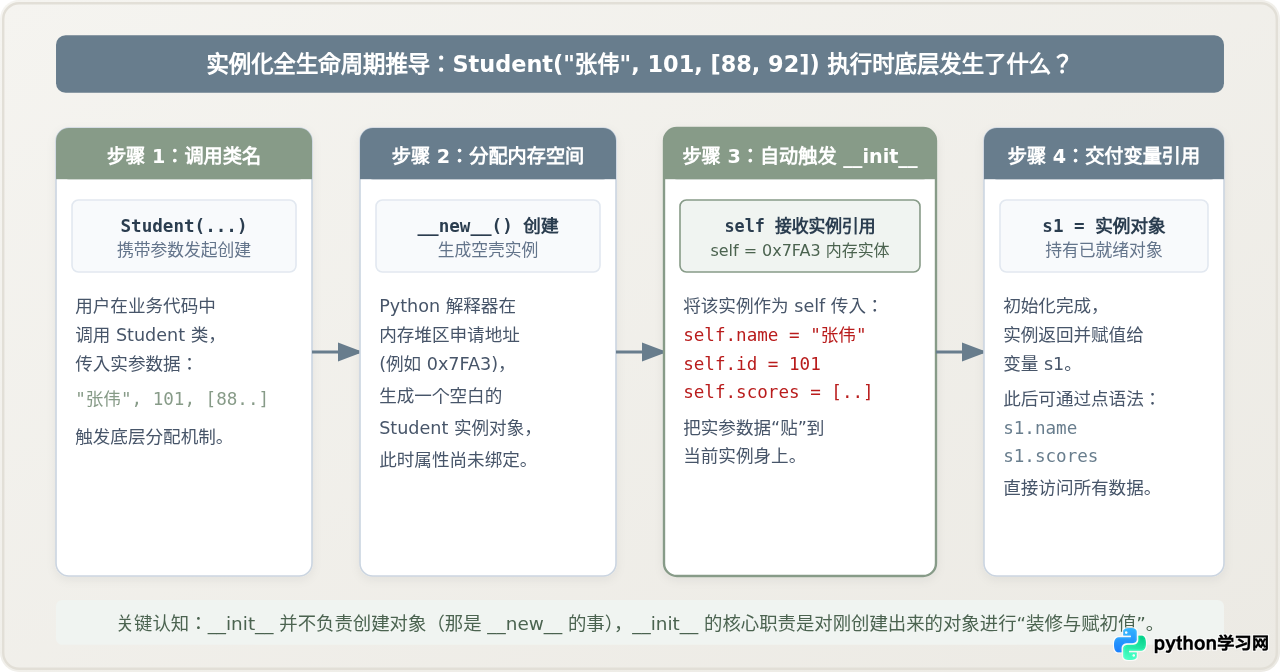
__init__是 Python 对象的初始化方法(Initialization Method)。它的前后分别有两个下划线(通常称为双下划线或 dunder,即 Double Underscore)。- 当你执行
s1 = Student("张伟", 101)时,Python 解释器会自动调用__init__函数。 self参数是 Python 的核心约定。它代表当前正在被创建和初始化的那个实例对象本身。通过self.name = name,我们把外部传入的参数赋值给当前实例自身的属性槽位。
下面是一个完整的学生类定义与实例化演示:
# 文件路径:student_demo.py
# 运行环境:Python 3.6+

class Student:
    def __init__(self, name, student_id, scores):
        """
        初始化学生对象
        :param name: 学生姓名(字符串)
        :param student_id: 学号(字符串或整数)
        :param scores: 成绩列表(包含各科分数的 list)
        """
        self.name = name
        self.student_id = student_id
        self.scores = scores

# 实例化学生对象
student1 = Student("张伟", "20240101", [88, 92, 79])
student2 = Student("李敏", "20240102", [95, 90, 94])

# 查看对象的属性
print(f"学生1姓名: {student1.name},学号: {student1.student_id},成绩: {student1.scores}")
print(f"学生2姓名: {student2.name},学号: {student2.student_id},成绩: {student2.scores}")学生2姓名: 李敏,学号: 20240102,成绩: [95, 90, 94]
def __init__(self, name, student_id, scores): 时,形参列表里有 4 个参数(包括 self);但在调用 Student("张伟", "20240101", [88, 92, 79]) 时,我们只传了 3 个实参。这是因为 Python 解释器会自动将新创建的实例作为第一个参数传递给 self,开发者无需也不应该手动传入 self。
三、两种实现方式的对比:面向过程字典 vs 面向对象类实例
很多初学者会有疑问:“我用字典存储学生数据,再写一个函数来算平均分,代码也很短,为什么一定要大费周章写 class?”
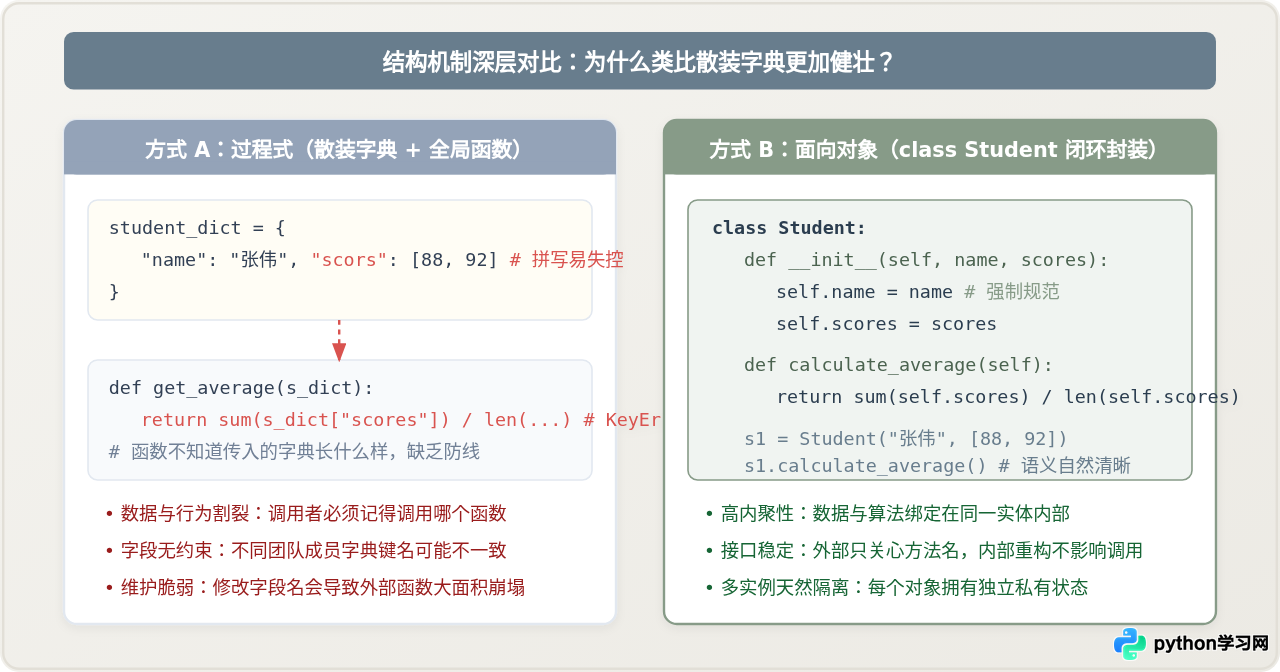
为了直观说明差异,我们在相同的业务条件下(记录学生姓名与多科成绩,并提供计算平均分的功能),分别用“面向过程(字典 + 独立函数)”与“面向对象(Student 类封装)”实现:
实现方案对比
| 对比维度 | 方式 A:面向过程(字典 + 外部函数) | 方式 B:面向对象(class Student 封装) |
|---|---|---|
| 数据存储结构 | stu = {"name": "张伟", "scores": [88, 92]}散装键值对,键名全靠程序员记忆。 |
stu = Student("张伟", [88, 92])结构由 __init__ 统一规范,属性名严格固定。 |
| 计算方法调用 | calc_average(stu)外部独立函数,必须手动把字典作为参数传入。 |
stu.calculate_average()方法直接内聚在对象上,自带数据上下文( self)。 |
| 拼写与结构校验 | 若某个字典不小心把 "scores" 误写为 "score",调用函数时才抛出 KeyError,极难排查。 |
在 __init__ 参数定义处就完成了约束,参数不匹配会立即报错,防范潜在隐患。 |
| 可维护性与扩展 | 函数与字典分离在各处,修改数据结构时需要全局搜索所有使用该字典的函数。 | 数据与操作在类内部高内聚,修改类的内部实现对外完全黑盒透明,调用代码无需更改。 |
四、完整实战:为 Student 类赋予方法与交互能力
一个实用的类不仅包含数据属性,更具备处理这些数据的能力。在类内部定义的函数被称为方法(Method)。与普通函数不同,实例方法的第一个参数必须是 self,以便在方法执行时能够访问当前实例的属性。
接下来我们扩充 Student 类,添加“计算平均分”与“输出学籍诊断报告”两个方法:
# 文件名:student_management.py
# 运行环境:Python 3.6+

class Student:
    def __init__(self, name, student_id, scores):
        """
        初始化学生基础数据
        """
        self.name = name
        self.student_id = student_id
        self.scores = scores

    def calculate_average(self):
        """
        计算该学生的各科平均成绩
        """
        if not self.scores:
            return 0.0
        return sum(self.scores) / len(self.scores)

    def print_report(self):
        """
        打印学生的综合学习报告
        """
        avg = self.calculate_average()
        status = "优秀" if avg >= 90 else ("良好" if avg >= 80 else "及格")
        print("=" * 36)
        print(f"学生姓名 : {self.name}")
        print(f"学号     : {self.student_id}")
        print(f"科目成绩 : {self.scores}")
        print(f"平均分   : {avg:.1f} 分")
        print(f"学业表现 : {status}")
        print("=" * 36)


# 实例化两个不同的学生对象
stu_zhang = Student("张伟", "20240101", [88, 92, 85, 95])
stu_li = Student("李敏", "20240102", [95, 96, 92, 98])

# 分别调用各自的汇报方法
stu_zhang.print_report()
stu_li.print_report()学生姓名 : 张伟
学号 : 20240101
科目成绩 : [88, 92, 85, 95]
平均分 : 90.0 分
学业表现 : 优秀
====================================
====================================
学生姓名 : 李敏
学号 : 20240102
科目成绩 : [95, 96, 92, 98]
平均分 : 95.2 分
学业表现 : 优秀
====================================
在上面的代码中:
- 当执行
stu_zhang.print_report()时,self自动指向stu_zhang,读取的是张伟的成绩列表[88, 92, 85, 95]。 - 当执行
stu_li.print_report()时,self自动指向stu_li,读取的是李敏的成绩列表。 - 同名方法在不同实例上调用时,各自读取各自的数据,实现了真正的数据隔离与逻辑复用。
五、初学者高频陷阱与防错检查清单
在初次接触 class 与 __init__ 时,有三个非常容易混淆甚至导致隐藏 Bug 的知识点,需特别警惕:
陷阱 1:在方法内部漏写 self 前缀
在 __init__ 内部,如果只写 name = name,这个 name 只会是该函数内的局部临时变量,在 __init__ 执行完毕后就会被垃圾回收器销毁,根本没有挂载到对象身上。正确的做法是必须写成 self.name = name。
陷阱 2:企图在 __init__ 中使用 return 返回值
__init__ 的唯一职责是初始化对象,其返回值必须隐式为 None。如果你试图在 __init__ 中写 return "初始化成功" 或返回具体数据,Python 解释器会直接抛出 TypeError: __init__() should return None, not '...'。
陷阱 3:混淆“类属性”与“实例属性”(可变对象共享大坑)
如果在类体顶层(而非 __init__ 中)定义了一个列表,这个列表将成为所有实例共享的类属性:
# 错误示例:类属性定义了可变对象
class StudentWrong:
    scores = []  # 这是属于类的共享列表!

    def __init__(self, name):
        self.name = name

s1 = StudentWrong("张伟")
s2 = StudentWrong("李敏")

s1.scores.append(100)
print(s2.scores) # 输出 [100]!李敏莫名其妙多出了张伟的成绩避坑准则:属于每个独立个体的属性(尤其是列表、字典等可变容器),必须严格在 __init__ 中通过 self.xxx = [] 进行定义!
结语
掌握 class 与 __init__ 是迈入 Python 高级开发的第一座里程碑。class 为我们提供了封装事物的图纸,而 __init__ 与 self 的配合让每个实例对象得以拥有独立的生命周期与状态空间。通过将散落的数据与独立函数整合为紧凑的类,不仅提升了代码的可读性,更为后续探索类的继承(Inheritance)、多态(Polymorphism)以及更复杂的系统设计奠定了坚实的基础。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









