

怎么检验Python自学效果?自测方法与实战小项目推荐
针对Python自学者容易出现的“看懂视频却写不出代码”的假性掌握问题,本文提供了一套脱离教程的四步闭环自测方法,并推荐了4个不同应用场景的实战小项目与量化验收清单,帮助读者精准检验并巩固自学成效。
检验Python自学效果的核心标准只有一个:在完全不看教学视频、不翻阅现成源码、脱离AI即时补全的前提下,能否将一个真实的日常需求拆解成程序逻辑,并独立写出能够正常运行、具备基础容错能力的完整代码。
一、认知定位:识别“看懂”与“学会”的真实差距
绝大多数Python自学者在经历语法速成或视频打卡后,都会产生一种“我好像都理解了”的心理预期。然而一旦打开空白编辑器,往往连变量名该怎么定义、主流程第一行该写什么都无从下手。这种现象本质上是因为“被动接收认知”与“主动逻辑构建”之间存在巨大断层。
阅读现成代码只需读者顺着既有逻辑进行验证,属于最低阶的记忆与识别;而独立编写程序则需要逆向完成“需求理解 → 模块划分 → 数据容器选择 → 边界条件防御”的全流程。检验自学成效的第一步,就是通过清晰的分级标准,准确判断自己当前处于哪个阶段。
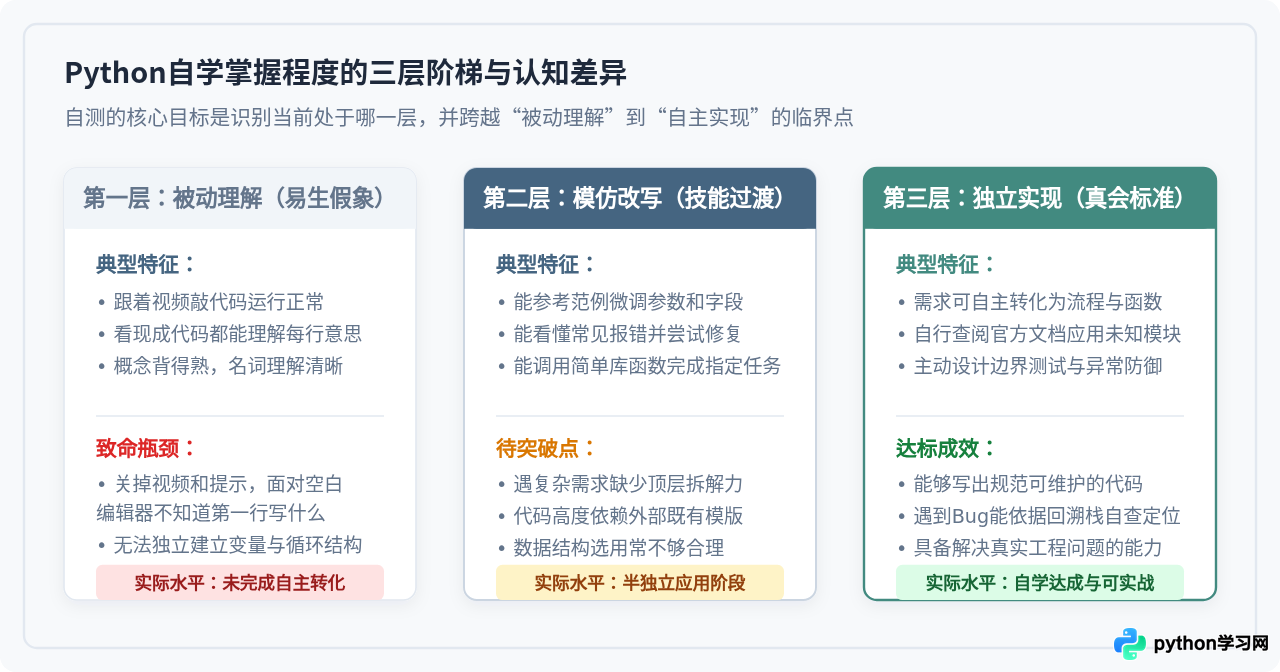
如上图所示,当自学者仍处于“第一层被动理解”时,任何盲目刷更高阶技术框架(如Django、深度学习框架)的行为都是在沙滩上建高楼。只有当能够达到“第二层模仿改写”并向“第三层独立实现”跨越时,自学才算真正产生成效。
二、四步闭环自测法:无现成答案下的自我诊断
为了客观评估自身真实的编程掌控力,建议采用“四步闭环自测法”。该方法不依赖复杂的考试试卷,而是通过对具体编程动作的刻意约束,精准暴露知识盲区。
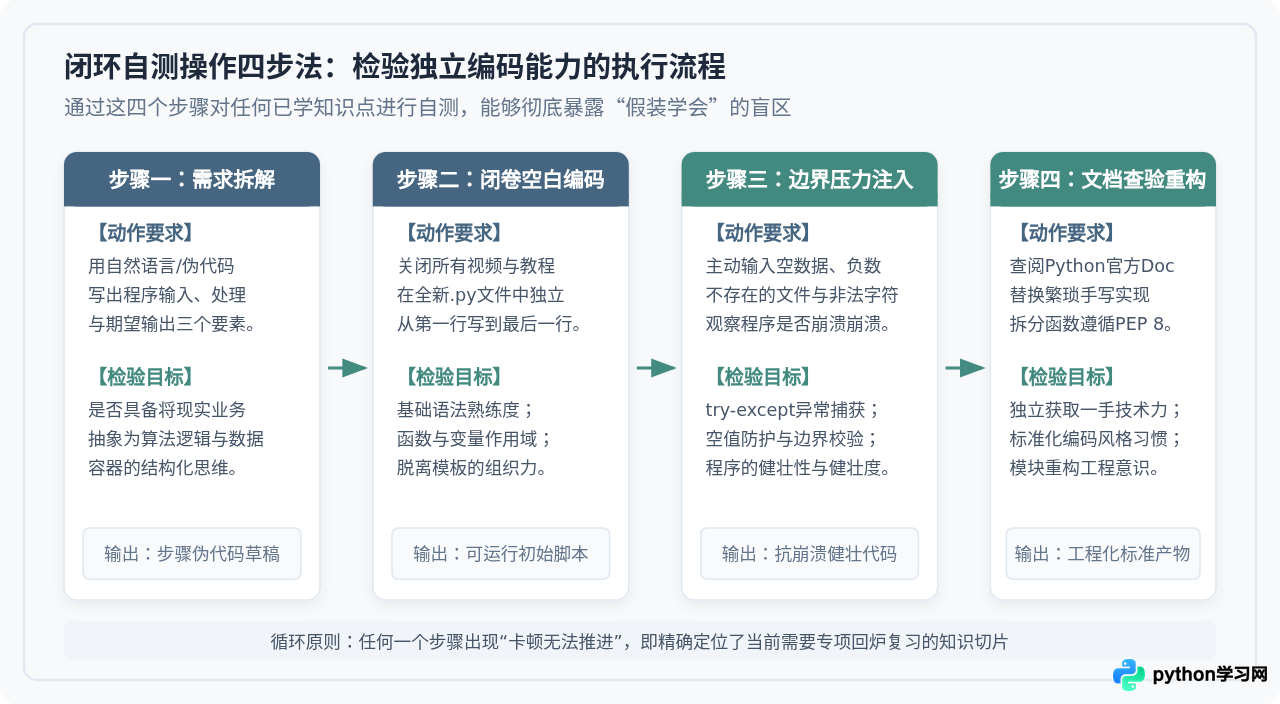
步骤一:需求拆解与流程草图(脱离代码的逻辑抽象)
选择一个现实小需求(例如“统计一段英文文本中出现频率最高的前5个单词”)。在动键盘写代码前,先拿出一张纸或打开文本编辑器,只用自然语言写出处理逻辑:
- 输入是什么?(一段包含标点、大小写的长字符串)
- 有哪些中间步骤?(转小写统一格式、正则或replace清洗标点符号、按空格切分为列表、使用字典或计数器统计频次)
- 输出形式是什么?(按频次倒序排列的元组列表)
如果这一步无法写出清晰的执行顺序,说明核心问题不在于Python语法遗忘,而在于对问题的逻辑拆解能力尚未建立。
步骤二:闭卷空白文件编码(闭门造车式验证)
关闭浏览器中的教程标签页,新建一个空白的 test_word_count.py。完全依靠记忆与逻辑,从第一行模块导入写到最后。在此过程中,重点记录自己卡壳的位置:
- 是忘记了切分字符串的方法名(
split())? - 是不知道如何把字典按照键值排序(
sorted(d.items(), key=lambda x: x[1], reverse=True))? - 还是搞混了列表推导式的语法结构?
所有卡壳的点就是你的第一手真实薄弱项,这比盲目刷几十道选择题要精准得多。
步骤三:主动注入边界压力(检验健壮性)
代码初步运行成功并不代表检验合格。此时必须扮演“刁钻用户”,向程序注入各种非预期输入:
- 传入空字符串
"",程序是否会抛出IndexError? - 文本全是由逗号、空格组成,统计是否会出现空键?
- 如果改为读取本地文件,当指定路径不存在时,是否直接崩溃暴露原生回溯栈?
合格的自学者必须掌握 try-except 与参数前置校验,能给出友好的错误提示而非让程序粗暴中断。
步骤四:官方文档查验与重构(检验自驱进阶力)
在完成初始实现后,打开 Python 官方文档(如 docs.python.org),查阅标准库是否有更优雅的现成解决方案。例如针对上述单词统计,标准库的 collections.Counter 可以将十几行逻辑浓缩为极其清晰的数行:
from collections import Counter
import re

def get_top_words(text: str, top_n: int = 5) -> list[tuple[str, int]]:
    # 清洗标点并统一转小写
    words = re.findall(r'[a-zA-Z]+', text.lower())
    return Counter(words).most_common(top_n)

# 示例调用
if __name__ == "__main__":
    sample_text = "Python is powerful, and Python is easy to learn. Python standard library is rich."
    print("统计结果示例:", get_top_words(sample_text, top_n=3))
对比手写版本与官方标准库实现,不仅能加深对底层数据结构的理解,更是建立查阅官方一手文档习惯的关键转折。
三、实战小项目推荐:由浅入深的4个阶段自测题
小项目是检验Python自学综合能力的试金石。挑选自测项目时,应避免直接使用现成教学模板泛滥的爬虫demo或博客系统,而应选择覆盖不同系统维度的实用工具。以下推荐4个层次分明的实战项目:
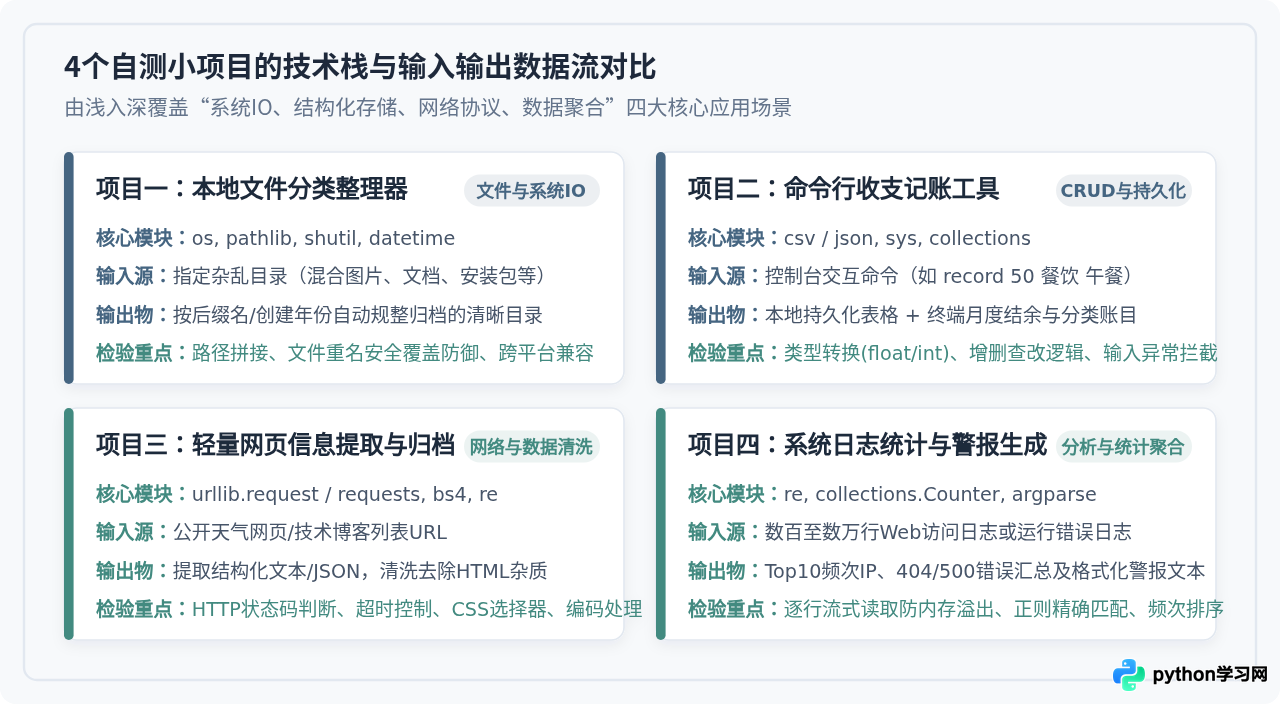
项目一:本地文件按类型批量整理器(系统IO与路径操作)
项目目标:编写一个命令行脚本,扫描用户指定的“下载”或“桌面”混乱目录,根据文件后缀名(如 .jpg/.png 归入 Images,.pdf/.docx 归入 Documents,.zip/.dmg 归入 Archives)自动创建子文件夹并移动归类;同时记录一份移动日志。
核心考核点:
os与pathlib.Path的路径遍历与目录创建;shutil.move文件移动与同名冲突处理(防止直接覆盖用户同名文件);- 字典映射关系的建立与后缀名小写化规范。
from pathlib import Path
import shutil

EXTENSION_MAP = {
    "Images": [".jpg", ".jpeg", ".png", ".gif"],
    "Documents": [".pdf", ".docx", ".txt", ".xlsx"],
    "Archives": [".zip", ".tar", ".gz"]
}

def organize_directory(target_path: str):
    base_dir = Path(target_path)
    if not base_dir.exists() or not base_dir.is_dir():
        print(f"错误:指定路径 {target_path} 不存在或不是文件夹。")
        return

    for item in base_dir.iterdir():
        if item.is_file():
            suffix = item.suffix.lower()
            target_category = "Others"
            for category, extensions in EXTENSION_MAP.items():
                if suffix in extensions:
                    target_category = category
                    break

            dest_folder = base_dir / target_category
            dest_folder.mkdir(exist_ok=True)

            dest_file = dest_folder / item.name
            # 安全防护:避免同名文件直接被覆盖
            if dest_file.exists():
                dest_file = dest_folder / f"{item.stem}_dup{item.suffix}"

            shutil.move(str(item), str(dest_file))
            print(f"已移动: {item.name} -> {target_category}/")

if __name__ == "__main__":
    # 示例用法:传入一个待整理的实际测试路径
    # organize_directory("./test_downloads")
    pass
项目二:命令行个人收支记账工具(数据结构、CSV与CRUD持久化)
项目目标:实现一个支持用户在终端交互式增删查改的记账程序。包含功能:添加一条收支记录(日期、类型、金额、备注)、按月度汇总总收入总支出、以CSV格式持久化保存并在启动时自动加载。
核心考核点:
- 使用内置
csv模块读写结构化表格文件; - 用户输入数字类型的类型安全转换与校验(防止输入 abc 导致
ValueError); - 列表与字典嵌套结构的数据过滤与聚合求和。
项目三:轻量网页信息提取与自动化归档(HTTP协议与数据清洗)
项目目标:编写程序请求指定公开技术资讯页面或天气公开页面,提取文章标题、发布时间和文章链接,过滤其中的HTML标签和多余空白字符,最终格式化输出为 JSON 文件。
核心考核点:
requests或内置urllib.request的网络请求与响应状态码(200、404、500)判断;- 请求头
User-Agent设置及网络超时的处理机制(timeout参数); - 基于
BeautifulSoup或正则对DOM树的CSS选择器精确定位。
项目四:Web访问日志分析与异常报警生成器(流式IO与统计分析)
项目目标:面对一个包含数万行Nginx或Apache标准格式的访问日志文件,脚本能逐行流式读取,统计出:访问频次Top 10的IP地址、404与500状态码占比,并将分析结果输出为一份排版整洁的文本日报。
核心考核点:
- 避免使用
readlines()一次性把大文件加载入内存,必须使用迭代器逐行处理; - 使用正则表达式
re精准捕获 IP、时间戳、状态码等字段; collections.Counter的高频统计与百分比计算。
四、代码质量验收清单:自测完成度评分
能够把代码跑通,只是完成了自学的及格线。在软件工程中,可读性、防御性和模块化程度决定了代码是“玩具脚本”还是“可用工程”。完成上述任一项目后,请对照以下四维度验收清单进行自查:
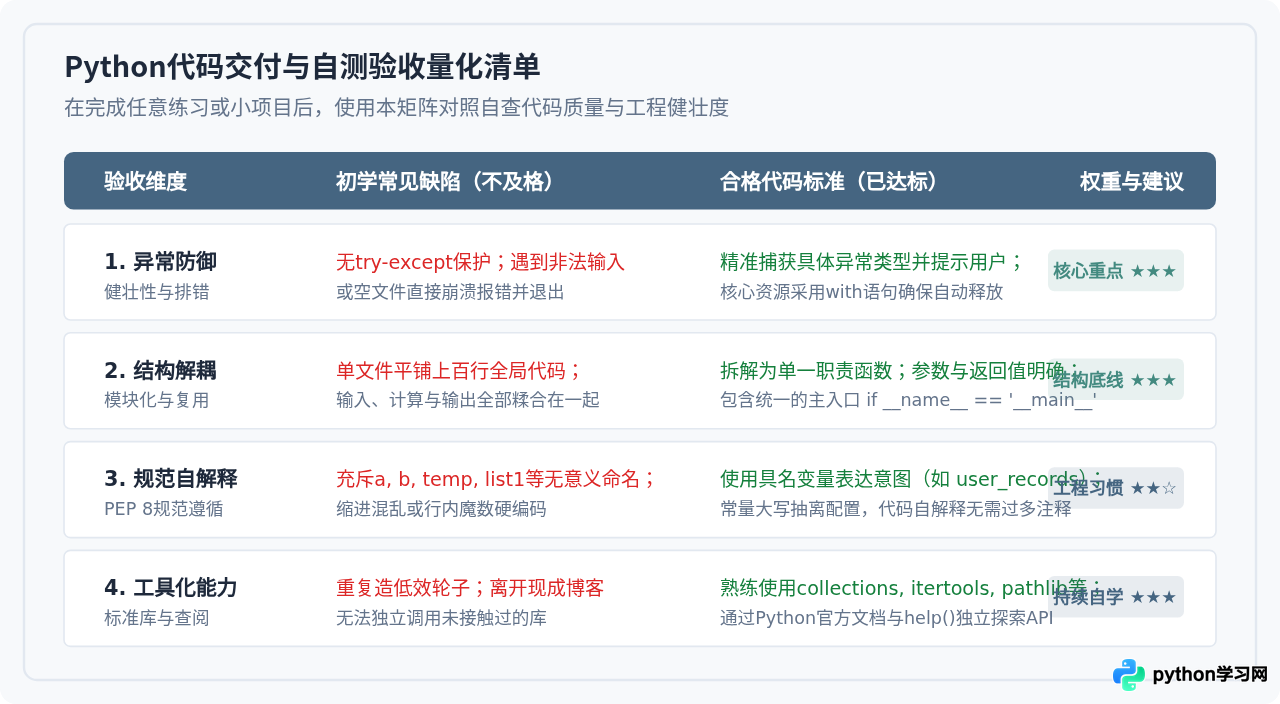
1. 无全局裸露执行:所有功能必须封装进函数,顶层仅保留配置常量与
if __name__ == '__main__': 入口。
2. 资源必带上下文管理:所有涉及文件打开的操作均使用
with open(...) as f:,杜绝手动 open 后因异常导致未 close 的句柄泄漏。
3. 变量名具有自解释性:不出现单独的
i, j, list1, data, temp,使用 unprocessed_records、monthly_summary 等清晰名词。
不要在自测初期过早引入重型第三方框架。如果一个初学者连 Python 内置的
dict, list, set 特性及 pathlib 都不能熟练运用,直接使用 Pandas 或 Web 框架只会用框架的高级封装掩盖基础能力的薄弱。先把标准库用熟,才是自学效果最扎实的证明。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









