

Python自动化脚本怎么写更稳定:异常处理与日志记录技巧
深入讲解如何通过规范的异常处理(精细捕获、指数退避重试、资源安全释放)与工业级日志记录(logging模块、双通道分级、轮转机制、堆栈追踪),构建无人值守也能高稳定运行的Python自动化脚本。
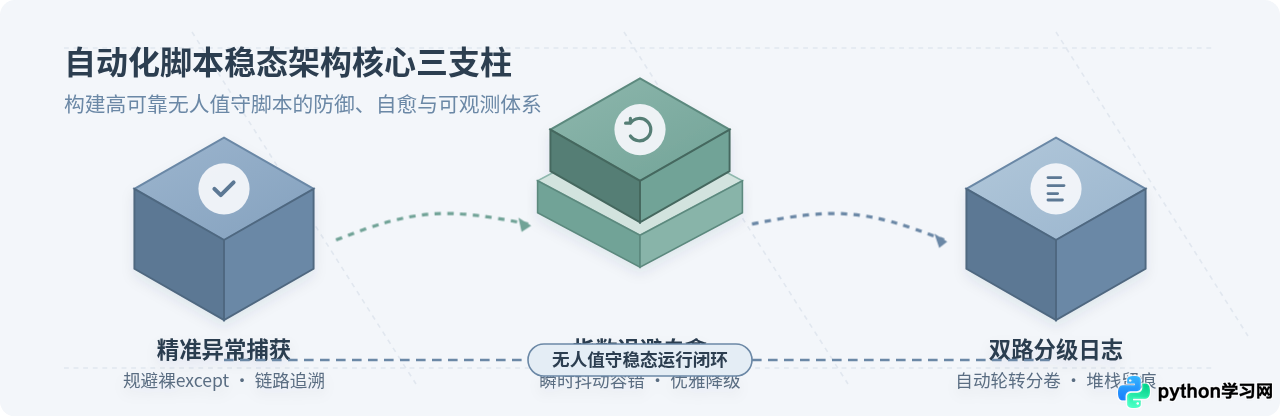
自动化脚本在长时间无人值守运行时,最容易遇到的故障不是核心业务代码本身的语法缺陷,而是不可控的外部环境波动——例如瞬时网络超时、第三方接口临时限流、文件读写锁冲突或返回数据结构突变。提升自动化脚本稳定性的核心,不是奢求写出“永远不发生错误”的绝对代码,而是建立两道坚固的防御纵深:一道是弹性的异常防御体系,通过精确捕获、指数退避重试与无条件资源闭环,吸收瞬时故障并保障链路安全;另一道是可追溯的标准化日志系统,通过规范分级、多通道分流、自动文件轮转与完整堆栈保存,让任何偶发故障都能被准确定位和复盘。
一、异常处理进阶技巧:从“粗暴捕获”到“弹性自愈”
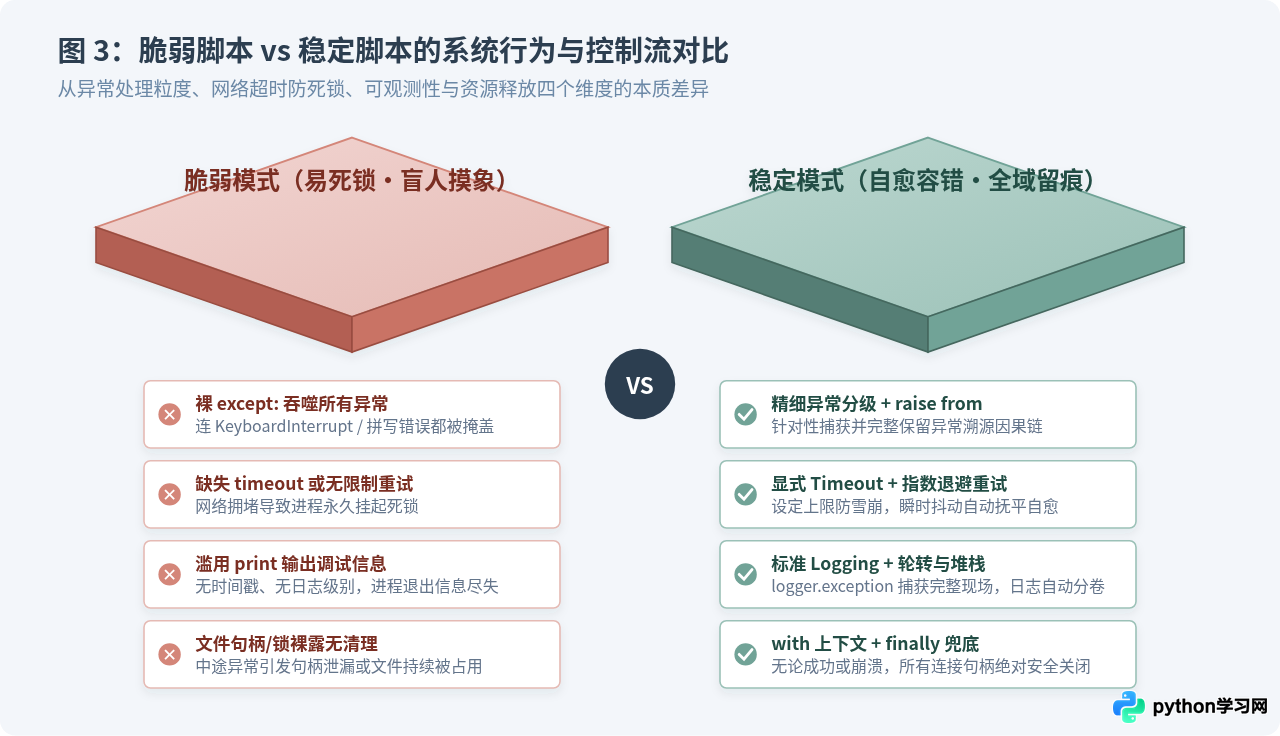
许多初学者编写脚本时,习惯于使用裸 except: 或者盲目使用 except Exception: 把整段代码包裹起来。这种做法看似让程序“不再报错退出”,实则是将自动化脚本推向了极其危险的失控边缘。
1. 坚决规避裸 except,实行精准异常捕获
在 Python 中,直接使用不带类型的 except: 会拦截所有继承自 BaseException 的对象,包括用于响应终端中断信号的 KeyboardInterrupt 和系统退出信号 SystemExit。这会导致脚本一旦运行,在控制台通过 Ctrl + C 根本无法正常终止进程,只能强行杀进程。即便使用 except Exception:,也会把代码中的变量名拼写错误(NameError)、属性不存在(AttributeError)或逻辑错误悄无声息地吞掉,将原本容易修复的代码缺陷转变成难以排查的暗病。
高稳定性的做法是:只捕获当前代码块可能触发且你有能力处理的特定异常。例如,针对网络请求只捕获 requests.exceptions.RequestException(及其细分子类 ConnectTimeout、HTTPError);针对文件操作只捕获 FileNotFoundError 或 PermissionError;针对接口响应解析只捕获 json.JSONDecodeError 或 KeyError。
# 脆弱的反例:吞掉所有未知错误,掩盖根本原因
try:
    response = requests.get(api_url)
    data = response.json()
    save_to_database(data["items"])
except:
    print("出错了!")  # 即使 save_to_database 函数拼写错误,也无法得知

# 稳健的正例:针对各环节分层精确捕获
try:
    response = requests.get(api_url, timeout=(3.05, 10))
    response.raise_for_status()
    data = response.json()
except (requests.exceptions.ConnectTimeout, requests.exceptions.ReadTimeout) as err:
    logger.warning("请求接口超时,准备进入重试流程: %s", err)
except requests.exceptions.HTTPError as err:
    logger.error("接口返回 HTTP 错误状态码: %s", err)
    raise
except (json.JSONDecodeError, KeyError) as err:
    logger.error("响应数据格式解析失败,字段可能变更: %s", err)
    raise
2. 使用 raise ... from err 保留原始异常链
在模块化脚本中,底层函数经常需要向外层抛出统一定义的业务异常(例如 DataFetchError 或 SyncJobFailed)。如果在捕获底层异常后直接抛出新异常,原有的上下文堆栈就会被切断,排查时无法查清最初是哪一行 socket 连接超时的。利用 Python 3 的 from err 语法,能够将新异常与根因异常串联成完整的因果调用链:
class DataSyncError(Exception):
    """数据同步业务自定义异常"""
    pass

try:
    cursor.execute("SELECT * FROM remote_orders WHERE status = 'pending'")
except sqlite3.OperationalError as err:
    # 明确保留原始 sqlite3 错误调用栈
    raise DataSyncError("远程订单查询操作失败,数据库可能处于锁定状态") from err
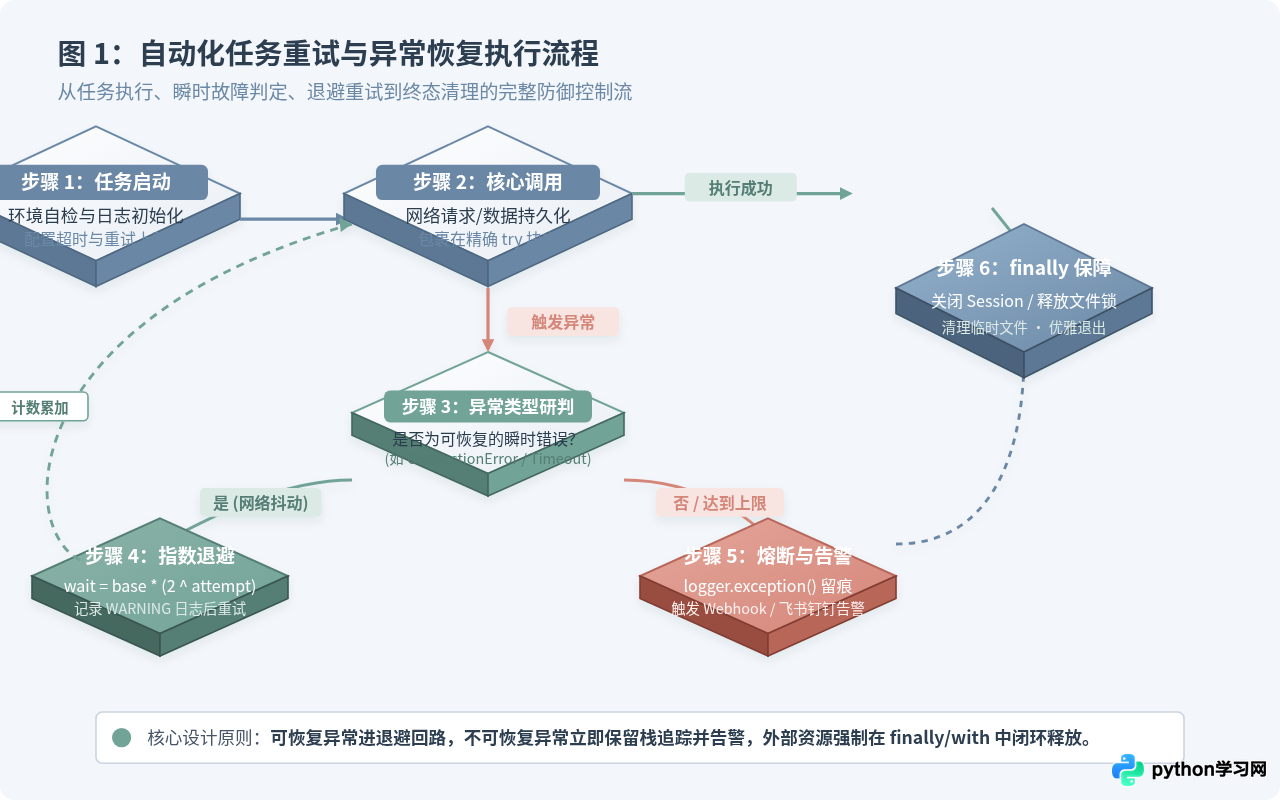
3. 应对瞬时波动的指数退避重试(Exponential Backoff)
网络拥堵、连接重置或接口限流(HTTP 429)往往是暂时性的。如果遇到错误立刻原样发起重试,大概率会连续失败,甚至对下游服务器造成冲击。指数退避策略通过让每次重试的等待时间按指数级递增,配合轻微随机扰动(Jitter),能有效规避高并发重试造成的踩踏。
每次重试等待时间的计算公式为:
\( T_{wait} = \min(T_{max}, T_{base} imes 2^{attempt} + ext{uniform}(0, 1)) \)
4. 利用 with 与 finally 实现资源绝对安全闭环
自动化脚本需要长时间持续运行,最常见的暗病是连接泄露和文件句柄泄露。脚本在执行过程中抛出未预期的异常时,如果底层未执行 close(),连接池会被逐渐耗尽,最终引发后续任务全部堵死。只要涉及网络会话(Session)、数据库连接、文件操作或临时锁,一律使用上下文管理器(with 语句)或置于 finally 块中清理。
# 确保无论网络或处理是否报错,Session 均会被正确释放
with requests.Session() as session:
    session.mount("https://", requests.adapters.HTTPAdapter(max_retries=3))
    try:
        resp = session.get("https://api.example.com/data", timeout=5)
        resp.raise_for_status()
    finally:
        # 此处可以处理临时中间文件清理或状态解锁
        clean_up_temporary_files()
二、日志记录的最佳实践:建立无人值守的可观测性
在本地终端开发时,print 足够直观;但在服务器后台或定时任务(如 Linux Crontab、Systemd Timer 或 Windows 任务计划程序)中,print 的弊端暴露无遗:它既没有时间戳,也没有告警分级,一旦进程退出,控制台输出很难被持久化追溯。
1. 为什么必须使用标准 logging 模块
Python 内置的 logging 模块提供了生产级所需的核心要素:
- 时间与上下文信息:每条日志自动附带精确到毫秒的 ISO 时间戳、模块文件名、函数名以及进程/线程 ID。
- 分流路由机制:可以同时配置多个处理器(Handler),例如一条日志产生后,控制台只显示关键进度,而磁盘文件记录完整的调试参数。
- 全生命周期无侵入切换:通过调整全局日志级别,无需改动一行业务代码,即可在排查问题时开启调试输出,常态运行时恢复精简输出。
2. 规范五级日志的使用分工
| 日志级别 | 严重度数值 | 适用业务场景 | 典型记录内容示例 |
|---|---|---|---|
DEBUG |
10 | 内部调试变量、请求原始报文、算法各分支进入标记 | HTTP GET /api/v1 耗时 124ms, 响应长度 4096 字节 |
INFO |
20 | 任务生命周期里程碑、批次完成进度、关键统计数据 | 批次 #1042 同步完成,处理记录 500 条,成功 500 条 |
WARNING |
30 | 非预期但已自愈的事件、触发重试、配置项缺失采用默认值 | 远程服务连接超时,已触发第 2 次指数退避重试 (等待 4.2s) |
ERROR |
40 | 单项任务执行失败,导致该条目被跳过,但整体流程未中断 | 记录 ID 8891 字段缺失校验失败,已跳过并进入死信队列 |
CRITICAL |
50 | 致命性破坏,导致整个脚本无法继续运行,需立即人工介入 | 数据库磁盘空间已耗尽或鉴权凭据完全失效,主进程退出 |
3. 配置 RotatingFileHandler 彻底防范磁盘被撑爆
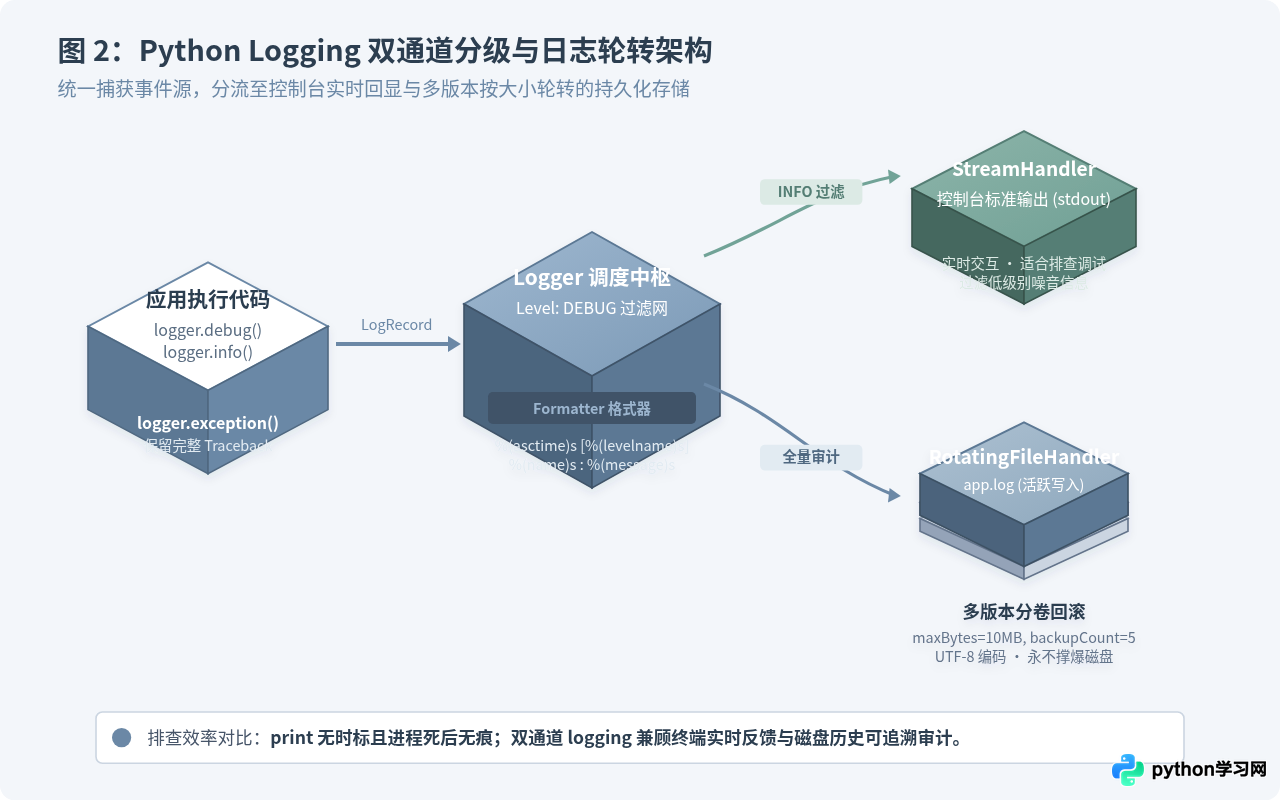
很多开发者直接使用 logging.basicConfig(filename='run.log'),由于缺乏日志切割机制,在无人值守数周后,该文件可能膨胀至几十吉字节(GB),不仅耗尽磁盘空间,还会导致排查问题时无法打开文本编辑器。推荐使用 RotatingFileHandler(按文件体积轮转)或 TimedRotatingFileHandler(按天轮转),并且显式设置 encoding="utf-8" 避免跨操作系统出现乱码。
4. 捕获完整异常现场:使用 logger.exception
很多代码在捕获异常时写 logger.error(f"失败: {err}"),这样输出的日志仅仅包含异常名称字符串(如 'NoneType' object has no attribute 'get'),却彻底丢掉了产生该异常的文件名、函数与行号。在 except 块中,应当直接调用 logger.exception(...),或者显式指定 logger.error(..., exc_info=True)。日志模块会自动抓取 sys.exc_info(),将完整的 Traceback 调用栈写入文件。
三、实战范式:高可靠自动化采集脚本生产模板
下面是一个经过工业场景检验的完整 Python 自动化脚本范本,融合了双通道轮转日志配置、带抖动的指数退避重试装饰器以及精准异常分层处理:
#!/usr/bin/env python3
# -*- coding: utf-8 -*-
"""
高可靠性数据自动化同步采集脚本标准工程模板
"""
import sys
import os
import time
import random
import logging
from logging.handlers import RotatingFileHandler
import requests

def setup_logger(log_file_path: str = "automation_runner.log") -> logging.Logger:
    """初始化双通道分级与轮转日志记录器"""
    logger = logging.getLogger("TaskWorker")
    logger.setLevel(logging.DEBUG)  # 根收集器设为 DEBUG,由各 Handler 分流过滤

    # 避免重复添加 Handler
    if logger.handlers:
        return logger

    # 统一格式化模板:时间 [级别] [文件名:行号] - 消息
    formatter = logging.Formatter(
        fmt="%(asctime)s [%(levelname)s] [%(filename)s:%(lineno)d] - %(message)s",
        datefmt="%Y-%m-%d %H:%M:%S"
    )

    # 1. 控制台输出 Handler(仅显示 INFO 及以上级别)
    console_handler = logging.StreamHandler(sys.stdout)
    console_handler.setLevel(logging.INFO)
    console_handler.setFormatter(formatter)
    logger.addHandler(console_handler)

    # 2. 磁盘文件持久化轮转 Handler(单文件最大 5MB,保留 5 份历史归档,UTF-8)
    file_handler = RotatingFileHandler(
        filename=log_file_path,
        maxBytes=5 * 1024 * 1024,
        backupCount=5,
        encoding="utf-8"
    )
    file_handler.setLevel(logging.DEBUG)
    file_handler.setFormatter(formatter)
    logger.addHandler(file_handler)

    return logger

logger = setup_logger()

def retry_with_backoff(max_retries: int = 3, base_delay: float = 1.0, max_delay: float = 10.0):
    """
    通用指数退避重试装饰器
    :param max_retries: 最大重试次数
    :param base_delay: 基础退避时间基数(秒)
    :param max_delay: 退避上限封顶时间(秒)
    """
    def decorator(func):
        def wrapper(*args, **kwargs):
            attempt = 0
            while attempt < max_retries:
                try:
                    return func(*args, **kwargs)
                except (requests.exceptions.ConnectionError,
                        requests.exceptions.Timeout) as err:
                    attempt += 1
                    if attempt >= max_retries:
                        logger.error("操作 [%s] 已达最大重试上限 (%d 次),宣告失败", func.__name__, max_retries)
                        raise
                    # 指数退避 + 随机抖动 Jitter
                    delay = min(max_delay, base_delay * (2 ** (attempt - 1)) + random.uniform(0.1, 0.5))
                    logger.warning("操作 [%s] 遭遇瞬时错误 [%s],第 %d 次重试,将在 %.2f 秒后再次发起...",
                                   func.__name__, err.__class__.__name__, attempt, delay)
                    time.sleep(delay)
        return wrapper
    return decorator

@retry_with_backoff(max_retries=3, base_delay=1.5, max_delay=8.0)
def fetch_remote_dataset(session: requests.Session, url: str) -> dict:
    """拉取远程数据接口,配置显式网络超时"""
    logger.debug("开始请求接口: %s", url)
    # (连接超时 3.05 秒,读取数据超时 15 秒)
    response = session.get(url, timeout=(3.05, 15))
    response.raise_for_status()
    return response.json()

def execute_automation_job():
    """主任务执行调度器"""
    logger.info("========== 自动化批处理任务启动 ==========")
    target_api = "https://httpbin.org/json"  # 示例公开数据源

    with requests.Session() as session:
        try:
            logger.info("正在执行第一阶段:拉取远端数据...")
            result = fetch_remote_dataset(session, target_api)
            logger.info("数据获取成功,开始校验数据完整性")

            # 数据结构安全校验,防御字段缺失
            slideshow = result.get("slideshow")
            if not slideshow or "title" not in slideshow:
                raise ValueError("接口返回 payload 中缺失核心字段 'slideshow.title'")

            logger.info("数据检验合格,标题内容: %s", slideshow["title"])
            logger.info("自动化批处理任务成功执行完毕")

        except ValueError as err:
            logger.error("数据结构格式校验未通过: %s", err)
            sys.exit(1)
        except requests.exceptions.HTTPError as err:
            logger.error("远程接口返回非 200 HTTP 状态码: %s", err)
            sys.exit(2)
        except requests.exceptions.RequestException:
            # 捕获最终仍未恢复的网络异常,记录完整调用栈
            logger.exception("网络通道彻底故障,已终止本次运行")
            sys.exit(3)
        except Exception:
            # 顶级兜底防御,记录不可预期的未知缺陷
            logger.exception("发生未预期的致命性系统错误")
            sys.exit(99)
        finally:
            logger.info("资源清理完毕,任务会话已安全退出")

if __name__ == "__main__":
execute_automation_job()2026-11-01 11:15:02 [INFO] [runner.py:72] - ========== 自动化批处理任务启动 ==========
2026-11-01 11:15:02 [INFO] [runner.py:77] - 正在执行第一阶段:拉取远端数据...
2026-11-01 11:15:02 [DEBUG] [runner.py:65] - 开始请求接口: https://httpbin.org/json
2026-11-01 11:15:03 [INFO] [runner.py:80] - 数据获取成功,开始校验数据完整性
2026-11-01 11:15:03 [INFO] [runner.py:87] - 数据检验合格,标题内容: Sample Slide Show
2026-11-01 11:15:03 [INFO] [runner.py:88] - 自动化批处理任务成功执行完毕
2026-11-01 11:15:03 [INFO] [runner.py:104] - 资源清理完毕,任务会话已安全退出四、生产环境防御性部署核对清单(Checklist)
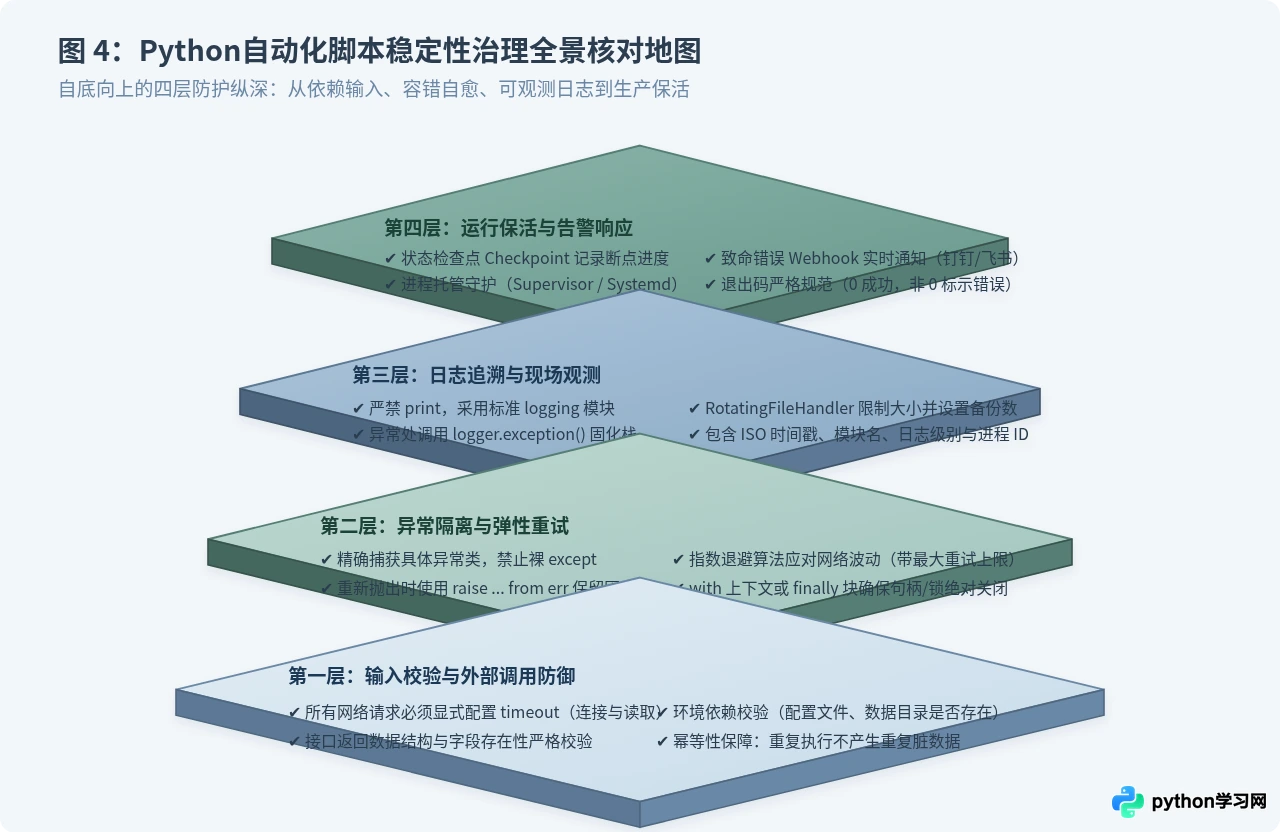
为了确保脚本在脱离人工监督的环境中持续健壮运行,在交付部署前,建议逐一核对以下四项核心安全要求:
- 所有网络与外部调用必须显式声明 Timeout:Python 的
requests库如果不带timeout参数,默认行为是永久等待。在网络遭遇丢包或中间代理卡死时,进程将在套接字读取处无限挂起。推荐设置双元组超时timeout=(3.05, 20),分别限制 TCP 握手耗时与数据包间隔耗时。 - 任务具备幂等性与检查点(Checkpoint):批量处理任务(如遍历 10000 个文件)如果运行到第 9000 个时崩溃,重新启动时不应从头再来。在本地维护一个轻量 SQLite 或进度文件(记录最后处理的
last_processed_id),并在重新拉起时跳过已完成项。 - 致命错误接入自动化通知 Webhook:当发生
CRITICAL级别故障或捕获到未处理的顶级异常退出时,脚本应当能够异步调用企业微信、钉钉或飞书的群机器人 Webhook,向维护人员第一时间发送故障卡片,变“被动发现”为“主动告警”。 - 进程退出码与托管进程联动:脚本顺利完成应当以
sys.exit(0)退出,异常退出则明确返回非零退出码(如sys.exit(1))。这样外部托管工具(如 Linux 的 Systemd、Docker 容器或 Crontab 监控脚本)能准确感知失败并触发相应的重启或告警逻辑。
五、结语
编写高可靠的 Python 自动化脚本,不是依靠“不出错”的侥幸,而是依靠对各种异常可能性的敬畏与防御。通过用精确分类的捕获替代盲目的裸 except,引入指数退避机制抚平外部瞬时抖动,借助 with 和 finally 彻底封堵资源泄漏漏洞;同时配置双通道分级与自动轮转的日志体系,在关键错误处完整保留 Traceback 调用链,就能让自动化脚本在无人值守的生产环境中真正做到坚韧自愈、稳如磐石。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









