

Python手动实现二分查找的常见陷阱:边界条件与死循环处理
深入解析在Python中手动实现二分查找算法时的常见陷阱,重点剖析闭区间与半开区间定义、循环终止条件、整除向下取整引发死循环的机理,并提供标准防坑实现与自查清单。
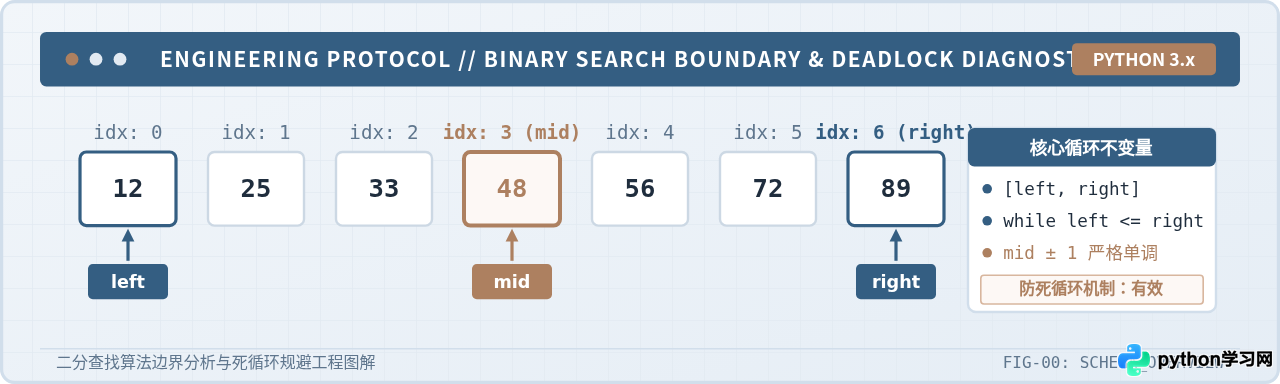
手动用 Python 编写二分查找时,最让程序员抓狂的问题往往不是算法的对半切分思想,而是细微边界条件处理失误导致的死循环(CPU 100% 卡死)或单元素漏判。二分查找的代码骨架非常轻量,但其正确性高度依赖于循环不变量(Loop Invariant)在整个迭代过程中的严格自洽。本文直击手动实现二分查找中最常出现的四个陷阱:区间定义与循环条件的脱节、整除向下取整引发的区间原地踏步、边界收缩时的越界错位、以及搜索目标不存在时的返回值错乱。通过具体的推演过程、死循环代码复现与两套标准模板,帮助你在手写二分算法时做到零失误。
一、陷阱根源:区间定义与循环条件的逻辑不自洽
绝大多数初学者或经验不足的开发者写出死循环或越界错误,本质上是因为在下笔写代码之前,没有在脑海中确立清晰的“搜索区间语义”。一旦搜索区间的定义出现模糊,循环条件的设置就会产生逻辑脱节。
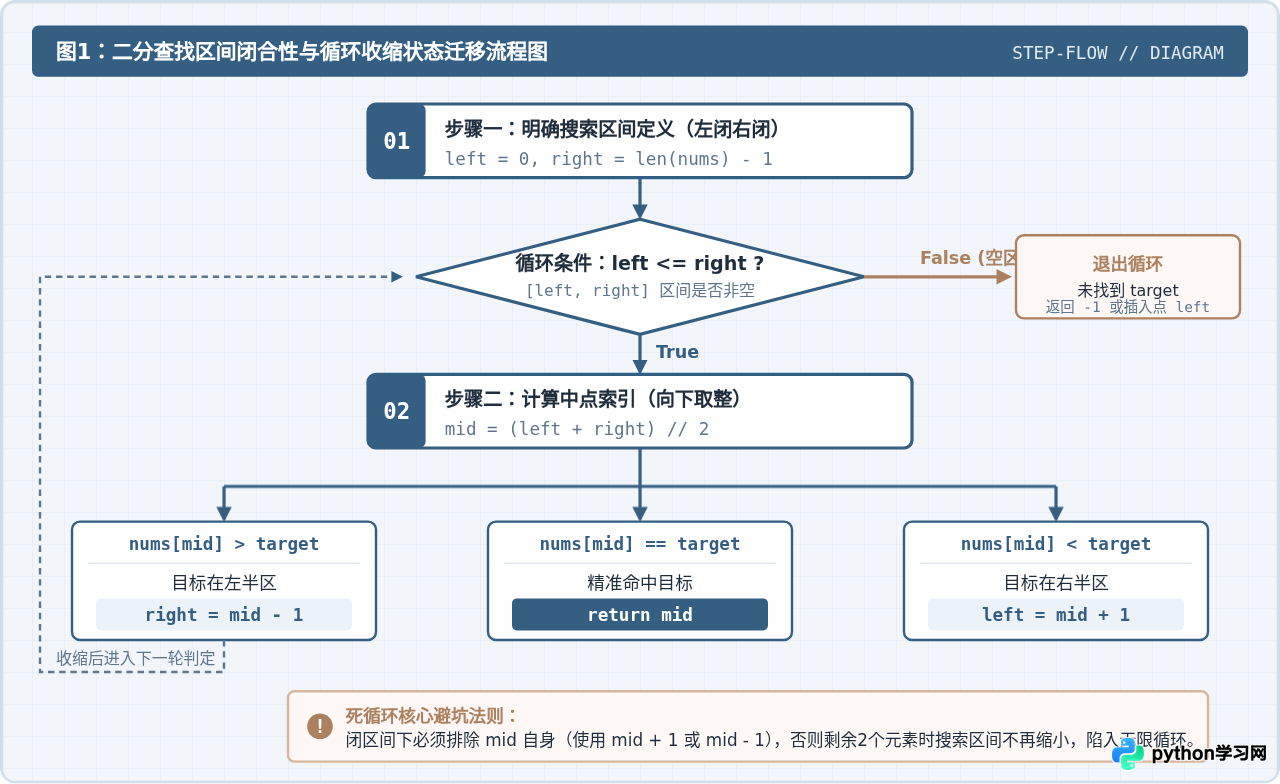
在二分查找中,最主流且不易出错的是左闭右闭区间 [left, right]。所谓左闭右闭,指的是待查找的目标元素可能存在于从索引 left 到索引 right(包含两端点)的连续切片中。
1. 为什么是 while left <= right 而不是 while left < right?
当我们将区间定义为左闭右闭 [left, right] 时,如果 left == right,这个区间内依然包含一个有效元素(即 [left, left] 并非空集)。因此,算法必须进入循环体对 nums[left] 进行最后的相等性判定。
如果错误地写成 while left < right,那么当搜索空间缩减到只剩最后 1 个元素时,循环会直接跳出,导致这最后一个关键元素根本没有被比较过就被遗漏。
2. 初始边界的定义约束
既然定义了右侧也是闭区间,那么数组的最右端合法索引就是 len(nums) - 1。如果误写为 right = len(nums),在执行 nums[right] 或 mid = (left + right) // 2 时就有可能在边界条件下直接触发 Python 的 IndexError: list index out of range 异常。
二、致命死循环:Python整除特性与 left = mid 陷阱
死循环是手动实现二分查找中最隐蔽的致命 Bug。在 Python 中,双斜杠整除运算符 // 采用的是向下取整(向负无穷方向取整)的数学规则。正是这个向下取整的特性,与错误的分支收缩逻辑结合,构成了死循环的完美风暴。
1. 双元素相邻时的整除偏向性
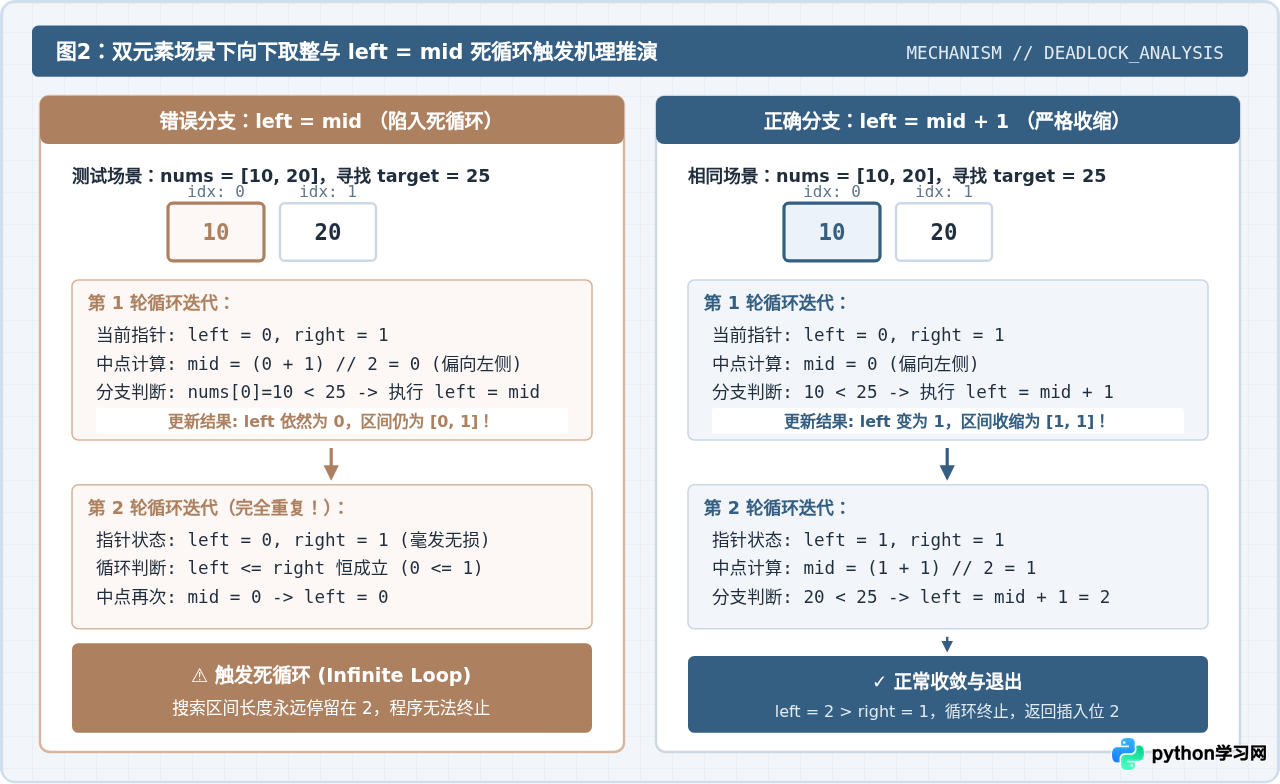
设想搜索空间缩减到了极限情况:当前区间只剩下 2 个相邻元素,例如 left = 0, right = 1。
此时计算中点:
mid = (0 + 1) // 2 = 1 // 2 = 0。
可以看到,在只剩 2 个元素时,mid 的值始终精确等于 left!整除操作天然地将中点拉向了左边界。
2. 死循环代码现场复现与剖析
如果在比较之后,发现目标值位于右侧,有人可能会想:“既然 mid 不对,那我把左指针移过来,写 left = mid 吧。”
这一行 left = mid 会立即导致死锁:
- 当前状态:
left = 0, right = 1,计算得mid = 0。 - 目标在右半区,执行
left = mid,即将 0 赋值给left。 left的值依然是 0,right依然是 1!搜索区间[0, 1]的长度完全没有减少。- 进入下一轮
while left <= right,因为0 <= 1恒为真,循环再次执行,mid再次算得 0,left再次被赋为 0……循环陷入无休止的原地自旋,CPU 飙升到 100%。
# 错误示例:必然导致死循环的代码
def buggy_binary_search(nums, target):
    left = 0
    right = len(nums) - 1
    while left <= right:
        mid = (left + right) // 2
        if nums[mid] == target:
            return mid
        elif nums[mid] < target:
            left = mid  # ⚠️ 致命错误!当只剩2个元素时,mid==left,此处陷入死循环
        else:
            right = mid - 1
return -1left = mid,且计算公式采用向下取整 (left + right) // 2,那么只要搜索区间剩余相邻两个元素且触发该分支,程序必将 100% 陷入死循环。要打破该僵局,必须保证每一轮迭代后区间长度严格单调递减。
三、边界收缩偏差:为什么精准查找必须使用 mid ± 1
理解了死循环的触发机理,我们就能彻底想通为什么在精准匹配的二分查找中,边界更新必须毫不犹豫地写成 left = mid + 1 和 right = mid - 1。
其原因有双重保障:
- 逻辑排除性:进入收缩分支的前提是
nums[mid] != target。既然已经确认索引mid处的数值不是我们要找的元素,那么在下一步的候选范围中,就没有任何理由继续包含mid。将其从新区间中剔除(左边界跳到mid + 1,右边界缩到mid - 1)在逻辑上是完全正确的。 - 收缩严格性:无论是加 1 还是减 1,都强行打破了中点偏向性带来的停滞可能。每执行一次分支,区间两端的跨度至少缩减 1 个单元。当只剩 2 个元素(
left=0, right=1, mid=0)时,执行left = 0 + 1 = 1,区间瞬间变成只有 1 个元素的[1, 1],随后在下一轮迭代中顺利跳出或命中。
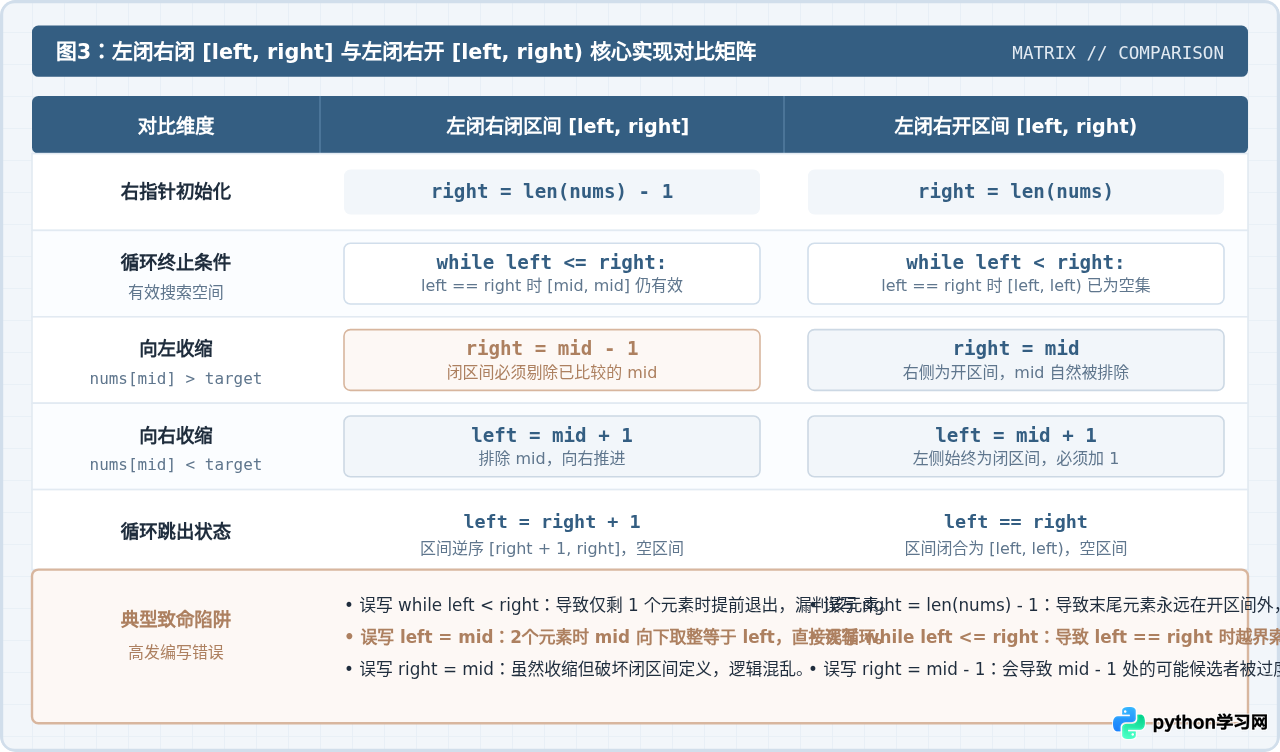
针对左闭右闭与左闭右开两种范式,我们可以通过以下对照表进行直观核对:
| 机制维度 | 左闭右闭 [left, right] |
左闭右开 [left, right) |
|---|---|---|
| 初始右指针 | right = len(nums) - 1 |
right = len(nums) |
| 循环继续条件 | while left <= right: |
while left < right: |
| 向右收缩分支 | left = mid + 1 |
left = mid + 1 |
| 向左收缩分支 | right = mid - 1 |
right = mid(因为右侧是开的,自动排除了 mid) |
| 循环退出状态 | left = right + 1(空区间) |
left == right(空区间) |
四、目标不存在与重复元素:左右边界查找的指针落点
在很多工程实战与算法题中,数组往往包含重复数据,需求也从“找到任意一个等于 target 的元素”变成了“寻找最左侧出现的边界索引(Lower Bound)”或“寻找最右侧出现的边界索引(Upper Bound)”。这种场景下,若处理不当,极易再次掉入边界死循环的陷阱。
1. 寻找最左边界(左侧插入位置)的标准闭区间实现
当我们要找重复元素的最左侧位置时,即使 nums[mid] == target,我们也不能直接返回,而是要继续收缩右边界以锁定更左侧的可能候选者,即令 right = mid - 1。
当循环以 left <= right 结束跳出时,left 指针恰好停留在首个大于或等于 target 的元素索引上。此时必须执行后置边界检查,防止 left 越界或该位置的元素并非 target。
def binary_search_left_bound(nums, target):
    """寻找 target 在有序数组中首次出现的索引;若不存在则返回 -1"""
    left = 0
    right = len(nums) - 1

    while left <= right:
        mid = (left + right) // 2
        if nums[mid] >= target:
            # 如果中点值大于等于目标,锁定目标在左侧或中点处,继续向左压缩
            right = mid - 1
        else:
            left = mid + 1

    # 循环跳出时,left 指向第一个 >= target 的位置
    # 必须检查越界以及值是否匹配
    if left >= len(nums) or nums[left] != target:
        return -1
    return left
2. 为什么向上取整能解决某些特殊场景的死循环?
有时候一些开发者偏向于在找到可能符合条件的值时保留当前中点,写出类似 left = mid 的分支。正如第二节所述,向下取整的 // 2 在 left = mid 时必死循环。
如果某种特殊业务逻辑确实需要保留 left = mid(例如在求最大化满足条件的数值时),那么中点计算公式就必须改为向上取整:
mid = (left + right + 1) // 2。
当双元素 left = 0, right = 1 时,向上取整得到 mid = (0 + 1 + 1) // 2 = 1。此时 mid 偏向了 right。执行 left = mid 会让 left 变成 1,区间成功收缩为 [1, 1],死循环便被解开了。但对于常规二分查找,最推崇的依然是 mid ± 1 范式,逻辑更加自然无歧义。
五、自查自纠:手写二分查找的防陷阱清单与标准实现
为了在实际编码过程中杜绝二分查找的所有低级陷阱,建议在写完代码后,参照以下 4 个检查点进行静态审查。
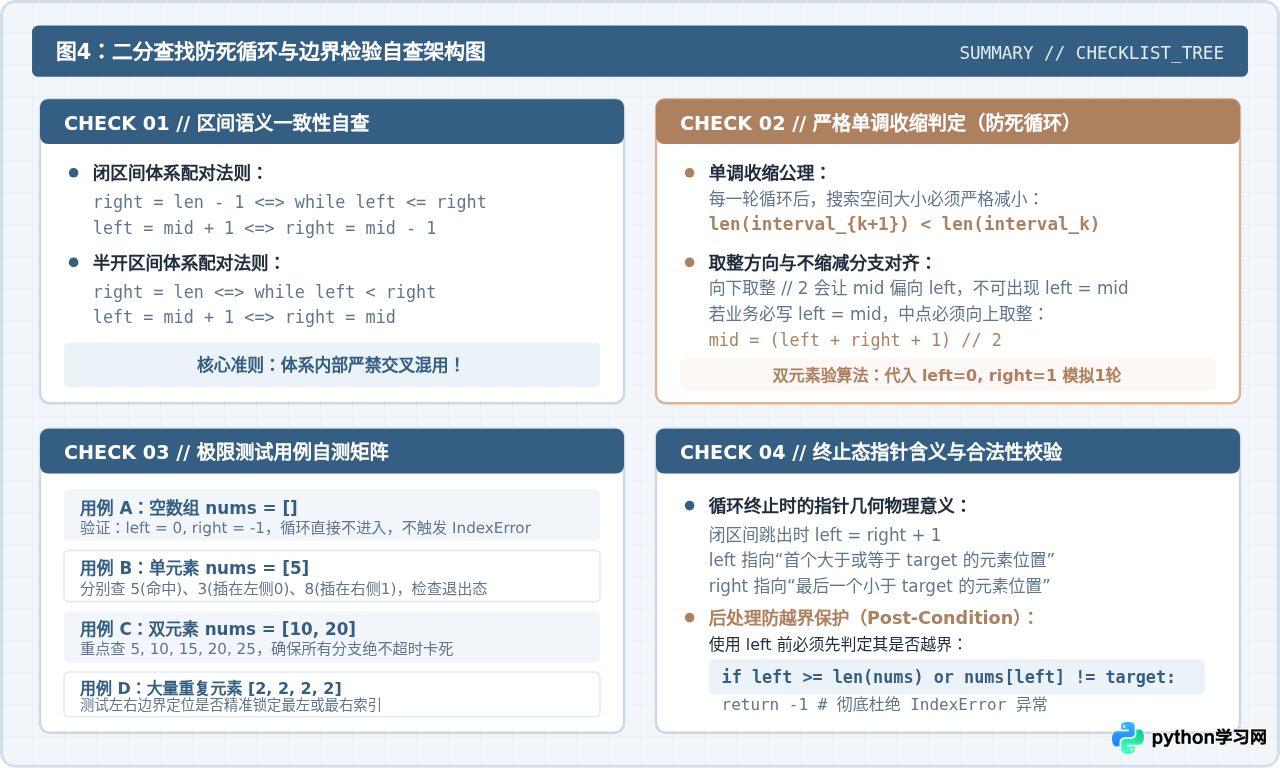
- 区间定义配对检查:初始
right = len(nums) - 1是否配对了while left <= right?如果初始用了len(nums),循环是否正确写为while left < right? - 单调缩减性检查:在循环体的所有
if / elif / else逻辑分支中,是否至少有一个指针发生了带有± 1的实质性位移?是否存在left = mid或right = mid与取整方向产生共振的死循环分支? - 双元素推演检查:手动拿 2 个相邻元素(例如
[10, 20],查找 25 和查找 5)在脑海中单步推演 1 轮,确认循环能否在有限步内正常退出。 - 后处理合法性检查:如果函数在循环外部使用
left或right访问数组元素,是否先行判断了0 <= left < len(nums)防止越界?
标准工业级精准二分查找实现(可直接使用)
下面给出经过严格验证的左闭右闭标准精准匹配二分查找 Python 实现,兼顾了区间自洽、死循环免疫以及空列表防护:
def binary_search(nums: list[int], target: int) -> int:
    """
    标准左闭右闭二分查找
    :param nums: 升序排列的整数列表
    :param target: 目标查找值
    :return: 目标值在列表中的索引,若不存在则返回 -1
    """
    # 边界保护:空列表直接返回 -1
    if not nums:
        return -1

    left = 0
    right = len(nums) - 1  # 定义搜索区间为 [left, right] 闭区间

    while left <= right:    # 当 left == right 时,[left, right] 依然有效
        # 计算中点:在 Python 中整数自带高精度不会溢出,但 // 2 具有向下取整特性
        mid = (left + right) // 2

        if nums[mid] == target:
            return mid      # 命中目标,立即返回索引
        elif nums[mid] < target:
            left = mid + 1  # 目标在右半区,严格排除 mid,防止死循环
        else:
            right = mid - 1 # 目标在左半区,严格排除 mid

    # 循环因 left > right 结束,说明区间已缩减为空集,目标不存在
    return -1
掌握二分查找的关键在于形成清晰的“区间模型”。只要时刻保持区间闭合性与循环条件的自洽,并严格执行让搜索区间单调缩减的 mid ± 1 策略,死循环和边界漏判将不再成为编程中的障碍。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









