

Python只能处理xlsx吗?兼容xls旧格式的操作库推荐
解答Python是否只能处理xlsx格式,深入分析xls与xlsx的技术区别,推荐并详解xlrd、xlwt、xlutils及pandas等兼容旧版xls格式的Python库与实战代码。
很多开发者在刚接触 Python 自动化办公时,往往首先接触到流行的 openpyxl 库。当尝试用它打开扩展名为 .xls 的旧版 Excel 表格时,程序会直接抛出 InvalidFileException 异常。这常让人产生一个疑问:Python 难道只能处理 .xlsx 格式吗?答案显然是否定的。Python 完全能够高效读写和修改 .xls 文件,只是因为这两种文件底层技术结构截然不同,需要匹配不同的专用工具库。
一、格式本质差异:为什么 openpyxl 无法直接打开 xls?
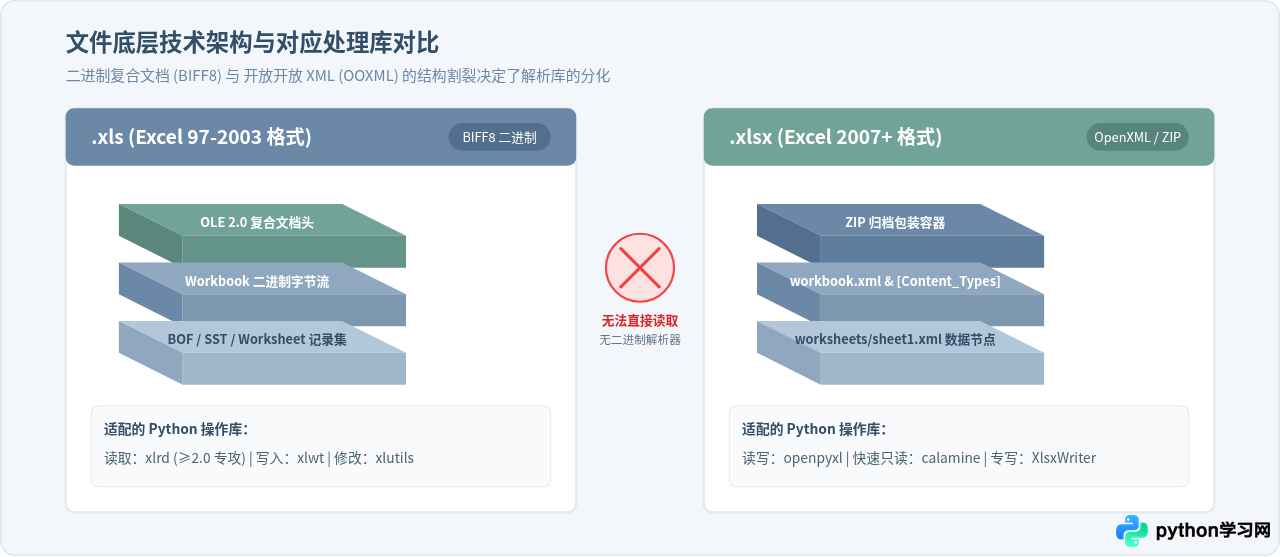
Excel 的 .xls 与 .xlsx 虽然都是电子表格,但在底层存储格式上属于完全不同的两代技术:
- .xls(Excel 97-2003):基于微软专有的二进制复合文档格式(BIFF,Binary Interchange File Format)。其数据以二进制字节流和分块记录(Record)的形式紧凑存储,解析时必须按字节偏移逐步解码。
- .xlsx(Excel 2007 及以后):基于开放标准的 Office Open XML(OOXML)。它本质上是一个标准的 ZIP 压缩包,解压后由一系列独立的 XML 文件、样式表及资源关系文件组成。
openpyxl 的底层设计是基于 ZIP 解压与 XML 树解析实现的,其代码库完全不包含 BIFF 二进制解析器。因此,强行用 openpyxl 加载 .xls 文件必然失败。面对旧版 .xls,我们应当选用针对 BIFF 协议设计的专属库。
二、兼容 xls 的主流 Python 操作库详解
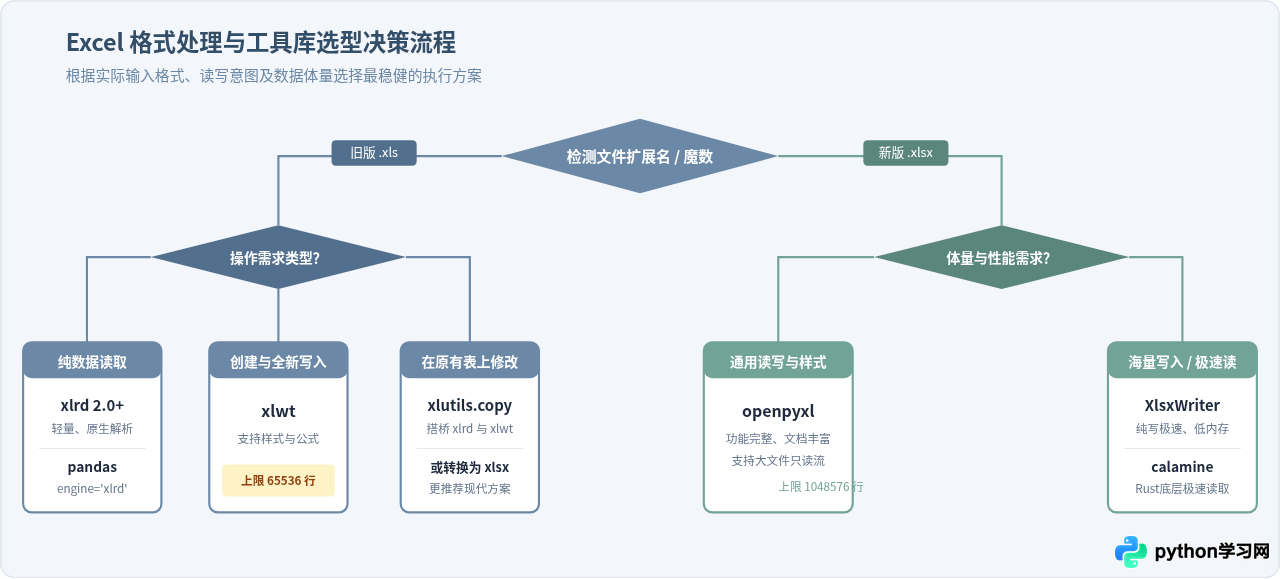
处理旧版 .xls 格式并不困难。Python 生态中有多个成熟稳定的专业库,它们分工明确,覆盖读取、写入与修改等不同场景。
1. xlrd:专注高效读取 xls
xlrd 是 Python 领域历史最悠久的 Excel 读取库之一。需要特别注意的是它的版本变迁:
- 在
1.2.0及更早版本中,xlrd同时支持.xls和.xlsx。 - 自
2.0.0版本起,为了降低维护复杂度并规避潜在安全问题,官方移除了对.xlsx的支持,将其定位纯粹收敛为专门读取.xls文件的专用库。
因此,对于现代项目,直接安装最新版本的 xlrd(如 pip install xlrd)即可稳定、高效地提取 .xls 中的数据,无需降级到老版本。
2. xlwt:专注创建与写入 xls
xlwt 是与 xlrd 配对的写入库,专门用于生成标准的 .xls 二进制文件。它支持设置单元格字体、边框、背景色、对齐方式以及基础公式计算。使用 xlwt 需要牢记旧版格式的物理边界:
- 单张工作表的最大行数为 65,536 行(216)。
- 单张工作表的最大列数为 256 列(28)。
- 单个单元格字符串最大长度为 32,767 个字符。
如果数据量超过 65,536 行,xlwt 会抛出 ValueError。此时应考虑分表写入或直接转为 .xlsx 格式。
3. xlutils:桥接读写,原地修改 xls
由于 xlrd 仅提供只读句柄,而 xlwt 只能全新写入,无法直接对已有 .xls 进行行追加或局部单元格修改。xlutils 库正是为了解决这一痛点而诞生的。它提供的 copy 模块能够将 xlrd.Book 内存对象直接转换为可由 xlwt 编辑的 Workbook,从而在保留原有数据的基础上进行追加写入和样式覆写。
4. pandas:通过指定引擎无缝兼容
如果你主要进行数据分析,日常使用 pandas.read_excel(),也可以直接处理 .xls 文件。只需确保环境中已安装 xlrd,并在调用时指定参数 engine='xlrd'(或由 pandas 根据文件后缀自动推断)。pandas 会在底层调用 xlrd 解码数据并封装为通用的 DataFrame。
三、实操示例:从读取、修改到格式转换的完整方案
在实际业务中,处理 .xls 常见的三类任务是:读取已有数据、生成全新报表、以及向现有历史表格中追加记录。以下给出经过验证的完整示例代码。
1. 使用 xlrd 读取 .xls 数据
读取 .xls 文件的基本逻辑是:打开工作簿、定位指定工作表、按行列索引提取数据。需要注意的是,Excel 内部将日期存储为浮点数,需要借助 xlrd.xldate_as_tuple 转换为 Python 原生日期对象。
import xlrd
from datetime import datetime

def read_xls_file(file_path):
    # 打开工作簿,formatting_info=True 保留格式信息(若需要)
    workbook = xlrd.open_workbook(file_path)

    # 获取第一个工作表
    sheet = workbook.sheet_by_index(0)
    print(f"工作表名称: {sheet.name}")
    print(f"总行数: {sheet.nrows}, 总列数: {sheet.ncols}")

    for row_idx in range(sheet.nrows):
        row_values = []
        for col_idx in range(sheet.ncols):
            cell = sheet.cell(row_idx, col_idx)
            # 处理日期格式(cell.ctype == 3 代表 XL_CELL_DATE)
            if cell.ctype == xlrd.XL_CELL_DATE:
                date_tuple = xlrd.xldate_as_tuple(cell.value, workbook.datemode)
                date_val = datetime(*date_tuple).strftime("%Y-%m-%d")
                row_values.append(date_val)
            else:
                row_values.append(cell.value)
        print(f"行 {row_idx}: {row_values}")

# 执行读取
read_xls_file("data_example.xls")
2. 使用 xlwt 创建并写入 .xls 文件
使用 xlwt 创建新表格非常直接。通过定义 XFStyle,可以为单元格设置背景色、加粗字体、对齐方式以及数字格式:
import xlwt

def create_xls_file(output_path):
    # 实例化工作簿,指定编码
    workbook = xlwt.Workbook(encoding='utf-8')
    sheet = workbook.add_sheet('销售月报')

    # 定义表头样式
    header_style = xlwt.XFStyle()

    # 设置字体
    font = xlwt.Font()
    font.name = 'Microsoft YaHei'
    font.bold = True
    font.colour_index = 0x10 # 黑色
    header_style.font = font

    # 设置背景填充
    pattern = xlwt.Pattern()
    pattern.pattern = xlwt.Pattern.SOLID_PATTERN
    pattern.pattern_fore_colour = xlwt.Style.colour_map['light_blue']
    header_style.pattern = pattern

    # 写入表头
    headers = ['产品编号', '产品名称', '单价', '销量', '金额']
    for col_idx, header in enumerate(headers):
        sheet.write(0, col_idx, header, header_style)

    # 写入数据行
    data = [
        ['P001', '机械键盘', 299.0, 12, 3588.0],
        ['P002', '无线鼠标', 99.0, 45, 4455.0],
    ]
    for row_idx, row_data in enumerate(data, start=1):
        for col_idx, value in enumerate(row_data):
            sheet.write(row_idx, col_idx, value)

    # 保存文件
    workbook.save(output_path)
    print(f"文件已成功保存至: {output_path}")

create_xls_file("sales_report.xls")
3. 使用 xlutils 原地追加或修改已有 .xls
当需要向已有 .xls 末尾追加新记录时,将 xlrd 读取的工作簿复制给 xlutils.copy,即可安全获得写入句柄:
import xlrd
from xlutils.copy import copy

def append_to_xls(file_path, new_row_data):
    # 第一步:以保留格式方式只读打开
    rb = xlrd.open_workbook(file_path, formatting_info=True)
    r_sheet = rb.sheet_by_index(0)
    current_rows = r_sheet.nrows

    # 第二步:转换为可写入对象
    wb = copy(rb)
    w_sheet = wb.get_sheet(0)

    # 第三步:在当前行数末尾写入新数据
    for col_idx, val in enumerate(new_row_data):
        w_sheet.write(current_rows, col_idx, val)

    # 第四步:保存覆盖或另存为新文件
    wb.save(file_path)
    print(f"已向 {file_path} 追加 1 行数据,当前总行数: {current_rows + 1}")

append_to_xls("sales_report.xls", ['P003', '4K显示器', 1899.0, 5, 9495.0])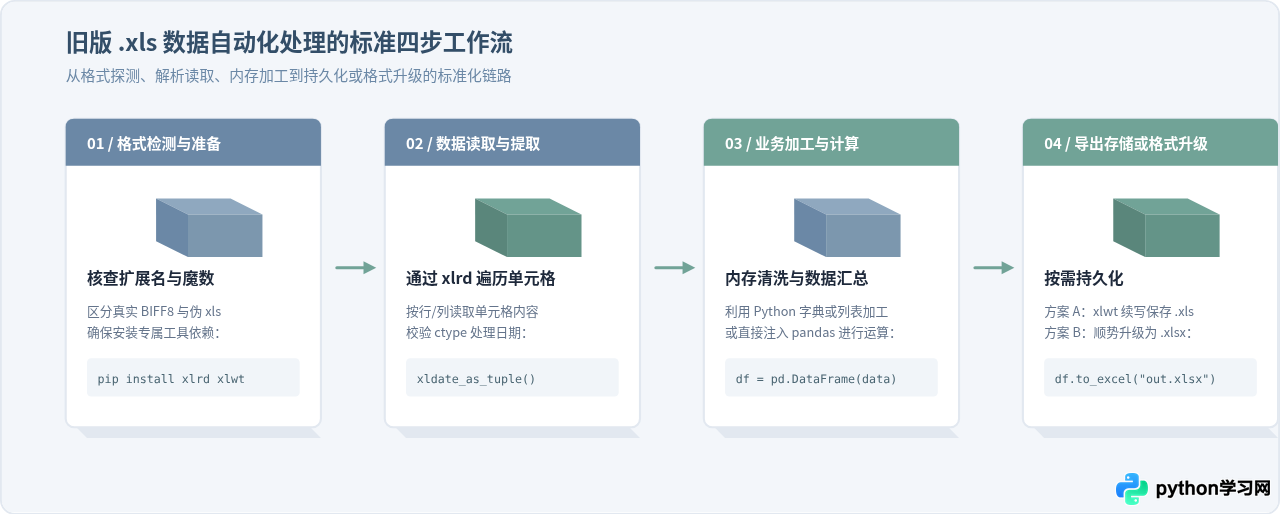
四、批量转换思路:将 xls 升级为 xlsx 从源头解决兼容问题
如果企业历史系统中沉淀了成百上千个 .xls 报表,每次处理都要在 xlrd、xlwt 与 openpyxl 之间来回切换,维护成本较高。一种更彻底的思路是在前置环节通过脚本批量将 .xls 转换为 .xlsx:
import os
import pandas as pd

def convert_xls_to_xlsx(folder_path):
    for root, _, files in os.walk(folder_path):
        for file in files:
            if file.lower().endswith('.xls') and not file.startswith('~$'):
                xls_path = os.path.join(root, file)
                xlsx_path = os.path.splitext(xls_path)[0] + '.xlsx'

                try:
                    # 使用 xlrd 引擎读取所有工作表
                    excel_file = pd.ExcelFile(xls_path, engine='xlrd')
                    with pd.ExcelWriter(xlsx_path, engine='openpyxl') as writer:
                        for sheet_name in excel_file.sheet_names:
                            df = pd.read_excel(excel_file, sheet_name=sheet_name)
                            df.to_excel(writer, sheet_name=sheet_name, index=False)
                    print(f"转换成功: {file} -> {os.path.basename(xlsx_path)}")
                except Exception as e:
                    print(f"转换失败 {file}: {e}")

# 执行批量升级转换
# convert_xls_to_xlsx("./legacy_reports")openpyxl 开展自动化脚本编写,彻底摆脱旧格式库维护滞后的风险。
五、库能力矩阵与技术选型总结
为了让大家在面对不同项目要求时能一目了然地选出最适配的工具,下表汇总了 Python 生态中主要 Excel 处理库的核心指标:
| 库名称 | 支持格式 | 读/写支持 | 单表最大行数 | 依赖环境 | 适用典型场景 |
|---|---|---|---|---|---|
| xlrd (≥2.0) | .xls 专攻 | 只读 | 65,536 行 | 纯 Python | 快速提取老旧系统导出的 .xls 数据 |
| xlwt | .xls 专攻 | 只写 | 65,536 行 | 纯 Python | 需要生成严格要求 .xls 格式的交付物 |
| xlutils | .xls 专攻 | 修改 / 追加 | 65,536 行 | 依赖 xlrd & xlwt | 在已有 .xls 模板中填充数据 |
| openpyxl | .xlsx 专攻 | 读 / 写 / 改 | 1,048,576 行 | 纯 Python | 现代 Excel 表格的主流常规办公自动化 |
| pandas | .xls & .xlsx | 读 / 写 | 视底层引擎决定 | 依赖对应引擎库 | 数据分析、清洗、多格式批量转换 |
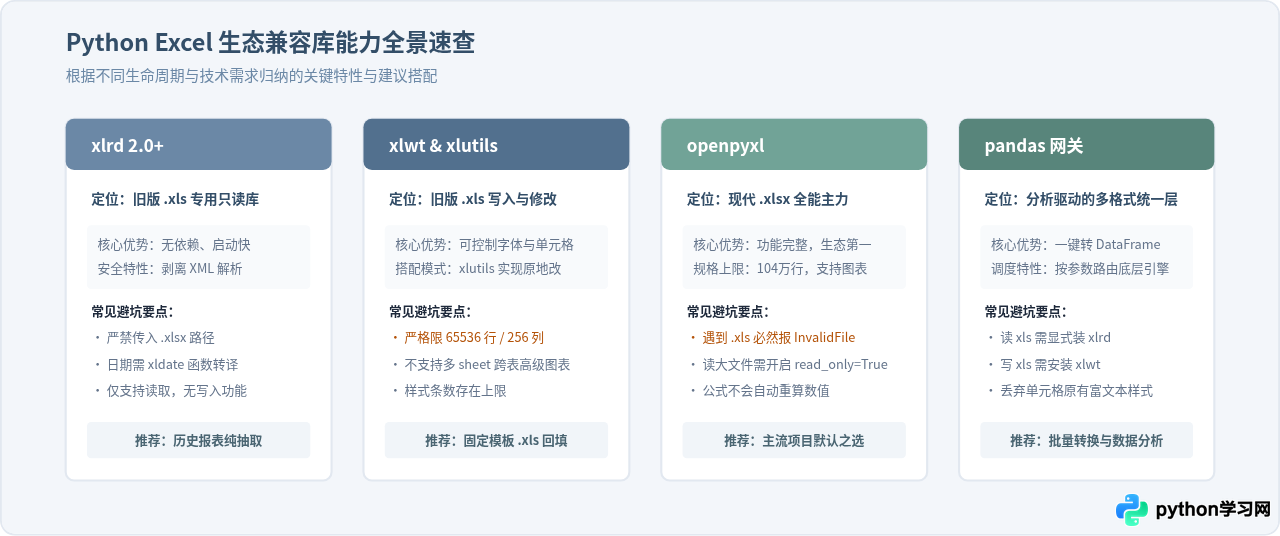
回到最初的问题:“Python 只能处理 xlsx 吗?”显然不是。Python 拥有完备的办公自动化工具链。遇到 .xls 格式报错时,不要急于手动打开 Excel 另存为,只需根据读取、新建或修改的具体诉求,引入 xlrd、xlwt 或 xlutils 即可优雅应对历史格式难题。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









