

怎么在Python中实现类似万能头文件的批量导入效果
本文详解如何在Python中实现类似C++万能头文件的批量导入效果,分别针对算法竞赛、脚本刷题、交互式REPL及IPython环境提供实操方案,并解析命名空间机制与工程权衡。
在算法竞赛和日常刷题中,C++ 选手常用 #include <bits/stdc++.h> 一行引入标准库中的绝大多数容器和算法,免去了逐一书写头文件的麻烦。Python 原生标准库虽然功能丰富,但并没有内置类似的一键导入指令;当需要频繁调用 collections.deque、heapq、bisect、math 或 itertools 时,重复书写多行导入语句会打断思考。要在 Python 中实现类似万能头文件的批量导入效果,核心解决路径通常分为三类:针对算法脚本编写集中的预载模块并通过 import * 载入、针对交互式终端配置 PYTHONSTARTUP 环境变量实现自动注入,以及针对数据分析与 Notebook 环境配置 IPython Profile 启动脚本。
一、为什么 Python 没有官方万能头文件
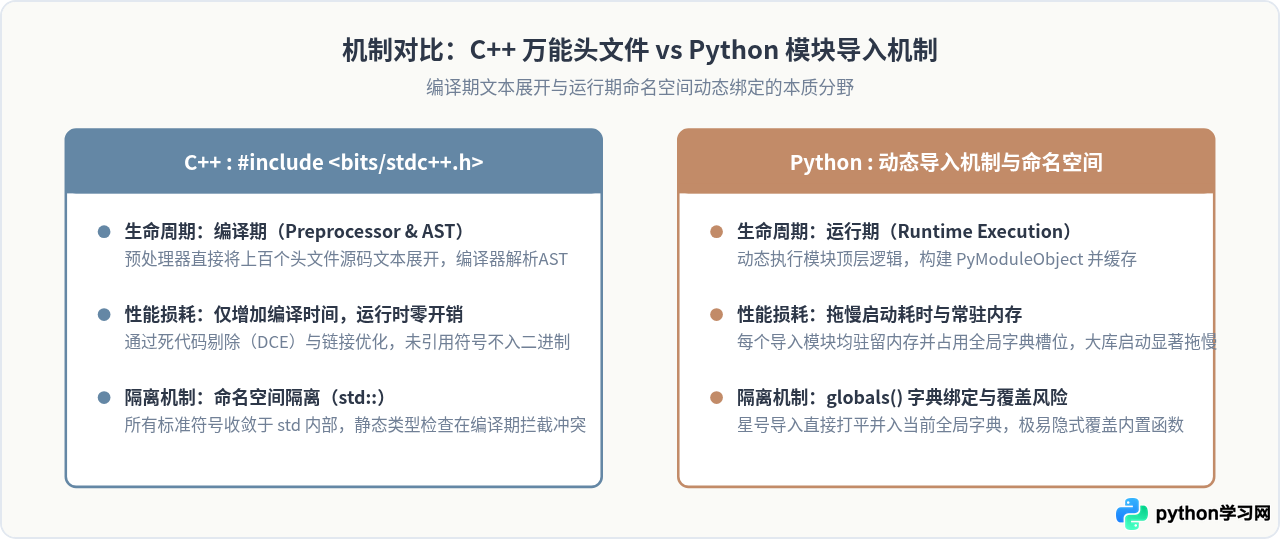
要理解如何在 Python 中实现批量导入,首先必须看清 Python 与 C++ 机制层面的根本差异。C++ 的头文件包含属于编译期文本预处理阶段,编译器在编译时将头文件内容展开,未调用的函数在链接优化时会被剔除,因此几乎不会增加最终可执行文件的运行时开销。而 Python 是一门完全动态的解释型语言,模块导入是在运行时执行的。
当执行 import 语句时,Python 解释器需要检索模块路径、执行模块顶层代码、创建模块对象,并将相应的符号绑定到当前作用域的全局字典 globals() 中。如果像 C++ 那样无差别全量加载 Python 庞大的标准库,会导致脚本启动耗时显著增加、内存消耗成倍上升,并且极易发生严重的变量名覆盖(例如模块内部的工具函数覆盖了 Python 内置的 min、max、sum 或 id)。因此,在 Python 中模拟万能头文件,必须针对不同使用场景量身定制,区分算法竞赛、交互探索与正式工程。
二、方案一:编写高频算法聚合模块(Prelude)
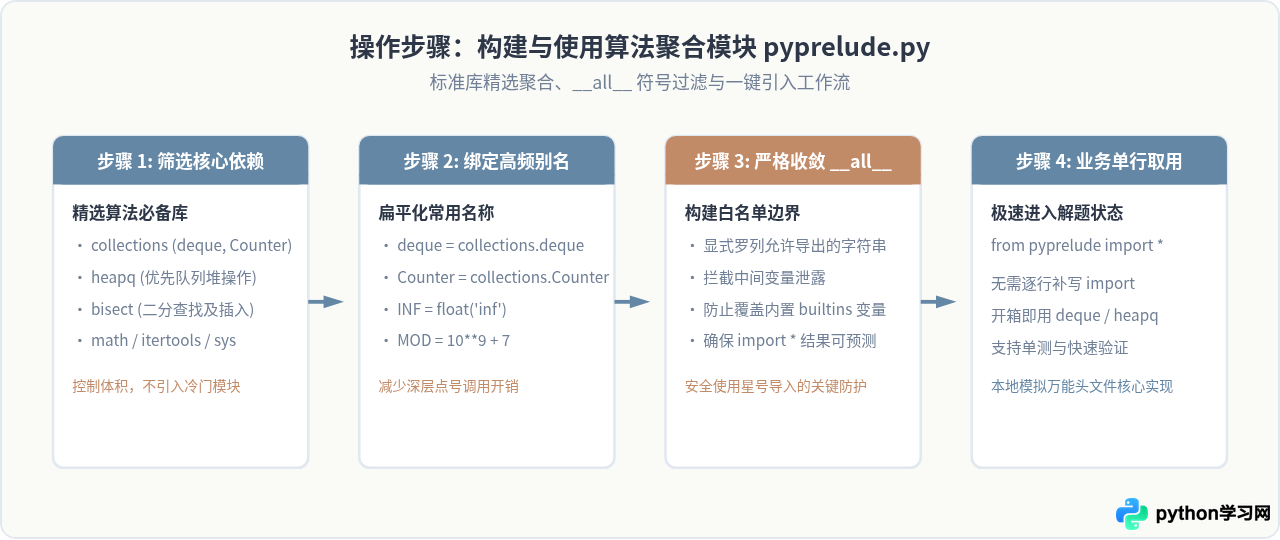
对于在本地刷题(如 LeetCode、Codeforces 练习)的场景,最通用、跨平台且无需修改任何解释器配置的做法,是编写一个专用的预载模块(通常命名为 pyprelude.py 或 prelude.py)。该模块负责把算法最常用的标准库与常用结构集中引入,并通过显式定义 __all__ 过滤掉垃圾符号。
1. 编写 pyprelude.py 脚本
在你的刷题工作目录(或 Python 的库搜索路径 site-packages 下)创建文件 pyprelude.py,录入如下规范内容:
# pyprelude.py - 算法竞赛与高频刷题聚合模块
import sys
import math
import cmath
import bisect
import heapq
import itertools
import functools
import collections
import string
import random

# 常用结构快捷别名
deque = collections.deque
defaultdict = collections.defaultdict
Counter = collections.Counter

# 常用无穷大常数与取模基数
INF = float('inf')
MOD = 10**9 + 7
MOD9 = 998244353

# 精确控制导出符号列表,避免泄露内部临时变量
__all__ = [
    'sys', 'math', 'cmath', 'bisect', 'heapq', 'itertools',
    'functools', 'collections', 'string', 'random',
    'deque', 'defaultdict', 'Counter', 'INF', 'MOD', 'MOD9'
]
2. 在代码中单行引入使用
在具体解题代码中,只需在文件顶部写下一行导入语句,即可像使用万能头文件一样直接取用常用工具:
# solution.py
from pyprelude import *

def solve():
    q = deque([1, 2, 3])
    freq = Counter("banana")
    pq = []
    heapq.heappush(pq, (1, "start"))
    dist = defaultdict(lambda: INF)
    print("队列首部:", q.popleft())
    print("字符统计:", freq)
    print("默认距离:", dist["unvisited"])

if __name__ == '__main__':
    solve()
三、方案二:利用 PYTHONSTARTUP 打造原生交互终端全自动导入
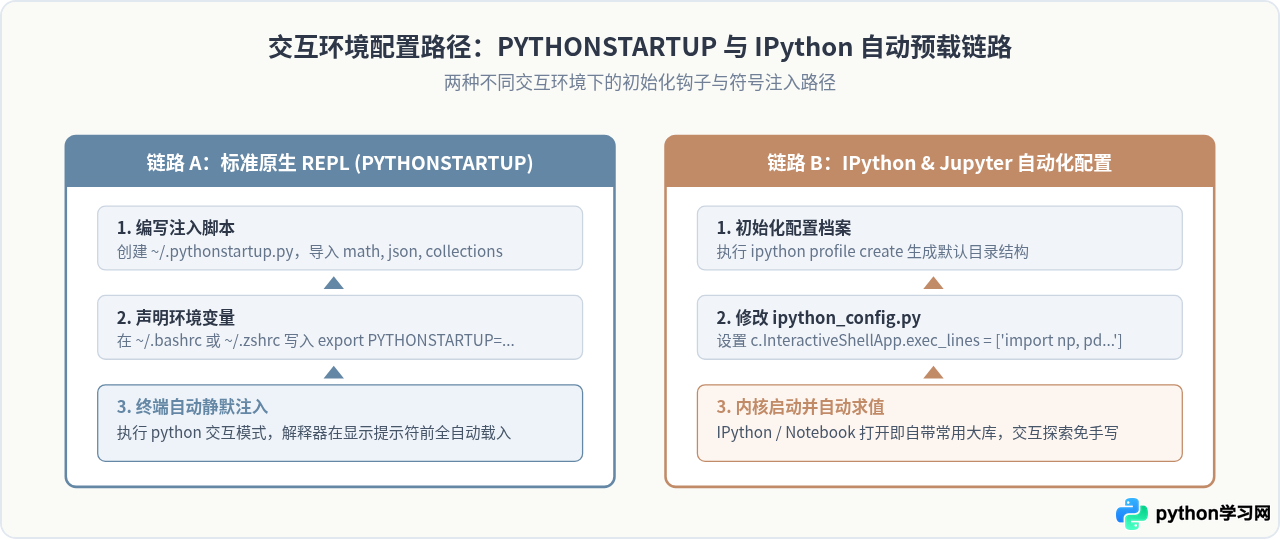
如果你经常在终端启动原生 python 命令进行简短的原型验证、数值计算或正则调试,连 from pyprelude import * 都不想每次敲一遍,可以使用 Python 官方原生提供的环境变量 PYTHONSTARTUP。
当 Python 以交互模式(Interactive Mode)启动时,如果系统设置了 PYTHONSTARTUP 环境变量,解释器会在输出欢迎标语之前,优先执行该变量指向的 Python 脚本。在该脚本中导入的所有模块和定义的函数,都会直接常驻于终端交互的全局命名空间中。
1. 创建终端初始化脚本
在你的用户家目录下创建一个隐式初始化文件(例如 ~/.pythonstartup.py):
# ~/.pythonstartup.py
import sys
import os
import math
import json
import re
import collections
from collections import deque, Counter, defaultdict
import itertools
import functools
import heapq
import datetime

print("[Auto-Loaded] 常用模块 (sys, os, math, json, re, collections, itertools, heapq) 已自动预载完毕。")
2. 配置环境变量
打开你使用的 Shell 配置文件(如 macOS/Linux 下的 ~/.bashrc 或 ~/.zshrc),在末尾追加配置:
export PYTHONSTARTUP="$HOME/.pythonstartup.py"
保存后执行 source ~/.zshrc 或重新开启一个终端窗口。此时只要输入 python 回车,即可看到预载成功的提示,直接使用 deque 或 json,实现真正意义上的“零输入自动具备万能导入”:
$ python
Python 3.11.8 (main, Feb 12 2024, 14:50:05) [Clang 15.0.0] on darwin
Type "help", "copyright", "credits" or "license" for more information.
[Auto-Loaded] 常用模块 (sys, os, math, json, re, collections, itertools, heapq) 已自动预载完毕。
>>> d = deque([10, 20])
>>> math.sqrt(16)
4.0
重要提示:PYTHONSTARTUP 仅对交互式终端有效。使用 python script.py 运行独立的脚本文件时,该文件不会被执行,因此绝对不会对现有的系统级脚本或自动化任务产生意外的副作用或性能干扰。
四、方案三:配置 IPython 与 Jupyter Notebook 自动预载环境
在数据科学与科研领域,用户更常使用的是功能强大的 IPython 终端或网页端 Jupyter Notebook。针对此类环境,IPython 提供了成熟的配置文件机制,允许在启动时通过配置指令批量自动导入常用数据包(如 numpy、pandas、matplotlib.pyplot 等)。
1. 生成默认配置档案
在终端运行命令生成默认配置文件:
ipython profile create命令执行后,系统会在 ~/.ipython/profile_default/ 目录下生成 ipython_config.py 文件。
2. 编辑配置文件注入执行行
使用文本编辑器打开 ~/.ipython/profile_default/ipython_config.py,找到或在文件末尾追加 c.InteractiveShellApp.exec_lines 配置项:
c = get_config()

# 启动 IPython 或对应内核的 Jupyter 时自动执行的代码列表
c.InteractiveShellApp.exec_lines = [
    'import sys, os, math, time',
    'import numpy as np',
    'import pandas as pd',
    'import matplotlib.pyplot as plt',
    'from collections import Counter, defaultdict, deque',
    'print("【数据分析常用栈已自动载入: np, pd, plt, Counter, defaultdict】")'
]
配置完成后,每次启动 ipython 或者启动绑定该 Profile 的 Jupyter Notebook 单元格,都无需再手写冗长的 import numpy as np 和 import pandas as pd,极大地提升了交互式分析的顺畅度。
五、工程禁忌与避坑指南
虽然通过聚合模块和环境变量能够极为爽快地实现“万能头文件”效果,但在真正的商业软件和工程项目中,PEP 8 官方编码规范明确指出:永远应当避免在生产代码中使用 from module import * 通配符导入。理解其中的技术原因,有助于准确把握这一技巧的使用边界:
- 命名空间污染与覆盖(Shadowing):批量导入会将上百个变量名称直接塞入当前文件的
globals()中。如果不慎将一个自定义局部变量命名为min、max、sum或某个模块同名对象,原本的内置功能就会被覆盖,排查时极难发现。 - IDE 自动补全与静态检查失效:现代编辑器(如 VS Code、PyCharm、Pyright、Mypy)高度依赖显式导入来解析符号类型。使用通配符导入后,静态分析器无法判断某个变量究竟来自哪个外部模块,会导致跳入源码、类型推导、重构改名全部失效,同时抛出大量的“未定义变量(Undefined variable)”或“导入未使用(Unused import)”警告。
- 代码可读性与协作成本:团队协作中,当协作者阅读你的代码看到
Counter或bisect_left时,若顶部是显式的from collections import Counter,读者能一眼获知其出处;而面对from pyprelude import *,协作者必须逐级跳转翻查该聚合包的定义。 - 隐式冷启动损耗:若在批量导入模块中加入了体量庞大的第三方库(如
torch、pandas、scipy),即使脚本仅用于输出一行字符串,启动时也必须耗费数秒加载全部 C 扩展和动态链接库,降低微服务或命令行工具的响应敏捷度。
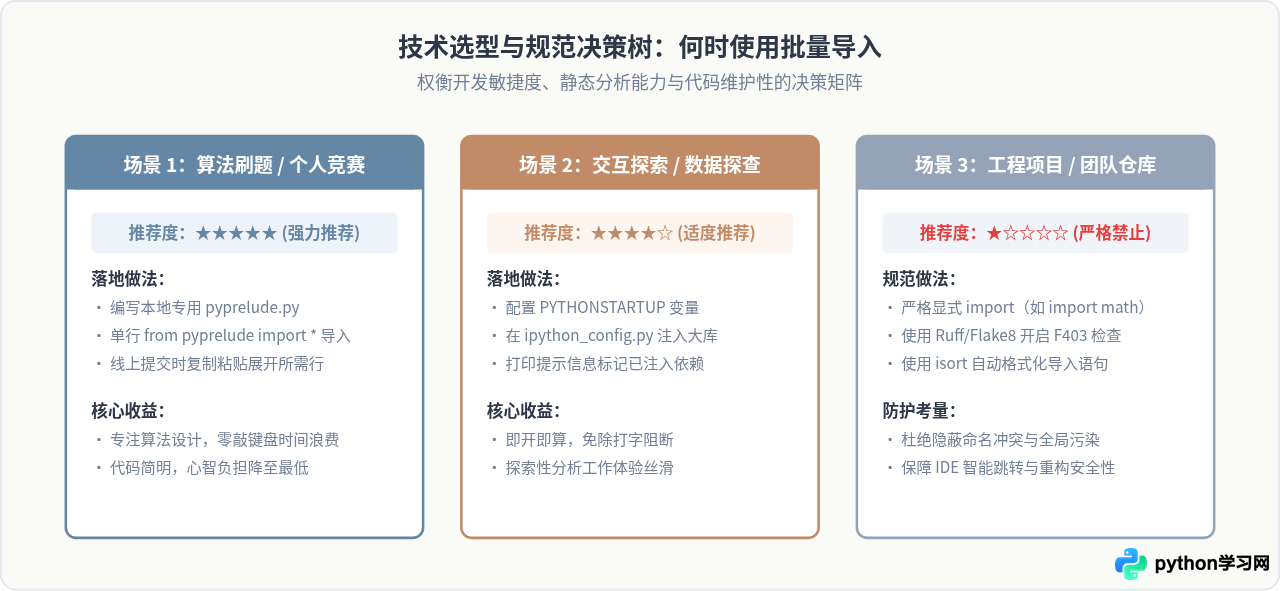
六、方案对比与总结
为了让不同诉求的开发者迅速找到最合适的方案,下表将本文介绍的实现途径进行了横向对比:
| 实现途径 | 生效范围 | 配置成本 | 运行开销 | 最佳适用场景 |
|---|---|---|---|---|
| 聚合模块 (Prelude) | 仅当前脚本(需写一行导入) | 极低(创建单个 .py 文件) |
轻微(毫秒级加载标准库) | LeetCode 刷题、ACM/算法本地练习 |
| PYTHONSTARTUP | 所有原生交互式 Python 终端 | 低(配置单行环境变量) | 启动微秒级(退出后自动清空) | 终端即时试算、快速验证 Python 代码 |
| IPython Profile | IPython 终端及 Jupyter Notebook | 中(编辑专用配置文件) | 中(取决于是否引入科学计算大库) | 探索性数据分析、深度学习交互实验 |
| IDE 预设模板 / Snippet | 新建文件时自动插入多行显式导入 | 低(配置编辑器代码片段) | 零额外开销,完全符合 PEP 8 规范 | 兼顾极速编码与工程严谨性的长久之策 |
综上所述,Python 并没有官方的“万能头文件”,但通过灵活利用模块系统的 __all__ 聚合机制、环境注入钩子 PYTHONSTARTUP 以及 IPython 配置体系,我们完全可以在个人练习与交互探索中享受到一键预载的极致便捷。只要在正式工程开发中坚守显式导入的规范防线,就能够在提升编程效率的同时,确保代码的健壮性与可维护性。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









