

Python Celery分布式任务队列实现高可用定时消息通知
深入讲解如何使用Python与Celery构建高可用的分布式定时消息通知系统,涵盖Beat调度容灾、消息幂等重试、Broker集群部署与Worker健康监管全流程。
在企业级业务系统中,定时向用户推送短信、邮件、应用内推送或企微告警是常见的基础需求。当定时通知的规模由每秒几十条攀升至数万条时,单机 crontab 或简单的线程轮询往往会遭遇单点宕机、任务重复堆积、调度精度丢失以及第三方通道限流等系统性隐患。利用 Python 生态中成熟的分布式任务队列 Celery,配合健壮的 Broker 集群与调度机制,可以构建具备负载均衡、幂等防重与故障自愈能力的高可用定时通知体系。
一、系统整体拓扑与高可用架构
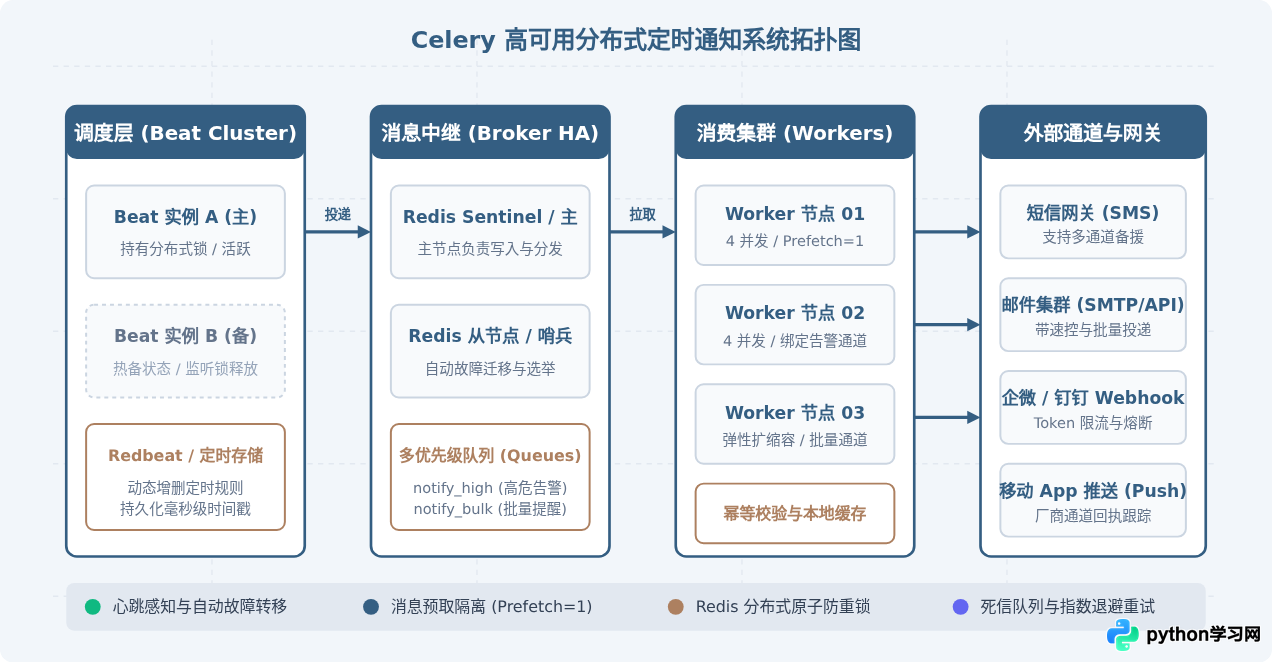
一套健壮的 Celery 定时通知系统通常由四个核心分层组成:调度层(Celery Beat)、存储缓冲层(Message Broker 与 Result Backend)、计算消费层(Celery Worker 节点集群)以及外部通道层。要在生产环境中达成 99.99% 的可用性,每一层都必须消除单点故障(SPOF)。
二、核心配置与 Broker 集群连接
消息中间件(Broker)是解耦调度与执行的核心枢纽。在实际生产场景中,推荐使用 Redis Sentinel 哨兵集群或 RabbitMQ 镜像/Quorum 队列。如果使用单节点 Redis,一旦该节点异常重启,调度事件将丢失,Worker 也会因网络断连导致任务堵塞。
以下是经过生产检验的基础配置文件 celery_config.py,重点针对连接保活、ACK 确认策略以及预取数量进行了稳健性配置:
# celery_config.py
import os

# 1. Broker 高可用连接配置 (以 Redis Sentinel 为例)
# 如果使用 RabbitMQ 集群,可用逗号分隔多个节点:
# BROKER_URL = 'amqp://user:pwd@node1:5672/vhost;amqp://user:pwd@node2:5672/vhost'
BROKER_URL = os.getenv('CELERY_BROKER_URL', 'redis-sentinel://10.0.1.10:26379,10.0.1.11:26379,10.0.1.12:26379/0')
BROKER_TRANSPORT_OPTIONS = {
    'master_name': 'mymaster',
    'socket_timeout': 5.0,
    'socket_connect_timeout': 5.0,
    'retry_on_timeout': True,
    'visibility_timeout': 3600,  # 任务最长执行可见时间,超时未ACK将重新入队
}

# 2. 序列化与时区
CELERY_TIMEZONE = 'Asia/Shanghai'
CELERY_ENABLE_UTC = False
CELERY_ACCEPT_CONTENT = ['json']
CELERY_TASK_SERIALIZER = 'json'
CELERY_RESULT_SERIALIZER = 'json'

# 3. 任务可靠性与防丢失核心参数
CELERY_TASK_ACKS_LATE = True            # 关键:任务执行完成后才向 Broker 发送 ACK,防止 Worker 崩溃时丢任务
CELERY_WORKER_PREFETCH_MULTIPLIER = 1   # 关键:避免单个 Worker 批量预取大量耗时通知任务,保证均匀派发
CELERY_TASK_REJECT_ON_WORKER_LOST = True # Worker 异常断开时拒绝任务并回滚至队列

# 4. 队列路由隔离
CELERY_TASK_QUEUES = {
    'notify_urgent': {'exchange': 'notify', 'routing_key': 'notify.urgent'},
    'notify_normal': {'exchange': 'notify', 'routing_key': 'notify.normal'},
}
CELERY_TASK_DEFAULT_QUEUE = 'notify_normal'
CELERY_TASK_DEFAULT_EXCHANGE = 'notify'
CELERY_TASK_DEFAULT_ROUTING_KEY = 'notify.normal'CELERY_TASK_ACKS_LATE默认情况下,Celery 在从 Broker 拉取到任务的瞬间就会发送确认(Early ACK)。若此 Worker 在真正向通道推送消息前被系统 OOM 杀死或物理断电,该条定时通知将彻底丢失。开启 ACKS_LATE = True 配合 REJECT_ON_WORKER_LOST = True,能够确保在 Worker 非正常退出时,Broker 重新将该任务分配给健康节点。
三、Beat 调度器的单点突破与主备选举
Celery 原生的 celery beat 进程是一个纯单进程轮询器。官方明确禁止同时启动多个原生 Beat 进程,否则会导致定时任务成倍重复触发。然而只部署一个 Beat 进程又构成了系统的单点故障(SPOF)。
解决 Beat 调度高可用主要有两种工业界成熟路线:
- 基于 Redis 的分布式调度插件(如 Redbeat):任务时间表不保存在本地内存或文件,而是写入 Redis 的 Sorted Set 中,通过有序集合的分数(Score 为下次触发时间戳)实现动态管理。
- 分布式锁选主运行(Leader Election):在多台服务器上同时运行 Beat 守护脚本,启动时竞争 Redis 分布式排他锁(附带 TTL 心跳续约),只有获得锁的主节点执行调度,其余备用节点休眠轮询等待锁释放。
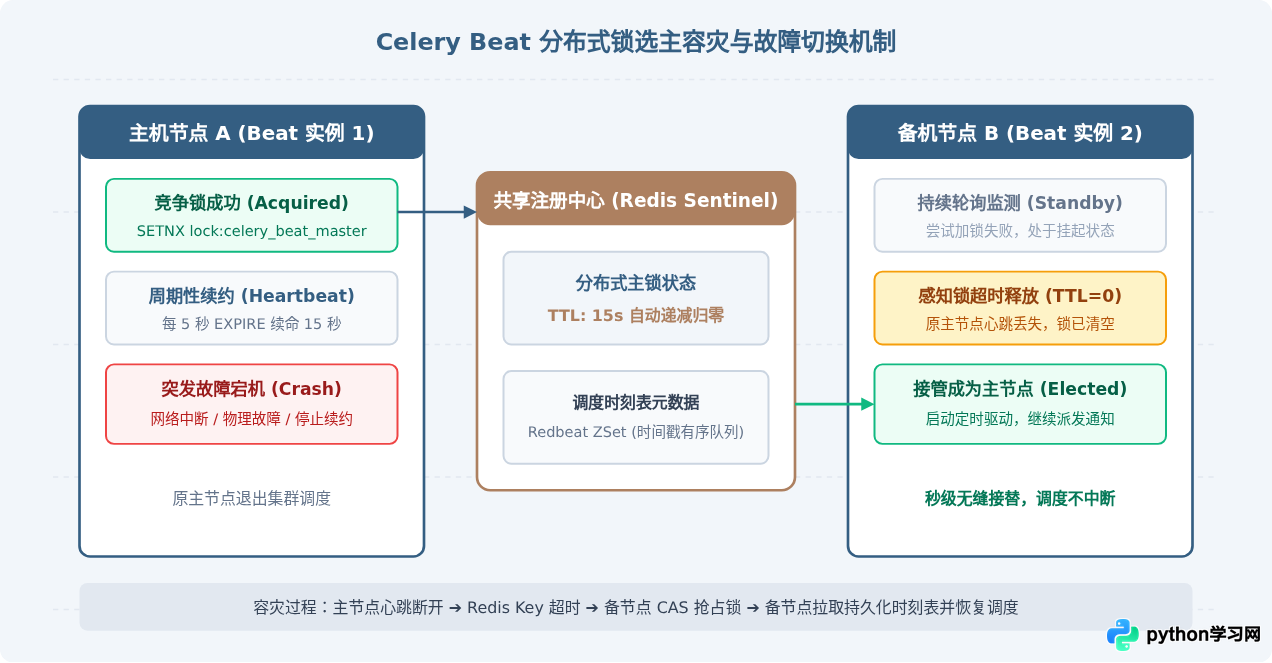
以下是使用 Python 编写的轻量级 Beat 守护进程封装脚本 ha_beat_runner.py,可作为 systemd 服务直接部署在多台物理机或容器节点上:
# ha_beat_runner.py
import time
import socket
import subprocess
import redis

REDIS_HOST = '10.0.1.10'
REDIS_PORT = 6379
LOCK_KEY = 'celery:beat:leader_lock'
LOCK_TIMEOUT = 15  # 锁有效时间 15 秒
HEARTBEAT_INTERVAL = 5  # 续命间隔 5 秒
NODE_ID = f"{socket.gethostname()}_{time.time()}"

client = redis.Redis(host=REDIS_HOST, port=REDIS_PORT, db=0, decode_responses=True)

def run_beat_process():
    return subprocess.Popen(['celery', '-A', 'tasks.app', 'beat', '-l', 'info'])

def main():
    beat_process = None
    print(f"[Node {NODE_ID}] 启动高可用 Beat 监听守护...")

    try:
        while True:
            # 尝试通过 SETNX 获取排他锁
            acquired = client.set(LOCK_KEY, NODE_ID, nx=True, ex=LOCK_TIMEOUT)

            if acquired or client.get(LOCK_KEY) == NODE_ID:
                # 刷新锁过期时间
                client.expire(LOCK_KEY, LOCK_TIMEOUT)

                # 若尚未拉起 Beat 子进程,则启动
                if beat_process is None or beat_process.poll() is not None:
                    print(f"[Node {NODE_ID}] 成功夺锁,正启动 Celery Beat 主进程...")
                    beat_process = run_beat_process()

                time.sleep(HEARTBEAT_INTERVAL)
            else:
                # 未获得锁,确保本地无 Beat 进程在跑
                if beat_process and beat_process.poll() is None:
                    print(f"[Node {NODE_ID}] 锁丢失,紧急终止本地 Beat 进程...")
                    beat_process.terminate()
                    beat_process.wait()
                    beat_process = None

                # 备用节点休眠轮询
                time.sleep(3)
    finally:
        if beat_process and beat_process.poll() is None:
            beat_process.terminate()
        if client.get(LOCK_KEY) == NODE_ID:
            client.delete(LOCK_KEY)

if __name__ == '__main__':
    main()
四、消息通知任务定义、幂等性与重试机制
在分布式环境中,网络抖动或超时重试会导致相同的一条定时通知被投递或执行多次。向用户重复发送短信或扣费提醒会造成恶劣的体验。因此,定时通知任务必须在业务逻辑层面实现幂等性。
幂等性实现的标准范式是:全局唯一消息业务键(Idempotency Key) + 强一致性分布式锁 + 执行流水状态机。
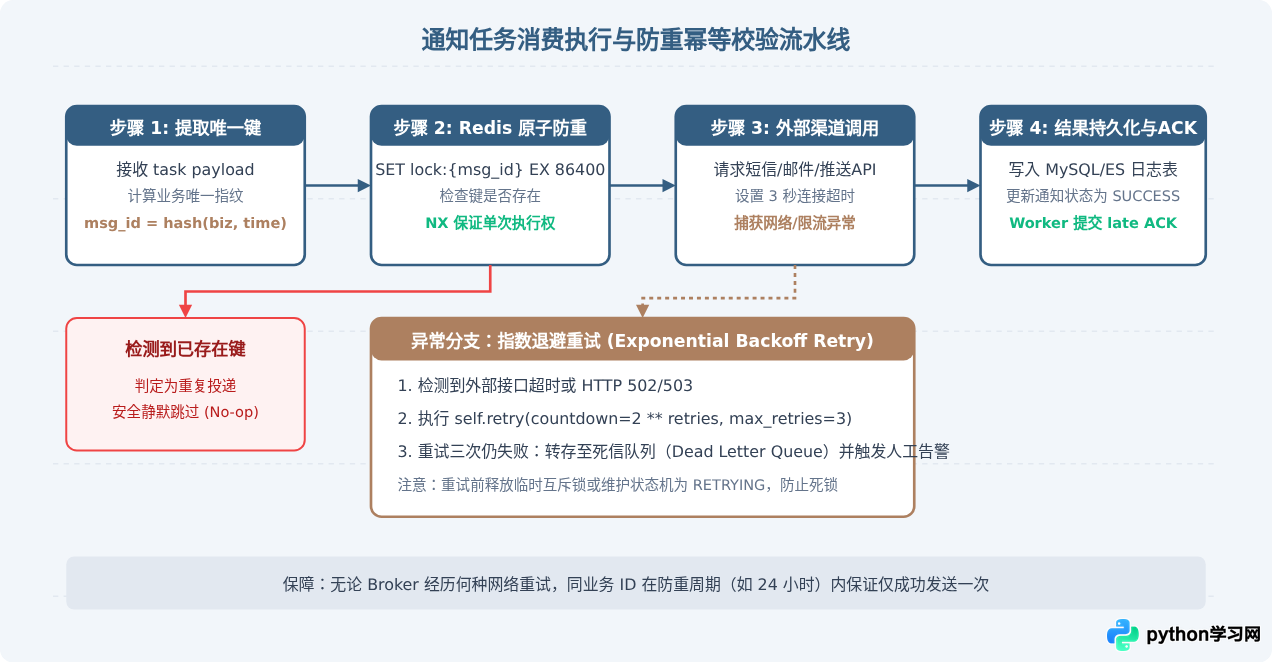
下面是具体的任务实现模块 tasks/notifications.py:
# tasks/notifications.py
import logging
import requests
import redis
from celery import Celery
from celery.exceptions import MaxRetriesExceededError

app = Celery('notify_app')
app.config_from_object('celery_config')

logger = logging.getLogger(__name__)
redis_client = redis.Redis(host='10.0.1.10', port=6379, db=1, decode_responses=True)

@app.task(bind=True, max_retries=3, queue='notify_urgent')
def send_timed_notification(self, task_biz_id: str, channel: str, recipient: str, content: str):
    """
    通用定时消息通知任务
    :param task_biz_id: 业务层全局唯一流水号,如 'DAILY_REPORT_20261025_USER10086'
    :param channel: 通道类型 ('sms', 'email', 'webhook')
    :param recipient: 接收人标识
    :param content: 通知文本
    """
    lock_key = f"notify:lock:{task_biz_id}"
    status_key = f"notify:status:{task_biz_id}"

    # 1. 检查任务是否已经执行成功 (防重屏障)
    current_status = redis_client.get(status_key)
    if current_status == "SUCCESS":
        logger.info(f"[幂等跳过] 任务已执行过: {task_biz_id}")
        return {"status": "SKIPPED", "task_biz_id": task_biz_id}

    # 2. 获取分布式排他锁,防止并发消费同一任务
    acquired = redis_client.set(lock_key, "PROCESSING", nx=True, ex=120)
    if not acquired:
        logger.warning(f"[并发拦截] 任务正在处理中: {task_biz_id}")
        return {"status": "CONFLICT", "task_biz_id": task_biz_id}

    try:
        # 3. 模拟请求第三方网关发送消息
        response = call_external_gateway(channel, recipient, content)

        # 4. 执行成功,登记状态,保留 7 天
        redis_client.set(status_key, "SUCCESS", ex=7 * 86400)
        logger.info(f"[发送成功] 业务ID: {task_biz_id}, 响应: {response}")
        return {"status": "SUCCESS", "task_biz_id": task_biz_id}

    except (requests.RequestException, TimeoutError) as exc:
        # 释放执行锁,使重试能够顺利抢占
        redis_client.delete(lock_key)
        backoff_countdown = 2 ** self.request.retries * 5  # 指数退避:5s, 10s, 20s
        logger.error(f"[通道异常] 准备第 {self.request.retries + 1} 次重试, 延时 {backoff_countdown}s. 错误: {exc}")
        try:
            raise self.retry(exc=exc, countdown=backoff_countdown)
        except MaxRetriesExceededError:
            # 记录到死信存储并标记失败
            redis_client.set(status_key, "FAILED", ex=7 * 86400)
            logger.critical(f"[彻底失败] 达到最大重试次数,转入死信归档: {task_biz_id}")
            raise
    finally:
        # 正常完成时清理临时处理锁
        redis_client.delete(lock_key)

def call_external_gateway(channel: str, recipient: str, content: str):
    # 模拟外部网关调用并施加严谨超时
    url_map = {
        'sms': 'https://sms-gateway.internal/api/v1/send',
        'webhook': 'https://qyapi.weixin.qq.com/cgi-bin/webhook/send',
    }
    target_url = url_map.get(channel, 'https://notify.internal/api/send')
    res = requests.post(target_url, json={'to': recipient, 'msg': content}, timeout=3.5)
    res.raise_for_status()
    return res.json()
五、生产级 Worker 部署与健康管理
部署高可用 Worker 集群时,应避免在一台机器上启动单个庞大的 Worker 进程。正确的工程实践是将 Worker 节点拆分为多台独立云服务器,利用进程管理工具(如 systemd 或 supervisord)实现崩溃自拉起,并利用独立端口向 Prometheus 暴露心跳指标。
以下是使用 systemd 守护 Worker 的标准单元文件 /etc/systemd/system/celery-worker.service:
[Unit]
Description=Celery High-Availability Notification Worker
After=network.target

[Service]
Type=forking
User=celeryapp
Group=celeryapp
EnvironmentFile=/etc/default/celeryd
WorkingDirectory=/opt/notification-system
ExecStart=/bin/sh -c '${CELERY_BIN} -A $CELERY_APP multi start $CELERYD_NODES \
  --pidfile=${CELERYD_PID_FILE} --logfile=${CELERYD_LOG_FILE} \
  --loglevel=${CELERYD_LOG_LEVEL} $CELERYD_OPTS'
ExecStop=/bin/sh -c '${CELERY_BIN} multi stopwait $CELERYD_NODES \
  --pidfile=${CELERYD_PID_FILE}'
ExecReload=/bin/sh -c '${CELERY_BIN} multi restart $CELERYD_NODES \
  --pidfile=${CELERYD_PID_FILE} --logfile=${CELERYD_LOG_FILE} \
  --loglevel=${CELERYD_LOG_LEVEL} $CELERYD_OPTS'
Restart=always
RestartSec=5s

[Install]
WantedBy=multi-user.target
配套的配置环境变量 /etc/default/celeryd:
# 启动两个独立 worker 进程进行分流
CELERYD_NODES="worker_urgent_1 worker_bulk_1"
CELERY_BIN="/opt/notification-system/venv/bin/celery"
CELERY_APP="tasks.notifications:app"

# 日志与 PID 路径
CELERYD_LOG_FILE="/var/log/celery/%n%I.log"
CELERYD_PID_FILE="/var/run/celery/%n.pid"
CELERYD_LOG_LEVEL="INFO"

# 针对不同队列绑定专门 worker
CELERYD_OPTS="-Q:worker_urgent_1 notify_urgent -c:worker_urgent_1 8 -Q:worker_bulk_1 notify_normal -c:worker_bulk_1 4"
六、高可用容灾演练与运维自愈
系统上线前,必须针对各类突发事故开展全链路故障注入验证,确保各项指标均能自愈回正。
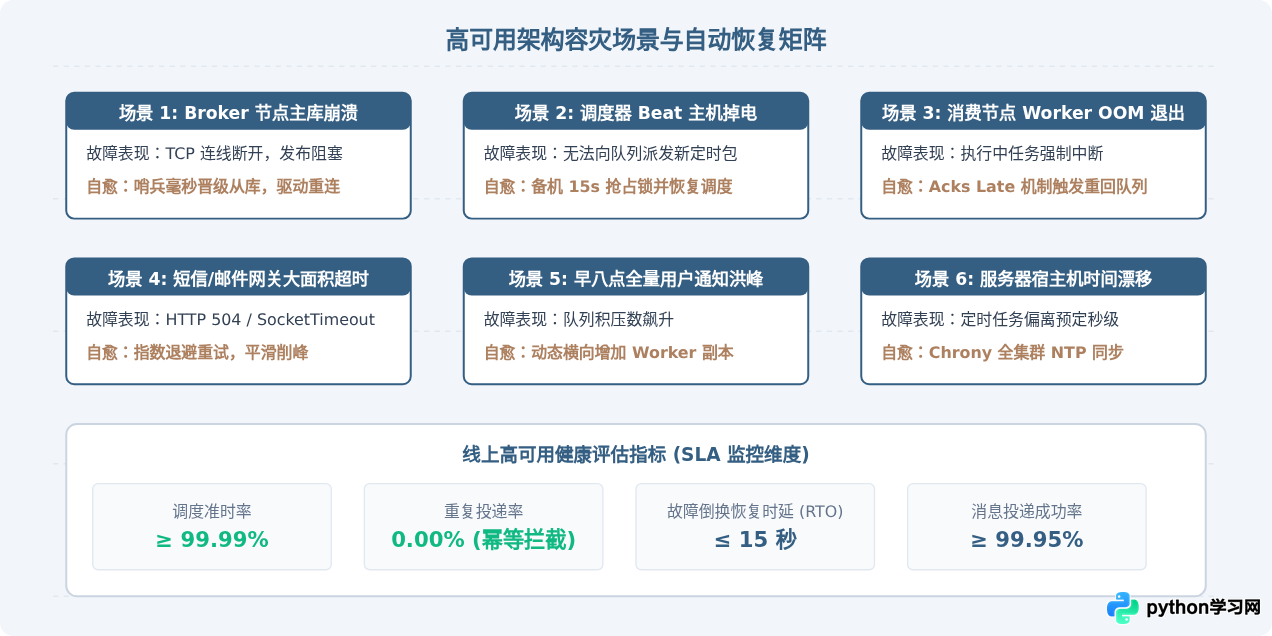
验证集群运行状态的常用命令:
# 1. 检查活跃的 Worker 节点及其并发配置
celery -A tasks.notifications inspect active

# 2. 检查各 Worker 预取的任务积压数量
celery -A tasks.notifications inspect reserved

# 3. 统计各队列未消费的滞留深度 (结合 redis-cli)
redis-cli -h 10.0.1.10 -p 6379 llen notify_urgent
redis-cli -h 10.0.1.10 -p 6379 llen notify_normal
七、总结与生产落地检查清单
实现 Python Celery 的高可用定时消息通知,核心并不在于单个工具的引入,而在于对整个链路中脆弱环节的层层防御。总结起来,上线前应逐一核对以下工程要点:
| 层面 | 检查项 | 标准配置与建议 |
|---|---|---|
| 中间件 | Broker 哨兵/集群配置 | 采用 Redis Sentinel 或 RabbitMQ Quorum 集群,配置自动重试连接参数。 |
| 调度端 | Beat 消除单点故障 | 部署多实例并引入基于 Redis 的分布式锁选主脚本或 Redbeat 插件。 |
| 消费端 | 任务丢失防护 | 必须配置 acks_late=True、reject_on_worker_lost=True 及 prefetch_multiplier=1。 |
| 业务层 | 幂等性与重试 | 计算业务唯一键,使用 Redis 原子锁拦截并发,网络异常使用指数退避重试。 |
| 运维层 | 进程守护与监控 | 使用 systemd 托管进程自愈,部署 Flower 或导出 Prometheus 指标并设置队列深度阈值告警。 |
按照这套方案构建的定时通知系统,能够做到无论面临网络分区、节点突然断电还是第三方网关偶发性故障,均能做到定时精准触发、消息不丢不重、系统自愈运行。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









