

Python怎么批量注释多行代码

在Python开发过程中,无论是在调试功能、排查报错还是临时停用某段逻辑,批量注释多行代码都是高频操作。与C、Java等语言拥有专门的块注释语法(/* ... */)不同,Python在官方语法层面上只提供了一种真正的注释标记,即井号 #。这意味着在原生Python代码中,批量注释本质上是“为多行代码的行首统一添加 #”。在实际开发中,开发者主要通过代码编辑器快捷键(最推荐的标准做法)和未赋值的三引号多行字符串(临时规避写法)两种途径实现多行注释。
方法一:使用编辑器快捷键批量添加单行注释(推荐方案)
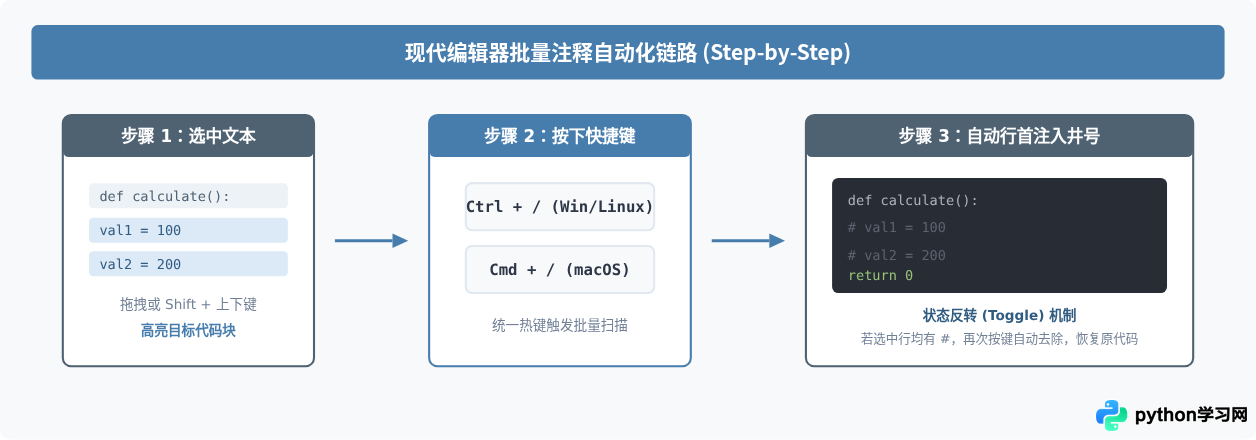
现代代码编辑器和集成开发环境(IDE)都内置了批量行注释功能。这种方式直接利用工具自动化在每行开头插入或移除 #,既符合PEP 8规范,又不会引入多行字符串的解析副作用,是最安全、规范的批量注释手段。
具体操作只需要两步:
- 选中目标区域:使用鼠标拖拽或者键盘快捷键(按住
Shift配合方向键)高亮选中需要注释的多行代码。 - 按下注释快捷键:按下对应编辑器的多行注释组合键,选中的所有行开头会自动填充
#。再次按下该组合键,则会自动批量取消注释。
| 开发工具 / 编辑器 | Windows / Linux 快捷键 | macOS 快捷键 | 注释行为与作用 |
|---|---|---|---|
| VS Code | Ctrl + / |
Cmd + / |
单行批量切换:每行首添加或移除 # |
| PyCharm / IntelliJ | Ctrl + / |
Cmd + / |
单行批量切换(若按 Ctrl+Shift+/ 也会自动用井号包裹选区) |
| Jupyter Notebook / Lab | Ctrl + / |
Cmd + / |
单元格内多行批量添加或取消 # |
| Sublime Text | Ctrl + / |
Cmd + / |
选中文本逐行切换注释状态 |
| Vim / Neovim | 可视化块模式:Ctrl + v 选中行首,按 I 输入 # ,按 Esc |
同左 | 原生列编辑批量插入;或配合插件(如 commentary/nerdcommenter)按 gcc |
| IDLE(自带环境) | Alt + 3(添加注释) / Alt + 4(取消注释) |
Ctrl + 3 / Ctrl + 4 |
在选中的行首插入 ## 或删除开头的井号 |
方法二:使用三引号多行字符串作为伪注释
在没有快捷键或者需要临时停用大块独立代码时,很多开发者会选择使用一对三单引号(''')或三双引号(""")将代码包围起来:
"""
以下代码被多行字符串包围,暂时不参与逻辑运算
val_a = fetch_remote_data()
val_b = parse_json(val_a)
print("Debug:", val_b)
"""
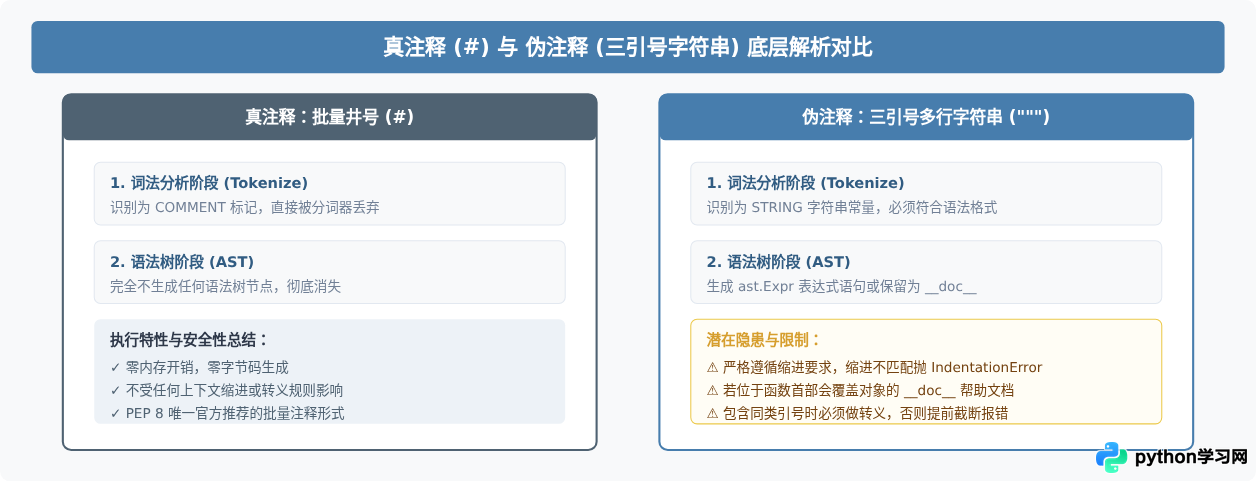
print("程序正常向下执行")这种做法在技术原理上需要明确区分:三引号实质上是多行字符串字面量(Multiline String Literal),并非真正的注释(Comment)。当Python解释器执行到一段没有赋值给任何变量、也没有作为函数或类第一条语句的独立字符串时,解释器会生成一个常量对象并随后丢弃,从而在宏观上达到了“不运行该段逻辑”的效果。
三引号批量“注释”的三个典型陷阱
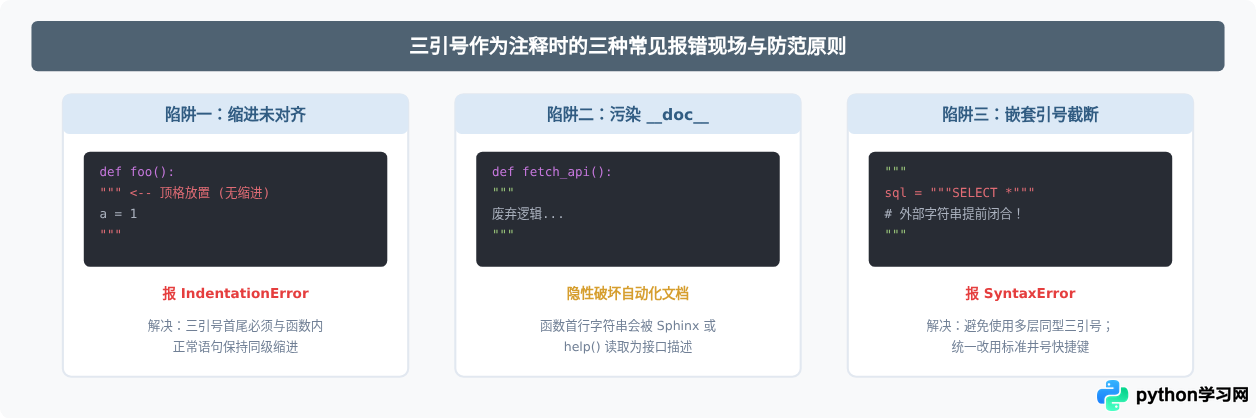
虽然三引号在临时调试时很方便,但如果盲目将其视为“万能块注释”,经常会导致令人困惑的语法错误:
1. 缩进不匹配引发的 IndentationError
在Python中,每一条语句的缩进级别都必须严格与其所属的代码块一致。三引号多行字符串本身也是一条语句,如果放置在函数或循环体内部,三引号的首行缩进必须与内部语句严格对齐:
def process_order():
    user_id = 1001
# 错误写法:三引号顶格放置,破坏了函数的缩进层级
"""
    discount = 0.8
    total = price * discount
"""
return total运行上述代码会直接抛出:IndentationError: unexpected indent。正确的写法是三引号的开始与结束行都必须和 user_id 保持相同的缩进空格数。
2. 无意间覆盖 docstring(文档字符串)
在Python语法中,定义在模块、类或函数第一行的未赋值字符串,会被自动识别并赋值给该对象的 __doc__ 属性。如果你在函数第一行用三引号注释掉了旧代码,原本写好的文档描述就会被注释内容直接覆盖:
def get_user_info(uid):
    """
    uid = str(uid).strip()
    # 本意是注释掉这里的旧逻辑
    """
    return db.query(uid)

print(get_user_info.__doc__)  # 输出的是注释掉的废弃代码,而非原本的文档说明
3. 内部包含相同引号导致提前闭合
如果被注释的代码本身就包含三单引号或三双引号(例如内部有格式化SQL或正则),外层的三引号会与内部的引号提前配对,导致剩余部分暴露成无法识别的残缺代码,产生 SyntaxError: invalid syntax。
方法三:使用正则表达式或脚本进行批量自动化处理
当面对大型文件、没有图形界面的服务器环境,或是需要在批处理脚本中批量注释上千行代码时,可以通过正则表达式快速完成行首加井号的操作。
1. 编辑器内的正则表达式替换
在 VS Code 或 Sublime Text 中,打开查找替换窗口(Ctrl + H 或 Cmd + Option + F),选中“仅在选定内容中查找”并开启正则表达式支持(图标 .*):
- 查找目标(Regex):
^(匹配每行的开头) - 替换为:
#(在开头插入井号与空格) - 批量反注释查找:
^#\s?(匹配行首的井号及可选空格),替换为空即可。
2. 使用 Python 脚本处理批处理任务
如果需要在CI流水线或离线工具中自动化注释某个文件中的特定代码段,编写一段简洁的Python脚本即可稳定达成:
def batch_comment_file(file_path, start_line, end_line):
    """将指定行号范围内的代码添加井号注释(行号从1开始计算)"""
    with open(file_path, 'r', encoding='utf-8') as f:
        lines = f.readlines()

    modified_lines = []
    for idx, line in enumerate(lines, start=1):
        if start_line <= idx <= end_line:
            # 保留原有的缩进空白,将 # 插入在非空字符前
            stripped = line.lstrip()
            indent = line[:len(line) - len(stripped)]
            modified_lines.append(f"{indent}# {stripped}" if stripped else line)
        else:
            modified_lines.append(line)

    with open(file_path, 'w', encoding='utf-8') as f:
        f.writelines(modified_lines)

# 示例调用:将 target.py 的第 10 行至第 25 行批量注释
# batch_comment_file("target.py", 10, 25)
场景选型与总结
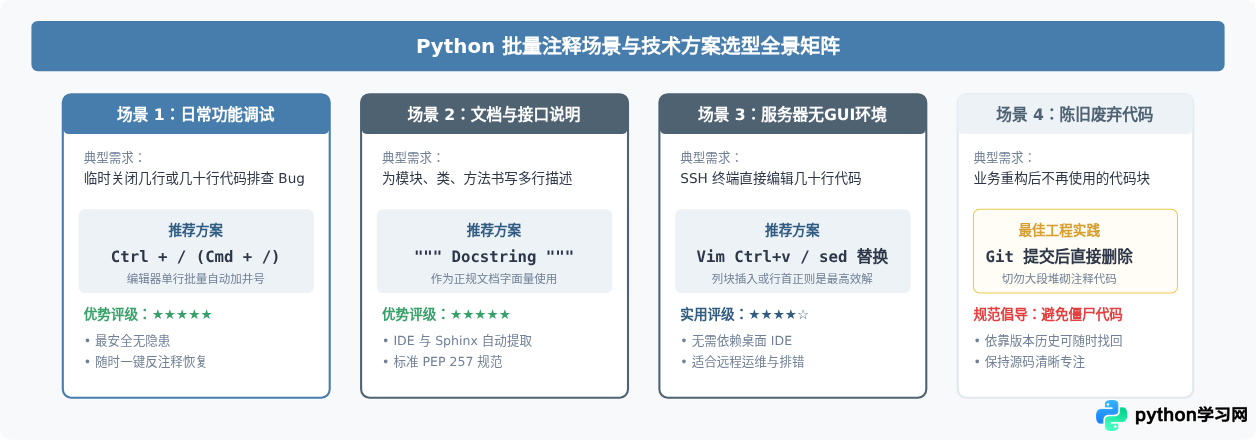
针对“Python怎么批量注释多行代码”这一问题,实际开发中的决策非常清晰:
- 日常开发、本地调试、单段停用:首选编辑器快捷键(
Ctrl + /或Cmd + /)。这是PEP 8官方最鼓励的形态,全自动处理缩进与取消注释,没有任何负面副作用。 - 函数或模块说明:规范编写 Docstring,使用三引号撰写接口输入输出说明,而不是用于屏蔽代码。
- 长期废弃的旧逻辑:直接使用 Git 等版本控制系统记录并删除代码,切忌在生产代码库中长期堆放数百行被注释的代码,以保持代码库的整洁和可维护性。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









