

Python基础语法代码示例:变量、循环与函数定义
系统讲解Python基础语法中的变量命名与类型、for与while循环控制结构,以及函数定义与参数传递机制。结合可运行的代码示例与工程结构图,帮助读者掌握核心编程逻辑。
一、变量定义与数据载体
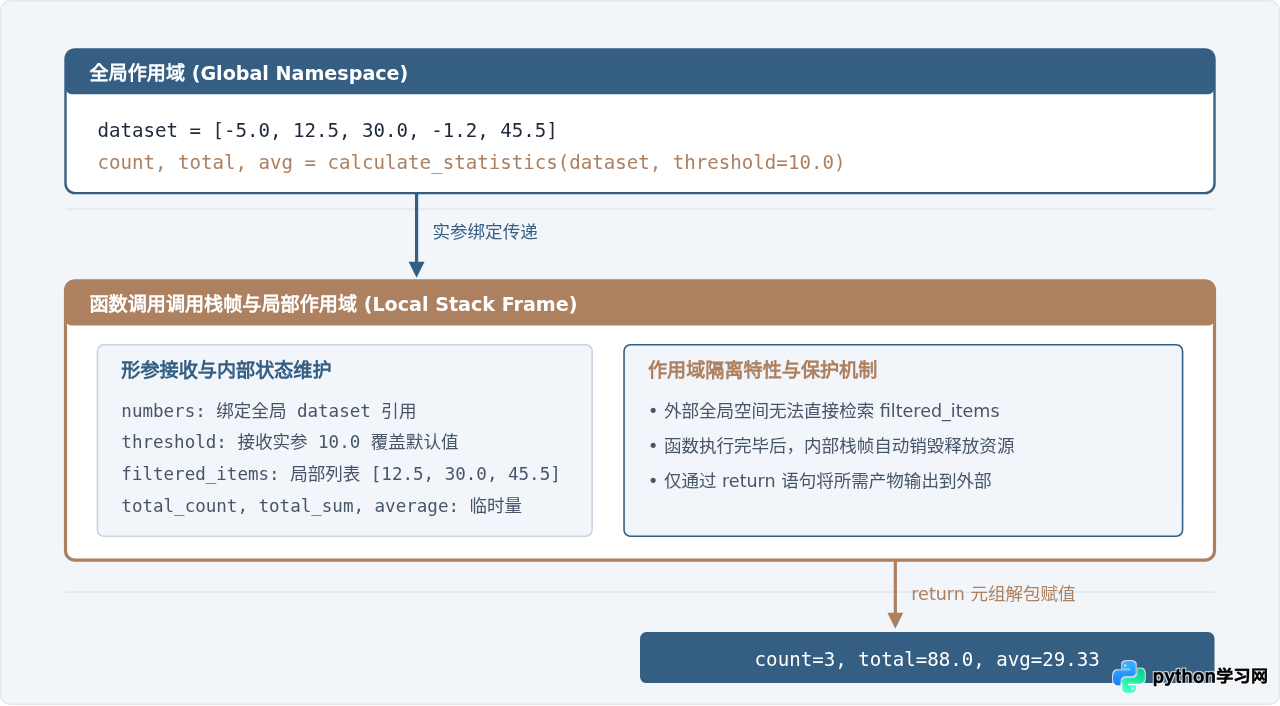
在Python中,变量无需显式声明类型即可直接赋值使用。赋值操作的本质并非在内存中划定一个带固定类型的“盒子”,而是创建或引用一个内存对象,并将变量名作为标识符“绑定”到该对象上。这一机制使得Python具备动态类型特征。
1. 命名规则与常见基础类型
变量名只能由字母、数字和下划线组成,且不能以数字开头,同时禁止使用Python保留关键字(如 def、class、for 等)。PEP 8规范建议使用小写字母配合下划线分割单词(蛇形命名法,例如 student_score)。
- 数值类型(int, float):用于存储整数和浮点数,支持常规算术运算。
- 字符串(str):文本序列,支持通过单引号、双引号或三引号定义,具备不可变性。
- 列表(list):有序的可变序列,支持元素的增删改查。
- 字典(dict):由键值对组成的映射容器,通过唯一且不可变的键进行快速检索。
下面的代码展示了基础变量赋值、复合容器定义以及使用 type() 函数检测变量类型的具体方式:
# 基础类型变量赋值
total_count = 42                # 整数 int
completion_rate = 0.875         # 浮点数 float
system_status = "OPERATIONAL"   # 字符串 str
is_active = True                # 布尔值 bool

# 复合容器变量定义
port_list = [8080, 8081, 9000]  # 列表 list
server_config = {               # 字典 dict
    "host": "127.0.0.1",
    "port": 8080,
    "environment": "production"
}

# 格式化输出与类型判定
print(f"total_count 类型: {type(total_count).__name__}, 数值: {total_count}")
print(f"server_config 类型: {type(server_config).__name__}, 目标主机: {server_config['host']}")server_config 类型: dict, 目标主机: 127.0.0.1
变量在整个程序体系中承担着数据载体的任务,它为后续的条件判断、循环遍历和函数传参提供了明确的数据入口。
二、循环结构与流程控制
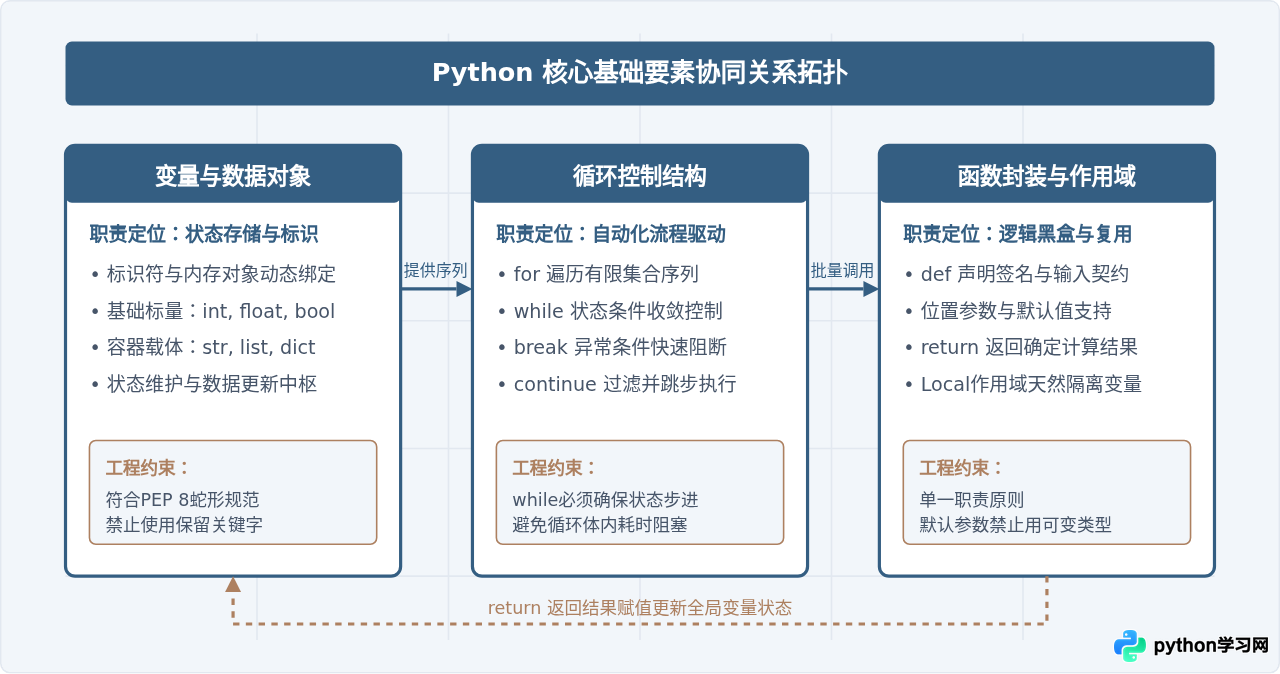
当需要对数据集进行批量运算或根据某一动态状态重复执行任务时,就需要使用循环结构。Python主要提供 for 循环与 while 循环两种形式。
1. for 循环:确定集合与区间遍历
Python的 for 循环本质上是一个迭代器驱动模型,用于依次从可迭代对象(如列表、元组、字符串、字典键值或 range() 区间)中提取元素,直到集合耗尽。
内置函数 range(start, stop, step) 生成整数序列,遵循“左闭右开”规则(包含 start,但不包含 stop)。结合 enumerate() 函数还可以同时获取元素下标与对应值。
2. while 循环:状态驱动的条件收敛
while 循环在指定的布尔表达式为 True 时持续执行循环体。它适用于无法预先确定具体循环次数、但知道终止条件的场景。必须在循环体内安排改变判定变量的语句(步进逻辑),否则会导致CPU占满的死循环。
3. 流程跳变:break、continue 与 else 语句
break:立即终止当前整个循环,跳出循环块执行后续代码。continue:立即结束当前本次迭代,直接跳转到下一次循环条件的判定处。else子句:挂接在循环末尾。只有当循环完整自然执行完毕、未被break强制打断时,才会触发else块中的语句。
以下代码综合展示了 for 遍历筛选与 while 状态步进的典型用法:
# for 循环示例:结合 range 与 enumerate 进行元素过滤
raw_metrics = [12, 0, 45, 99, 105, 30]
valid_metrics = []

for idx, metric in enumerate(raw_metrics):
    if metric == 0:
        continue  # 跳过无效的0值样本
    if metric > 100:
        print(f"检测到异常超限数值 {metric}(位于索引 {idx}),提前终止扫描。")
        break     # 遇到超出阈值的值立即阻断
    valid_metrics.append(metric)
else:
    print("所有指标均在安全测量范围内。")

print(f"已收集的合规指标: {valid_metrics}")

# while 循环示例:阈值收敛计算
voltage = 12.0
decay_rate = 0.85
step_counter = 0

while voltage > 5.0:
    voltage *= decay_rate
    step_counter += 1

print(f"经过 {step_counter} 次衰减后,电压降至安全阈值以下: {voltage:.2f}V")已收集的合规指标: [12, 45, 99]
经过 6 次衰减后,电压降至安全阈值以下: 4.52V
三、函数定义、参数传递与作用域
函数是组织好的、可重复调用的代码块。它将复杂的逻辑封装在黑盒内部,通过定义清晰的输入参数和返回值,实现代码复用并降低系统耦合度。
1. def 声明语法与参数分类
Python使用 def 关键字定义函数,紧跟函数名与圆括号包含的参数列表,末尾以冒号 : 结尾,函数体保持缩进。
- 位置参数:调用时必须按照定义顺序一一对应的参数。
- 默认参数:在定义时赋予默认值的形参(如
threshold=60.0)。调用时若不传参则采用该默认值。 - 返回值(return):通过
return将运算产物返回给调用方。若函数未书写return,默认返回None。当return后紧跟多个由逗号分隔的表达式时,Python会自动将其组装为元组返回。
2. 局部作用域与全局隔离
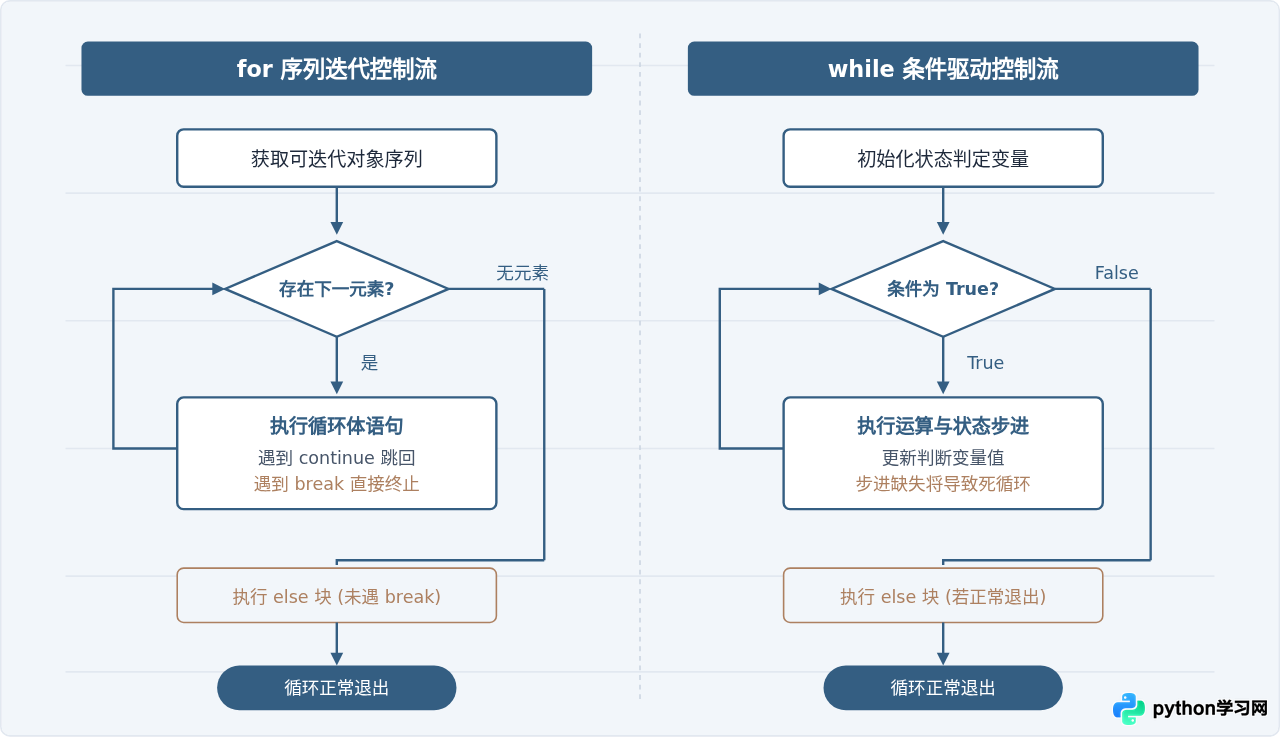
函数被调用时会创建一个独立的局部命名空间(Local Scope)。在函数体内声明的变量仅在函数生命周期内有效,外界无法直接访问。函数如果需要读取外部全局变量可以直接引用,但若要对全局变量重新赋值,需借助 global 关键字(工程中通常应尽量避免滥用全局变量,优先通过入参和返回值传递状态)。
以下示例展示了一个接收数据集与过滤阈值的统计函数,演示了默认参数、循环过滤与多值返回:
def calculate_statistics(numbers, threshold=0.0):
    """
    计算序列中高于指定阈值的数值之和及平均值。

    参数:
        numbers (list): 待统计的数值列表
        threshold (float): 过滤门限,默认为0.0

    返回:
        tuple: (符合条件的元素数量, 总和, 平均值)
    """
    filtered_items = []

    # 在局部作用域内使用循环进行数据收集
    for num in numbers:
        if num >= threshold:
            filtered_items.append(num)

    total_count = len(filtered_items)

    # 边界保护:防止除以0
    if total_count == 0:
        return 0, 0.0, 0.0

    total_sum = sum(filtered_items)
    average = total_sum / total_count

    # 返回多个计算产物(打包为元组)
    return total_count, total_sum, average

# 调用示例:使用位置参数与默认参数
dataset = [-5.0, 12.5, 30.0, -1.2, 45.5]
count, total, avg = calculate_statistics(dataset, threshold=10.0)

print(f"入选样本数: {count}")
print(f"样本总和: {total:.2f}")
print(f"样本均值: {avg:.2f}")样本总和: 88.00
样本均值: 29.33
四、综合应用:三者协同实现成绩分析系统
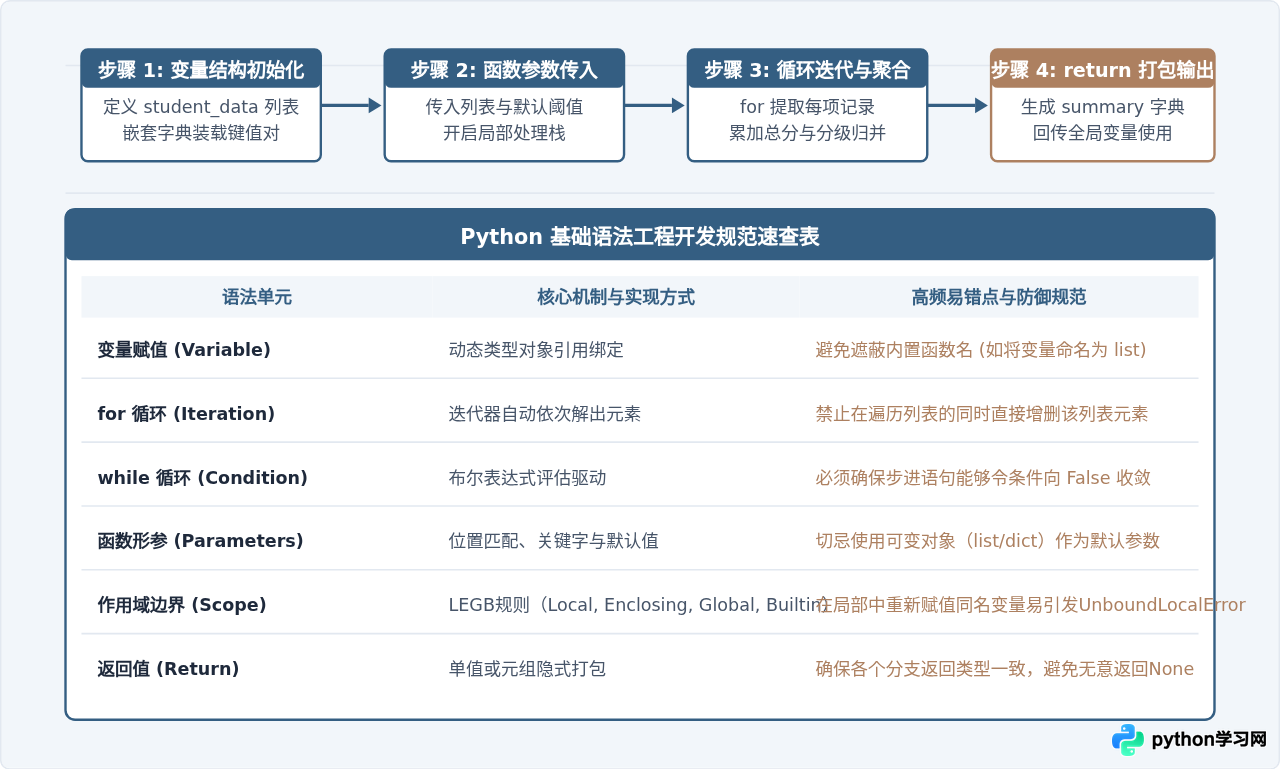
在实际项目开发中,变量、循环和函数通常不是孤立存在的。最标准的编程模式是:使用变量存储输入数据和控制状态,使用函数封装业务逻辑,使用循环处理集合元素与状态更新。
下面通过一个完整的“成绩分析与评级”程序,演示如何组织这三者:
- 定义数据变量:构建包含多名学生姓名及单科分数的字典列表。
- 定义分析函数:封装单名学生的等级评定函数,以及针对全体学生的综合统计函数。
- 运用循环处理:在函数内部使用
for循环计算总分并分类统计,使用字典记录等级分布。
def assign_grade(score):
    """根据分数返回对应的评级等级"""
    if score >= 90:
        return "优秀"
    elif score >= 75:
        return "良好"
    elif score >= 60:
        return "及格"
    else:
        return "不合格"

def analyze_student_records(records, pass_mark=60):
    """
    分析学生成绩列表,统计平均分及等级分布。
    """
    total_score = 0
    grade_distribution = {"优秀": 0, "良好": 0, "及格": 0, "不合格": 0}
    failed_students = []

    # 循环遍历记录集合
    for student in records:
        name = student["name"]
        score = student["score"]

        # 累加总分
        total_score += score

        # 调用辅助函数计算等级并更新统计字典
        grade = assign_grade(score)
        grade_distribution[grade] += 1

        # 记录不及格名单
        if score < pass_mark:
            failed_students.append(name)

    total_students = len(records)
    avg_score = total_score / total_students if total_students > 0 else 0.0

    return {
        "total_count": total_students,
        "average_score": round(avg_score, 2),
        "distribution": grade_distribution,
        "failed_list": failed_students
    }

# 业务数据变量
student_data = [
    {"name": "张伟", "score": 92},
    {"name": "李强", "score": 78},
    {"name": "王芳", "score": 58},
    {"name": "赵敏", "score": 88},
    {"name": "孙磊", "score": 63}
]

# 执行统计并输出结果
summary = analyze_student_records(student_data)

print(f"总参与人数: {summary['total_count']} 人")
print(f"全班平均分: {summary['average_score']} 分")
print("成绩等级分布:")
for grade_name, count in summary["distribution"].items():
    print(f"  - {grade_name}: {count} 人")
print(f"预警名单: {summary['failed_list']}")全班平均分: 75.8 分
成绩等级分布:
- 优秀: 2 人
- 良好: 1 人
- 及格: 1 人
- 不合格: 1 人
预警名单: ['王芳']
五、避坑指南:三类常见基础语法错误及排查方案
在函数定义中,默认参数的值是在函数定义时(模块加载阶段)计算并创建一次,而不是在每次调用时重新生成。如果将空列表 [] 或空字典 {} 等可变对象直接作为默认参数,多次调用将共享同一个对象,导致状态相互污染。
推荐解法:使用 None 作为占位哨兵值:
# 正确范式:使用 None 作为防御性默认值
def append_worker(task_id, task_list=None):
    if task_list is None:
        task_list = []
    task_list.append(task_id)
    return task_list
在 for item in my_list: 循环体内直接执行 my_list.remove(item) 或 my_list.pop(),会导致列表底层索引错位,进而跳过后续元素引发逻辑疏漏。
推荐解法:优先使用列表推导式生成新列表,或遍历原列表的浅拷贝(my_list.copy() 或 my_list[:])。
如果函数内部存在对某个变量名赋值的语句(例如 counter += 1),Python解析器会将该变量整体判定为局部变量。如果在该赋值语句之前尝试读取该变量,且局部命名空间尚未对其绑定,就会抛出 UnboundLocalError: local variable referenced before assignment。
推荐解法:明确变量是局部持有还是全局引用,若需读写外部状态,显式通过参数传入并由 return 产出。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









