

C语言中怎么调用Python函数并处理返回值
详细介绍在C语言中利用Python官方C API嵌入解释器、导入脚本模块、构造参数、调用Python函数并安全解析各种返回值与管理内存引用计数的完整实用指南。
在高性能计算、系统底层工具或已有 C/C++ 业务工程中,直接调用 Python 编写的模型、算法或业务脚本是一种非常实用的跨语言混合编程方式。C 语言调用 Python 函数并获取返回值的标准途径是使用 Python 官方原生提供的 C API(嵌入式 Python,Embedding Python)。通过初始化解释器上下文、导入目标模块、构造参数元组、执行函数调用,并将返回的 PyObject* 解析为 C 语言原生数据类型,即可无缝打通两种语言的数据链路。
一、整体调用流程与核心生命周期
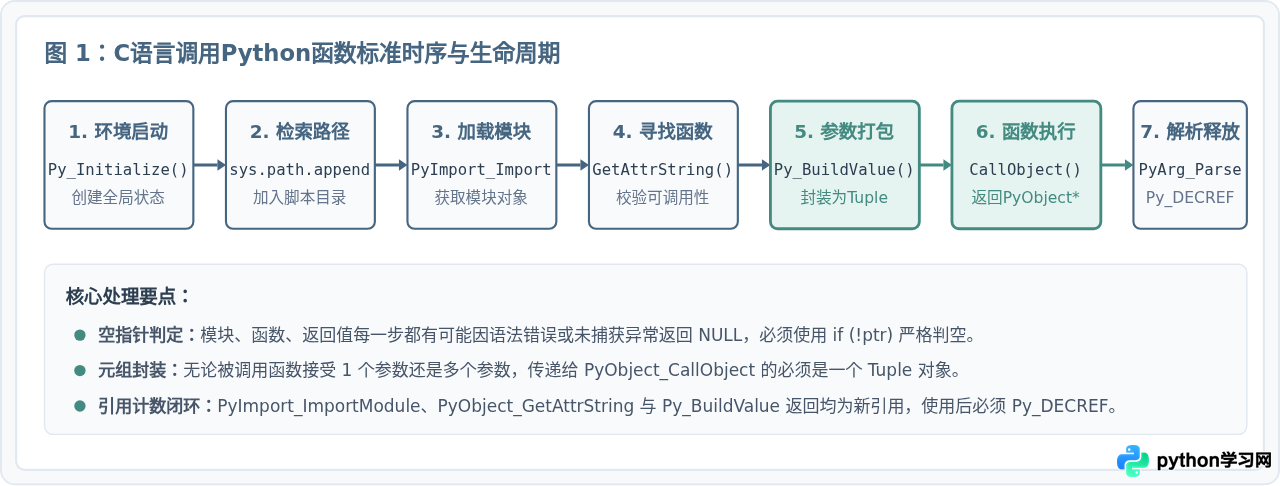
C 语言与 Python 的交互遵循明确的状态机模型。在 C 程序中,所有的 Python 数据和函数均以统一的不透明指针 PyObject* 形式存在。完成一次函数调用包含七个标准阶段:
- 初始化解释器:通过
Py_Initialize()启动 Python 虚拟机环境。 - 配置模块路径:将当前目录或脚本所在路径挂载到 Python 的
sys.path中。 - 导入脚本模块:使用
PyImport_ImportModule()加载目标.py文件。 - 提取目标函数:使用
PyObject_GetAttrString()找到函数对象并校验其可调用性。 - 打包入参元组:Python C API 要求参数统一置于元组中,使用
PyTuple_New()或Py_BuildValue()构建入参。 - 发起调用并捕获异常:通过
PyObject_CallObject()触发执行,并检查返回指针与错误栈。 - 解析返回值与资源回收:通过
PyArg_Parse()提取 C 原生数据,并依次回退释放引用计数(Py_DECREF)。
二、编译与开发环境准备
在编写 C 代码前,必须安装包含开发头文件与静态/动态库的 Python 运行时(例如 Linux 上的 python3-dev 或 macOS 自带的 Python framework)。在源文件开头引入头文件时,有一条至关重要的规则:
#include <Python.h> 必须放在所有标准系统头文件(如 stdio.h、stdlib.h)之前。因为 Python 定义了若干影响系统预处理行为的底层宏(如 _GNU_SOURCE、_POSIX_C_SOURCE),放在后面可能导致宏重定义冲突。
编译时不需要手动记忆复杂的头文件路径和链接参数,可以直接通过官方工具 python3-config 动态生成:
# 查看编译选项(包含头文件路径)
python3-config --cflags --embed

# 查看链接选项(包含库路径和 -lpython3.x)
python3-config --ldflags --embed

# 一键编译命令示例
gcc -Wall -O2 call_py.c -o call_py $(python3-config --cflags --embed) $(python3-config --ldflags --embed)
注意:在 Python 3.8 及更新版本中,作为嵌入式宿主程序编译时,必须携带 --embed 参数,否则只会生成用于编写 C 扩展模块的标志,导致链接时出现 undefined reference to Py_Initialize 等错误。
三、核心 API 详解与数据类型转换
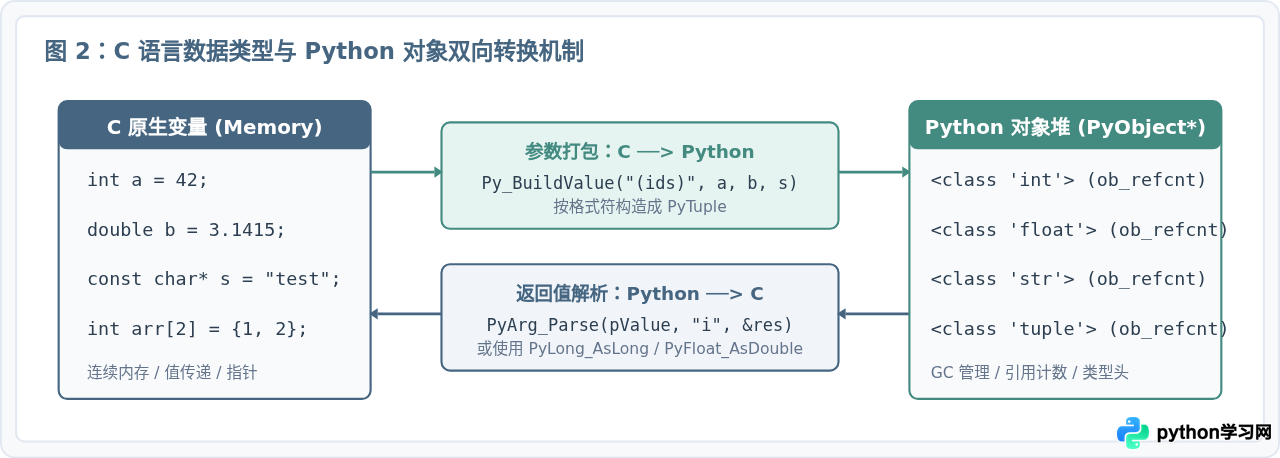
C 语言中调用 Python 函数的核心在于两个方向的数据转换:将 C 变量打包为 Python 对象作为实参,以及将返回的 Python 对象解包为 C 变量。
1. 常用格式化字符对应表
Py_BuildValue 和 PyArg_Parse 依靠格式化字符串识别类型。常用的格式符对齐如下:
| 格式化字符 | C 原生类型 | 对应 Python 类型 | 说明与场景 |
|---|---|---|---|
i |
int |
int |
标准整型 |
l |
long |
int |
长整型(在 Python 3 中统一为 int) |
d |
double |
float |
双精度浮点数 |
f |
float |
float |
单精度浮点数 |
s |
const char* |
str |
UTF-8 编码的以 \0 结尾字符串 |
(ii) |
两个 int 变量 |
tuple |
圆括号表示封装/解包元组 |
[ii] |
两个 int 变量 |
list |
方括号表示构造列表 |
O |
PyObject* |
任意 Python 对象 | 直接传递对象指针(会递增引用计数) |
四、完整实战代码:编写 Python 模块与 C 宿主
下面通过一个完整且经过工程级异常校验的示例,演示如何调用 Python 函数并处理标量返回值和元组复合返回值。
1. 编写被调用的 Python 脚本 (calc_service.py)
# calc_service.py
# 该脚本包含两个典型的函数:数值加法与复合信息处理

def add_numbers(a: int, b: int) -> int:
    """接收两个整型,返回它们的和"""
    return a + b

def process_user_record(user_id: int, name: str, score: float):
    """接收混合类型参数,返回一个包含计算结果与状态的元组"""
    is_passed = score >= 60.0
    summary = f"ID={user_id}, Name={name}, Score={score:.1f}, Passed={is_passed}"
    # 返回: (状态布尔码, 汇总文本, 加权计算值)
    return (1 if is_passed else 0, summary, score * 1.05)
2. 编写 C 宿主调用程序 (main.c)
#include <Python.h>
#include <stdio.h>
#include <stdlib.h>

int main(int argc, char *argv[]) {
    // 1. 初始化 Python 解释器
    Py_Initialize();
    if (!Py_IsInitialized()) {
        fprintf(stderr, "错误: 初始化 Python 解释器失败\n");
        return 1;
    }

    // 2. 将当前目录 "." 加入 sys.path,以便找到同目录下的 calc_service.py
    PyRun_SimpleString("import sys");
    PyRun_SimpleString("sys.path.append('.')");

    // 3. 导入模块 calc_service
    PyObject *pModuleName = PyUnicode_DecodeFSDefault("calc_service");
    PyObject *pModule = PyImport_Import(pModuleName);
    Py_DECREF(pModuleName); // pModuleName 不再使用,释放引用

    if (pModule == NULL) {
        PyErr_Print();
        fprintf(stderr, "错误: 无法加载模块 calc_service.py\n");
        Py_Finalize();
        return 1;
    }

    // ==========================================
    // 场景 A:调用单返回值函数 add_numbers(a, b)
    // ==========================================
    printf("--- [场景 A] 调用 add_numbers ---\n");
    PyObject *pFuncAdd = PyObject_GetAttrString(pModule, "add_numbers");

    if (pFuncAdd && PyCallable_Check(pFuncAdd)) {
        // 构建参数元组: (100, 250)
        PyObject *pArgs = Py_BuildValue("(ii)", 100, 250);

        // 调用函数
        PyObject *pValue = PyObject_CallObject(pFuncAdd, pArgs);
        Py_DECREF(pArgs); // 传递完毕后,释放参数元组引用

        if (pValue != NULL) {
            // 解析整型返回值
            long result = 0;
            if (PyArg_Parse(pValue, "l", &result)) {
                printf("C 语言接收到的运算结果: %ld\n", result);
            } else {
                fprintf(stderr, "解析返回值失败\n");
            }
            Py_DECREF(pValue); // 释放返回值对象引用
        } else {
            PyErr_Print();
            fprintf(stderr, "函数 add_numbers 调用失败\n");
        }
        Py_DECREF(pFuncAdd);
    } else {
        if (PyErr_Occurred()) PyErr_Print();
        fprintf(stderr, "未找到可调用函数 add_numbers\n");
    }

    // ==========================================
    // 场景 B:调用返回复合元组的函数 process_user_record
    // ==========================================
    printf("\n--- [场景 B] 调用 process_user_record ---\n");
    PyObject *pFuncProcess = PyObject_GetAttrString(pModule, "process_user_record");

    if (pFuncProcess && PyCallable_Check(pFuncProcess)) {
        // 构造三元参数: int, string, double
        PyObject *pArgs = Py_BuildValue("(isd)", 1001, "Alice", 85.5);

        PyObject *pValue = PyObject_CallObject(pFuncProcess, pArgs);
        Py_DECREF(pArgs);

        if (pValue != NULL) {
            // 解析元组返回值: (int, string, double)
            int statusCode = 0;
            const char *summaryText = NULL;
            double weightedScore = 0.0;

            if (PyArg_ParseTuple(pValue, "isd", &statusCode, &summaryText, &weightedScore)) {
                printf("解析元组成功:\n");
                printf("  状态码: %d\n", statusCode);
                printf("  描述文本: %s\n", summaryText);
                printf("  加权得分: %.2f\n", weightedScore);
            } else {
                PyErr_Print();
                fprintf(stderr, "元组解包失败\n");
            }
            Py_DECREF(pValue);
        } else {
            PyErr_Print();
        }
        Py_DECREF(pFuncProcess);
    }

    // 4. 清理模块并关闭解释器
    Py_DECREF(pModule);
    Py_Finalize();

    return 0;
}
3. 编译与执行结果验证
将上述两个文件放在同一目录下执行编译与运行:
# 编译源码
gcc -Wall -O2 main.c -o main $(python3-config --cflags --embed) $(python3-config --ldflags --embed)

# 执行程序
./main
终端期望的标准输出如下(示例):
--- [场景 A] 调用 add_numbers ---
C 语言接收到的运算结果: 350

--- [场景 B] 调用 process_user_record ---
解析元组成功:
  状态码: 1
  描述文本: ID=1001, Name=Alice, Score=85.5, Passed=True
  加权得分: 89.78
五、常见数据类型的解析方法精析
在实际业务中,Python 函数可能返回字典(dict)、列表(list)或空值(None)。针对不同的返回类型,处理方式有所不同:
1. 处理单值原生对象类型转换
除了通用的 PyArg_Parse,使用专用的类型转换函数往往更为直接且不易出错:
- 整型:
long val = PyLong_AsLong(pValue); - 浮点数:
double val = PyFloat_AsDouble(pValue); - 字符串:
const char *str = PyUnicode_AsUTF8(pValue);(返回的char*指针指向内部缓冲区,不应手动free,且在pValue有效期内有效)。 - 布尔型:
int flag = PyObject_IsTrue(pValue);(返回 1 为真,0 为假,-1 表示错误)。
2. 处理列表 (List) 与字典 (Dict)
当 Python 函数返回列表时,可以通过索引迭代:
if (PyList_Check(pValue)) {
    Py_ssize_t size = PyList_Size(pValue);
    for (Py_ssize_t i = 0; i < size; i++) {
        PyObject *item = PyList_GetItem(pValue, i); // 返回 Borrowed Reference
        long num = PyLong_AsLong(item);
        printf("List[%zd] = %ld\n", i, num);
    }
}
当返回字典时,可通过键名直接查询:
if (PyDict_Check(pValue)) {
    PyObject *keyVal = PyDict_GetItemString(pValue, "status"); // Borrowed Reference
    if (keyVal != NULL) {
        printf("dict['status'] = %ld\n", PyLong_AsLong(keyVal));
    }
}
3. 处理 None 返回值
Python 中无显式 return 的函数默认返回 None。在 C API 中,None 对应全局单例 Py_None:
if (pValue == Py_None) {
    printf("函数无有效返回值 (返回了 None)\n");
}
六、内存安全与引用计数管理
内存管理是 C 嵌入 Python 时最容易发生段错误(Segmentation Fault)或内存泄漏的地方。Python 采用引用计数器跟踪对象的生命周期。当引用计数降至 0 时,对象被析构。
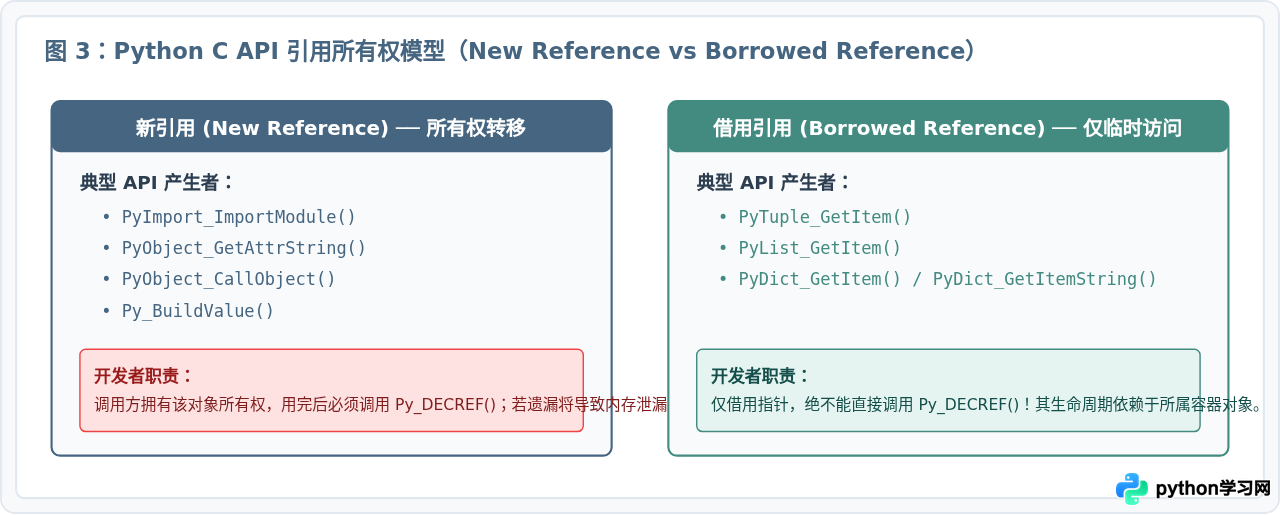
牢记两个准则:
- 谁创建谁释放(New Reference):凡是通过构造函数或查询属性获得的新引用,在宿主作用域结束时必须配对调用
Py_DECREF(obj);如果不确定指针是否为NULL,建议使用宏Py_XDECREF(obj)(内部会先执行空指针校验)。 - 切勿释放借来之物(Borrowed Reference):使用
PyTuple_GetItem或PyDict_GetItemString获取的元素属于借用引用。对其执行Py_DECREF会导致容器内部指针变成野指针,随后在访问容器或容器销毁时引发段错误。
七、常见故障排查与运行期安全检查
在实际开发与测试过程中,初学者最常遇到三类典型错误:
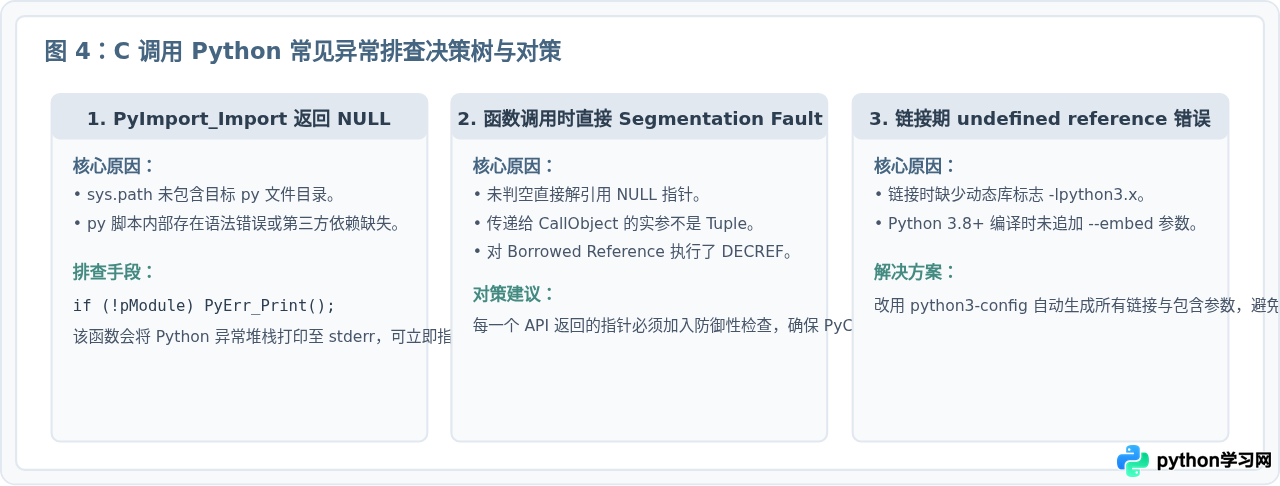
落地核对清单 (Checklist)
- 头文件顺序:确保
#include <Python.h>在全部标准库头文件前声明。 - 路径设置:脚本不在默认全局模块目录时,务必通过
sys.path.append()添加脚本目录。 - 参数封包:无参数传递
NULL或PyTuple_New(0);有参数时必须封装为PyTuple。 - 逐级判空:对模块、函数、参数元组、调用结果执行严格非空校验。
- 异常诊断:任意 API 返回
NULL时,立即调用PyErr_Print()输出 Python 层面的详细错误信息。 - 引用平衡:严格区分新引用与借用引用,对所有新产生的
PyObject*实施及时的Py_DECREF(),避免生产环境长时间运行引发内存泄漏。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









