

为什么不建议在生产环境使用Python在线解析器?
在生产环境中引入在线或远程Python解析器(包括各类云端沙箱执行API、在线交互式REPL后端及第三方动态代码求值服务),本质上是将系统的核心计算流程与未受控的外部动态环境绑定。这样做会直接打破安全防护边界,引入致命的远程代码执行(RCE)与沙箱逃逸漏洞,同时由于网络往返导致请求延迟不可控、容器生命周期短暂而丢失运行时状态,最终导致生产服务陷入极高的安全与可用性风险中。
一、核心架构风险:外部依赖与信任链断裂
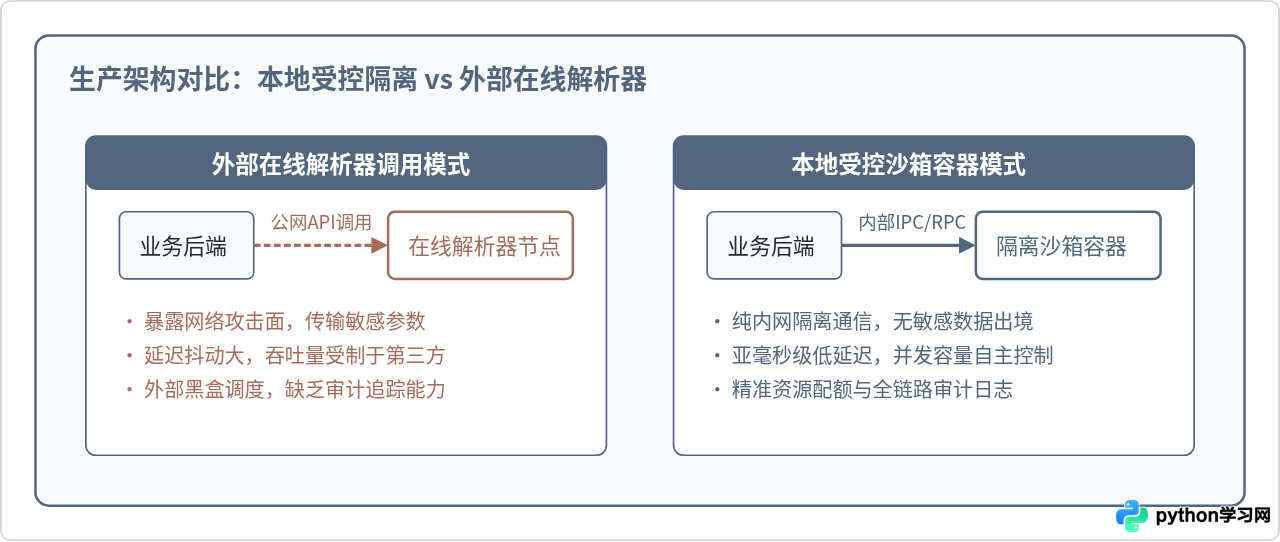
在开发或调试阶段,很多团队为了省去配置运行时和依赖包的繁琐步骤,或者为了让系统具备动态计算表达式的能力,会尝试调用第三方在线Python解析服务或公网托管的沙箱。这种做法在本地演示中行之有效,但在生产架构中却引入了单点灾难。
生产环境强调“确定性”、“可审计”与“最小授权”。当业务请求依赖公网上的在线解析节点时,每一次计算都要跨越公网防火墙,你的业务核心数据被明文传输给第三方,而第三方的计算节点对你的系统而言完全处于“黑盒”状态。一旦解析服务中断、限流或受到外部攻击,下游核心业务将直接瘫痪。
二、无法根除的安全隐患:沙箱逃逸与代码执行
在线解析器通常需要执行动态输入的Python语句。在Python的动态对象模型中,完全限制恶意行为极其困难。很多在线解析器声称有“内建安全沙箱”,但实际上仅过滤了 import os 或移除了 __builtins__ 中的常见函数。这类机制在Python强大的元类机制和内省机制面前形同虚设。
攻击者可以通过查找全局类层次结构,轻松绕过简易过滤机制,重新实例化危险模块:
# 示例:通过类内省机制绕过基础关键字过滤获取敏感执行上下文
[c for c in ().__class__.__bases__[0].__subclasses__() if c.__name__ == 'catch_warnings'][0]()._module.__builtins__['__import__']('os').system('id')
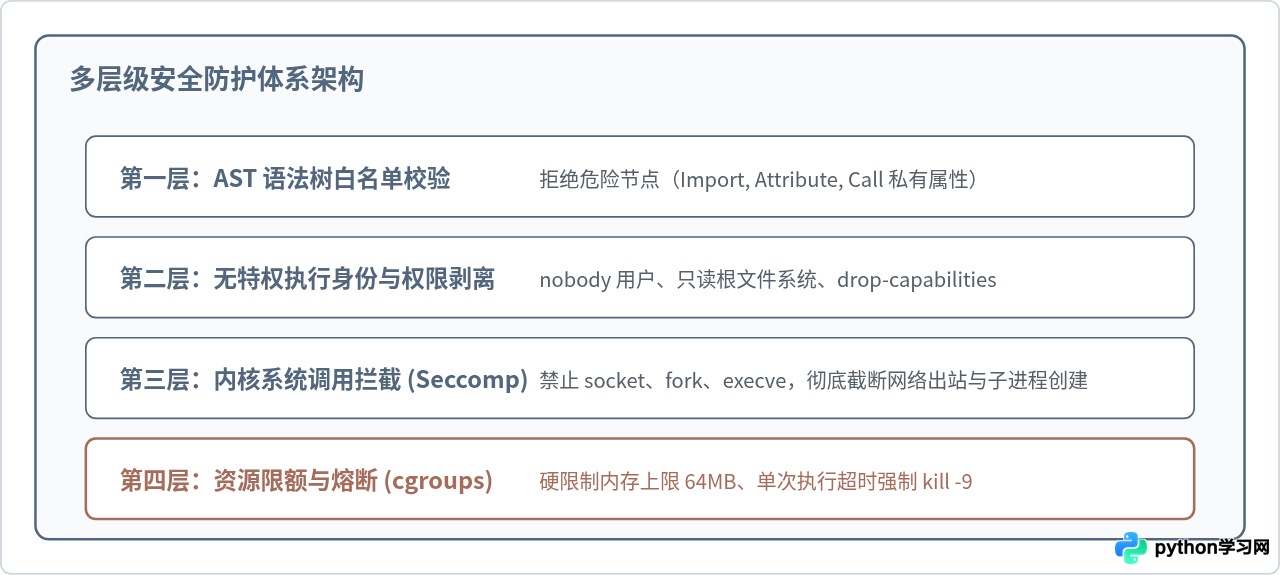
如果该在线解析器与生产系统共享凭据或处于内网互通网络,攻击者就能借助解析器作为跳板,窃取生产数据库密钥、环境变量或云平台元数据(Instance Metadata)。在生产环境中,任何允许执行不可控代码的地方,都必须依赖内核级别的严格隔离(如 gVisor、Firecracker 微虚拟机或 seccomp 限制系统调用),而通用在线解析器往往不具备针对特定业务场景定制安全边界的能力。
三、性能瓶颈与状态缺陷:延迟抖动与冷启动
生产环境对接口响应时间(P99延迟)有极高要求。在线解析器往往采用无状态弹性设计,每次执行代码可能会触发一次远程容器创建或微虚拟机挂载,这带来了无法忽视的性能损耗:
- 网络RTT开销:每次执行均需经过公网握手、请求序列化、数据解密,网络延迟通常在几十毫秒到上千毫秒不等,远高于本地解析的亚毫秒级。
- 运行时状态丢失:在线解析器的容器通常是瞬态的,代码执行完毕后环境立即销毁。如果在循环或多步骤处理中需要保留全局对象或缓存计算结果,在线解析器必须频繁来回传递大量序列化数据,极大消耗带宽。
- 冷启动与限流:第三方平台为了保障多租户公平调度,会对并发数、执行时间实施严格配额限制。在业务高峰期,请求很容易直接触发 HTTP 429(Too Many Requests)或遭遇冷启动排队,引发雪崩。
四、标准替代方案:安全、确定的生产演进路径
如果业务确实需要支持用户自定义公式、规则引擎或安全代码求值,不应依赖公网在线解析器,而应采用“需求分流、分级受控”的标准工程落地步骤:
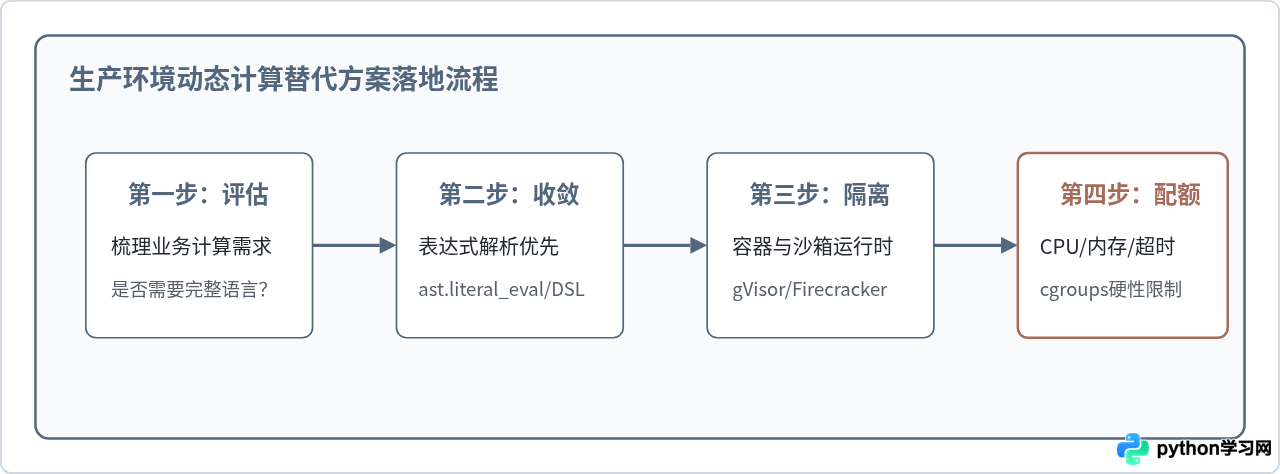
具体实施过程中,可按以下层次替换在线解析器:
- 简单数值与数据求值:使用内置安全解析
若只是解析配置字典或数学常数,使用 Python 原生ast.literal_eval替代危险的动态执行,从根源消除任意方法调用风险。import ast # 安全解析结构化数据,拒绝任意代码执行 raw_input = "{'rate': 0.15, 'base': 1000}" safe_config = ast.literal_eval(raw_input) result = safe_config['base'] * safe_config['rate'] - 业务公式计算:采用专用受限 DSL
对于业务人员自配置的佣金、折扣公式,采用如simpleeval或基于 AST 自建的解释器。只开放指定白名单函数(如max、min、round),严禁访问__class__与底层属性。 - 不可避免的完整脚本执行:自建轻量级隔离计算集群
针对代码评测(OJ)或自动化数据报表这类必须运行完整 Python 脚本的需求,在内网部署基于微虚拟化(如 Firecracker、gVisor)的执行代理。通过独立的无状态 Worker 节点运行脚本,执行节点与业务网段实行物理网络隔离,禁止出站流量,并施加严格的 CPU、内存和执行时间上限。
五、多维度对比与总结
为了帮助架构选型,下表直观总结了公网在线解析器与本地受控方案在核心工程指标上的差异:
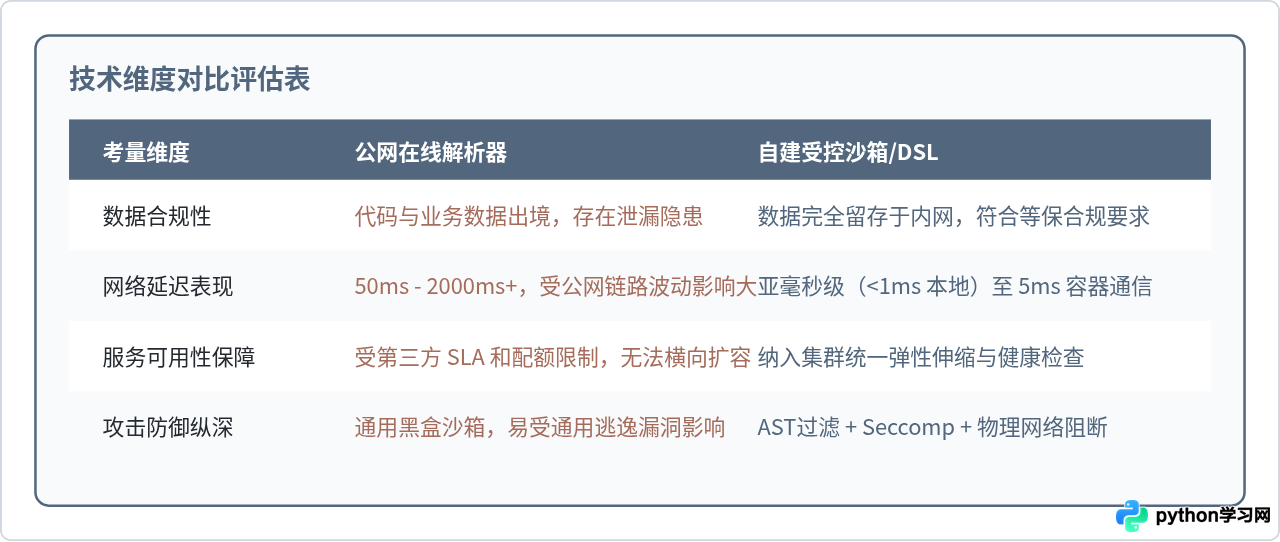
总结:在线Python解析器是学习、测试与验证原型的利器,但它与生产环境所要求的稳定性、低延迟和可防御性背道而驰。生产架构应秉持“最小特权”与“受控计算”原则,优先使用受限表达式引擎,对于完整脚本则构建内网微虚拟化沙箱,坚决杜绝在关键业务链路中引入公网在线解析器。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









