

Python str.replace、re.sub与str.translate性能对比及选型建议

Python 中做字符串替换最常用的三个工具是 str.replace、re.sub 和 str.translate。三者在底层实现、调用开销和擅长的替换模式上各不相同。本文通过具体场景和基准数据说明它们的性能差异,最后给出按场景选型的简要判断表。
一、三种方法的基本用法
1. str.replace
str.replace(old, new[, count]) 是最简单的字符串替换方法,将所有匹配的子串替换为新字符串,可选参数 count 限制替换次数。
text = "hello world, hello python"
result = text.replace("hello", "hi")
# 'hi world, hi python'
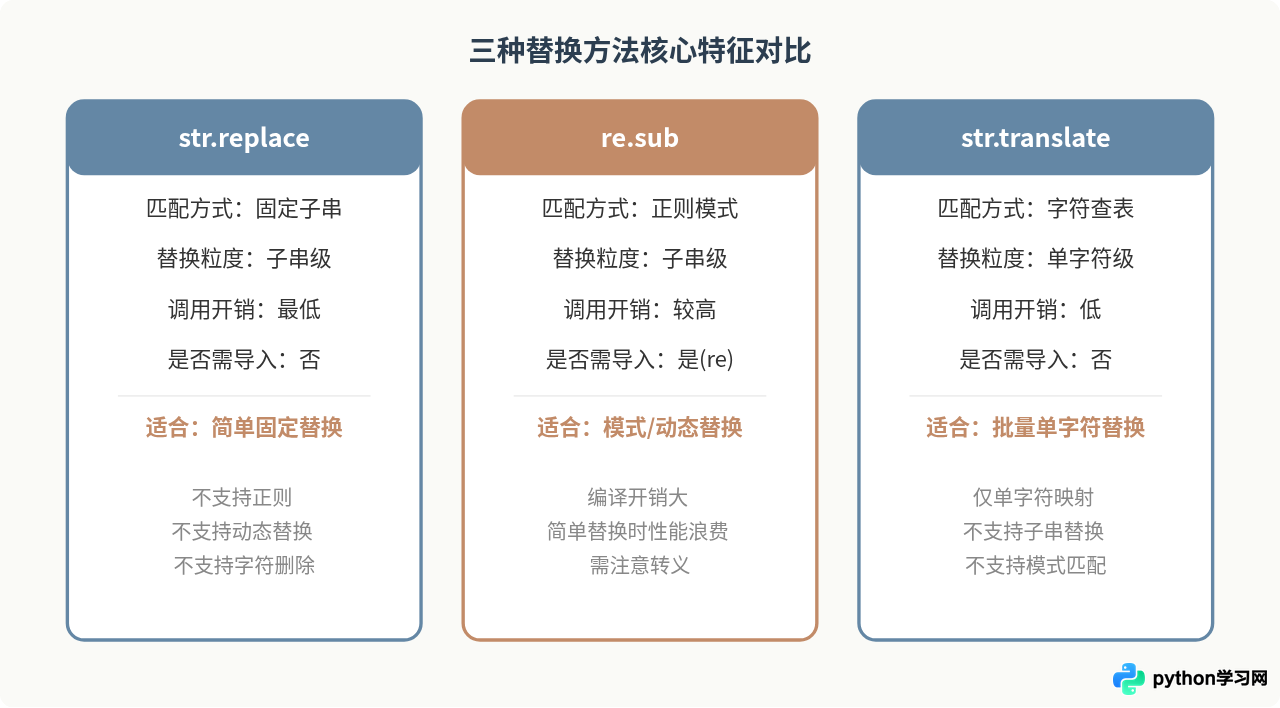
它是纯 C 实现的内置方法,不需要额外导入,调用开销最低。但它只能做固定字符串的精确匹配,不支持模式或条件替换。
2. re.sub
re.sub(pattern, repl, string, count=0, flags=0) 使用正则表达式匹配并替换。repl 可以是字符串,也可以是一个接收 match 对象的函数。
import re
text = "价格: 100元, 折扣: 20元"
result = re.sub(r'\d+', lambda m: str(int(m.group()) * 2), text)
# '价格: 200元, 折扣: 40元'正则引擎的编译和匹配过程比固定字符串查找复杂得多,即使替换的是固定子串,re.sub 的开销也远高于 str.replace。但它能处理模式匹配、分组引用和动态替换,是三者中功能最强的。
3. str.translate
str.translate(table) 根据映射表对每个字符做一对一替换或删除。映射表通常用 str.maketrans 生成。
table = str.maketrans("aeiou", "12345")
text = "education"
result = text.translate(table)
# '2d5c1t34n'它的特点是按单个字符查表替换,一次遍历就能完成多个字符的替换或删除。当需要同时替换大量不同的单字符时,str.translate 远快于多次调用 str.replace。但它只能处理字符级映射,不能替换子串。
二、性能差异的根本原因
三者之间的性能差异不是简单的"谁快谁慢",而是取决于替换任务的类型。理解底层机制才能做出正确选择。
str.replace 为什么最快
str.replace 的实现在 CPython 中是纯 C 代码。它使用优化的子串搜索算法(基于 Boyer-Moore 和 Horspool 的变体)直接扫描字节,找到匹配后复制替换内容到新字符串。整个过程没有正则编译、没有 Python 层函数调用、没有字符映射查表,是三者中路径最短的。
re.sub 的开销来自哪里
re.sub 每次调用时需要经历:正则表达式编译(如果没有预编译)→ 构建有限自动机 → 逐步匹配输入字符串 → 对每个匹配构建 match 对象 → 执行替换。即使正则表达式就是一个固定字符串,这些步骤也不会跳过。与 str.replace 相比,固定字符串替换场景下 re.sub 通常慢 5 到 10 倍。
预编译(re.compile)可以省去重复编译的开销。在循环中反复使用同一个正则时,预编译是必要的优化。但即使预编译后,匹配过程本身仍然比固定字符串搜索慢。
str.translate 快在哪里
str.translate 对字符串做单次线性遍历,对每个字符查一次映射表(本质上是字典查找或数组索引),决定替换、删除还是保留。当需要同时替换 10 个不同字符时,str.translate 只遍历一次字符串,而用 str.replace 逐个替换则需要遍历 10 次。替换的字符种类越多,str.translate 的优势越明显。
三、基准测试对比
以下测试使用 Python 3.11,在一段包含 10000 个字符的文本上分别执行替换操作,用 timeit 取 10000 次执行的平均耗时。
场景 1:替换单个固定子串
将文本中所有的 "Python" 替换为 "Java"。
import timeit

text = "Python is great. " * 500  # 约9000字符

# str.replace
t1 = timeit.timeit(lambda: text.replace("Python", "Java"), number=10000)

# re.sub
import re
pattern = re.compile(r"Python")
t2 = timeit.timeit(lambda: pattern.sub("Java", text), number=10000)

# 示例结果
# str.replace:  0.18s
# re.sub:       1.02s
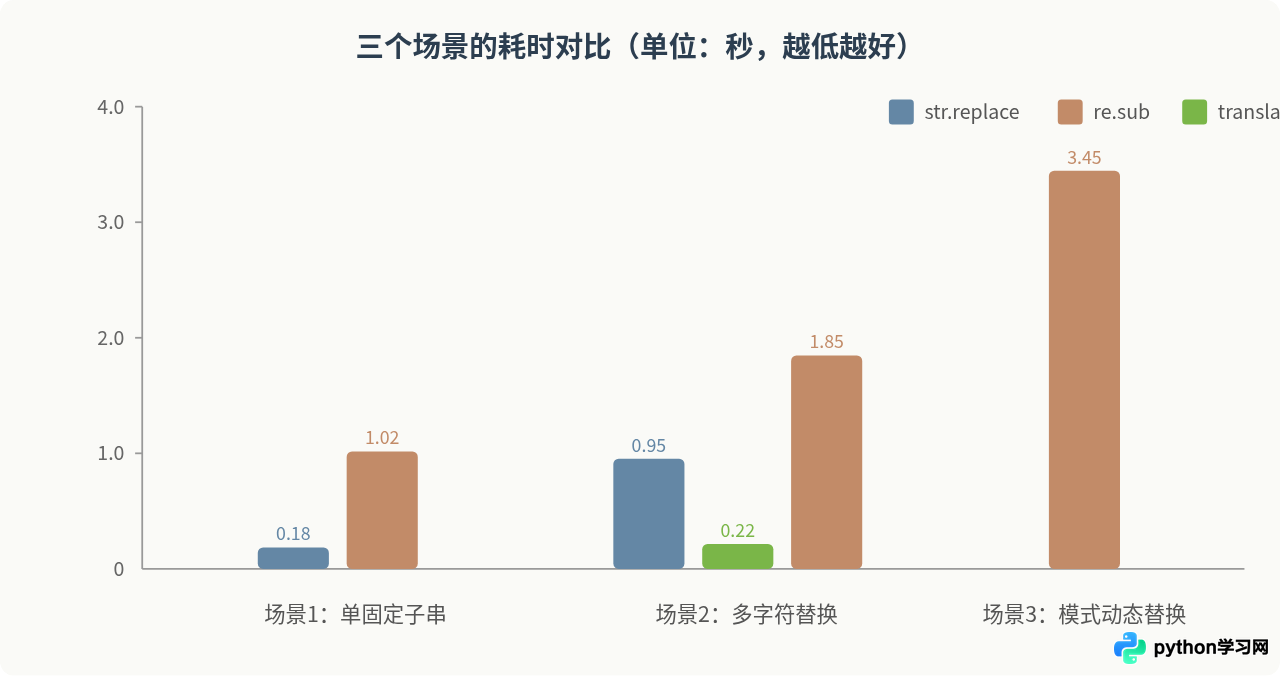
str.replace 约为 re.sub 速度的 5.7 倍。这是 str.replace 最擅长的场景。str.translate 不适用于子串替换,此场景不参与对比。
场景 2:同时替换多个单字符
将文本中的元音字母 a、e、i、o、u 全部删除。
text = "education is the most powerful weapon" * 250

# str.replace 链式调用
def replace_chain(s):
    for ch in "aeiou":
        s = s.replace(ch, "")
    return s
t1 = timeit.timeit(lambda: replace_chain(text), number=10000)

# str.translate
table = str.maketrans("", "", "aeiou")
t2 = timeit.timeit(lambda: text.translate(table), number=10000)

# re.sub
pattern = re.compile(r"[aeiou]")
t3 = timeit.timeit(lambda: pattern.sub("", text), number=10000)

# 示例结果
# str.replace(×5):  0.95s
# str.translate:     0.22s
# re.sub:            1.85s
str.translate 比链式 str.replace 快约 4.3 倍,比 re.sub 快约 8.4 倍。需要同时替换或删除的字符越多,str.translate 的优势越大。
场景 3:基于模式的动态替换
将文本中所有数字序列翻倍。
text = "item1 costs 50, item2 costs 120, total 170" * 200

pattern = re.compile(r"\d+")
t1 = timeit.timeit(
    lambda: pattern.sub(lambda m: str(int(m.group()) * 2), text),
    number=10000
)

# 示例结果
# re.sub:  3.45s
这种场景只有 re.sub 能完成。str.replace 无法做模式匹配,str.translate 无法处理子串或动态逻辑。
四、容易踩的性能陷阱
陷阱 1:用 re.sub 做固定字符串替换
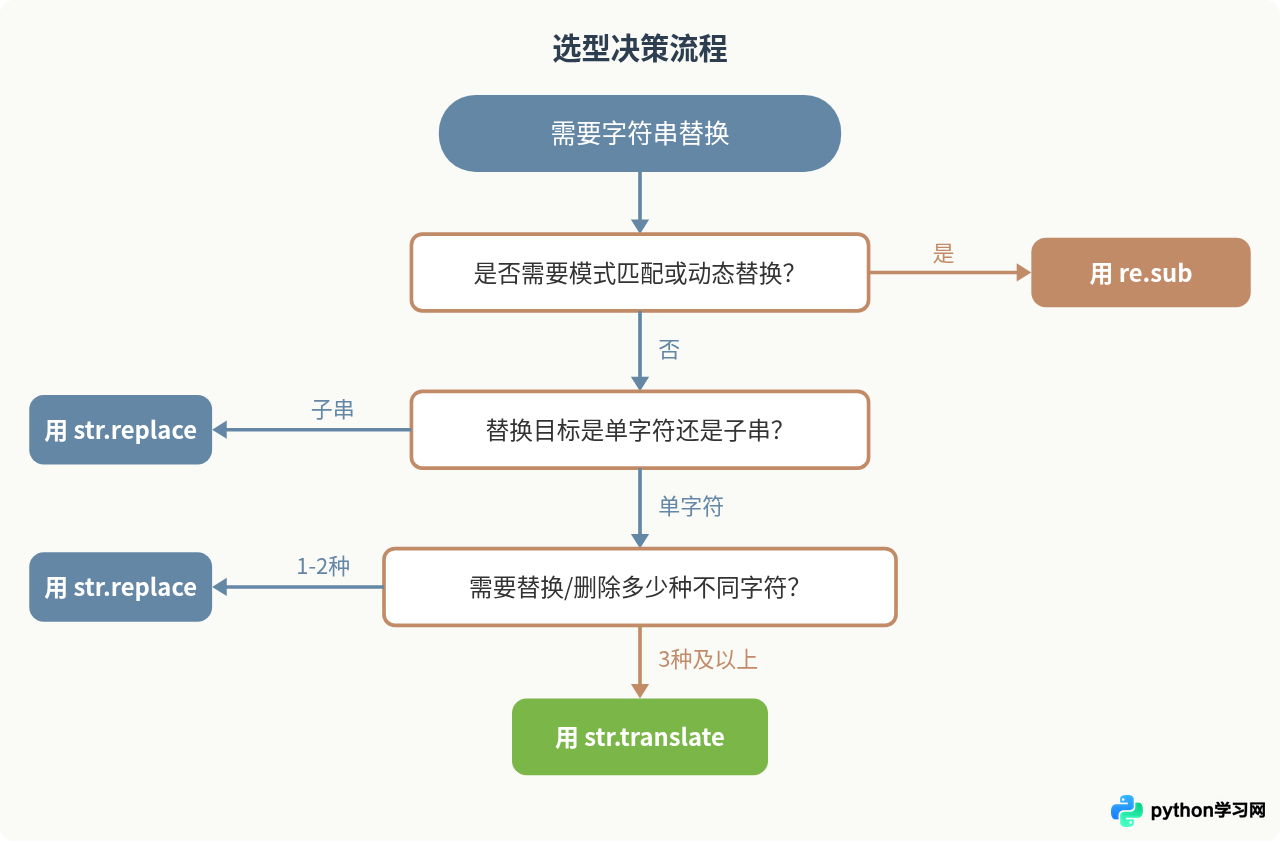
这是最常见的性能浪费。很多人习惯导入 re 后对所有替换都使用 re.sub,但当替换目标是固定字符串时,str.replace 在各种文本长度下都明显更快。只有当替换涉及模式匹配(通配符、字符类、量词等),re.sub 的额外开销才值得付出。
陷阱 2:链式 str.replace 替换大量字符
需要替换 20 个不同的标点符号时,用 20 次 str.replace 链式调用意味着字符串被遍历 20 次,每次都生成一个新的字符串对象。改用 str.translate 只需一次遍历。
# 不推荐:链式 str.replace
def clean_punctuation(text):
    for ch in ',.;:!?()[]{}@#&*':
        text = text.replace(ch, '')
    return text

# 推荐:str.translate
remove_table = str.maketrans('', '', ',.;:!?()[]{}@#&*')
def clean_punctuation(text):
    return text.translate(remove_table)
陷阱 3:循环内反复 re.compile
虽然 Python 的 re 模块内部有编译缓存(默认缓存最近 512 个模式),但在性能敏感的场景下,显式预编译仍然更可靠。
# 不推荐
for line in lines:
    result = re.sub(r'\d{4}-\d{2}-\d{2}', 'DATE', line)

# 推荐
date_pattern = re.compile(r'\d{4}-\d{2}-\d{2}')
for line in lines:
    result = date_pattern.sub('DATE', line)
陷阱 4:误用 str.translate 处理子串
str.translate 只能做字符到字符的映射,不能把 "abc" 这个子串替换为 "xyz"——它会把 a、b、c 分别映射为 x、y、z。如果需要替换多字符子串,必须使用 str.replace 或 re.sub。
五、进阶对比:预编译与文本长度的影响
预编译对 re.sub 的提升
不预编译时,re.sub 每次调用都要编译正则。对于简单模式,编译开销约占总耗时的 15%–30%。预编译后这部分开销只发生一次。但即使预编译,re.sub 处理固定字符串替换仍然比 str.replace 慢数倍,因为匹配引擎本身的开销无法消除。
文本长度的影响
三种方法的耗时都与文本长度近似线性增长,但斜率不同。对于极短字符串(几十个字符),三者差异不大,因为函数调用本身的固定开销占主导。当字符串长度超过几千字符后,底层扫描效率的差异开始显现,str.replace 和 str.translate 的优势变得明显。
特殊场景:大量不同子串替换
如果需要替换几十种不同的子串(不是单字符),str.replace 的链式调用效率会随替换种类线性下降。这时可以考虑用 re.sub 结合合并后的正则模式和字典映射:
replacements = {"apple": "苹果", "banana": "香蕉", "cherry": "樱桃"}
pattern = re.compile("|".join(re.escape(k) for k in replacements))
result = pattern.sub(lambda m: replacements[m.group()], text)
这种方式只遍历一次字符串,当替换种类超过 5–10 种时,通常比链式 str.replace 更快。
六、选型建议总结
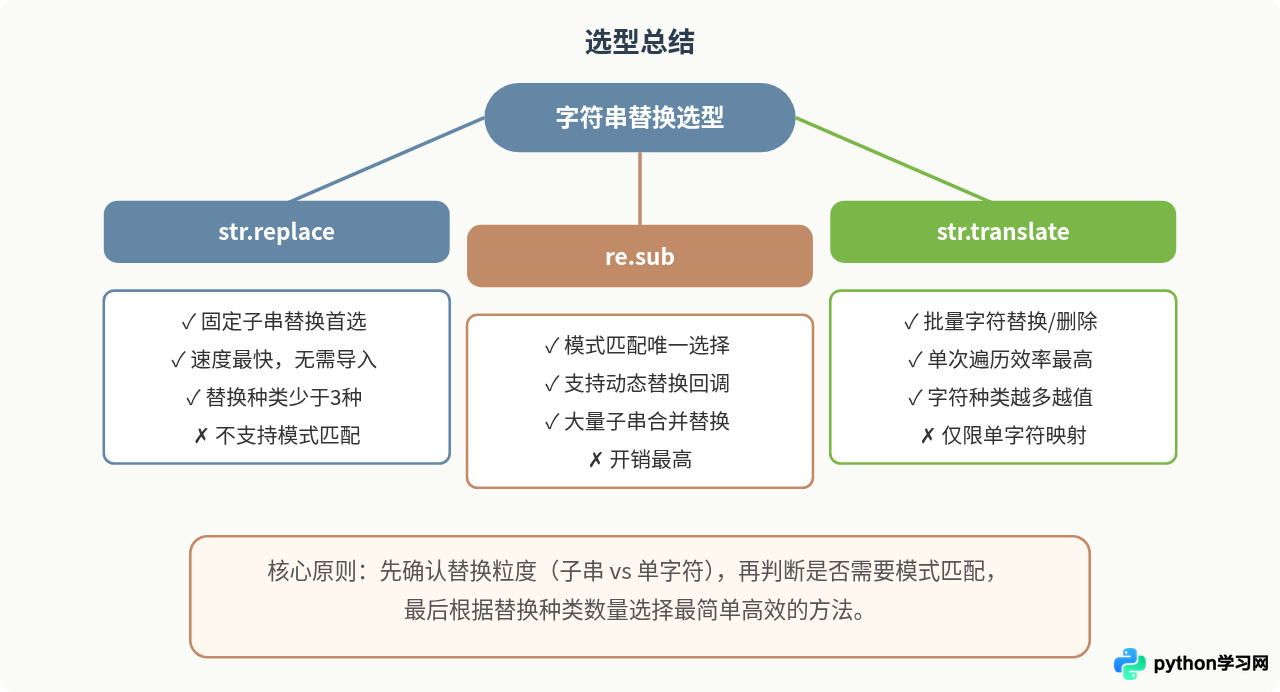
| 场景 | 推荐方法 | 原因 |
|---|---|---|
| 替换一个或几个固定子串 | str.replace | 开销最低,代码最简单 |
| 删除或替换多种单字符 | str.translate | 一次遍历完成全部映射 |
| 模式匹配替换 | re.sub | 唯一支持正则的选项 |
| 动态替换逻辑(函数作为 repl) | re.sub | repl 参数接受回调函数 |
| 大量不同子串替换(>5种) | re.sub + 合并模式 | 避免多次遍历 |
| 性能不敏感的简单脚本 | 任意 | 差异可忽略,选最易读的 |
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









