

Dify是什么:开源LLM应用开发平台核心功能解析

Dify 是一个开源的大语言模型(LLM)应用开发平台,提供从应用构建、模型接入到运营监控的完整工具链。它的核心思路是:让不同技术水平的人都能通过可视化界面和标准化组件,把 LLM 能力组装成可运行的应用,而不必从零编写大量胶水代码。本文将拆解 Dify 的核心功能模块,说明每个模块解决什么问题、如何运作,以及在实际使用中需要注意的关键细节。
Dify 的整体定位与架构概览
开发一个基于 LLM 的应用,通常需要处理几件事:选择并接入模型、编写 Prompt、管理上下文、对接知识库、监控运行效果。如果是复杂应用,还要编排多步推理流程、管理工具调用。Dify 把这些环节封装成平台内的独立模块,通过统一的 Web 界面和 API 对外提供服务。
从架构层面看,Dify 由以下几个核心层组成:
- 模型层:统一的模型接入接口,支持 OpenAI、Anthropic、本地部署的开源模型等数十种模型供应商。
- 编排层:可视化工作流编辑器和 Chatflow/Workflow 两种编排模式。
- 知识层:内置的 RAG(检索增强生成)引擎,处理文档导入、分段、索引和检索。
- Agent 层:支持 ReAct 和 Function Calling 两种策略的智能体框架。
- 运维层:日志、标注、用量统计等 LLMOps 功能。
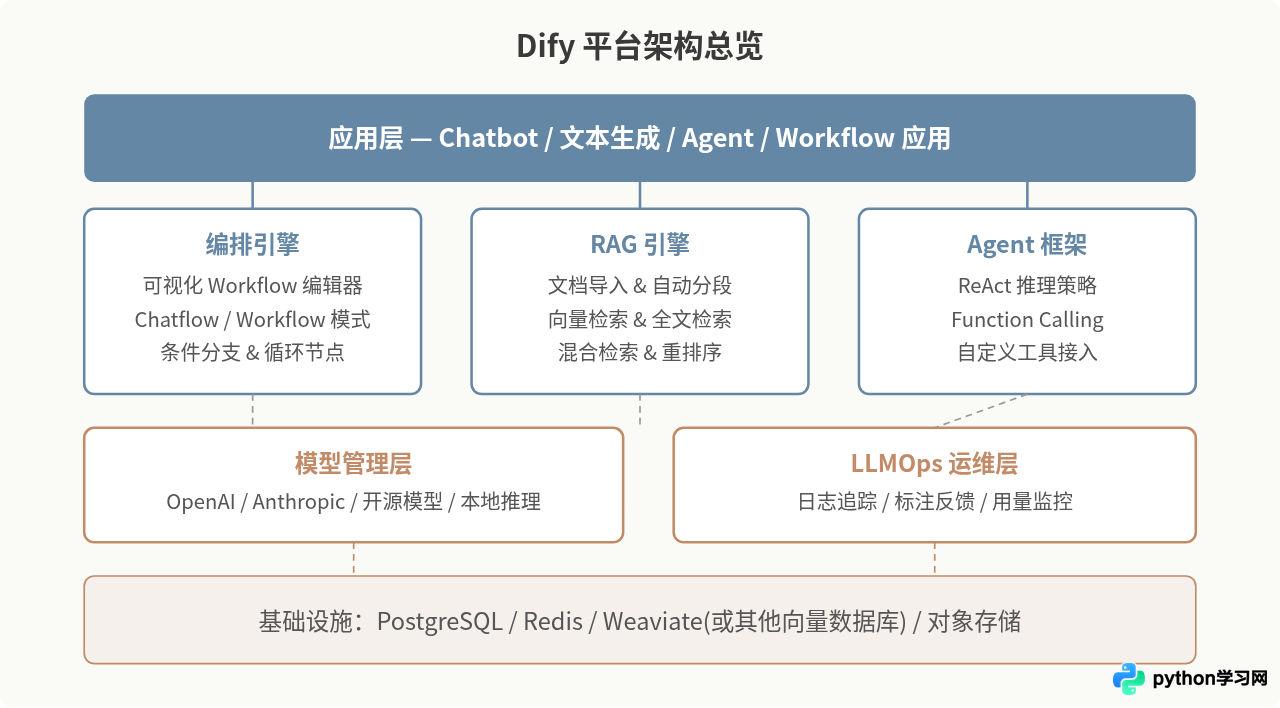
理解这张结构之后,我们逐个模块来看它们各自做了什么、怎么用。
可视化编排:Workflow 与 Chatflow
Dify 提供两种编排模式来构建应用逻辑:
Chatflow 面向对话类应用。它在一个多轮对话的框架内,允许你在"用户输入→模型回复"的主链路上插入额外的处理节点,比如知识检索、条件判断、代码执行。典型场景是客服机器人——用户发送消息后,先查知识库,再把检索结果和问题一起交给 LLM 生成回答。
Workflow 面向非对话的批处理或自动化任务。它没有内建的对话上下文,执行流程从"开始"节点出发,经过一系列处理节点,最终到达"结束"节点输出结果。适合文档摘要、数据提取、内容生成管线等场景。
两种模式共享同一套节点类型,包括:
- LLM 节点:调用大模型,可配置 Prompt 模板和参数。
- 知识检索节点:从已导入的知识库检索相关内容。
- 代码执行节点:运行 Python 或 JavaScript 代码段处理数据。
- 条件分支节点(IF/ELSE):根据变量值决定走哪条路径。
- HTTP 请求节点:调用外部 API。
- 变量聚合节点:合并多条分支的输出。
- 迭代节点:对数组类数据逐项执行相同的处理逻辑。
在编辑器中,你通过拖拽节点、连线、配置参数来完成整个流程的搭建。每个节点的输出可以作为下游节点的输入变量引用,变量名在连线时自动关联。
RAG 引擎:从文档到可检索知识
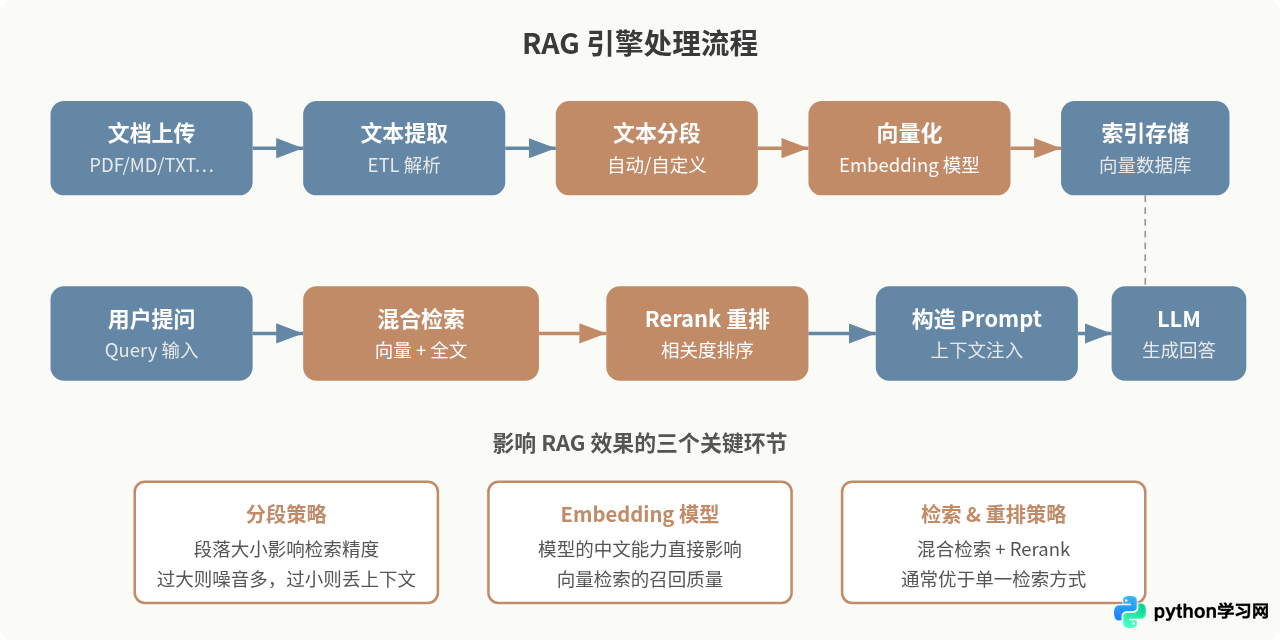
RAG(Retrieval-Augmented Generation)是目前让 LLM 回答特定领域问题最常用的方法。Dify 内置了完整的 RAG 流水线,覆盖文档导入、文本分段、向量化、索引存储和检索这几个环节。
文档导入支持 TXT、Markdown、PDF、HTML、DOCX、CSV 等格式。上传后,Dify 会自动提取文本内容。对于 PDF 等格式,Dify 提供了 ETL(提取-转换-加载)方案,包括内置的解析器和可选的第三方解析服务。
文本分段是 RAG 效果的关键。Dify 提供两种模式:
- 自动分段:按段落和固定长度自动切分,适合结构不规则的文档。
- 自定义分段:你指定分隔符(比如 Markdown 的标题标记),Dify 按规则切分。对于结构清晰的文档,这种方式能保证每段内容的语义完整性。
分段完成后,每个段落会通过 Embedding 模型(如 OpenAI 的 text-embedding-3-small)转换成向量,存入向量数据库。Dify 支持 Weaviate、Qdrant、Milvus、PGVector 等多种向量存储后端。
检索方式有三种可选策略:
| 检索方式 | 原理 | 适用场景 |
|---|---|---|
| 向量检索 | 计算查询与段落向量的相似度 | 语义匹配为主的场景 |
| 全文检索 | 基于关键词的倒排索引 | 专有名词、编号等精确匹配场景 |
| 混合检索 | 同时执行向量和全文检索,再用重排序模型合并排序 | 兼顾语义和关键词的通用场景 |
混合检索通常效果最好,但需要额外配置一个 Rerank 模型(如 Cohere Rerank 或本地部署的 BGE-Reranker)。Rerank 模型会对初步检索出的候选段落重新评分排序,把最相关的内容排在前面。
Agent 框架:让 LLM 使用工具
Agent(智能体)是 Dify 中比简单问答更进一步的应用形态。它的核心能力是:LLM 不仅生成文本回答,还能根据任务需要主动调用外部工具来获取信息或执行操作。
Dify 的 Agent 支持两种推理策略:
Function Calling:依赖模型自身的函数调用能力(如 GPT-4、Claude 等支持的原生 Function Calling 接口)。模型直接输出结构化的工具调用指令,Dify 解析并执行。这种方式效率高、格式规范,但要求所用模型支持 Function Calling。
ReAct(Reasoning + Acting):通过 Prompt 引导模型交替进行"思考"和"行动"。模型先分析当前状态和目标,决定下一步要调用什么工具、传什么参数;拿到工具结果后继续推理,直到得出最终答案。这种方式不依赖模型原生的函数调用接口,兼容性更好,但每次推理都需要额外的 token 消耗。
Dify 内置了一些常用工具(如 Google 搜索、Wikipedia 查询、天气查询等),同时支持通过 OpenAPI Schema 导入自定义工具。你只需提供工具的 API 描述(endpoint、参数、返回格式),Dify 就会把它注册为 Agent 可用的工具。
一个典型的 Agent 使用场景:用户问"北京明天的天气怎么样?"Agent 识别出需要查询实时天气,自动调用天气 API 工具,拿到结果后组织成自然语言回复。如果用户接着问"那适合穿什么衣服?"Agent 可以基于上一轮获取的天气数据,结合自身知识给出建议,不需要再次调用工具。
模型管理:统一接入多种 LLM
Dify 的模型管理层解决的问题是:让同一个应用可以灵活切换或组合不同供应商的模型,而不需要修改应用逻辑。
在模型配置页面,你添加模型供应商的 API Key 或连接信息后,该供应商下的所有可用模型都会出现在模型选择列表中。目前支持的供应商包括 OpenAI、Anthropic、Google(Gemini)、Azure OpenAI、Hugging Face、Replicate、讯飞星火、百度文心、通义千问、MiniMax 等,以及通过 Ollama、Xinference、LocalAI 等框架接入的本地开源模型。
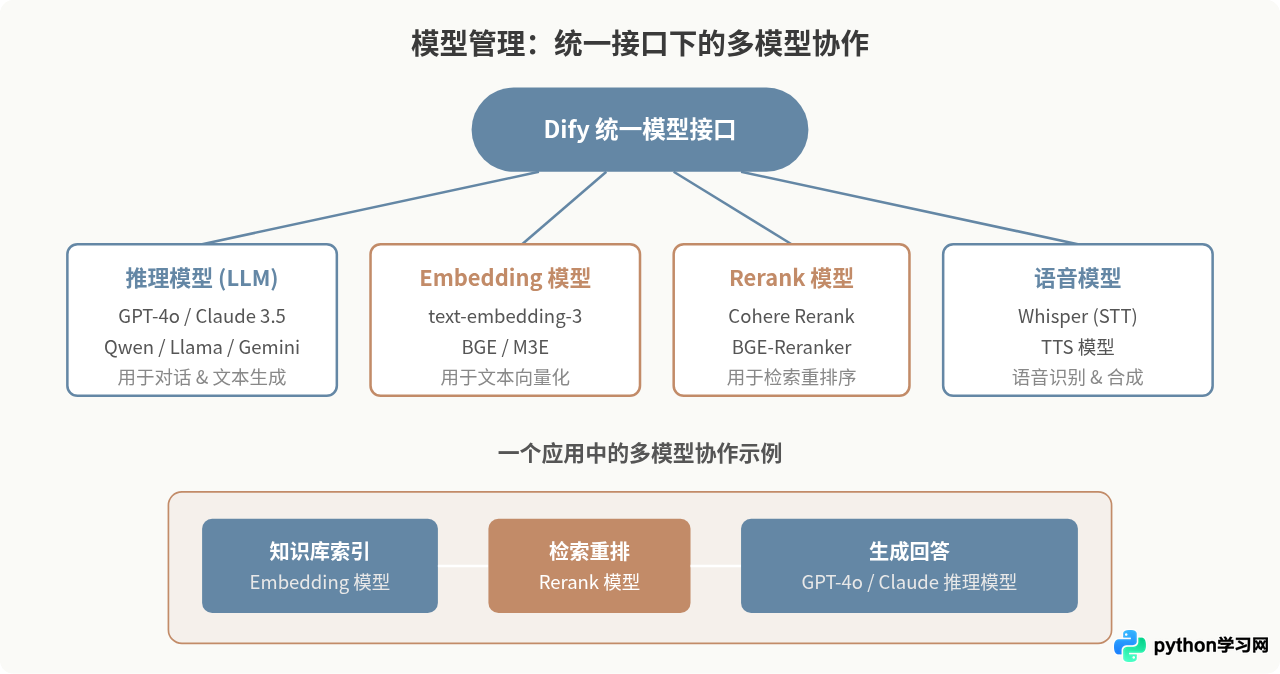
模型在 Dify 中按用途分为四类:
- 推理模型(LLM):用于文本生成和对话,如 GPT-4o、Claude 3.5 Sonnet。
- Embedding 模型:用于文本向量化,RAG 知识库需要用到。
- Rerank 模型:用于检索结果重排序。
- 语音模型:用于文本转语音或语音转文本。
一个应用中可以同时使用不同供应商的模型。比如用 GPT-4o 做主推理、用 text-embedding-3-small 做知识库索引、用 Cohere Rerank 做检索重排。切换模型时,只需在节点配置中选择另一个模型,不需要改动 Prompt 或工作流逻辑(但不同模型对 Prompt 的理解可能有差异,切换后建议重新测试效果)。
LLMOps:应用上线后的运营监控
把应用搭建完成只是开始,上线后的持续优化才决定应用的实际效果。Dify 提供了一套 LLMOps 工具来支撑这个过程。
日志与追踪:每次用户与应用的交互都会被记录,包括用户输入、模型输出、工具调用过程、Token 消耗和响应时间。在 Workflow 应用中,你还能看到每个节点的执行详情和中间输出,方便定位问题出在流程的哪个环节。
标注与反馈:Dify 支持对模型输出进行人工标注。你可以把某次回答标记为"好"或"差",也可以直接编辑理想回答作为标注样本。这些标注数据有两个用途:一是作为 few-shot 示例注入 Prompt,让模型遇到类似问题时参考标注的答案;二是积累数据用于后续的模型微调。
用量统计:按时间维度统计活跃用户数、对话轮次、Token 消耗、响应延迟等指标。这些数据帮助你判断应用的使用趋势和成本结构。
API 访问:每个 Dify 应用都可以通过 RESTful API 访问,方便集成到你自己的产品中。API 遵循标准的请求-响应格式,支持流式输出(SSE)。配合 API Key 做访问控制,可以安全地暴露给前端或第三方系统调用。
本地部署与快速开始
Dify 是开源项目,源码托管在 GitHub(langgenius/dify)。部署方式推荐使用 Docker Compose,这是最快的上手路径。基本步骤如下:
# 克隆仓库
git clone https://github.com/langgenius/dify.git

# 进入 docker 目录
cd dify/docker

# 复制环境变量模板
cp .env.example .env

# 启动所有服务
docker compose up -d
启动完成后,访问 http://localhost/install 进入初始化页面,设置管理员账号。登录后的第一件事是在"设置 → 模型供应商"页面添加至少一个模型的 API Key,之后就能创建应用了。
环境要求方面,Dify 依赖 Docker 和 Docker Compose。官方推荐的最低配置是 2 核 CPU、4GB 内存。如果要使用本地模型推理(通过 Ollama 或 Xinference),需要根据模型大小额外准备 GPU 或更大内存。
.env 文件中有几个关键配置需要注意:SECRET_KEY 务必修改为随机字符串(用于加密敏感数据);如果要对外提供服务,需要把 APP_WEB_URL 和 SERVICE_API_URL 改为实际的访问地址;向量数据库默认使用 Weaviate,如果你已有 Qdrant 或 Milvus 实例,可以在此切换。
常见应用场景与选型参考
理解了核心模块之后,来看 Dify 在哪些场景下比较合适、哪些情况可能需要额外考虑。
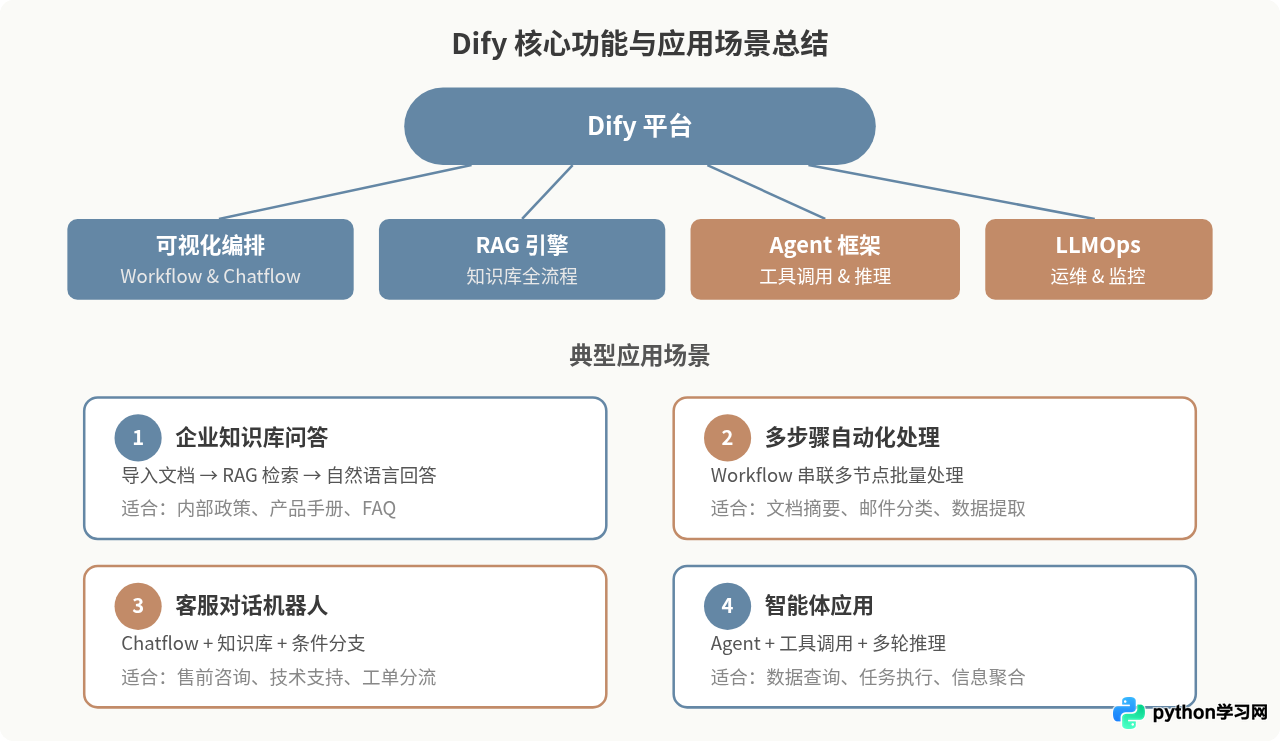
企业内部知识库问答:这是 Dify 最典型的应用场景。把内部文档导入知识库,用 RAG 驱动问答,可以快速搭建一个能回答员工问题的内部助手。Dify 的优势是开箱即用的 RAG 流程和可视化的调试工具,让非专业开发者也能搭建和调优。
多步骤自动化处理:利用 Workflow 模式,可以搭建文档摘要、邮件分类、内容审核等自动化管线。每个步骤用不同的 Prompt 或工具处理,中间结果通过变量传递。
客户服务对话机器人:Chatflow 模式加上知识库检索和条件判断,可以构建有一定规则约束的客服机器人。复杂问题可以通过条件分支转接人工处理。
需要谨慎评估的情况:如果应用逻辑非常复杂,涉及大量自定义代码和深度集成,Dify 的可视化编排可能会成为限制。这种情况下,直接使用 LangChain 或 LlamaIndex 等代码框架可能更灵活。另外,Dify 的多租户和权限管理功能相对基础,企业大规模部署前需要评估是否满足安全合规需求。
与其他方案的关键区别
开发 LLM 应用的工具不止 Dify 一个,了解它与其他方案的差异有助于判断是否适合你的需求。
与 LangChain/LlamaIndex 的区别:LangChain 和 LlamaIndex 是代码框架,开发者用 Python 代码编排 LLM 调用链。Dify 则提供了完整的 Web 平台和可视化界面。对于开发者来说,代码框架更灵活、可定制性更强;Dify 的优势在于降低了门槛,非开发人员也能使用,而且自带部署、监控、用户管理等运营功能,不需要额外搭建。
与 Coze/GPTs 的区别:Coze(字节跳动)和 OpenAI 的 GPTs 是 SaaS 平台,不需要部署。Dify 是开源自部署的,数据完全在自己的服务器上,没有数据外流的顾虑。但自部署意味着你需要自己维护基础设施和处理升级。
与 FastGPT 的区别:FastGPT 也是国内的开源 LLM 应用平台,功能定位与 Dify 类似。两者都提供可视化编排和 RAG 引擎。FastGPT 在知识库问答场景上做了更多专项优化(如更细粒度的分段控制);Dify 的 Agent 框架和 Workflow 功能更丰富,模型供应商的覆盖面也更广。选择时可以根据自己的核心场景来决定。
总结
Dify 把构建 LLM 应用过程中的模型接入、Prompt 编排、知识库管理、Agent 工具调用和上线运维这几个环节整合到了一个平台中。它的核心价值不在于提供某个环节的最强实现,而在于提供一个从零到上线的完整路径,降低了把 LLM 能力变成可用产品的门槛。
如果你正在考虑搭建基于 LLM 的应用,可以从 Docker Compose 部署一个本地实例开始,用 Chatflow 搭一个简单的知识库问答应用来体验核心功能。遇到编排能力不够用的场景,再评估是否需要更底层的代码框架。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









